제5장. Unity의 LTO 설정과 Android·iOS에서의 성능 비교
Unity 6000.5에 추가된 Android용 링크 타임 최적화(LTO) 설정은 엔진 코드에만 적용됩니다. 직접 작성한 C#에서 생성되는 코드에도 LTO를 적용하려면 별도의 설정이 필요합니다. 두 설정을 모두 시험하고, 벤치마크와 실제 타이틀에서 성능, 바이너리 크기, 빌드 시간을 측정했습니다.
5.1. IL2CPP의 컴파일과 번역 단위
Unity의 Android 빌드(IL2CPP)에서는 C#을 리스트 5.1의 흐름으로 기계어로 변환합니다.
리스트 5.1: IL2CPP 빌드의 처리 흐름
1 2 3 4 5 6 7 8 | C# 소스 ↓ C# 컴파일 IL 어셈블리(.dll) ↓ IL2CPP 변환 대량의 C++(.cpp) ← 「IL2CPP 생성 코드」 ↓ clang 로 컴파일(.cpp마다 개별 최적화) ↓ 링크 libil2cpp.so ← C# 코드에서 생성된 최종 네이티브 바이너리 |
clang은 cpp를 번역 단위(통칭 TU)별로 컴파일하여 오브젝트 파일로 생성합니다. TU는 컴파일러가 개별적으로 읽어 들여 최적화하는 단위를 가리킵니다.
일반적인 C++ 빌드에서는 다른 TU에 있는 함수 본문을 참조할 수 없으므로, 짧은 함수도 인라인화되지 않고 call 명령이 남는 경우가 있습니다. IL2CPP 생성 코드에는 작은 함수와 안전 검사가 많아 이 제약의 영향을 받기 쉬운 구조입니다. 예를 들어 buf[idx]라는 C#의 한 줄은 대략 리스트 5.2의 C++이 됩니다.
리스트 5.2: IL2CPP가 생성하는 배열 접근 코드의 예
1 2 3 | if (buf == NULL) ThrowNullReferenceException(); // null 체크 if ((uint32_t)idx >= buf->max_length) ThrowIndexOutOfRange(); // 경계 체크 val = buf->m_Items[idx]; |
생성 코드의 규모가 커질수록 TU를 넘나드는 호출도 늘어나고, 호출에 걸리는 시간의 합계도 늘어납니다.
5.2. LTO / ThinLTO란
LTO(Link Time Optimization)는 링크 시점에 TU를 넘나드는 인라인화, 상수 전파, 불필요한 코드 제거를 수행하는 clang/LLVM의 기능입니다. 컴파일 시에는 오브젝트 파일을 LLVM bitcode(최적화 전의 중간 표현)로 출력합니다. 링크 시점에 이를 모아서 최적화하고 기계어를 생성합니다.
full LTO는 모든 중간 표현을 하나로 합쳐 최적화합니다. 최적화할 수 있는 범위는 가장 넓지만, 중간 표현의 통합과 최적화가 단일 프로세스에 집중되므로 대규모 빌드에서는 많은 메모리를 사용합니다. 이번에도 실제 타이틀 빌드 중 메모리 사용량이 20GB에 달해 OS에 의해 프로세스가 강제 종료되었습니다.
ThinLTO는 컴파일 시에 각 TU의 요약(summary)을 만듭니다. 링크 시점에는 필요한 함수를 다른 TU에서 가져와(import) 병렬로 최적화합니다. full LTO보다 메모리 사용량과 처리 시간을 억제하기 쉬워 대규모 빌드에서 널리 사용됩니다.
5.3. 엔진 코드의 ThinLTO 설정
Unity 6000.5에서 Link Time Optimization 토글이 추가되었습니다.
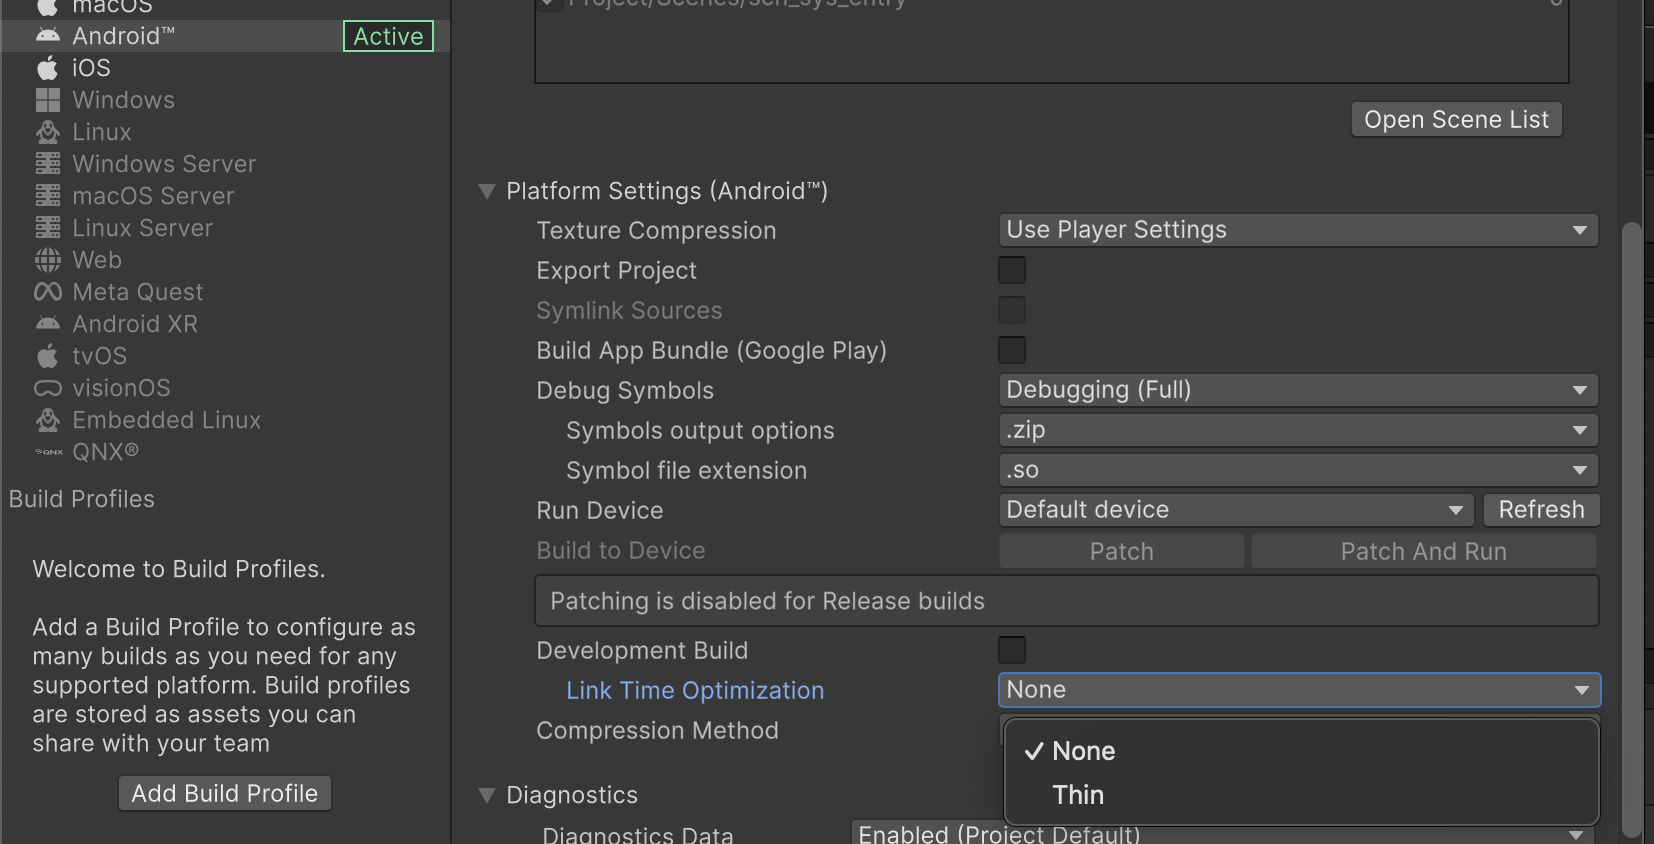
그림 5.1: Build Profiles > Player Settings > Android
이 토글을 활성화하면 Unity가 제공하는 ThinLTO 적용 완료 엔진 바이너리가 선택됩니다. 대상은 Unity 엔진 코드이며, IL2CPP 생성 코드(C#에서 유래한 코드)는 포함되지 않습니다. 에디터 설치 폴더에는 일반 버전과 ThinLTO 버전의 사전 빌드된 so 파일이 함께 들어 있습니다.
리스트 5.3: Android Player에 포함되는 libunity.so의 베리언트
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Libs/arm64-v8a/libunity.so 29,032,960 bytes └── Release_ThinLTO/Libs/arm64-v8a/libunity.so 30,042,536 bytes (+3.5%) |
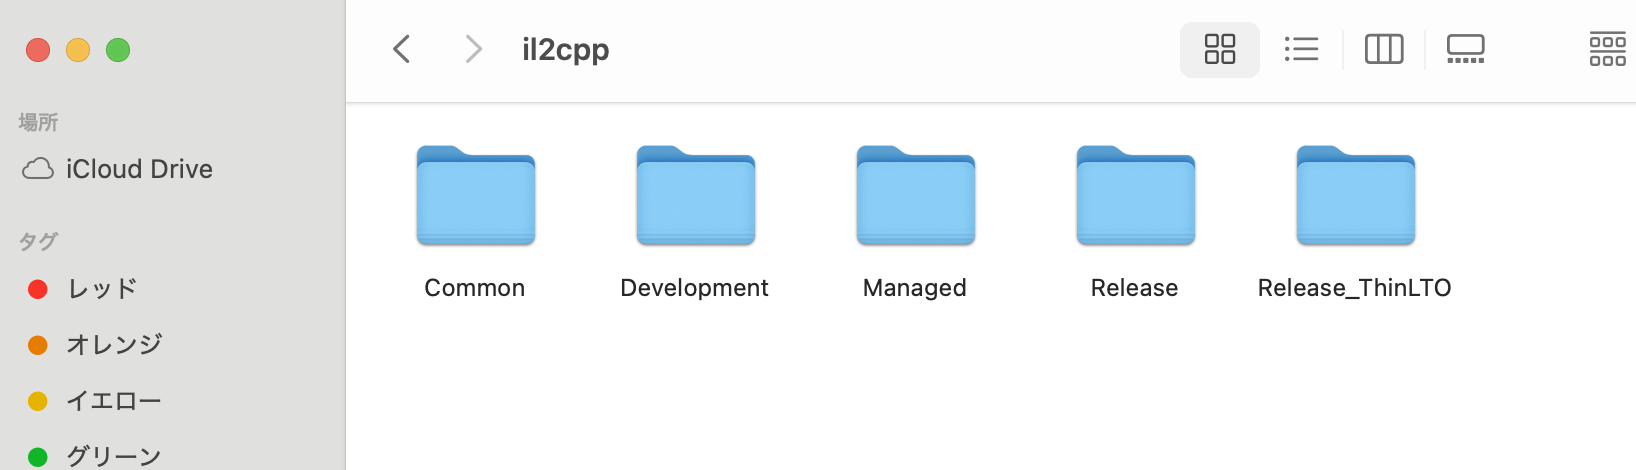
그림 5.2: 에디터 설치 폴더. Release와 Release_ThinLTO가 모두 포함되어 있으며, 빌드 시 둘 중 하나가 선택됩니다
5.3.1. 활성화 조건과 조건을 충족하지 않을 때의 동작
토글이 활성화되는 조건은 다음 세 가지입니다. 하나라도 충족하지 않으면 오류나 경고 없이 LinkTimeOptimization 파일은 None 파일로 빌드됩니다.
- IL2CPP 스크립팅 백엔드
- Strip Engine Code가 비활성(스트리핑되지 않은 prebuilt를 그대로 사용하기 때문)
- Development 빌드가 아닐 것
Development Build가 활성화되어 있으면 토글 자체가 표시되지 않습니다. 적용 여부는 리스트 5.4의 2가지로 확인할 수 있습니다.
리스트 5.4: 엔진 코드 LTO 토글 적용 확인 명령어
1 2 3 4 | # ① 빌드 입력에 ThinLTO가 지정되어 있는가 grep -o 'LinkTimeOptimization"[: ]*"[A-Za-z]*"' Library/Bee/Player*-inputdata.json # ② APK 내 libunity.so가 Release_ThinLTO 버전과 일치하는가 unzip -p out.apk lib/arm64-v8a/libunity.so | md5 |
5.4. 엔진 코드 LTO 토글의 효과
포함되어 있는 일반 버전과 ThinLTO 버전의 바이너리를 비교하고, 변경이 많은 서브시스템을 중심으로 실기기에서 퍼포먼스를 측정했습니다.
5.4.1. 포함된 바이너리의 함수 크기 비교
Unity는 두 베리언트의 심볼이 포함된 .so을 에디터 설치 폴더에 동봉하고 있습니다.
리스트 5.5: Android Player에 포함되는 심볼 포함 libunity.so
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Symbols/arm64-v8a/libunity.sym.so └── Release_ThinLTO/Symbols/arm64-v8a/libunity.sym.so |
llvm-nm --defined-only --print-size --demangle에서 얻은 함수 이름을 대조하고, 네임스페이스와 클래스 이름을 사용하여 서브시스템별로 집계했습니다(표 5.1).
표 5.1: 엔진 코드 LTO 토글에 따른 서브시스템별 함수 차이
| 서브시스템 | 함수 수 (Release → ThinLTO) | 크기가 변한 함수 수 | 크기 변화율 | .text 차이 |
|---|---|---|---|---|
| Particle | 1,419 → 1,290 | 1,043 | 80.9% | +49.66% |
| Serialization/Asset | 2,890 → 1,387 | 1,040 | 75.0% | -16.61% |
| Mesh/Geometry | 1,055 → 765 | 483 | 63.1% | +6.79% |
| Scripting | 8,924 → 7,680 | 4,302 | 56.1% | +10.27% |
| Gfx/Shader/Texture | 5,062 → 3,935 | 2,044 | 52.1% | +24.21% |
| Physics | 2,680 → 2,439 | 1,229 | 51.1% | +15.92% |
| NavMesh | 739 → 582 | 296 | 51.1% | +11.87% |
| XR/VFX/Video/기타 | 3,828 → 2,483 | 1,230 | 49.6% | +13.94% |
| Transform/Scene/Obj | 2,027 → 1,630 | 781 | 47.9% | +10.95% |
| Animation/Mecanim | 3,226 → 2,428 | 1,134 | 46.8% | +13.18% |
| Box2D | 2,169 → 1,562 | 712 | 46.4% | -0.43% |
| JobSystem/Threading | 244 → 181 | 78 | 43.6% | +3.16% |
| UI/UIToolkit | 883 → 701 | 293 | 42.0% | +1.38% |
| TextCore/Font/ICU | 3,500 → 2,101 | 861 | 41.9% | -5.73% |
| (미분류) | 29,193 → 21,077 | 7,511 | 37.6% | +3.37% |
| Renderer/Culling | 2,789 → 2,199 | 785 | 35.7% | +27.58% |
| C++ 표준/압축/인프라 | 13,158 → 9,484 | 3,071 | 32.6% | -13.31% |
| curl/TLS/HTTP | 1,809 → 1,558 | 318 | 21.0% | +1.17% |
| Audio/FMOD | 2,996 → 2,680 | 496 | 18.5% | +2.77% |
| Android/JNI | 1,445 → 1,186 | 193 | 16.3% | -5.52% |
| PhysX | 6,000 → 5,997 | 0 | 0.0% | -0.05% |
| 합계 | 96,036 → 73,345 | 27,900 | 38.8% | +4.41% |
※ 「크기가 변한 함수 수」는 함수의 개수입니다. 「크기 변화율」은 Release와 ThinLTO 양쪽에 존재하는 함수 중 크기가 변한 함수의 비율을 나타냅니다.
전체 함수 수는 96,036개에서 73,345개로 줄었지만 .text의 크기는 4.41% 늘었습니다.
5.4.2. 13개 워크로드를 이용한 벤치마크
표 5.1를 기반으로, 하나의 APK에 13개의 워크로드를 넣은 벤치마크 씬을 만들었습니다.
표 5.2: 엔진 코드 LTO 토글의 벤치마크 워크로드
| 워크로드 | 대상 서브시스템 | 내용 |
|---|---|---|
particle | Particle | 20,000 파티클 + noise/size/color 모듈, Simulate |
gfx | Gfx/Shader | MaterialPropertyBlock에 16개 프로퍼티 × float/vector + matrix를 기록하고 Clear |
cull | Renderer/Culling | CalculateFrustumPlanes + 4,096 AABB의 TestPlanesAABB |
physbind | Physics 바인딩 | Rigidbody / Collider 프로퍼티 왕복 |
anim | Animation | legacy Animation 48 리그 × 8 본 × 10 커브를 Sample() |
json | Serialization | JsonUtility의 왕복 |
instantiate | Serialization | Instantiate → DestroyImmediate(네이티브 clone/transfer 경로) |
xform | Transform/Scene | 계층 구조를 가진 Transform의 갱신 |
bind | Scripting 바인딩 | 극소 바인딩 호출을 대량으로 실행 |
mesh | Mesh/Geometry | 96×96 프로시저럴 메시의 재구축 |
phys2d | Box2D | 2D 리지드바디의 Simulate |
text | TextCore/Font | TextGenerator.Populate |
physics | PhysX | 3D 리지드바디의 Simulate |
※ 표 5.1의 서브시스템 중, 1샘플 100ms 정도의 안정적인 합성 부하를 C#에서 만들기 어려운 것은 측정 대상에서 제외했습니다. 이들에 대해서는 퍼포먼스에 미치는 영향을 평가하지 않았습니다.
5.4.3. 워크로드별 측정 결과
libunity.so만 다른 APK를 Pixel 8a(Tensor G3)에서 앞서 소개한 워크로드로 측정했습니다. Release / ThinLTO / ThinLTO / Release의 ABBA 순서를 3회 반복하여 총 12개 세션을 실행했습니다. 세션마다 앱을 재설치했고, 그 사이에 90초의 쿨다운을 두었습니다.
값은 1회 연산에 걸리는 시간(ns/op)입니다. 연산 단위는 워크로드마다 다르므로, 절대값은 같은 행 안에서 비교하시기 바랍니다.
표 5.3: 엔진 코드 LTO 토글의 워크로드별 벤치마크 결과
| 워크로드 | Release (ns/op) | ThinLTO (ns/op) | 차이 |
|---|---|---|---|
gfx | 990.46 | 852.49 | -13.93% |
cull | 96,520 | 87,499 | -9.35% |
text | 275,043 | 265,123 | -3.61% |
instantiate | 14,620 | 14,206 | -2.83% |
xform | 6,071.8 | 6,008.1 | -1.05% |
phys2d | 222,269 | 220,327 | -0.87% |
mesh | 2,340,210 | 2,334,143 | -0.26% |
json | 15,864.8 | 15,934.4 | +0.44% |
bind | 140.80 | 141.47 | +0.47% |
physbind | 607.28 | 610.74 | +0.57% |
particle | 265,635 | 267,335 | +0.64% |
anim | 28,100 | 28,563 | +1.65% |
physics | 484,641 | 482,796 | -0.38% |
| [합성: 기하 평균] | 21,918 | 21,380 | -2.46% |
※ 단위가 행마다 다르므로 합성값은 비율로서만 의미를 가집니다.
개선이 컸던 gfx와 cull는 C#에서 작은 함수를 1샘플당 수백만 회 호출하는 처리입니다. text의 TextGenerator.Populate도 내부에서 글리프 단위의 루프를 실행합니다. 1회의 처리가 작고 호출 횟수가 많은 경로에서 TU를 넘나드는 인라인화의 효과가 크게 나타났습니다.
5.4.4. 도입 시의 퍼포먼스·크기·메모리 비교
이번 측정에서는 바인딩 호출이 많은 일부 경로에서 CPU 시간이 단축되는 효과가 있었습니다. 다만 실제 타이틀에서의 개선 폭은 프레임 내에서 이러한 호출이 차지하는 비율에 좌우됩니다.
도입 시 치러야 하는 비용을 표 5.4에 정리했습니다.
표 5.4: 엔진 코드 LTO 토글 채택 시의 비용
| 구분 | 실측 차이 |
|---|---|
| Strip Engine Code OFF에 의한 크기 증가 | APK +5.67MB / 설치 +20.3MB |
| Strip Engine Code OFF에 의한 메모리 증가 | RSS +18.0MB / 그중 회수되기 어려운 영역 +8.0MB |
| engine ThinLTO 자체 | APK 크기 +398KB(30,621,595 → 31,019,967) / 메모리는 미측정 |
※ 설치 크기의 증가분은 APK의 증가분과, 기기에서 압축 해제된 .so의 증가분(arm64의 .so 합계로 +14.65MB)의 합계입니다.
Unity는 같은 토글에 대해 5개 프로젝트에서 콜드 스타트를 10회씩 측정한 결과를 공개하고 있습니다. CPU 시간은 13.88ms에서 13.36ms(-3.7%), 초기 표시까지의 시간은 247.96ms에서 229.90ms(-7.3%)로 단축되었고, APK 크기는 +3.3%이며 빌드 시간에 미치는 영향은 경미하다고 보고되어 있습니다 *1.
CPU 개선 폭은 이번 측정과 비슷한 수준입니다. 다만 공개된 APK 크기 +3.3%는 Strip Engine Code를 비활성화한 구성끼리의 비교이므로, 비활성화에 따른 설치 크기 +20.3MB와 메모리 +8.0MB의 증가는 포함되어 있지 않습니다.
5.5. libil2cpp.so에 LTO를 적용하는 방법
C#에서 변환된 코드를 포함하는 libil2cpp.so에 LTO를 적용하려면 Unity의 Master 구성을 사용하는 방법과 clang 플래그를 직접 전달하는 방법이 있습니다.
5.5.1. Master 구성과 IL2CPP LTO Mode 설정
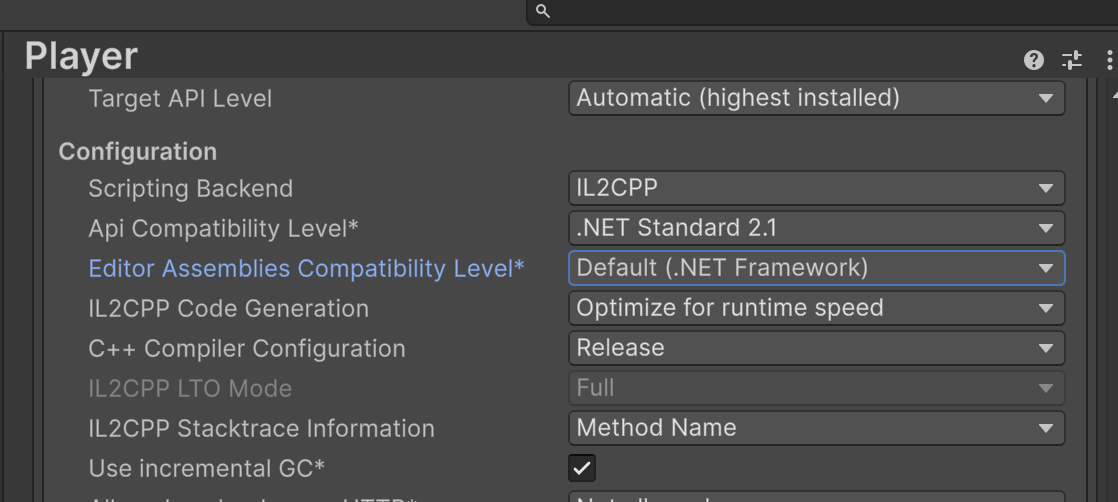
그림 5.3: IL2CPP LTO Mode와 C++ Compiler Configuration의 설정 화면
Player Settings > Configuration의 C++ Compiler Configuration을 Master로 설정하면 libil2cpp.so에 대한 LTO가 활성화됩니다. IL2CPP LTO Mode는 그때 사용할 Thin / Full 모드를 선택하는 항목입니다.
Unity 공식 기사에 따르면 IL2CPP LTO Mode는 6000.5부터 추가되었습니다. 6000.5 이전의 Android에서는 LTO 유무에 대해 Release와 Master 사이에 차이가 없습니다. 다만 6000.5의 Android 플랫폼에서는 토글을 선택할 수 없고 Thin으로 고정되어 있으며, 6000.6부터 Master 구성에서 Thin / Full을 선택할 수 있게 되었습니다. 6000.7 시점에도 Release 구성 그대로 LTO만 활성화하는 항목은 없었습니다.
Player Settings의 C++ Compiler Configuration에 대응하는 플래그는 Bee 빌드 그래프의 Il2CppCompilerConfiguration에서 확인할 수 있습니다.
표 5.5: Unity의 C++ Compiler Configuration별 컴파일러 플래그
| 버전 | Release | Master |
|---|---|---|
| Android 6000.3 (arm64) | -Os(크기 우선), LTO 없음 | -Os, LTO 없음(동일) |
| Android 6000.5 (arm64) | -Os | -O2(속도와 코드 크기의 균형을 맞추는 최적화) + ThinLTO |
| iOS 6000.3 / 6000.5 | -O3(코드 크기가 늘어날 가능성을 감수하고 더 적극적으로 속도를 추구하는 최적화), LTO OFF | -O3, LTO OFF(동일) |
5.5.2. Release 구성에 -flto=thin 추가하기
앞서 설명한 대로 Master 구성으로 전환하는 것이 LTO 효과를 가장 빠르게 얻는 방법이지만, LTO와 동시에 최적화 수준도 -Os에서 -O2로 바뀌며(표 5.5), 단점으로 크기와 빌드 시간이 늘어납니다. Release 구성을 유지한 채 ThinLTO만 적용하면 LTO의 효과를 분리해서 측정할 수 있고, 크기와 빌드 시간의 증가도 억제할 수 있습니다. 직접 작성한 C#에서 생성된 libil2cpp.so에 ThinLTO를 적용하려면 리스트 5.6와 같이 clang 플래그를 직접 전달하는 방법을 생각할 수 있습니다.
리스트 5.6: Release 구성에서 ThinLTO를 활성화하는 빌드 전처리
1 2 3 4 5 6 7 8 9 10 11 12 13 | // 기존 추가 인자를 보관 → 추가 → 반드시 원래대로 복원 var saved = PlayerSettings.GetAdditionalIl2CppArgs(); try { var extra = "--compiler-flags=-flto=thin --linker-flags=-flto=thin"; PlayerSettings.SetAdditionalIl2CppArgs( string.IsNullOrEmpty(saved) ? extra : saved + " " + extra); BuildPipeline.BuildPlayer(options); } finally { PlayerSettings.SetAdditionalIl2CppArgs(saved); } |
적용되었는지는 2단계로 확인합니다(리스트 5.7).
첫 번째는 빌드 명령에 플래그가 전달되었는지입니다. Unity의 빌드 시스템(Bee)은 실행한 컴파일과 링크 명령을 Library/Bee/Player*.dag.json에 기록합니다. 이 파일을 -flto=thin로 검색하여 IL2CPP 생성 코드의 컴파일과 libil2cpp.so의 링크 양쪽에 포함되어 있는지 확인합니다.
두 번째는 생성된 오브젝트 파일이 LLVM bitcode로 되어 있는지입니다. LTO를 활성화하면 컴파일 결과인 .o은 기계어가 아니라 bitcode가 됩니다. 첫 번째에서 찾은 컴파일 명령의 출력 파일을 하나 골라 앞 4바이트를 표시합니다.
리스트 5.7: IL2CPP ThinLTO의 적용 확인 명령
1 2 3 4 | # 1. 컴파일과 링크 명령에 -flto=thin이 있는지 rg -n -- '-flto=thin' Library/Bee/Player*.dag.json # 2. 생성된 오브젝트의 앞 4바이트(1.에서 찾은 .o를 지정) xxd -l 4 Library/Bee/artifacts/Android/.../GeneratedCode.o |
bitcode라면 4243 c0de(BC..), 일반 기계어 오브젝트라면 7f45 4c46(.ELF)가 표시됩니다. 폴더 안의 .o를 임의로 고르면 LTO 대상이 아닌 서드파티 라이브러리의 오브젝트를 집을 수 있습니다. 두 번째 명령에는 반드시 첫 번째 검색 결과에 나온 파일을 지정하시기 바랍니다.
5.5.3. 벤치마크 설계
합성 코드 생성
이 벤치마크에서는 일반적인 컴파일로는 최적화할 수 없는 TU를 넘나드는 호출을 주된 측정 대상으로 합니다. asmdef의 경계와 C++의 TU 경계는 같은 개념이 아니므로, IL2CPP 변환 후의 생성 C++와 Bee의 컴파일 그래프에서 호출자와 피호출자가 서로 다른 TU가 되는 것도 확인했습니다. 코드 제너레이터로 생성한 내용은 다음과 같습니다.
- asmdef 어셈블리 16개 × 클래스 24개 × 메서드 8개 = 3,072개 메서드
- 호출 체인이 1회전에 16개의 어셈블리 경계를 통과하며, 모든 메서드가 공유 어셈블리의 헬퍼(
Core.Mix/Core.Idx/ 구조체 연산)도 추가로 호출함 - 벤치마크가 모든 클래스를 순회하므로 managed 스트리핑에 의해 제거되지 않음
- 메서드마다 상수를 바꾸어 ICF에 의한 병합을 방지함
생성하는 3,072개 메서드의 예를 리스트 5.8에 나타냅니다.
리스트 5.8: 합성 벤치마크에서 생성하는 메서드의 예
1 2 3 4 5 6 | public static int M2(int sel, int x, int[] buf) { x = Core.Mix(x, 655663086); // 공유 어셈블리로의 경계를 넘는 호출 x += buf[Core.Idx(x, 7)]; // 경계 체크가 있는 배열 액세스(Idx는 & 1023으로 마스크) return M3(sel, x, buf); // 작은 함수 체인 } |
2개의 워크로드
표 5.6: IL2CPP ThinLTO의 합성 벤치마크 워크로드
| 워크로드 | 무엇을 측정하는가 |
|---|---|
| direct | 크로스 어셈블리 정적 호출 체인(LTO가 가장 효과적일 형태) |
| iface | 같은 종류의 연산을 인터페이스 디스패치를 거쳐 실행(LTO가 호출 대상을 직접 호출로 바꾸기 어려운 형태) |
둘 다 libil2cpp.so 안에서 완결됩니다. 각 구성에서 생성된 바이너리는 APK에서 추출한 libil2cpp.so의 md5로 매번 확인하고 있습니다. 1샘플이 약 100ms가 되도록 실행 시에 반복 횟수를 조정합니다. 실행마다 횟수가 다르므로 1 pass당 시간으로 정규화하여 비교합니다.
iface에서는 각 어셈블리에 IGenOp을 구현한 클래스를 4개씩(총 64개) 생성하고, 벤치마크가 인터페이스를 통해 순서대로 호출합니다(리스트 5.9). 메서드 본문에서는 direct와 동일한 Core.Mix / Core.Idx을 호출하지만, 어느 클래스의 Apply가 호출될지는 런타임에 결정됩니다.
리스트 5.9: iface 워크로드에서 생성하는 클래스와 호출 루프
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | sealed class Op0 : IGenOp { int m_State = 20612; public int Apply(int x, int[] buf) { x = Core.Mix(x, 347275849); // 공유 어셈블리로의 경계를 넘는 호출 x += buf[Core.Idx(x ^ m_State, 7)]; // direct와 같은 종류의 배열 접근 m_State = (m_State + x) | 1; return x; } } // 벤치마크 측: 64개의 구현을 인터페이스를 통해 순회 for (int i = 0; i < ops.Count; i++) a += ops[i].Apply(a ^ p, buf); // 호출 대상은 런타임에 결정된다 |
5.5.4. CPU 실측(Pixel 8a)
표 5.7: Pixel 8a에서의 IL2CPP ThinLTO CPU 실측 결과
| 구성 | direct (us/pass) | iface (us/pass) |
|---|---|---|
| off(Release, -Os) | 19.88 | 0.404 |
| thin(수동 ThinLTO) | 15.54 (-21.8%) | 0.375 (-7.3%) |
수동 ThinLTO로 direct는 21.8%, iface는 7.3% 단축되었습니다.
direct의 함수 호출과 명령 수
§5.3.1과 같은 호출 구조에 대해 LTO 유무에 따른 디스어셈블 결과를 비교했습니다.
표 5.8: direct 워크로드의 디스어셈블 비교
C000_M2 | LTO 없음 | ThinLTO |
|---|---|---|
| 명령 수 | 15 | 11 |
함수 호출(bl) | 2 | 0 |
| 스택 프레임 | 있음 | 없음 |
| callee-saved 레지스터 저장 | x19, x20, x29, x30 | 없음 |
| 메모리 접근 | 5회 | 1회 |
Core.Mix와 Core.Idx의 본문이 호출자로 전개되어 bl 명령 2개와 스택·레지스터 저장 처리가 불필요해졌습니다. 두 함수를 넘나드는 식도 함께 최적화됩니다. direct의 21.8% 단축은 이 변화가 3,072개 메서드만큼 누적된 결과입니다.
iface의 개선이 작은 이유
IL2CPP가 생성하는 interface 호출은 개략적으로 리스트 5.10의 형태입니다.
리스트 5.10: IL2CPP가 생성하는 interface 호출 코드의 개략
1 2 3 | const VirtualInvokeData& invokeData = il2cpp_codegen_get_interface_invoke_data(slot, obj, declaringInterface); return ((Func)invokeData.methodPtr)(obj, p1, p2, invokeData.method); |
호출 대상은 실행 시에 얻는 invokeData.methodPtr이므로 일반적인 C++ vtable 호출처럼 직접 호출로 바꿀 수 없습니다. 다만 메서드 본문에서 다른 TU의 헬퍼를 호출하는 부분은 인라인화할 수 있어 iface에서도 7.3% 단축되었습니다.
interface / virtual 호출에 시간이 걸리는 경우에는 sealed, 구체 타입으로 받기, 제네릭을 통한 정적 디스패치도 검토할 수 있습니다. ThinLTO로 개선되기 쉬운 부분은 다른 TU의 작은 함수를 정적으로 호출하는 부분입니다.
5.5.5. 크기와 빌드 시간
표 5.9: IL2CPP ThinLTO의 크기와 빌드 시간
| 구성 | libil2cpp.so (MB) | 동 .text | 콜드 빌드 |
|---|---|---|---|
| off | 37.36 | 기준 | 62s |
| thin | 38.16 (+2.2%) | +2.3% | 71s (+15%) |
이 구성에서는 인라인 전개의 영향으로 libil2cpp.so가 2.2% 늘었습니다. LTO는 불필요한 코드를 제거하는 경우도 있으므로 크기 변화의 방향은 코드베이스와 최적화 내용에 따라 달라집니다. 콜드 빌드는 62s에서 71s로 15% 늘었습니다. ThinLTO에서는 TU를 넘나드는 최적화와 기계어 생성을 링크 시에 수행하므로 그만큼 링크 시간이 늘어납니다.
5.6. Master 구성에서 활성화되는 최적화
Master 구성에서는 LTO와 동시에 최적화 수준도 바뀝니다(표 5.5). CPU 시간 단축이 어느 설정에 의한 것인지 조사하기 위해 각각을 분리하여 측정했습니다. 최적화 레벨(-Os → -O2)과 LTO의 영향을 개별적으로 조사하기 위해 {-Os, -O2} × {LTO 없음, ThinLTO}의 2×2를 실측했습니다(Android 6000.5 / arm64).
표 5.10: 최적화 레벨과 ThinLTO의 CPU 실측 비교
| direct (us/pass) | LTO 없음 | ThinLTO |
|---|---|---|
| -Os(Release) | 19.64(기준) | 15.54 (-20.9%) |
| -O2(Master) | 18.47 (-5.9%) | 15.54 (-20.9%) |
표 5.11: 최적화 레벨과 ThinLTO의 libil2cpp.so 크기 비교
| libil2cpp.so | LTO 없음 | ThinLTO |
|---|---|---|
| -Os | 37.36MB | 38.16MB (+2.2%) |
| -O2 | 39.14MB | 44.14MB (+12.8%) |
CPU 시간 단축률은 -O2 단독으로 5.9%, ThinLTO를 포함한 구성에서 20.9%였습니다. 이 벤치마크에서는 Master 구성의 개선 대부분을 ThinLTO로 얻을 수 있었던 것입니다. Release + 수동 ThinLTO와 Master의 CPU 시간은 15.54us로 같았지만, 최종 libil2cpp.so의 크기는 38.16MB와 44.14MB로, Release + 수동 ThinLTO 쪽이 약 13.5% 작았습니다.
표 5.12: Release + ThinLTO와 Master의 콜드 빌드 시간
| 구성 | 콜드 빌드 |
|---|---|
Release (-Os, LTO 없음) | 62s |
| Release + ThinLTO | 71s (+15%) |
Master (-O2 + ThinLTO) | 86s (+39%) |
콜드 빌드는 71s와 86s로, Release에 ThinLTO만 추가한 구성이 15초 짧았습니다. Unity의 공개 측정에서도 Master 구성(libil2cpp.so 측)은 CPU -2.3%, 초기 표시까지의 시간 -5.7%에 대해 libil2cpp.so 크기 +18.7%, 빌드 시간 +30~35%였습니다. CPU 개선 폭은 Unity의 -2.3%에 대해 이 장의 벤치마크에서는 -20.9%였습니다. 다만 Unity는 실제 프로젝트의 메인 스레드 전체를, 이 장은 작은 함수를 반복 호출하는 경로만을측정하고 있으므로 숫자를 그대로 비교할 수는 없습니다. 한편 크기와 빌드 시간은 이 장의 Master에서도 +18.2%, +38.7%로, Unity의 공개값과 가까운 결과입니다.
5.7. 실제 타이틀에서의 검증
벤치마크보다 규모가 큰 두 개의 실제 타이틀에서도 ThinLTO를 시험했습니다. Unity 버전, 어셈블리 수, 소스 코드 양, 바이너리 크기를 표 5.13에 나타냅니다.
표 5.13: 실제 타이틀의 Unity 버전과 코드 규모
| 항목 | 타이틀 A | 타이틀 B |
|---|---|---|
| Unity 버전 | 6000.5.3f1 | 6000.3.15f1 |
| 플레이어에 포함되는 어셈블리 수 | 158 | 285 |
컴파일되는 .cs | 6,969개 파일 | 16,700개 파일 |
| 같은 줄 수 | 약 138만 줄 | 약 319만 줄 |
| 그중 자사 코드 | 1,943개 파일 / 약 35만 줄 | 8,606개 파일 / 약 154만 줄 |
libil2cpp.so(비압축) | 189.0MB | 294.3MB |
5.7.1. Release + ThinLTO의 크기와 적용 확인
표 5.14: 타이틀 A의 크기와 빌드 시간
| 항목 | baseline | ThinLTO | 차이 |
|---|---|---|---|
| libil2cpp.so(비압축) | 189.01MB | 194.70MB | +5.69MB (+3.0%) |
동 .text | 8.54MB | 8.98MB | +0.44MB (+5.1%) |
| APK | 165.85MB | 166.94MB | +1.08MB (+0.65%) |
| 플레이어 빌드 부분 | 약 396s | 약 433s | 약 +9% |
.text +5.1%는 벤치마크(+2.3%)보다 큰 값으로, asmdef를 잘게 나눌수록 모듈을 넘나드는 인라인화가 늘어난다는 예상에 부합하는 결과였습니다. 189MB의 libil2cpp.so에서도 로컬 머신에서 ThinLTO 링크를 완료할 수 있었습니다.
타이틀 B에서는 llvm-readelf -S로 libil2cpp.so의 섹션별 크기를 비교했습니다(표 5.15).
표 5.15: 타이틀 B의 libil2cpp.so 섹션 차이
| 항목 | baseline | ThinLTO | 차이 |
|---|---|---|---|
| libil2cpp.so(파일 전체) | 294.30MB | 304.12MB | +3.34% |
il2cpp | 145.85MB | 162.22MB | +11.23% |
.text | 10.69MB | 11.14MB | +4.18% |
.rela.dyn | 50.28MB | 45.01MB | -10.48% |
.got | 1.76MB | 1.4KB | -99.92% |
.gcc_except_table | 3.70MB | 3.62MB | -2.32% |
.text의 증가율 4.18%는 타이틀 A(5.1%)와 벤치마크(2.3%)의 사이에 들어갔습니다. .got는 1.76MB에서 1.4KB로 줄었습니다. LTO에 의해 모듈을 넘나드는 참조가 해결되고 GOT를 경유하는 간접 참조가 직접 참조로 변환되었음을 보여 주는 결과입니다. 동적 재배치 엔트리를 포함하는 .rela.dyn의 10.5% 절감도 이 변화에 대응합니다.
5.7.2. 실제 타이틀에서의 Master와 full LTO (타이틀 A)
§6의 Master 구성과 full LTO의 비교를 실제 타이틀 규모에서 시험했습니다.
표 5.16: 타이틀 A의 빌드 구성 비교
| 타이틀 A | baseline | Release + thin | Master | full LTO |
|---|---|---|---|---|
| libil2cpp.so | 189.0MB | 194.7MB (+3.0%) | 222.2MB (+17.6%) | — |
| 빌드 | 453s | 465s | 537s(9분) | 2,903s(48분) 후 실패 |
| 링커 경로의 피크 RSS | — | — | 12.9GB | 20GB → Killed: 9(OOM) |
full LTO는 48분간 빌드한 후 링크 중 메모리 사용량이 20GB에 달해 OS에 의해 강제 종료되었습니다. §5.3의 벤치마크에서도 full LTO는 CPU 시간이 ThinLTO와 동등한 채로 콜드 빌드가 71s에서 247s로 약 3.5배가 되었습니다. 이 타이틀에서는 빌드를 완료할 수 없었으며 ThinLTO가 더 실용적이었습니다.
Master의 libil2cpp.so 크기는 baseline에서 약 33MB 증가했지만 CPU 성능은 Release + thin과 동등했습니다. Release + thin에서는 크기 증가가 약 5.7MB에 그치므로, 이 타이틀에서도 Master와 동등한 성능을 더 작은 바이너리로 얻을 수 있었습니다.
5.7.3. 실제 타이틀에서의 CPU 사이클 (타이틀 B)
아웃게임의 정상 상태 화면에서 Pixel 8a의 전체 스레드 CPU 사이클을 합산하여 측정했습니다. ThinLTO와 baseline을 번갈아 3세션씩 측정했으며, 각 세션의 값은 20초 계측을 6회 수행한 평균입니다.
표 5.17: 타이틀 B의 세션별 CPU 사이클
| 세션 | 총 사이클 (Gcyc) | UnityMain (Gcyc) |
|---|---|---|
| ThinLTO #1 | 44.88 | 27.48 |
| ThinLTO #2 | 45.18 | 27.36 |
| ThinLTO #3 | 45.54 | 27.60 |
| baseline #1 | 46.06 | 29.05 |
| baseline #2 | 45.71 | 27.89 |
| baseline #3 | 46.15 | 28.23 |
| 평균(ThinLTO vs baseline) | 45.20 vs 45.97 → -1.68% | 27.48 vs 28.39 → -3.21% |
5.7.4. Unity 공개값과의 비교
Unity가 공개한 Master 구성(libil2cpp.so 측)의 측정값을 타이틀 B의 결과와 비교합니다. §6의 벤치마크 결과도 함께 표기했습니다.
표 5.18: Unity 공개값과 이 장의 실측 결과 비교
| 지표 | Unity 공개(6개 프로젝트・Master) | 벤치마크 | 타이틀 B |
|---|---|---|---|
| CPU | 메인 스레드 -2.3% | direct -21.8% | UnityMain -3.21% / 총 사이클 -1.68% |
libil2cpp.so | +18.7% | +2.2%(Release+thin)/ +18.2%(Master) | +3.0% |
| 빌드 시간 | +30~35% | +15%(Release+thin)/ +38.7%(Master) | +9~15% |
Unity의 CPU 시간 단축률 -2.3%와 타이틀 B의 UnityMain -3.21%는 모두 수 % 정도의 개선이었습니다. 벤치마크의 -21.8%와의 차이는 실제 타이틀의 측정에 LTO 대상이 아닌 처리도 포함되기 때문으로 설명할 수 있습니다. Unity가 측정한 6개 프로젝트에서도 같은 경향이 보입니다.
크기와 빌드 시간은 구성에 따라 차이가 났습니다. Unity의 공개값은 Master 구성에서 각각 +18.7% / +30~35%입니다. 이 장에서 측정한 Master 구성의 +18.2%(44.14MB / 37.36MB) / +38.7%(86s / 62s)와도 가까운 값이었습니다. 기준이 되는 libil2cpp.so의 크기도 37.26MB / 37.36MB로 비슷합니다.
Release에 ThinLTO만 추가한 경우에는 동등한 CPU 퍼포먼스를 크기 +2~3%, 빌드 시간 +9~15%로 얻을 수 있었습니다. §6의 2×2 비교에서 Master 구성의 크기와 빌드 시간 증가는 주로 -O2의 변경에 의한 것으로 생각됩니다.
5.7.5. 최적화 대상 범위와 실제 타이틀에서의 개선 폭
타이틀 B에서의 개선은 메인 스레드에 집중되어 있습니다. UnityMain이 -3.21%였던 데 비해 UnityMain 이외 전체는 +0.8%였으며, 세션 간 드리프트 4%의 범위 내였습니다.
바이너리에서도 libil2cpp.so 이외의 .so는 거의 변하지 않았습니다. 네이티브 플러그인 2개는 md5가 완전히 일치했고, 나머지 1개의 .text 차이는 +0.008%로 빌드의 비결정성 범위였습니다. 이번 --compiler-flags에 의한 최적화는 이 플러그인들에는 미치지 않았습니다.
UnityMain의 -3.2%는 벤치마크의 -22%보다 작았습니다. 이 화면에서는 표정·눈 깜빡임·머리카락이나 의상의 흔들림·IK 등이 잡으로 실행됩니다. 이들은 libil2cpp.so 밖의 네이티브 바이너리에 포함되어 있으며, 이번 플래그에 의한 최적화의 대상이 아닙니다.
대상 외의 처리를 제외한 IL2CPP 생성 코드만의 개선 폭은 UnityMain 전체의 -3.21%보다 클 것으로 생각됩니다. 다만 정확한 값을 구하려면 프로파일러로 대상 내외의 처리 시간을 분리해야 합니다. 잡은 스케줄링에 따라 메인 스레드에서도 실행되므로, UnityMain의 측정값에도 대상 외의 처리가 포함됩니다.
5.8. iOS의 ThinLTO 적용
타이틀 B의 iOS 버전에도 ThinLTO를 적용했습니다. 검증용 벤치마크에서는 효과를 확인할 수 있었지만, 실제 타이틀에서는 빌드 시간 증가에 걸맞은 개선을 얻지 못했습니다.
5.8.1. iOS에서의 LTO 구조
표 5.19: Android와 iOS에서의 LTO 구조 비교
| 관점 | Android | iOS |
|---|---|---|
| il2cpp의 출력 | libil2cpp.so | libGameAssembly.a |
| 최종 링크 | il2cpp가 호출하는 LLD | Xcode가 UnityFramework를 만들 때의 ld64 |
| 전달하는 인자 | --compiler-flags=-flto=thin --linker-flags=-flto=thin | --compiler-flags=-flto=thin만 |
| 빌드 시간이 늘어나는 곳 | Unity의 빌드 단계 | Build ipa(xcodebuild) 단계 |
iOS에서는 il2cpp가 아카이브를 만들기만 하므로 --linker-flags는 전달하지 않습니다. LTO의 코드 생성은 이 bitcode를 포함한 아카이브를 읽어 들이는 Xcode 측의 링크 시점에 이루어집니다.
생성 코드의 컴파일은 il2cpp가 담당하므로 플래그는 AdditionalIl2CppArgs에 지정해야 합니다. Xcode의 LLVM_LTO = YES_THIN을 변경해도 생성 코드에는 적용되지 않습니다.
엔진 코드는 사전 빌드된 libiPhone-lib.a로 제공되며 bitcode를 가지고 있지 않습니다. 따라서 LTO 대상에서 제외됩니다. Android의 엔진 코드 LTO 토글(§3)처럼 LTO가 적용된 엔진으로 교체하는 설정도 없었습니다.
5.8.2. iPhone 13 검증용 벤치마크
먼저 §5.3과 동일한 검증용 벤치마크를 iOS로 이식하여 생성 코드에 대한 ThinLTO가 iOS에서도 동작하는지 확인했습니다. direct은 16개의 asmdef로 나뉜 3,072개의 작은 메서드를넘나들며 호출하는, ThinLTO가 가장 효과를 내기 쉬운 구성입니다. 따라서 여기서의 개선율은일반적인 타이틀에서 그대로 얻을 수 있는 값이 아니라, 조건이 맞는 경우의 상한에 가까운 값으로 취급합니다.
기기는 iPhone 13(iPhone14,5 / iOS 18.7.8)입니다. Unity 6000.5.3f1, IL2CPP Release, OptimizeSpeed를 사용했습니다. baseline과 ThinLTO의 차이는 --compiler-flags=-flto=thin의 유무뿐입니다. Xcode는 ReleaseForRunning, 개발 서명은 get-task-allow=true이며, Unity의 Development Build는 비활성화했습니다.
세션마다 언인스톨, 재설치, 기동을 수행하고 5회의 웜업 후 30샘플을 기록했습니다. 측정 순서는 baseline / ThinLTO / ThinLTO / baseline을 3블록, 총 12개 세션입니다. 모든 세션에서 서멀 상태는 Nominal이었습니다. 처리 횟수는 세션마다 자동으로 조정되므로 direct와 iface는 1 pass당, Physics는 1 step당으로 정규화했습니다.
표 5.20: iPhone 13 검증용 벤치마크 결과
| 워크로드 | baseline | ThinLTO | 차이 |
|---|---|---|---|
direct | 21,231.31ns/pass | 16,184.31ns/pass | -23.77% |
iface | 366.96ns/pass | 370.39ns/pass | +0.93% |
| Physics(대상 외 대조군) | 147.82us/step | 147.36us/step | -0.31%(분포는 겹침) |
direct는 3블록 모두에서 -23.6~-23.9%였으며, baseline과 ThinLTO의 모든 세션이완전히 분리되었습니다. Android의 -21.8%(§5.4)와도 가까워, 생성 코드에 대한 ThinLTO가 iOS에서도실제로 작동함을 확인할 수 있습니다. 한편 iface는 약간 악화되었고, 대상 외인 Physics에는차이가 나타나지 않았습니다. ThinLTO의 효과는 정적인 작은 함수 호출이 TU를 넘나드는 경로에 치우쳐 있습니다. 같은 벤치마크의 바이너리 크기를 표 5.21에 나타냅니다.
표 5.21: iPhone 13 검증용 벤치마크의 바이너리 크기
| 항목 | baseline | ThinLTO | 차이 |
|---|---|---|---|
| UnityFramework | 98.76MB | 107.52MB | +8.76MB(+8.87%) |
__text | 20.09MB | 20.46MB | +0.37MB(+1.83%) |
il2cpp | 22.49MB | 30.78MB | +8.30MB(+36.89%) |
5.8.3. 타이틀 B의 결과와 iOS에서 채택을 보류한 이유
다음으로 타이틀 B의 iOS 버전에 ThinLTO를 적용했습니다. UnityFramework의 크기를 표 5.22, 빌드 시간을 표 5.23에 나타냅니다.
표 5.22: iOS UnityFramework의 섹션 차이
| 섹션 | baseline | ThinLTO | 차이 |
|---|---|---|---|
| UnityFramework(파일 전체) | 316.53MB | 393.47MB | +24.31% |
__TEXT(세그먼트) | 261.83MB | 338.53MB | +29.29% |
il2cpp | 167.02MB | 240.26MB | +43.85% |
__text | 57.99MB | 61.70MB | +6.41% |
__gcc_except_tab | 6.85MB | 6.63MB | -3.16% |
__unwind_info | 3.44MB | 3.38MB | -1.75% |
__got | 18.8KB | 18.8KB | ±0 |
| ipa(아카이브 전체) | 233.83MB | 246.93MB | +5.60% |
표 5.23: iOS의 빌드 시간
| 단계 | baseline | ThinLTO |
|---|---|---|
Build ipa(xcodebuild) | 357s(5m57s) | 3,094s(51m34s) |
UnityFramework는 +24.31%, ipa는 +5.60% 늘었습니다. 빌드 시간은 약 9배, 46분 증가했습니다. 증가분의 대부분은 Xcode 측의 링크와 dsymutil에 의한 것이며, Android의 +9~15%에 비해 크게 길어졌습니다. GCC_OPTIMIZATION_LEVEL을 -Os로 낮춘 구성(-Os + thin)에서도 53m51s가 걸려 단축되지 않았습니다.
타이틀 B의 정상 상태 화면에서는 cpu/wall의 단순 평균이 ThinLTO에서 +1.08%로 약간 악화되었고, 서멀 상태가 맞은 조에서도 -1.45%의 개선에 그쳤습니다. baseline과 ThinLTO의 분포는 겹쳐 있어 큰 CPU 개선을 분리할 수 없었습니다. 메모리 차이 +0.40%도 세션 내 편차 이하입니다. 검증용 벤치마크의 -23.77%는 ThinLTO에 유리한 호출을 모은 경우의 값이며, 실제 타이틀 전체에는 해당하지 않았습니다.
실제 타이틀에서 명확한 개선을 확인하지 못했고, 콜드 빌드나 CI에서 매번 약 46분의 추가 시간이 필요하므로, 이번 검증에서는 iOS에 대한 수동 ThinLTO를 채택하지 않기로 했습니다.
5.9. 자신의 타이틀에 도입하려면
Android에서는 먼저 Release 구성에 -flto=thin을 추가하는 방법을 권장합니다. 이번 벤치마크에서는 Master와 동등한 CPU 성능을 더 작은 바이너리와 짧은 빌드 시간으로 얻을 수 있었습니다. 실제 타이틀의 정상 상태 화면에서도 총 사이클이 1.68%, UnityMain이 3.21% 줄었습니다(§7.3).
엔진 코드 LTO 토글(§3)은 Strip Engine Code 비활성화에 따른 크기와 메모리 증가가 크므로 이번 구성에서는 권장하지 않습니다.
iOS에 대한 수동 ThinLTO는 빌드 시간 증가에 걸맞은 개선이 없어 채택을 보류했습니다.
도입 전에 Release 빌드의 Profiler 캡처에서 PlayerLoop 내 스크립팅 시간을 조사하시기 바랍니다. 수동 플래그의 대상은 libil2cpp.so 내이며, 렌더 스레드, GPU, 엔진 내부, GC는 대상이 아닙니다. 다른 AOT 파이프라인으로 컴파일되는 잡도 포함되지 않습니다(§7.5). DOTS/Job을 많이 사용하는 타이틀에서는 그 처리 시간도 확인합니다.
예를 들어 33ms 프레임 중 스크립팅이 8ms라면, 그 부분을 약 20% 단축할 수 있어도 프레임 전체로는 약 1.6ms 단축에 그칩니다. 프레임 전체에서 스크립팅이 차지하는 비율이 커서 개선 여지가 있거나, 높은 프레임 레이트를 유지해야 하는 상태에서만 도입을 검토하는 것이 좋습니다.
빌드 시간 증가가 개발 중 작업에 영향을 준다면, 일상적인 개발 빌드에는 적용하지 않고 스테이징 이후의 빌드에만 적용하는 방법도 있습니다. 플래그는 빌드 전처리에서 추가하므로(리스트 5.6) 빌드 종류별로 전환할 수 있습니다.
설정 후에는 §3.1과 §5.2의 절차로 적용을 확인합니다. inputdata, 바이너리의 md5, 컴파일 명령의 -flto, 오브젝트 파일의 bitcode가 확인 지점입니다. LTO의 조건을 충족하지 않아도 빌드는 성공하는 경우가 있으므로, 빌드 결과만으로는 적용 여부를 판단할 수 없습니다.
[*1] Unity Android 플랫폼 팀 「Boosting Android performance with LTO optimizations in Unity 6.5」https://discussions.unity.com/t/boosting-android-performance-with-lto-optimizations-in-unity-6-5/1720008. 이후 이 장에서 'Unity 공개값'이라고 쓰는 것은 이 기사의 수치입니다.