제4장. 모바일용 셰이더 최적화: 초월 함수의 계측과 경량화
4.1. 들어가며
셰이더 내에서 sin이나 exp 같은 초월 함수를 사용하면 GPU의 처리 부하가 높아지는 경향이 있습니다. 이 글에서는 프로파일러의 계측값을 바탕으로, 이러한 함수가 실제 퍼포먼스에 어느 정도 영향을 미치는지 설명합니다. 또한 초월 함수를 근사 계산으로 대체하는 최적화 기법을 다루고, 실제로 어느 정도의 부하 절감 효과를 얻을 수 있는지 실측값과 함께 소개합니다.
4.2. 환경
이 글에서 사용한 Unity 버전, 렌더 파이프라인, 사용한 기기는 다음과 같습니다.
| Unity 버전 | Unity6000.3.20f1 |
|---|---|
| 렌더 파이프라인 | Universal Render Pipeline 17.3.0 |
| iOS 기기 | iPhoneX iPhone14 iPhone15 Pro |
| Android 기기 | Galaxy S9 |
4.3. 초월 함수
초월 함수란 유한 횟수의 사칙연산이나 거듭제곱근으로 나타낼 수 없는 함수를 말합니다. 대표적인 예로 삼각 함수, 지수 함수, 로그 함수를 들 수 있습니다.
- sin, cos 등의 삼각 함수
- pow, pow2 등의 지수 함수
- log, log10 등의 로그 함수
초월 함수는 부하가 높으므로 많이 사용하지 않는 것이 바람직하다고 알려져 있습니다.
4.3.1. 초월 함수가 무거운 이유
초월 함수가 무거운 이유는 다음 세 가지입니다.
- 클록 수가 많다
- 초월 함수 연산을 수행하는 유닛(SFU)의 수가 적다
- 레지스터 압력(register pressure)에 의한 오버헤드
4.3.2. 이유 1: 클록 수가 많다
스마트폰 등에 탑재된 GPU는 산술 연산을 수행하는 연산 유닛(ALU)을 많이 탑재하고 있습니다. ALU는 덧셈이나 곱셈을 1클록 사이클에 실행할 수 있도록 설계되어 있습니다.
그러나 초월 함수는 한 번의 명령으로 계산할 수 있는 단순한 연산이 아닙니다. GPU 내부에서 초월 함수를 계산할 때는 테일러 전개나 미니맥스 방법 같은 다항식 근사 알고리즘을 사용하여, 다수의 덧셈과 곱셈의 조합으로 분해하여 계산합니다.
단순한 사칙연산이 '1명령'으로 끝나는 반면, 초월 함수는 컴파일러에 의해 '수십 명령의 사칙연산'으로 전개되므로 처리 시간이 길어집니다.
4.3.3. 이유 2: SFU의 수가 적다
많은 GPU에는 초월 함수 등을 고속으로 처리하기 위한 SFU(Special Function Unit)라는 전용 하드웨어가 탑재되어 있으며, 초월 함수가 SFU에서 실행되기도 합니다.
SFU의 수는 ALU에 비해 매우 적으므로, SFU를 사용하여 초월 함수를 실행하더라도 처리에 오랜 시간이 걸립니다.
4.3.4. 이유 3: 레지스터 압력에 의한 오버헤드
sin()과 같은 초월 함수는 단순한 덧셈이나 곱셈에 비해 계산이 복잡하며, GPU 내부에서 계산하기 위해 더 많은 임시 레지스터를 필요로 합니다.
GPU의 각 연산 유닛(SM: Streaming Multiprocessor)이 가진 레지스터의 총량은 물리적으로 정해져 있으며, 스레드당 소비하는 레지스터 수가 늘어나므로(레지스터 압력이 높아지므로) 하나의 SM에 담을 수 있는 스레드 수가 줄어듭니다.
한 번에 실행할 수 있는 스레드 수가 줄어들기 때문에 처리에 오랜 시간이 걸리게 됩니다.
4.4. 다양한 함수의 부하
루프 횟수 0~10 각각에 대해 다양한 초월 함수를 실행했을 때의 GPU 시간을 계측하여, 어느 초월 함수가 가장 무거운지 살펴봅니다. GPU 시간 계측에는 FrameTimingManager를 사용했습니다.
4.5. 부하 계측에 사용한 셰이더
계측에는 다음과 같은 셰이더를 사용했습니다. 셰이더 키워드로 실행할 초월 함수를 선택할 수 있으며, 변수 _LoopCount를 사용하여 루프 횟수를 변경할 수 있도록 했습니다.
Shader "Benchmark/Transcendental"
{
    Properties
    {
        // uGUI(CanvasRenderer)는 텍스처를 "_MainTex"에 바인딩하므로 이름은 고정이다
        [PerRendererData][MainTexture] _MainTex("Sprite Texture", 2D) = "white" {}
        [MainColor] _BaseColor("Tint", Color) = (1, 1, 1, 1)

        // Mask(UI/Mask)용 스텐실 설정. Mask 컴포넌트가 Material을 교체하여 기록한다
        _StencilComp("Stencil Comparison", Float) = 8
        _Stencil("Stencil ID", Float) = 0
        _StencilOp("Stencil Operation", Float) = 0
        _StencilWriteMask("Stencil Write Mask", Float) = 255
        _StencilReadMask("Stencil Read Mask", Float) = 255

        _ColorMask("Color Mask", Float) = 15

        [Toggle(UNITY_UI_ALPHACLIP)] _UseUIAlphaClip("Use Alpha Clip", Float) = 0
    }

    SubShader
    {
        Tags
        {
            "Queue" = "Transparent"
            "RenderType" = "Transparent"
            "RenderPipeline" = "UniversalPipeline"
            "IgnoreProjector" = "True"
            "PreviewType" = "Plane"
            "CanUseSpriteAtlas" = "True"
        }

        Stencil
        {
            Ref [_Stencil]
            Comp [_StencilComp]
            Pass [_StencilOp]
            ReadMask [_StencilReadMask]
            WriteMask [_StencilWriteMask]
        }

        Cull Off
        ZWrite Off
        ZTest [unity_GUIZTestMode]
        Blend SrcAlpha OneMinusSrcAlpha
        ColorMask [_ColorMask]

        Pass
        {
            HLSLPROGRAM

            #pragma vertex vert
            #pragma fragment frag
            // 루프 횟수가 uniform(동적 루프)이므로 2.0이 아닌 3.0이 필요하다
            #pragma target 3.0

            // RectMask2D / Mask의 Alpha Clip 대응
            #pragma multi_compile_local _ UNITY_UI_CLIP_RECT
            #pragma multi_compile_local _ UNITY_UI_ALPHACLIP

            // 계측할 초월 함수를 전환한다. 실행 중 Shader.EnableKeyword로 전환하고자 하므로
            // shader_feature(사용되지 않는 variant가 제거됨)가 아닌 multi_compile을 사용한다.
            // 키워드마다 별도의 variant가 되므로 생성 코드에는 선택한 함수만 나온다(분기 오버헤드 없음).
            // 글로벌 키워드이므로 TranscendentalBenchmark 쪽에서 일괄 제어할 수 있다.
            // 키워드가 하나도 켜져 있지 않으면 맨 앞의 _FUNC_NONE variant가 사용된다.
            #pragma multi_compile_fragment _FUNC_NONE _FUNC_SIN _FUNC_SIN_APPROX _FUNC_COS _FUNC_TAN _FUNC_TAN_TAYLOR _FUNC_TAN_PADE _FUNC_ASIN _FUNC_ACOS _FUNC_ATAN _FUNC_EXP _FUNC_EXP2 _FUNC_POW _FUNC_LOG _FUNC_LOG2 _FUNC_LOG10

            #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"

            struct Attributes
            {
                float4 positionOS : POSITION;
                float4 color : COLOR;
                float2 uv : TEXCOORD0;
                UNITY_VERTEX_INPUT_INSTANCE_ID
            };

            struct Varyings
            {
                float4 positionHCS : SV_POSITION;
                float2 uv : TEXCOORD0;
                float4 positionOS : TEXCOORD1; // _ClipRect와 같은 공간(Canvas 로컬)으로 유지한다
            };

            TEXTURE2D(_MainTex);
            SAMPLER(sampler_MainTex);

            CBUFFER_START(UnityPerMaterial)
                half4 _BaseColor;
            CBUFFER_END

            // TranscendentalBenchmark에서 설정하는 글로벌 값.
            // 머티리얼 단위의 값이 아니므로 UnityPerMaterial에는 넣지 않는다(넣으면 SRP Batcher가 깨진다)
            int _TranscendentalLoopCount;
            float _PowExponent;

            // UnityUI.cginc의 UnityGet2DClipping에 상응(HLSL로 직접 정의)
            float Get2DClipping(float2 position, float4 clipRect)
            {
                float2 inside = step(clipRect.xy, position.xy) * step(position.xy, clipRect.zw);
                return inside.x * inside.y;
            }

            // 초월 함수에 전달하는 값을 (0.05, 0.95)로 한정한다.
            // asin/acos의 정의역 |x| <= 1, log 계열의 정의역 x > 0, exp 계열의 오버플로를
            // 한꺼번에 회피한다. 모든 variant 공통의 전처리이므로 비용은 차이를 구할 때 상쇄된다.
            float PrepareInput(float seed)
            {
                return seed;
                // return frac(seed) * 0.9 + 0.05;
            }

            float sinApprox(float x)
            {
                // sin의 포물선 근사. 곱셈과 abs만으로 처리되므로 실제 sin 명령과의 비용 차이를 본다.
                // 정의역은 |x| <= PI(PrepareInput의 출력은 이 범위에 들어간다).
                // 계수는 상수 폴딩되므로 실행 시 나눗셈 비용은 없다.
                return (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
            }

            float tanTaylor(float x)
            {
                // tan의 테일러 전개 3차까지(곱셈만 사용). 실제 tan 명령과의 비용 차이를 본다.
                // 정의역은 |x| < PI/2이며, π/4를 넘으면 정밀도가 급격히 떨어진다.
                float x2 = x * x;
                return x * (1.0 + x2 * 0.3333333); // 1.0/3.0
            }

            float tanPade(float x)
            {
                // tan의 파데 근사(곱셈 + 나눗셈 1회). 정의역은 |x| < PI/2.
                // 분모의 영점 x ≈ ±1.581이 tan의 극 ±PI/2 가까이에 있으므로 극 부근까지 추종한다.
                float x2 = x * x;
                return x * (15.0 - x2) / (15.0 - 6.0 * x2);
            }

            // 계측 대상 초월 함수. 키워드마다 하나만 남으므로
            // 생성 코드에는 선택한 함수의 전개 결과만 나타난다.
            float Transcendental(float x)
            {
                #if defined(_FUNC_SIN)
                    return sin(x);
                #elif defined(_FUNC_SIN_APPROX)
                    return sinApprox(x);
                #elif defined(_FUNC_COS)
                    return cos(x);
                #elif defined(_FUNC_TAN)
                    return tan(x);
                #elif defined(_FUNC_TAN_TAYLOR)
                    return tanTaylor(x);
                #elif defined(_FUNC_TAN_PADE)
                    return tanPade(x);
                #elif defined(_FUNC_ASIN)
                    return asin(x);
                #elif defined(_FUNC_ACOS)
                    return acos(x);
                #elif defined(_FUNC_ATAN)
                    return atan(x);
                #elif defined(_FUNC_EXP)
                    return exp(x);
                #elif defined(_FUNC_EXP2)
                    return exp2(x);
                #elif defined(_FUNC_POW)
                    // 지수를 상수로 하면 pow(x, 2) -> x * x처럼 폴딩되어 버리므로
                    // uniform을 전달하여 범용 pow 경로를 거치게 한다
                    return pow(x, _PowExponent);
                #elif defined(_FUNC_LOG)
                    return log(x);
                #elif defined(_FUNC_LOG2)
                    return log2(x);
                #elif defined(_FUNC_LOG10)
                    return log10(x);
                #else // _FUNC_NONE : 초월 함수가 없는 베이스라인
                    return x;
                #endif
            }

            Varyings vert(Attributes IN)
            {
                Varyings OUT;
                OUT.positionOS = IN.positionOS;
                OUT.positionHCS = TransformObjectToHClip(IN.positionOS.xyz);
                OUT.uv = IN.uv * 300.0;
                return OUT;
            }

            half4 frag(Varyings IN) : SV_Target
            {
                // 여기가 계측 대상(외형에는 의미가 없다).
                // UNITY_LOOP로 루프 언롤을 억제하여 _TranscendentalLoopCount회분의 비용이 그대로 반영되게 한다.
                // 초월 함수의 내부 이외에는 어느 variant에서도 완전히 같은 형태이므로
                // _FUNC_NONE과의 차이가 그 함수의 비용이 된다.
                float accum = 0.0;

                UNITY_LOOP
                for (int i = 0; i < _TranscendentalLoopCount; i++)
                {
                    // 루프 불변식으로 두면 루프 밖으로 끌어올려지므로 i를 인자에 섞는다
                    float x = IN.uv.x + i * 0.017;

                    accum += Transcendental(x);
                }
                return half4(saturate(accum.xxx) * 0.02, 1);
            }
            ENDHLSL
        }
    }
}
4.6. 계측 결과
4.6.1. iPhone15 Pro
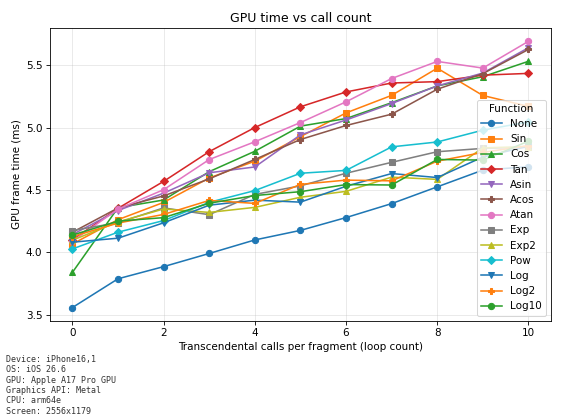
실행 횟수가 7 미만인 경우에는 tan이 가장 무겁고, 실행 횟수가 7 이상인 경우 Atan이 가장 무거웠습니다.
4.6.2. iPhone14
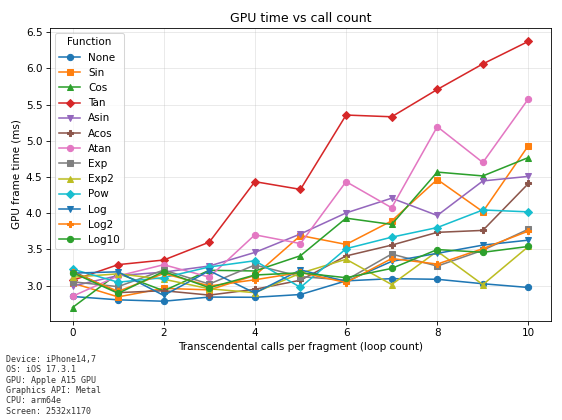
tan이 가장 부하가 높고, atan이 두 번째로 부하가 높았습니다.
4.6.3. iPhoneX
4.6.4. Galaxy S9
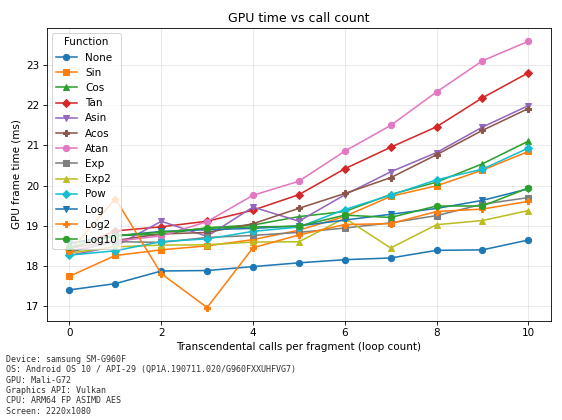
Atan의 부하가 가장 높은 것으로 보입니다.
4.6.5. 정리
| 기기 | 특이 사항 |
|---|---|
| iPhone 15 Pro | 실행 횟수가 7 미만인 경우 tan이 가장 무거움 실행 횟수가 7 이상인 경우 atan이 가장 무거움 |
| iPhone 14 | tan이 가장 무거움 |
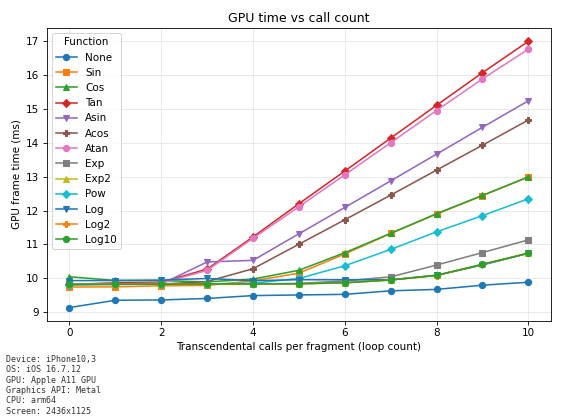
| iPhone X | tan이 가장 무거움 |
| Galaxy S9 | atan이 가장 무거움 |
4.7. sin 함수의 부하
초월 함수 중에서도 대표적인 sin 함수의 부하를 계측합니다.
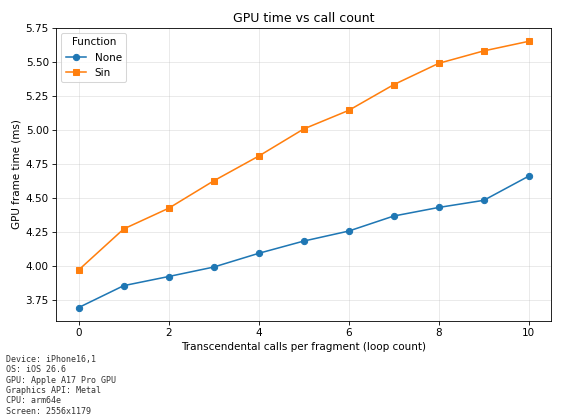
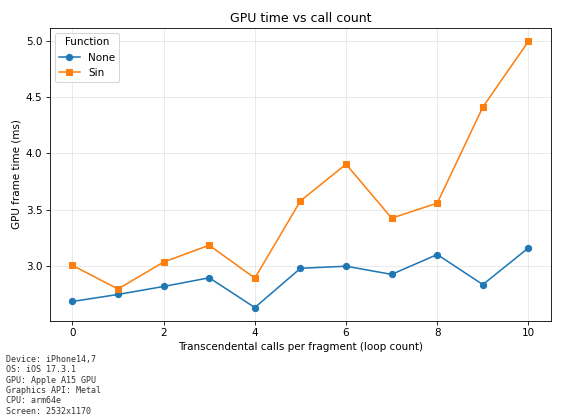
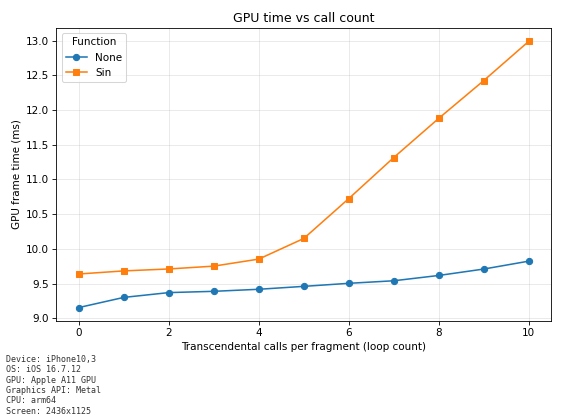
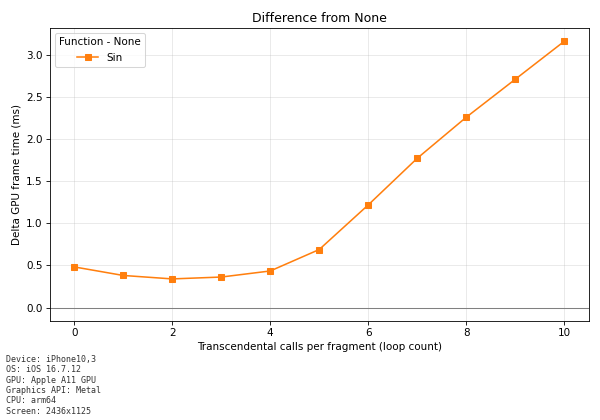
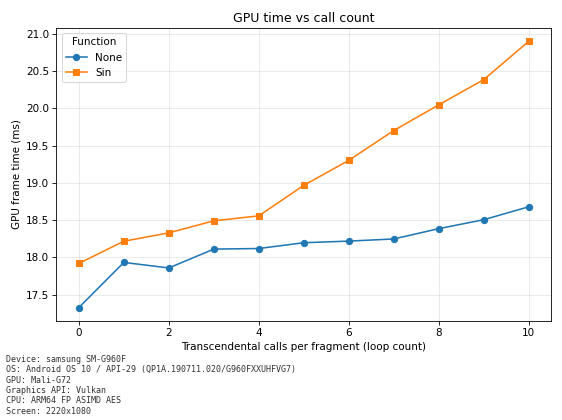
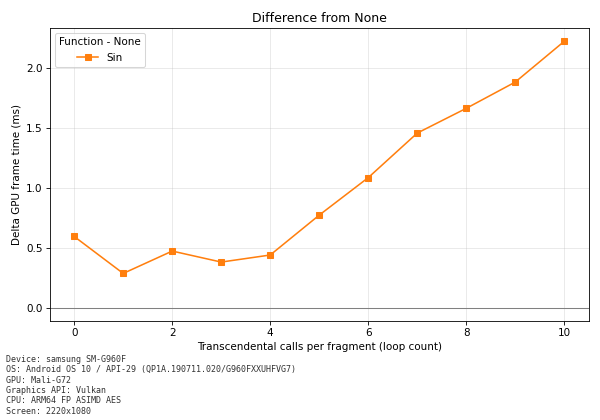
루프 횟수 0~10 각각에 대해 프레임 내 처리에 소요된 GPU 시간을 계측합니다. 각 계측 지점에서 10초간 계측을 수행하고, GPU 시간을 그래프로 정리했습니다.
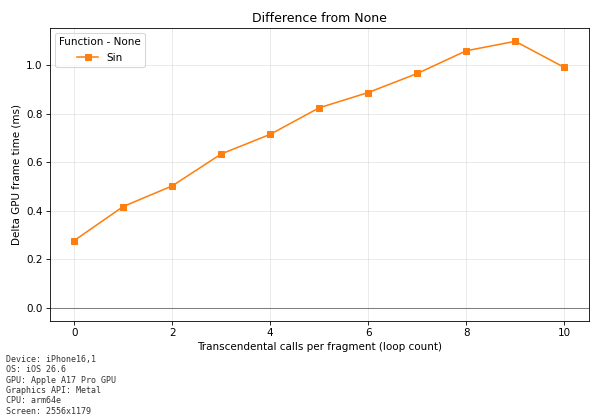
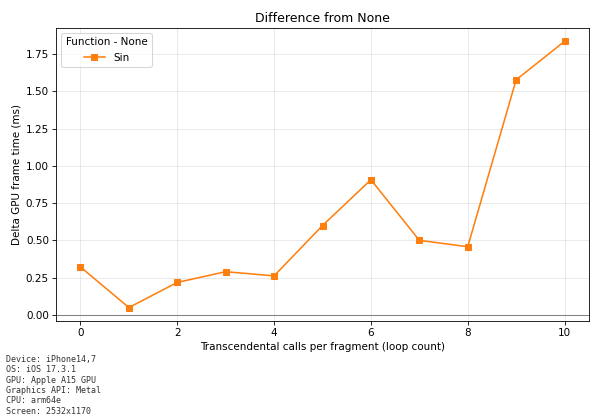
첫 번째 그래프: 루프 횟수에 따른 GPU 시간두 번째 그래프: 루프 횟수에 따른 GPU 시간과 None의 차이.
계측에는 FrameTimingManager를 사용했습니다.
4.7.1. iPhone15 Pro
sin 명령이 셰이더 내에 존재하는 것만으로 0.25ms 정도 증가했습니다. sin 호출이 1회 늘어날 때마다 처리 부하가 0.1ms 정도 증가합니다.
4.7.2. iPhone14
sin 명령이 셰이더 내에 존재하는 것만으로 GPU 시간이 0.25ms 정도 증가했습니다. sin 호출이 1회 늘어날 때마다 처리 부하가 0.1~0.2ms 정도 증가합니다.
4.7.3. iPhoneX
sin 명령이 셰이더 내에 존재하는 것만으로 0.5ms 정도 증가했습니다. sin 호출이 4회까지라면 GPU 시간의 증가는 거의 보이지 않지만, 5회를 넘으면 sin 호출이 1회 늘어날 때마다 처리 부하가 0.6ms 정도 증가합니다.
4.7.4. Galaxy S9
sin 명령이 셰이더 내에 존재하는 것만으로 0.5ms 정도 증가했습니다. sin 호출이 4회까지라면 GPU 시간의 증가는 거의 보이지 않지만, 5회를 넘은 뒤에는 sin 호출이 1회 늘어날 때마다 처리 부하가 0.2~0.3ms 정도 증가합니다.
4.7.5. sin 함수 부하 정리
| 기기 | sin 함수에 의한 GPU 부하 증가 | 특이 사항 |
|---|---|---|
| iPhone 15 Pro | +0.25ms (베이스라인) | 호출 1회당 약 0.1ms 증가 |
| iPhone 14 | +0.25ms (베이스라인) | 호출 1회당 약 0.1~0.2ms 증가 |
| iPhone X | +0.5ms (베이스라인) | 5회를 넘으면 호출 1회당 약 0.6ms 증가 |
| Galaxy S9 | +0.5ms (베이스라인) | 5회를 넘으면 호출 1회당 약 0.2~0.3ms 증가 |
※ 표의 '베이스라인'은 셰이더 내에 sin 함수가 존재하는 경우의 초기 부하 증가를 가리킵니다.
셰이더 내의 sin 함수가 늘어나면, sin 함수를 실행하지 않아도 GPU 시간이 증가하는 것을 확인할 수 있었습니다. 이는 레지스터 압력에 의한 부하 증가로 생각됩니다.
4.8. sin 함수의 포물선 근사
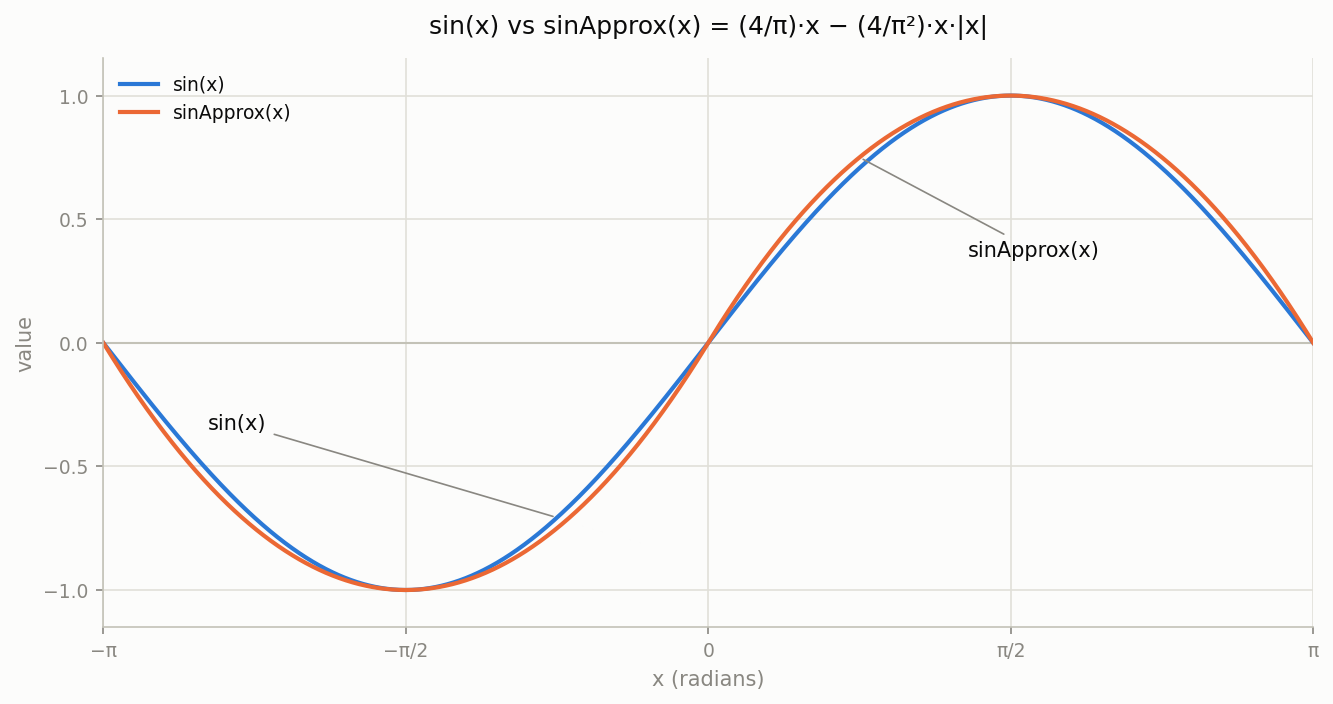
다음과 같은 다항식을 사용하여 sin을 근사하는 기법이 알려져 있습니다.
float sinApprox = (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
곱셈과 절댓값 abs()만으로 계산할 수 있으므로 매우 가볍습니다.
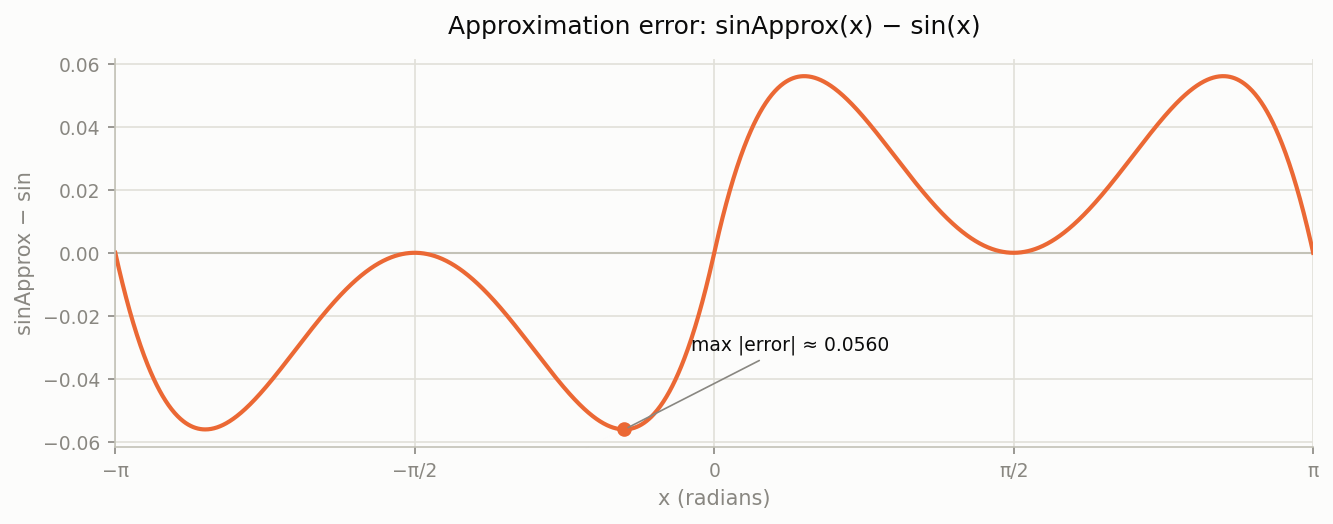
sin의 포물선 근사는 sin과 매우 가까운 값을 출력합니다(-PI<=x<=PI).
오차의 최댓값은 0.056 정도입니다.
4.9. sin 근사의 부하 계측
sin의 포물선 근사 sinApprox의 부하를 계측하여 그래프로 정리했습니다.
4.9.1. iPhone15 Pro
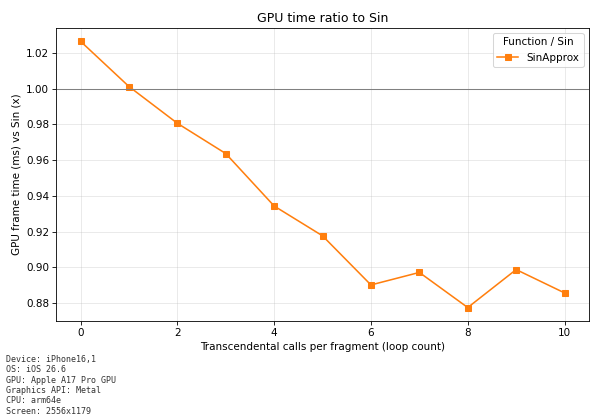
sin 함수보다 부하가 낮은 것을 확인할 수 있습니다.
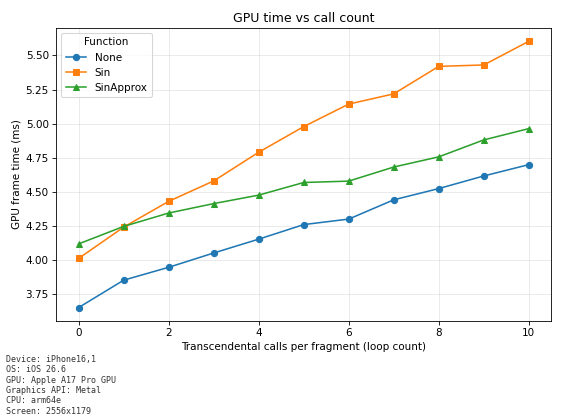
sin 함수와 근사 계산의 비교
함수를 10회 실행했을 때 부하가 약 0.6ms 낮아졌습니다.
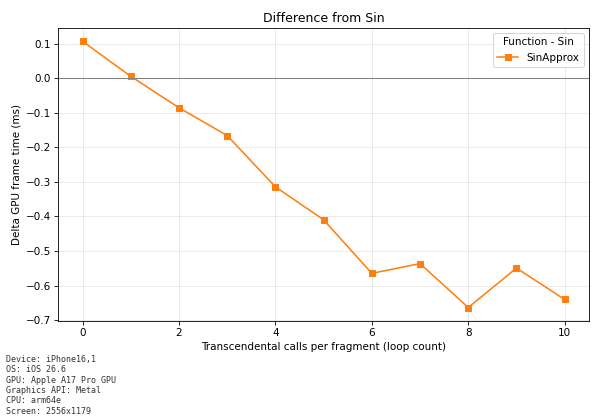
함수를 10회 실행했을 때 sinApprox의 부하는 sin의 90% 정도였습니다.
4.9.2. iPhone14
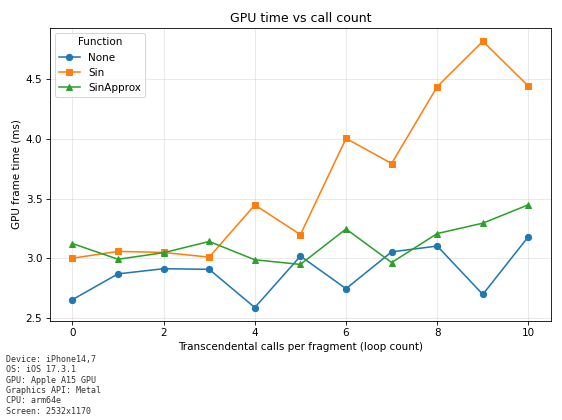
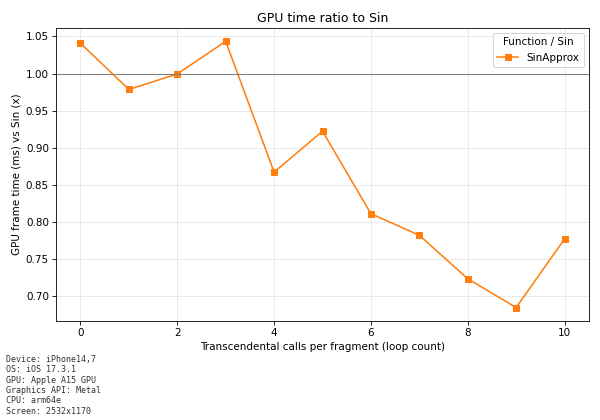
sin 함수와 근사 계산의 비교
함수를 10회 실행한 경우 GPU 시간이 약 1ms 짧아졌습니다.
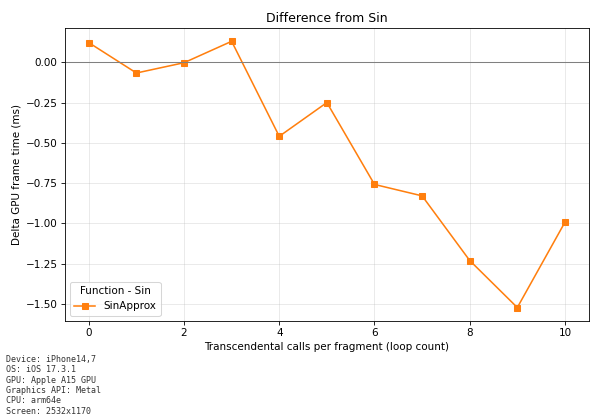
sinApprox를 10회 실행했을 때의 부하는 sin의 80% 정도였습니다.
4.9.3. iPhoneX
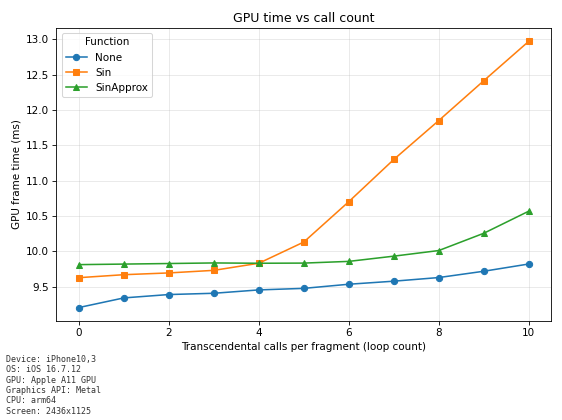
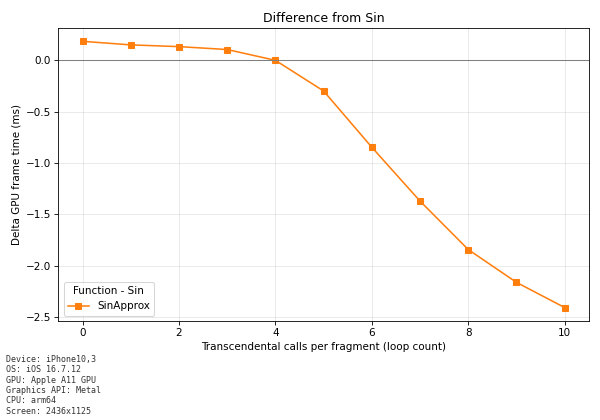
sin 함수와 근사 계산의 비교
sinApprox를 10회 실행했을 때의 부하는 sin을 실행했을 때와 비교하여 약 2.5ms 짧아졌습니다.
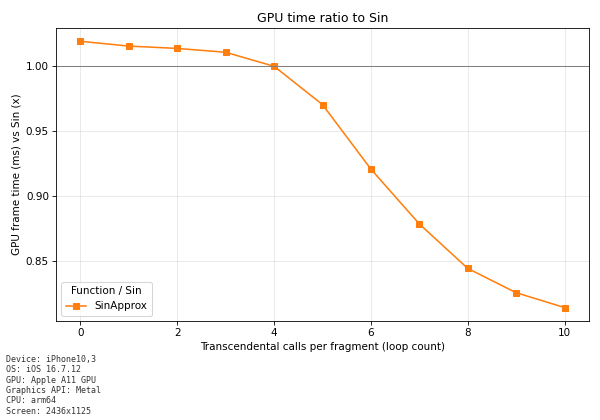
sinApprox를 10회 실행했을 때의 GPU 시간은 sin의 80% 정도였습니다.
4.9.4. Galaxy S9
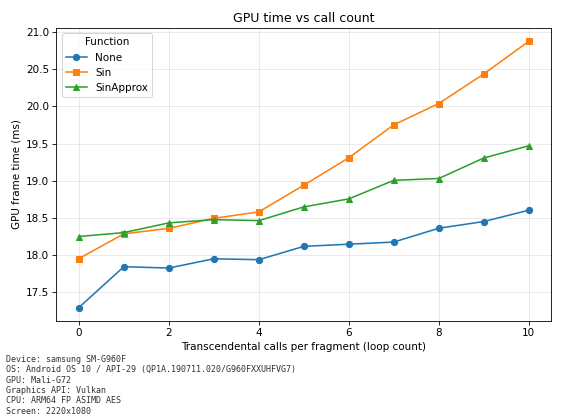
sin 함수와 근사 계산의 비교
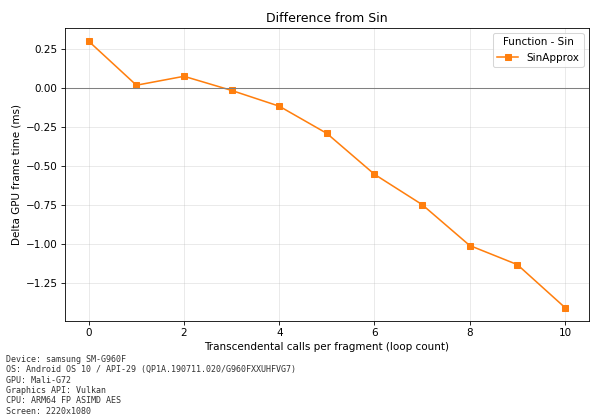
함수를 10회 실행한 경우 GPU 시간이 약 1.3ms 짧아졌습니다.
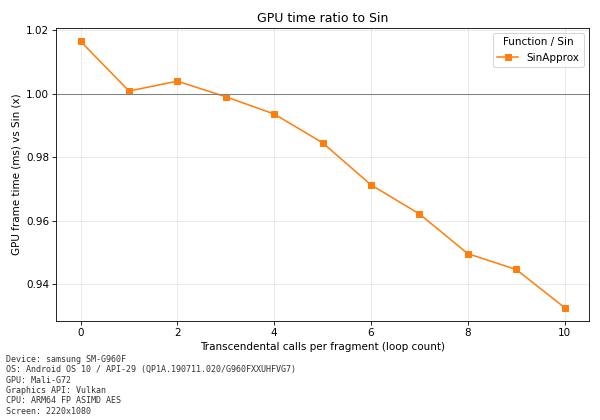
sinApprox를 10회 실행했을 때의 부하는 sin의 94% 정도였습니다.
4.9.5. sin 근사의 부하 정리
sinApprox에 의한 GPU 절감 효과를 표로 정리하면 다음과 같은 결과가 되었습니다.
| 기기 | sin 함수의 부하 | sinApprox에 의한 절감 효과 | 특이 사항 |
|---|---|---|---|
| iPhone 15 Pro | 기준 | 약 0.6ms 절감 | sinApprox의 부하는 sin의 약 90% |
| iPhone 14 | 기준 | 약 1.0ms 절감 | sinApprox의 부하는 sin의 약 80% |
| iPhone X | 기준 | 약 2.5ms 절감 | sinApprox의 부하는 sin의 약 80% |
| Galaxy S9 | 기준 | 약 1.3ms 절감 | sinApprox의 부하는 sin의 약 94% |
※ 절감 효과는 루프 횟수 10회에서의 GPU 시간 차이입니다.
4.10. tan 함수의 부하
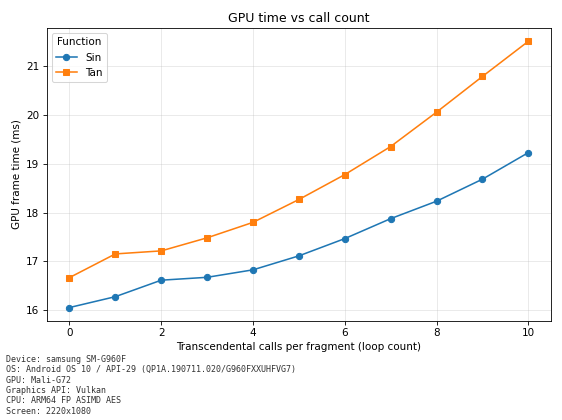
tan 함수의 부하도 계측했습니다. tan 함수 내부에서는 나눗셈이 호출되므로 sin 함수나 cos 함수보다 부하가 높습니다.
4.10.1. iPhone15Pro
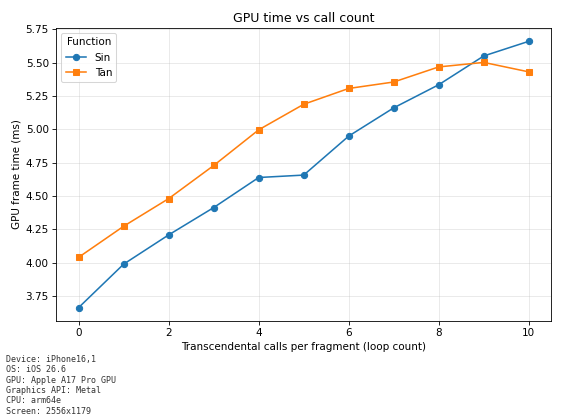
sin 함수보다 부하가 높지만, 실행 횟수가 9회를 넘으면 sin 함수의 부하가 더 높아졌습니다.
4.10.2. iPhone14
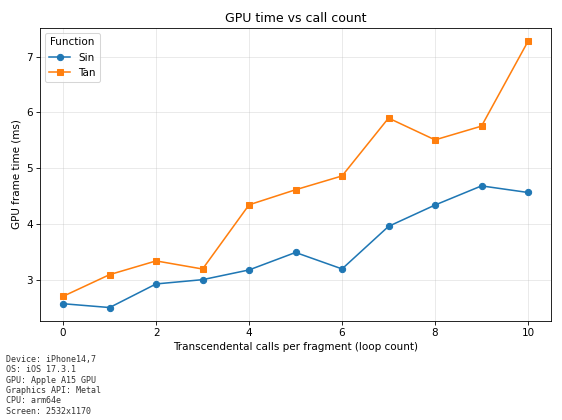
sin 함수보다 tan 함수의 부하가 더 높았습니다.
4.10.3. iPhoneX
sin 함수보다 tan 함수의 부하가 더 높았습니다.
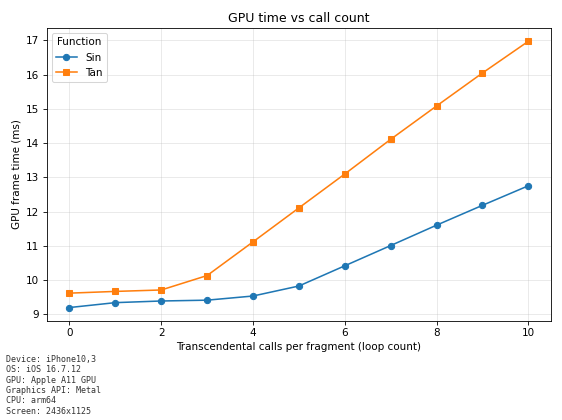
4.10.4. Galaxy S9
sin 함수보다 tan 함수의 부하가 더 높았습니다.
4.11. tan 함수의 근사
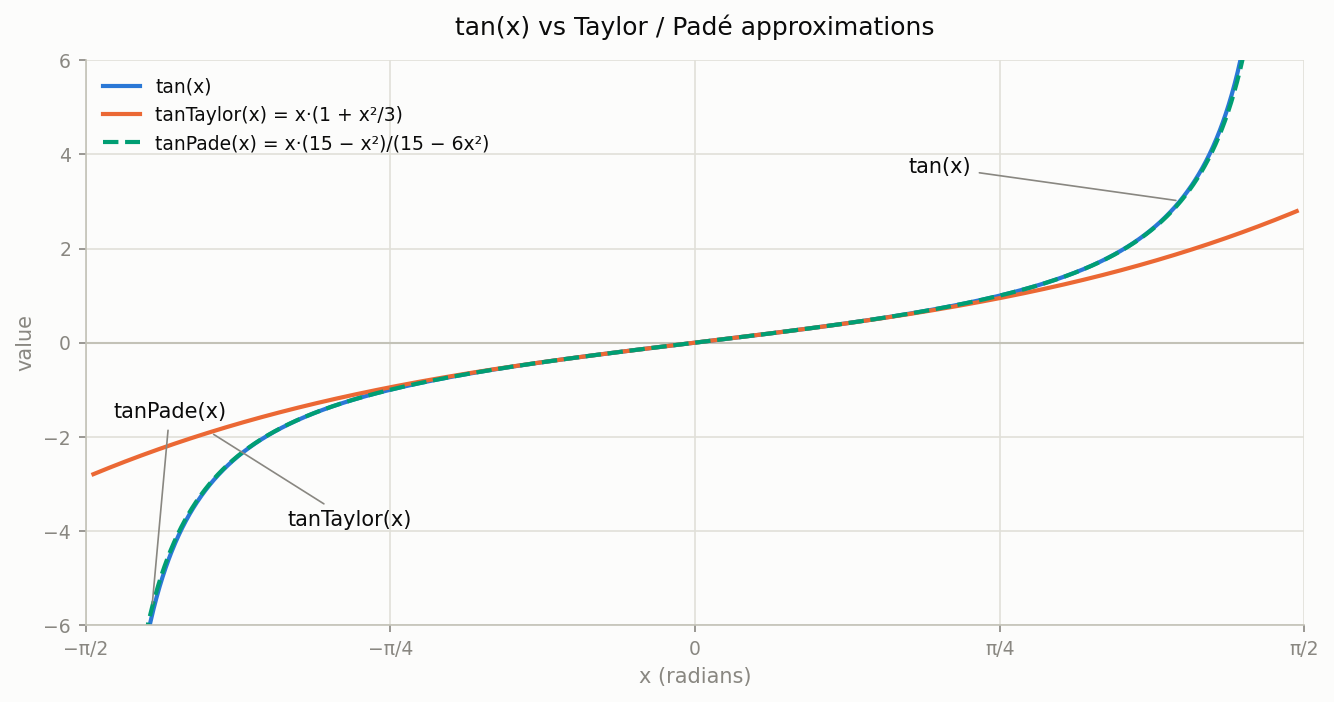
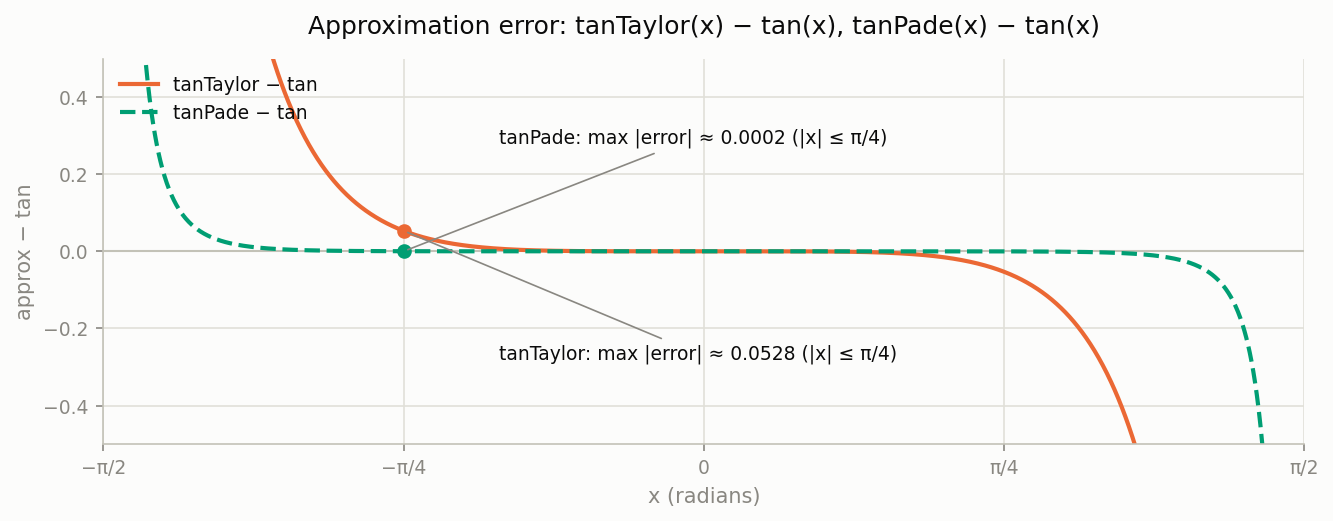
tan 함수의 근사 기법으로는 테일러 전개를 그대로 활용하는 방법과 파데 근사를 이용하는 방법이 있습니다. 테일러 전개는 부하가 낮지만 정밀도도 낮습니다. 파데 근사는 정밀도가 좋지만 부하도 높습니다.
4.11.1. 기법 1. 테일러 전개에 의한 근사
tan의 테일러 전개를 이용한 근사 계산입니다.
|x|가 PI/2에 가까워질수록 오차가 커집니다.
float tanTaylor(float x) {
    float x2 = x * x;
    return x * (1.0 + x2 * 0.3333333);
}
4.11.2. 기법 2. 파데 근사
tan의 파데 근사를 이용한 방법입니다.
|x| < PI/4 범위에서 tan(x)에 매우 가까운 값을 출력합니다.
float tanPade(float x) {
    float x2 = x * x;
    return x * (15.0 - x2) / (15.0 - 6.0 * x2);
}
4.12. tan 함수 근사 그래프
소개한 tanTaylor와 tanPade를 그래프로 그려 보았습니다.
tan 함수와의 오차
4.13. tan 함수 근사의 부하 계측
tan 함수의 근사 계산 부하를 계측했습니다.
4.13.1. iPhone15 Pro
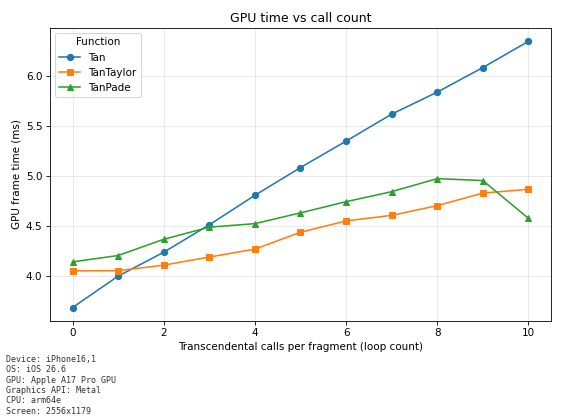
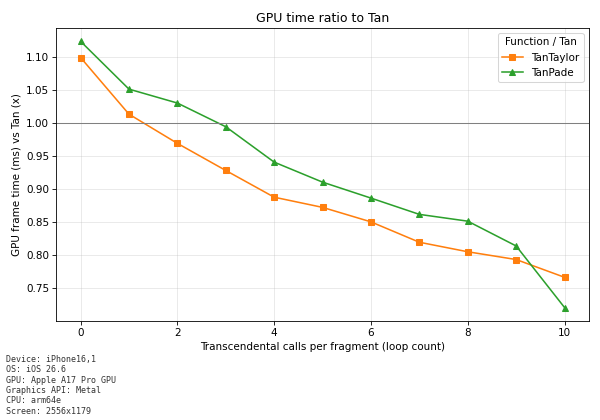
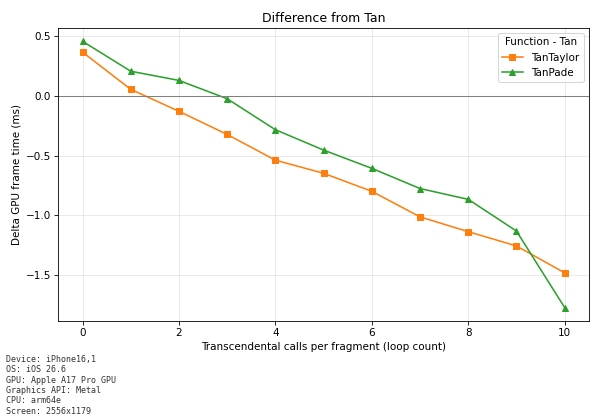
실행 횟수가 적은 경우에는 레지스터 압력에 의한 오버헤드가 두드러지지만, 실행 횟수가 늘어나면 근사 계산 쪽의 부하가 더 낮게 유지됩니다.
tan 함수와 근사 계산의 비교
함수를 10회 실행한 경우 근사 계산의 GPU 시간은 tan 함수의 80% 정도였습니다.
10회 실행했을 때 근사 계산 쪽이 처리 시간이 약 1ms 적었습니다.
4.13.2. iPhone14
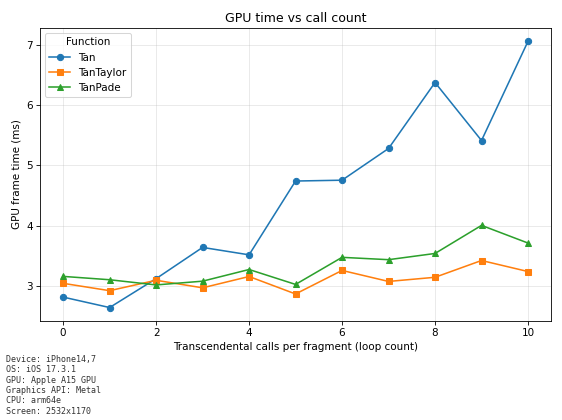
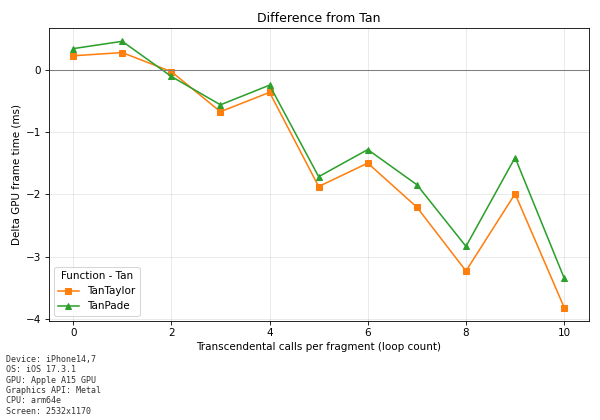
실행 횟수가 적은 경우에는 레지스터 압력에 의한 오버헤드가 약간 보입니다. 실행 횟수가 늘어나면 근사 계산 쪽의 부하가 더 낮게 유지됩니다.
tan 함수와 근사 계산의 비교 (iPhone14)
함수를 10회 실행한 경우 근사 계산의 GPU 시간은 tan 함수의 50% 정도였습니다.
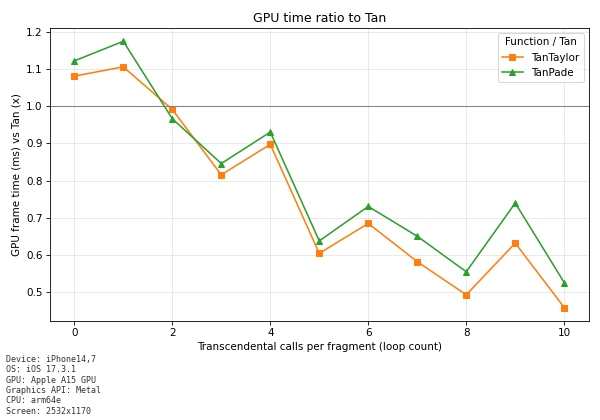
10회 실행했을 때 근사 계산 쪽이 처리 시간이 약 3ms 적었습니다.
4.13.3. iPhoneX
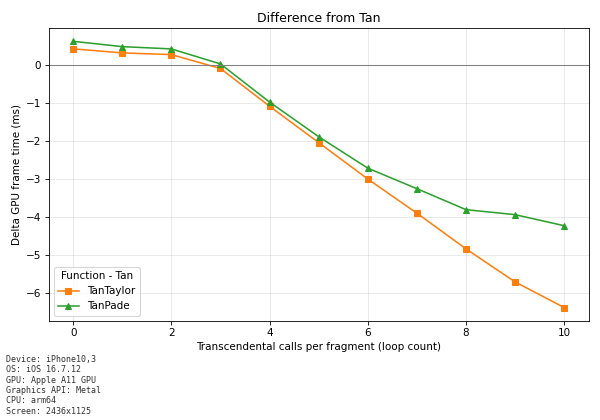
실행 횟수가 적은 경우에는 레지스터 압력에 의한 오버헤드가 약간 보입니다. 실행 횟수가 늘어나면 근사 계산 쪽의 부하가 더 낮게 유지됩니다. 테일러 전개의 경우 처리 부하의 증가는 거의 없지만, 파데 근사는 처리 부하가 약간 상승했습니다.
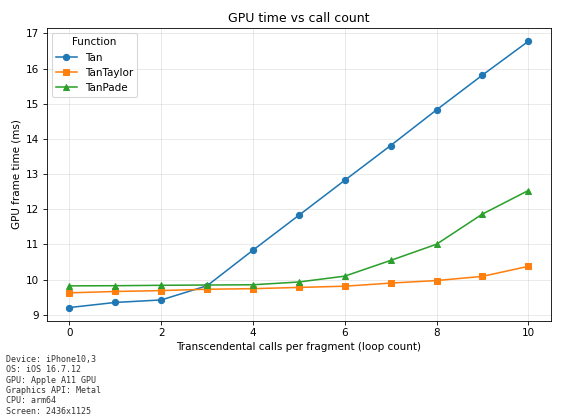
tan 함수와 근사 계산의 비교
함수를 10회 실행한 경우 테일러 전개의 GPU 시간은 tan 함수의 60% 정도였습니다. 파데 근사는 75% 정도의 GPU 시간이었습니다.
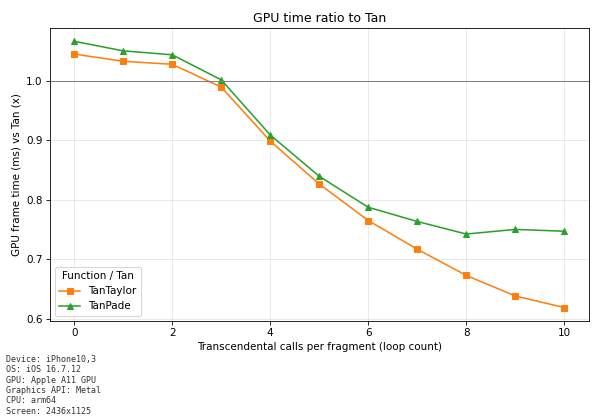
함수를 10회 실행했을 때 테일러 전개는 6ms 정도, 파데 근사는 4ms 정도 짧은 결과가 나왔습니다.
4.13.4. Galaxy S9
실행 횟수가 적은 경우에는 레지스터 압력에 의한 오버헤드가 약간 보입니다. 실행 횟수가 늘어나면 근사 계산 쪽의 부하가 더 낮게 유지됩니다.
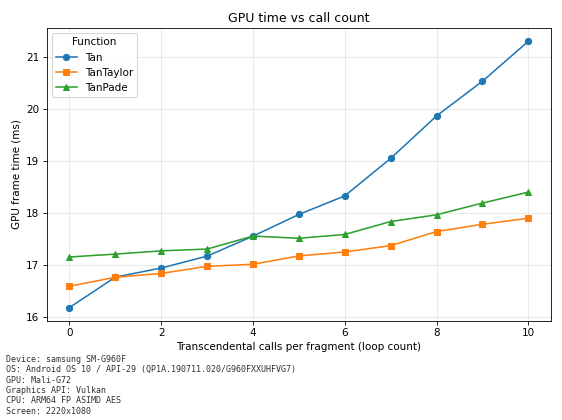
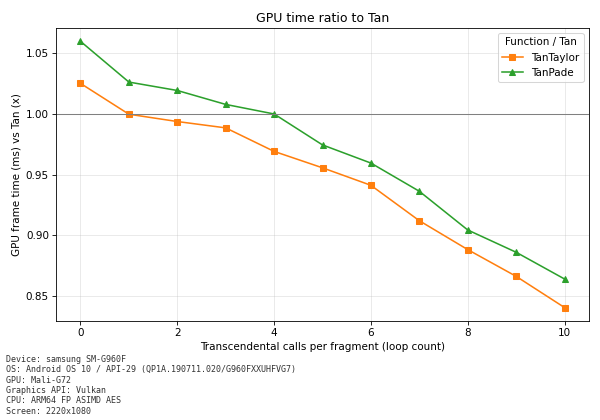
tan 함수와 근사 계산의 비교
함수를 10회 실행했을 때 근사 계산은 tan 함수의 85% 정도의 GPU 시간이었습니다.
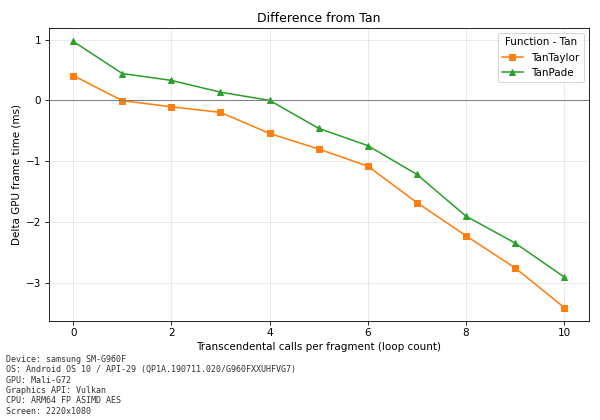
함수를 10회 실행했을 때 테일러 전개는 3ms 정도 짧은 결과가 나왔습니다.
4.13.5. tan 함수 근사의 부하 정리
| 기기 | GPU 부하의 경향 | 특이 사항 |
|---|---|---|
| iPhone 15 Pro | 근사 계산 쪽이 약 20% 낮음 | 근사 계산으로 약 1ms의 처리 시간 절감 |
| iPhone 14 | 근사 계산 쪽이 약 50% 낮음 | 근사 계산으로 약 3ms의 처리 시간 절감 |
| iPhone X | 근사 계산 쪽이 약 25~40% 낮음 | 테일러 전개는 약 6ms, 파데 근사는 약 4ms 절감 |
| Galaxy S9 | 근사 계산 쪽이 약 15% 낮음 | 근사 계산으로 약 3ms의 처리 시간 절감 |
※ 'GPU 부하의 경향'은 표준 tan 함수와 비교했을 때 근사 계산(테일러 전개 또는 파데 근사) 실행 시 GPU 시간의 대략적인 절감률입니다.