課題別の逆引きガイド
症状ごとに、まず見るべき値と、それを扱っている章を並べています。最初に計測の進め方を確認し、そのあと容量、メモリ、CPU、GPUの順に課題から引けるようにしました。
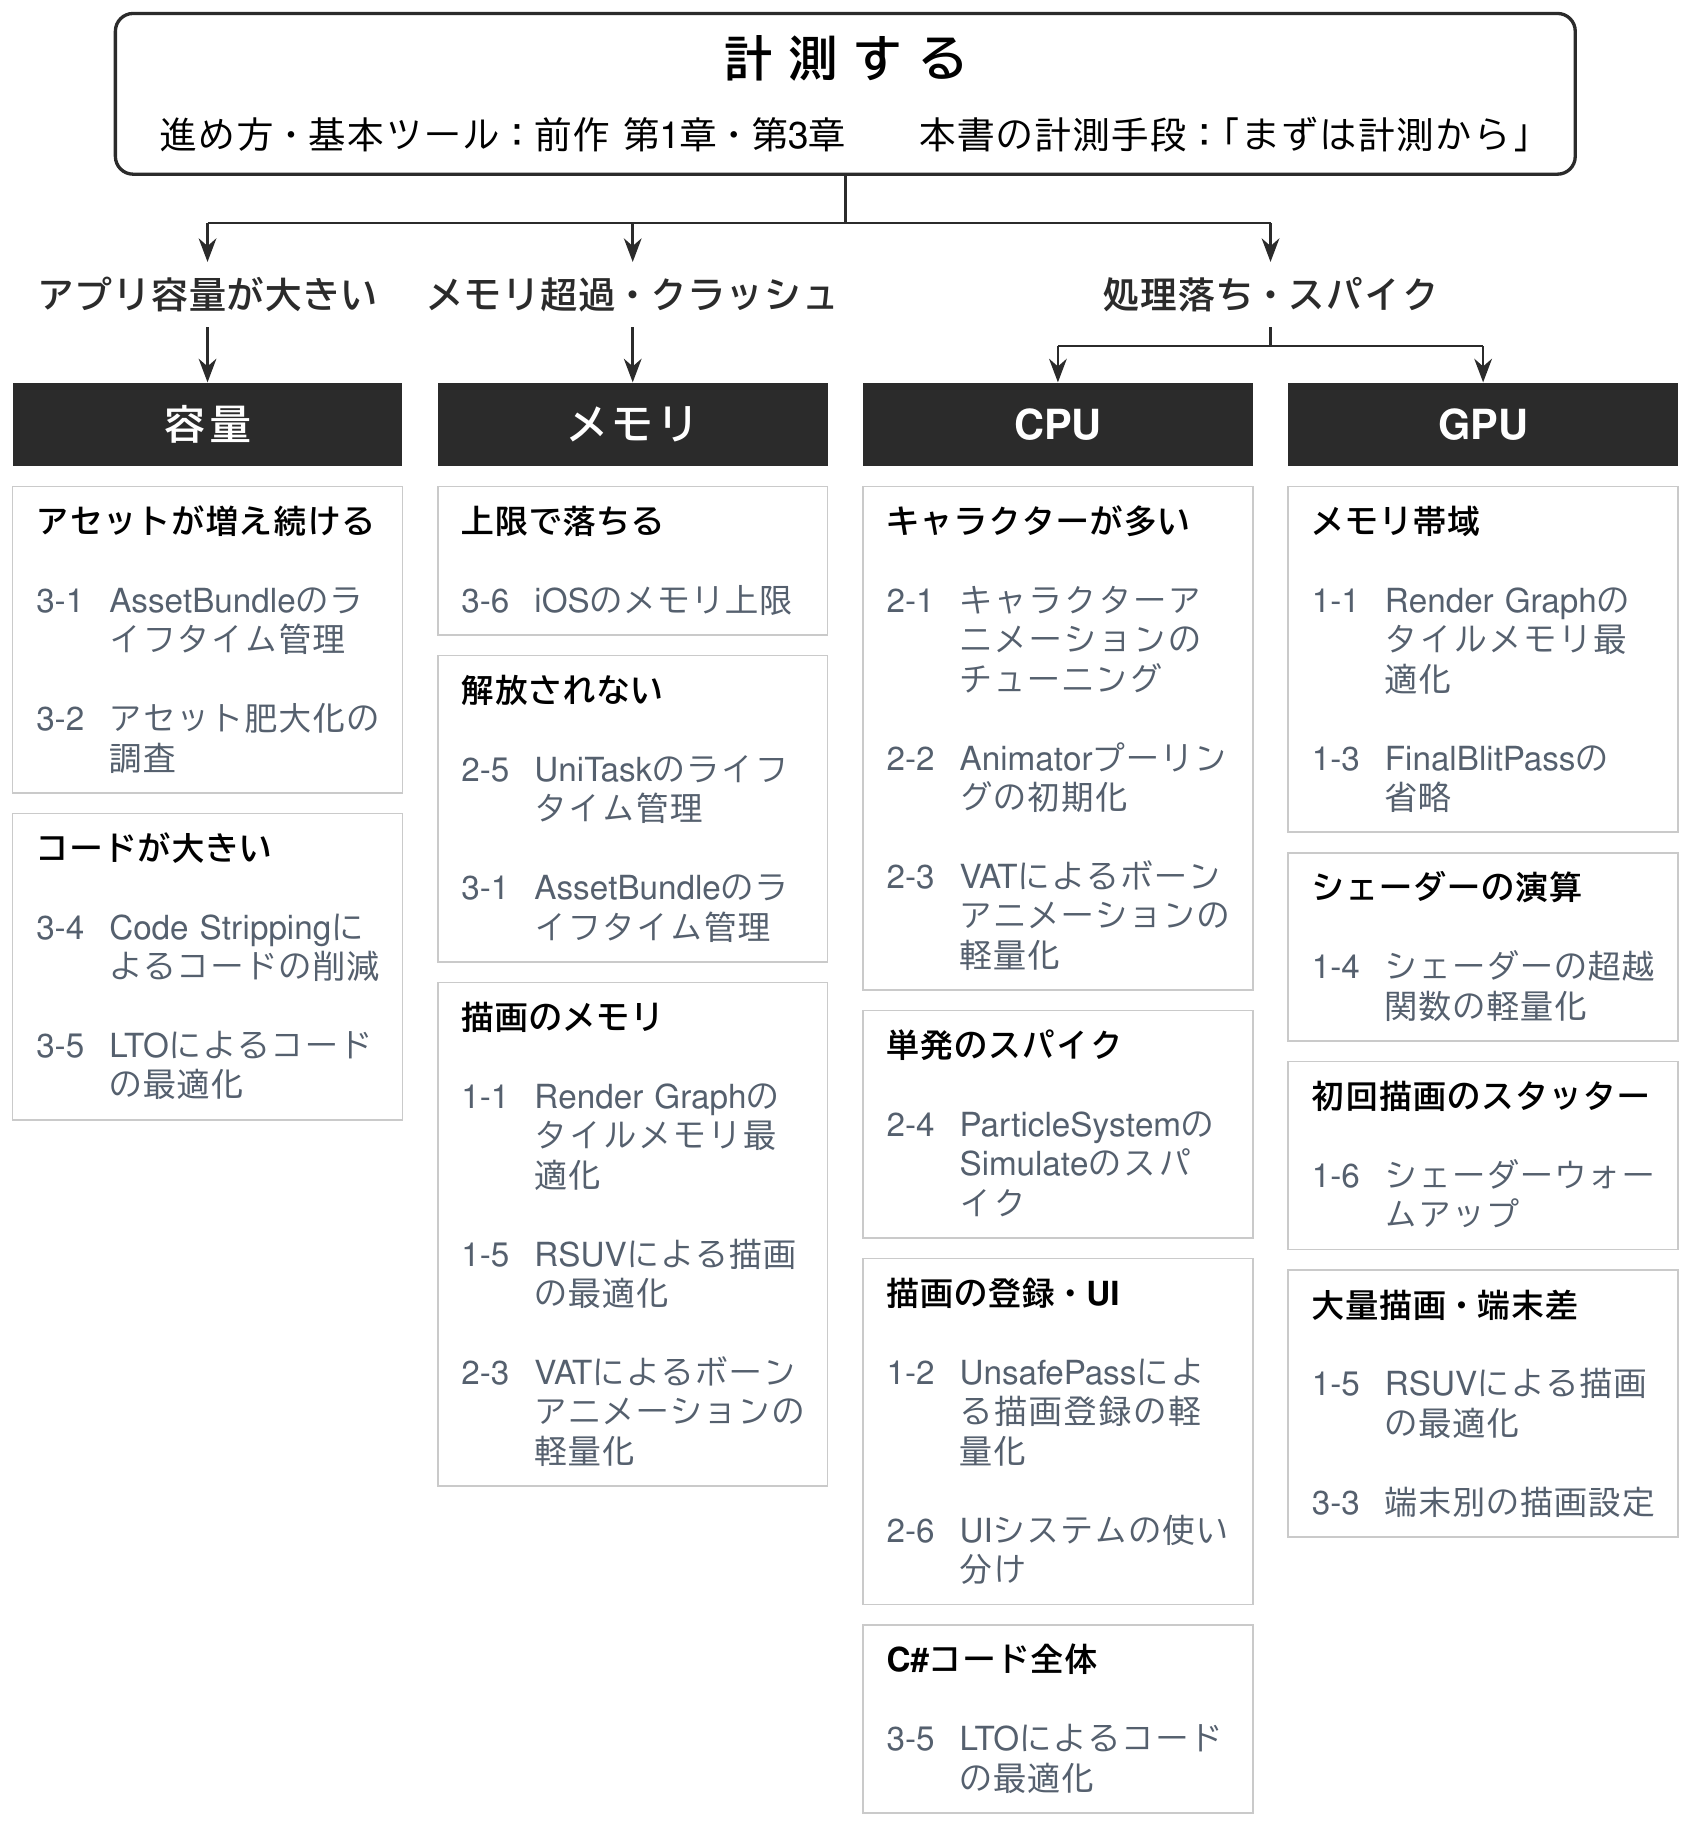
まずは計測から
どこが遅いのかを決めてから手を付けます。推測ではなく計測で原因を特定し、修正の前後で結果を比較するという進め方と、メモリ超過・処理落ちの切り分け方は、前作『Unity パフォーマンスチューニング バイブル』の第1章「パフォーマンスチューニングを始めよう」で解説しました。Unity ProfilerやFrame Debugger、RenderDocなどの基本的な使い方も第3章「プロファイリングツール」にまとめています。
ここでは、前作で扱っていない計測手段と、既存のツールで新たに確認できるようになった項目を紹介します。iOS向けであれば、Metal Performance HUDとPerformance TraceがDevelopment Buildフラグに依存せずに使えるため、計測処理をまだ組み込めていない段階でも、リリースに近い構成のままでも負荷の当たりを付けられます。
(第4部1章「Unityで活用するiOS標準のパフォーマンス計測機能」)
描画側は、計測の前にパイプラインの状態を確認しておきます。Frame Debuggerはイベント名の(RP n:m)表記でパスがマージされているかを示し、Render Graph Viewerは各アタッチメントのロード/ストアアクションとMemorylessの状態に加えて、マージされなかった理由(Pass Break Reasoning)まで表示します。Unityの表示とドライバに渡っている値を突き合わせたいときは、RenderDocでVulkanのキャプチャを取り、loadOp / storeOpをAPIレベルで確認します。
(第1部1章「Unity 6 Render Graphタイルメモリ最適化」)
計測そのものを毎日回す場合は、デバイスファームで借りた実機をアプリ内のリモート操作で画面遷移させ、メモリスナップショットとフィルタ済みのProfilerキャプチャをビルドごとに送る構成があります。端末上でフレームを絞り込む仕組みや閾値の決め方、長い巡回を端末の容量に収める工夫も併せて扱っています。
(第4部2章「デイリービルドの実機プロファイリングを自動化する」)
計測ではなくレビューの段階で効かせたい場合は、本書の知見そのものをAIコーディングエージェントの評価ルールへ変換する方法があります。前作の77ルールに本書からの86ルールを統合し、163ルールとしてスキル化した事例を紹介しています。
(第4部3章「チューニングバイブルをAIコーディングエージェントのスキルにする」)
容量
アプリ容量は、個々のアセットを絞る前に、増え方の原因を分類したほうが早く止まります。圧縮設定の誤り、解像度の過剰、余分な付随データ、形式の選択ミスの4つはImport時に判定できますが、まとめ方の不一致とバンドル間の重複は他のアセットとの関係で決まるため、ビルド前の検査が必要です。とくに重複は目に見えません。Addressablesに登録していない共有アセットは参照元のバンドルごとに複製されるため、4MBのテクスチャを2つのPrefabが参照しているだけで合計10MBになり、専用グループへ登録すれば6MBまで下がります。
(第3部2章「運用フェーズのアセット肥大化とProject Auditorによる調査」)
コード側にも削る余地があります。Managed Stripping LevelをMinimalからHighに上げると、終了処理のスクリプトを1つ置いただけのシンプルなシーンでも、マネージドアセンブリが約6.7%減りました。
(第3部4章「Unity Managed Code Stripping実践ガイド」)
そのうえで、どのアセットがいつまで必要かを設計として残します。ロードと解放の窓口を基盤へ集約し、ライフタイムの分類をAssetBundleの粒度とあわせて決めておくと、寿命の違うアセットが同じバンドルに混ざる状態を避けられます。
(第3部1章「AssetBundleのライフタイム管理」)
メモリ
iOSでは、Xcodeの設定を1つ有効にするだけで、アプリに適用されるメモリ上限が上がることがあります。提供された実機観測では、Increased Memory Limitによって4GB端末で約240MB、6GB端末で約1GBの余裕が増えました。ただし3GB端末では有効と無効で差がありませんでした。footprintに余裕があるのに確保が失敗する場合は、仮想アドレス空間側を広げるExtended Virtual Addressingが候補になります。
(第3部6章「iOSのメモリ上限と仮想アドレス空間」)
常駐量そのものを減らす側では、ロードしたアセットの解放漏れを最初に疑います。
(第3部1章「AssetBundleのライフタイム管理」)
非同期処理では、CancellationTokenSourceのDispose漏れがリンク元からの参照を残し、不要なオブジェクトが解放されない形で現れます。
(第2部5章「UniTaskとキャンセル処理のライフタイム管理」)
描画側のメモリは構造で決まります。アニメーションするオブジェクトを16体表示したときのGPUメモリの増分は、FBX方式が +411.8MB、Skin方式が +38.2MBで、VAT方式はほぼ増えませんでした。
(第2部3章「VATによるボーンアニメーション負荷軽減」)
マテリアルの複製もメモリを押し上げます。10000個のRendererにそれぞれマテリアルを持たせると15.79MB増えましたが、RSUVで値を渡せば増分は1.66KBで済みました。
(第1部5章「Renderer Shader User Valueを活用したグラフィックス最適化」)
ロードもストアもしないアタッチメントをメモリーレスにすれば、メインメモリ上に実体を持たずに済みます。
(第1部1章「Unity 6 Render Graphタイルメモリ最適化」)
ビルド設定では、Managed Code Strippingによって未使用コードをそもそもメモリに乗せずに済みます。
(第3部4章「Unity Managed Code Stripping実践ガイド」)
CPU
キャラクターを多数出す場面では、Transform階層の扱いが効きます。Optimize Game Objectsで階層をフラット化すると、300体の構成でメインスレッドのMeshSkinning.Updateが6.23msから約1.5msへ減り、スキニング行列の計算は全スレッド合計36.6msが完全に消えました。Playable Graphの手動更新はグラフ単位でしか並列化されないため、600体を1グラフにまとめると8.396msが4.500msになります。IKはメインスレッドで解かずにAnimation Jobへ移すと、300体が64回ずつ解く構成で9.094msが2.795msになりました。効いているのはBurstではなく、実行スレッドを移したことです。
遠景のキャラクターは、Nフレームに1回だけ更新します。Animator.Update()を個別に呼ぶより、Animator.enabledの切り替えや位相ごとの手動グラフでUnityの一括更新に戻したほうが安く、600体を2フレームに1回にすると5.037msが3.082msになりました。更新する体をフレームごとにずらしておけば、4フレームに1回の更新でもp95が9.470msから2.707msに収まり、スパイクになりません。
(第2部1章「Unity 3Dキャラクターアニメーションのチューニング」)
ボーンの更新そのものを事前計算へ置き換えるVATでは、16体表示時のCPUメインスレッドが154.3msから12.6msになりました。インスタンシングによって描画コマンドが1フレームあたり約21万から99に減り、SRPBatcher.Flushの76.17msがほぼ消えたことが効いています。
(第2部3章「VATによるボーンアニメーション負荷軽減」)
プールから戻ってきたAnimatorの初期化も、この設計に含めて考えます。
(第2部2章「ResetControllerStateでAnimatorプーリングを安全に行う」)
単発の大きなスパイクは、別の探し方をします。Noiseモジュールを有効にしたParticleSystemにParticleSystem.Simulate(20f, false, false)のような大きな秒数を渡すと、NoiseJobが約2000回呼ばれ、約50msのスパイクが発生しました。
(第2部4章「ParticleSystemで長い時間Simulateをすると巨大なスパイクが発生する」)
描画の登録コストもCPU負荷です。マージできないPassチェーンを1つのUnsafePassにまとめると、RasterRenderPass 1つあたり約1.8µsの固定コストを削減できます。100パスのピンポンBlurでは、1080.7µsが898.5µsになりました。
(第1部2章「RenderGraphのUnsafePassを使うべき場面」)
大量描画では、マテリアルを複製せずにオブジェクトごとの値を渡せるRSUVが効きます。iPhone 12でSphere 10000個のパラメータを毎フレーム変える計測では、Rendererごとのマテリアルが8.1FPSだったのに対し、RSUVとGPU Resident Drawerの併用では60.0FPSを保ちました。
(第1部5章「Renderer Shader User Valueを活用したグラフィックス最適化」)
UIでは、要素を1つ変えるとCanvas全体のメッシュが作り直されるuGUIに対し、UI Toolkitは変化した部分だけを更新します。
(第2部6章「UIシステムの使い分け — IMGUI / uGUI / UI Toolkit」)
C# コード全体に効く手段としてはLTOがあります。AndroidではReleaseビルドに-flto=thinを加えるだけで、ベンチマークの直接呼び出しが21.8%短縮し、Master(-O2)へ切り替えたときの5.9%を大きく上回りました。実タイトルの定常画面ではUnityMainが3.21%短縮でした。
(第3部5章「UnityのLTO設定とAndroid・iOSでの性能比較」)
GPU
モバイルでは、GPUの演算性能より先にメモリ帯域がボトルネックになります。1080pのRGBA8を1回ストアして次のパスでロードするだけで往復約16MB、60FPSなら約950MB/sを消費します。これを削る手段が、ロード/ストアアクションの明示、パスのマージ、フレームバッファフェッチ、メモリーレスの4つで、いずれもリソースの使い方をRender Graphへ正しく伝えることが条件になります。
たとえば全画素を必ず上書きするパスは、AccessFlags.WriteAllで宣言するだけで、1080pなら約8MB/フレームのロードがなくなります。ディファードのG-Bufferをフレームバッファフェッチで読めば、3枚分のストアだけで約24MB/フレーム、60FPSで約1.4GB/sの帯域を削れます。MSAAはStoreではなくResolveにすると、タイルメモリ上で解決され、4サンプル分のバッファをメモリーレスにできます。
(第1部1章「Unity 6 Render Graphタイルメモリ最適化」)
最後に1回だけ走るフルスクリーンのBlitも、高解像度では無視できないコストです。AfterRenderingPostProcessing以降にカスタムパスを注入するとURPのFinalBlitPassがほぼ必ず追加されますが、Unity 6.3からは最後のカメラの最終パスでSwitchActiveTexturesToBackbuffer()を呼べば、直接BackBufferへ出力して省略できます。カスタムFXAAの例では、Unity 6.0で2回必要だったBlitが1回になり、中間テクスチャも不要になりました。
(第1部3章「URPのFinalBlitPassを省略する方法」)
シェーダーの中身では超越関数が目立ちます。sinは乗算とabs()だけの放物線近似に置き換えられ、10回実行時にiPhone Xで約2.5ms、Galaxy S9で約1.3msのGPU時間を削減しました。tanの近似は10回実行時にGPU時間が本来の80%(iPhone 15 Pro)や50%(iPhone 14)になりました。ただし実行回数が少ないうちはレジスタープレッシャーによるオーバーヘッドが目立ちます。
(第1部4章「モバイル向けシェーダー最適化:超越関数の計測と軽量化」)
初回描画時のスタッターは、GPU側のコンパイルが原因です。MetalやVulkanでは1回のPSO生成に数十ミリ秒かかることがあり、GraphicsStateCollectionで任意のタイミングに済ませます。WarmUpProgressively()で1フレームあたりの件数を指定すれば、ウォームアップ自体のスパイクも避けられます。導入後もスタッターが残る場合は、Shader Strippingによるバリアントの欠落やメタデータの不一致を疑います。iOSでは、シェーダーを1つのバンドルにまとめて二重に読み込まれるのを防ぎ、SubPassを使うシェーダーはロード画面で一度描画してPSOを作っておきます。
(第1部6章「GraphicsStateCollectionによるシェーダーウォームアップ」)
それでも収まらない場合は、端末に応じて描画設定そのものを切り替えます。deviceModel、graphicsDeviceName、systemMemorySizeで端末を判定し、Quality Levelを切り替えるか、RenderPipelineAssetのrenderScaleや影のカスケード数を直接操作します。自作のRendererFeatureにも、一時テクスチャのフォーマットや解像度を下げる、Blitの数を減らす、簡易なシェーダーに置き換えるといった切り替え口を用意しておくと、同じ仕組みで負荷を調整できます。
(第3部3章「端末に応じた描画設定の切り替え」)