第4章 モバイル向けシェーダー最適化:超越関数の計測と軽量化
4.1 はじめに
シェーダー内で sin や exp などの超越関数を使用すると、GPUの処理負荷が高くなる傾向があります。本記事では、プロファイラの計測値を交えながら、これらの関数が実際のパフォーマンスにどの程度の影響を及ぼすのかを解説します。また、超越関数を近似計算に置き換える最適化手法を取り上げ、実際にどの程度の負荷削減効果が得られるのかを実測値とともに紹介します。
4.2 環境
この記事で使用したUnityバージョン、レンダーパイプライン、使用した端末は以下の通りです。
| Unityバージョン | Unity6000.3.20f1 |
|---|---|
| レンダーパイプライン | Universal Render Pipeline 17.3.0 |
| iOS端末 | iPhoneX iPhone14 iPhone15 Pro |
| Android端末 | Galaxy S9 |
4.3 超越関数
超越関数(ちょうえつかんすう)とは、有限回の四則演算や累乗根では表せない関数のことです。代表的な例として、三角関数、指数関数、対数関数が挙げられます。
- sinやcosなどの三角関数
- pow, pow2などの指数関数
- log, log10などの対数関数
超越関数は負荷が高いため、多用することは避けることが望ましいとされています。
4.3.1 超越関数が重い理由
超越関数が重い理由は以下の3つです。
- クロック数が多い
- 超越関数の演算を行うユニット(SFU)の数が少ない
- レジスタプレッシャーによるオーバーヘッド
4.3.2 理由1 : クロック数が多い
スマートフォンなどに搭載されているGPUは、算術演算を行うための演算ユニット(ALU)を多く搭載しています。ALUは、加算や乗算を1クロックサイクルで実行できるように設計されています。
しかし、超越関数は1回の命令で計算できる単純なものではありません。GPU内部で超越関数を計算する際、テイラー展開やミニマックス法などの多項式近似アルゴリズムを用いて、多数の加算と乗算の組み合わせに分解して計算しています。
単純な四則演算が「1命令」で終わるのに対し、超越関数はコンパイラによって「数十命令の四則演算」に展開されるため、処理時間が長くなります。
4.3.3 理由2 : SFUの数が少ない
多くのGPUには超越関数などを高速に処理するための SFU (Special Function Unit) という専用ハードウェアが搭載されており、超越関数がSFUにて実行されることもあります。
SFUの数はALUに比べて非常に少ないため、SFUを用いて超越関数を実行した場合でも処理に長い時間がかかります。
4.3.4 理由3 : レジスタープレッシャーによるオーバーヘッド
sin() のような超越関数は、単純な足し算や掛け算と比べて計算が複雑であり、GPUの内部で計算を行うために、より多くの一時的なレジスタを必要とします。
GPUの各演算ユニット(SM: Streaming Multiprocessor)が持つレジスタの総量は物理的に決まっており、1スレッドあたりの消費レジスタ数が増える(レジスタプレッシャーが高まる)ため、1つのSMに詰め込めるスレッドの数が減ります。
一度に実行できるスレッド数が減るため、処理に長い時間がかかってしまいます。
4.4 様々な関数の負荷
ループ回数0〜 10それぞれについて、様々な超越関数を実行した時のGPU時間を計測し、どの超越関数が最も重いのかを調べてみることにします。GPU時間の計測にはFrameTimingManagerを使用しています。
4.5 負荷計測に使用したシェーダー
計測には、次のようなシェーダーを使用しました。シェーダーキーワードで実行対象の超越関数を選択することができ、変数 _LoopCount を使用して、ループ回数を変更できるようにしています。
Shader "Benchmark/Transcendental"
{
    Properties
    {
        // uGUI(CanvasRenderer)はテクスチャを "_MainTex" にバインドするので名前は固定
        [PerRendererData][MainTexture] _MainTex("Sprite Texture", 2D) = "white" {}
        [MainColor] _BaseColor("Tint", Color) = (1, 1, 1, 1)

        // Mask (UI/Mask) 用のステンシル設定。MaskコンポーネントがMaterialを差し替えて書き込む
        _StencilComp("Stencil Comparison", Float) = 8
        _Stencil("Stencil ID", Float) = 0
        _StencilOp("Stencil Operation", Float) = 0
        _StencilWriteMask("Stencil Write Mask", Float) = 255
        _StencilReadMask("Stencil Read Mask", Float) = 255

        _ColorMask("Color Mask", Float) = 15

        [Toggle(UNITY_UI_ALPHACLIP)] _UseUIAlphaClip("Use Alpha Clip", Float) = 0
    }

    SubShader
    {
        Tags
        {
            "Queue" = "Transparent"
            "RenderType" = "Transparent"
            "RenderPipeline" = "UniversalPipeline"
            "IgnoreProjector" = "True"
            "PreviewType" = "Plane"
            "CanUseSpriteAtlas" = "True"
        }

        Stencil
        {
            Ref [_Stencil]
            Comp [_StencilComp]
            Pass [_StencilOp]
            ReadMask [_StencilReadMask]
            WriteMask [_StencilWriteMask]
        }

        Cull Off
        ZWrite Off
        ZTest [unity_GUIZTestMode]
        Blend SrcAlpha OneMinusSrcAlpha
        ColorMask [_ColorMask]

        Pass
        {
            HLSLPROGRAM

            #pragma vertex vert
            #pragma fragment frag
            // ループ回数がuniform(動的ループ)なので 2.0 ではなく 3.0 が必要
            #pragma target 3.0

            // RectMask2D / Mask のAlpha Clip対応
            #pragma multi_compile_local _ UNITY_UI_CLIP_RECT
            #pragma multi_compile_local _ UNITY_UI_ALPHACLIP

            // 計測する超越関数の切り替え。実行時に Shader.EnableKeyword で切り替えたいので
            // shader_feature(未使用variantが剥がれる)ではなく multi_compile を使う。
            // キーワードごとに別variantになるため、生成コードには選んだ関数だけが出る(分岐オーバーヘッド無し)。
            // グローバルキーワードなので TranscendentalBenchmark 側から一括で制御できる。
            // キーワードが1つも立っていない場合は先頭の _FUNC_NONE のvariantが使われる。
            #pragma multi_compile_fragment _FUNC_NONE _FUNC_SIN _FUNC_SIN_APPROX _FUNC_COS _FUNC_TAN _FUNC_TAN_TAYLOR _FUNC_TAN_PADE _FUNC_ASIN _FUNC_ACOS _FUNC_ATAN _FUNC_EXP _FUNC_EXP2 _FUNC_POW _FUNC_LOG _FUNC_LOG2 _FUNC_LOG10

            #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"

            struct Attributes
            {
                float4 positionOS : POSITION;
                float4 color : COLOR;
                float2 uv : TEXCOORD0;
                UNITY_VERTEX_INPUT_INSTANCE_ID
            };

            struct Varyings
            {
                float4 positionHCS : SV_POSITION;
                float2 uv : TEXCOORD0;
                float4 positionOS : TEXCOORD1; // _ClipRect と同じ空間(Canvasローカル)で保持
            };

            TEXTURE2D(_MainTex);
            SAMPLER(sampler_MainTex);

            CBUFFER_START(UnityPerMaterial)
                half4 _BaseColor;
            CBUFFER_END

            // TranscendentalBenchmark から設定するグローバル値。
            // マテリアル単位の値ではないので UnityPerMaterial には入れない(入れるとSRP Batcherが壊れる)
            int _TranscendentalLoopCount;
            float _PowExponent;

            // UnityUI.cginc の UnityGet2DClipping 相当(HLSLで自前定義)
            float Get2DClipping(float2 position, float4 clipRect)
            {
                float2 inside = step(clipRect.xy, position.xy) * step(position.xy, clipRect.zw);
                return inside.x * inside.y;
            }

            // 超越関数へ渡す値を (0.05, 0.95) に収める。
            // asin/acos の定義域 |x| <= 1、log系の定義域 x > 0、exp系のオーバーフローを
            // まとめて回避する。全variant共通の前処理なので、コストは差分では相殺される。
            float PrepareInput(float seed)
            {
                return seed;
                // return frac(seed) * 0.9 + 0.05;
            }

            float sinApprox(float x)
            {
                // sinの放物線近似。乗算とabsだけで済むので、本物のsin命令とのコスト差を見る。
                // 定義域は |x| <= PI(PrepareInputの出力はこの範囲に収まる)。
                // 係数は定数畳み込みされるので、実行時の除算コストは無い。
                return (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
            }

            float tanTaylor(float x)
            {
                // tanのテイラー展開の3次まで(乗算のみ)。本物のtan命令とのコスト差を見る。
                // 定義域は |x| < PI/2 で、π/4を超えると急速に精度が落ちる。
                float x2 = x * x;
                return x * (1.0 + x2 * 0.3333333); // 1.0/3.0
            }

            float tanPade(float x)
            {
                // tanのパデ近似(乗算+除算1回)。定義域は |x| < PI/2。
                // 分母の零点 x ≈ ±1.581 が tan の極 ±PI/2 の近くにあるため、極付近まで追従する。
                float x2 = x * x;
                return x * (15.0 - x2) / (15.0 - 6.0 * x2);
            }

            // 計測対象の超越関数。キーワードごとに1つだけが残るので、
            // 生成コードには選んだ関数の展開結果だけが現れる。
            float Transcendental(float x)
            {
                #if defined(_FUNC_SIN)
                    return sin(x);
                #elif defined(_FUNC_SIN_APPROX)
                    return sinApprox(x);
                #elif defined(_FUNC_COS)
                    return cos(x);
                #elif defined(_FUNC_TAN)
                    return tan(x);
                #elif defined(_FUNC_TAN_TAYLOR)
                    return tanTaylor(x);
                #elif defined(_FUNC_TAN_PADE)
                    return tanPade(x);
                #elif defined(_FUNC_ASIN)
                    return asin(x);
                #elif defined(_FUNC_ACOS)
                    return acos(x);
                #elif defined(_FUNC_ATAN)
                    return atan(x);
                #elif defined(_FUNC_EXP)
                    return exp(x);
                #elif defined(_FUNC_EXP2)
                    return exp2(x);
                #elif defined(_FUNC_POW)
                    // 指数を定数にすると pow(x, 2) -> x * x のように畳まれてしまうので、
                    // uniform を渡して汎用のpow経路を通す
                    return pow(x, _PowExponent);
                #elif defined(_FUNC_LOG)
                    return log(x);
                #elif defined(_FUNC_LOG2)
                    return log2(x);
                #elif defined(_FUNC_LOG10)
                    return log10(x);
                #else // _FUNC_NONE : 超越関数なしのベースライン
                    return x;
                #endif
            }

            Varyings vert(Attributes IN)
            {
                Varyings OUT;
                OUT.positionOS = IN.positionOS;
                OUT.positionHCS = TransformObjectToHClip(IN.positionOS.xyz);
                OUT.uv = IN.uv * 300.0;
                return OUT;
            }

            half4 frag(Varyings IN) : SV_Target
            {
                // ここが計測対象(見た目に意味は無い)。
                // UNITY_LOOP でループ展開を抑止し、_TranscendentalLoopCount 回ぶんのコストがそのまま乗るようにする。
                // 超越関数の中身以外はどのvariantでも完全に同じ形なので、
                // _FUNC_NONE との差分がその関数のコストになる。
                float accum = 0.0;

                UNITY_LOOP
                for (int i = 0; i < _TranscendentalLoopCount; i++)
                {
                    // ループ不変式にすると外へ巻き上げられてしまうので、iを引数に混ぜる
                    float x = IN.uv.x + i * 0.017;

                    accum += Transcendental(x);
                }
                return half4(saturate(accum.xxx) * 0.02, 1);
            }
            ENDHLSL
        }
    }
}
4.6 計測結果
4.6.1 iPhone15 Pro
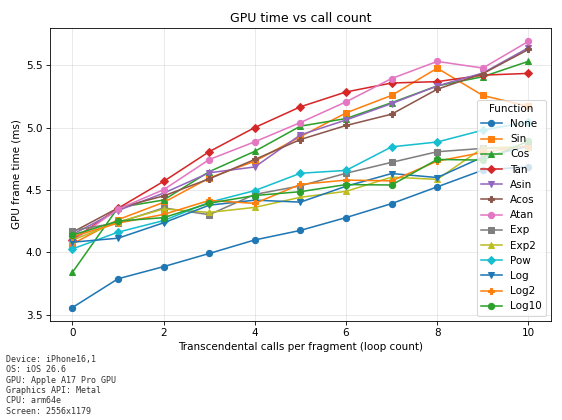
実行回数が7未満の場合はtanが最も重く、実行回数が7以上の場合はAtanが最も重くなりました。
4.6.2 iPhone14
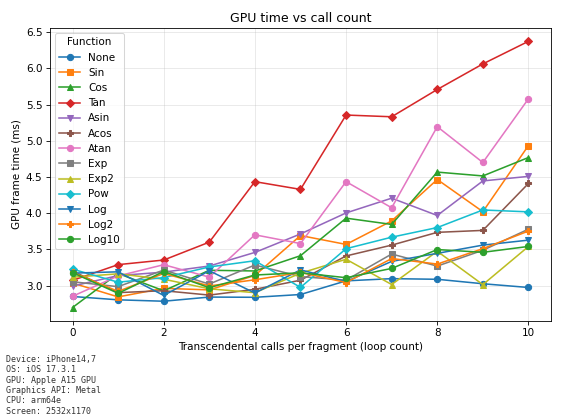
tanが最も負荷が高く、atanは2番目に負荷が高くなりました。
4.6.3 iPhoneX
4.6.4 Galaxy S9
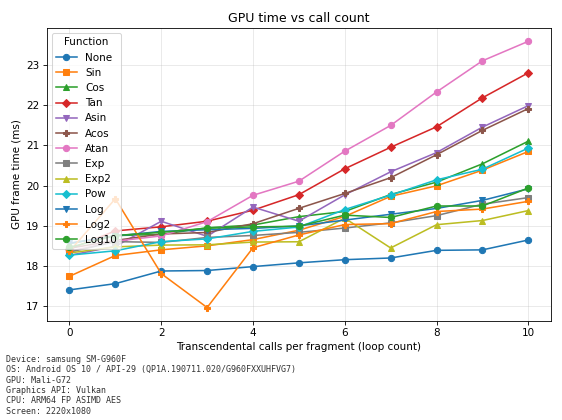
Atanが最も負荷が高いようです。
4.6.5 まとめ
| 端末 | 特記事項 |
|---|---|
| iPhone 15 Pro | 実行回数が7未満の場合はtanが最も重い 実行回数が7以上の場合はatanが最も重い |
| iPhone 14 | tanが最も重い |
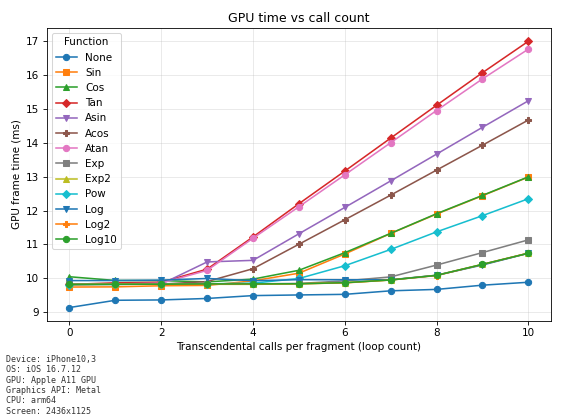
| iPhone X | tanが最も重い |
| Galaxy S9 | atanが最も重い |
4.7 sin関数の負荷
超越関数の中でも代表的なsin関数についての負荷を計測します。
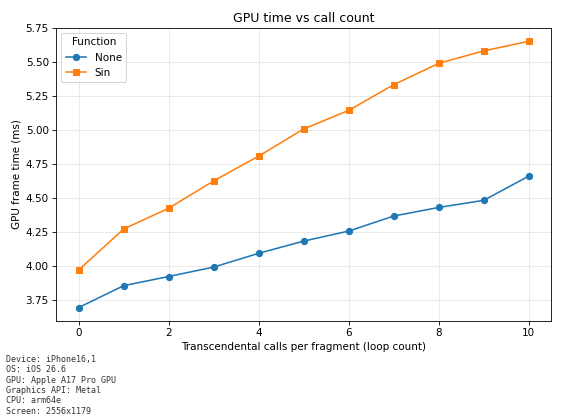
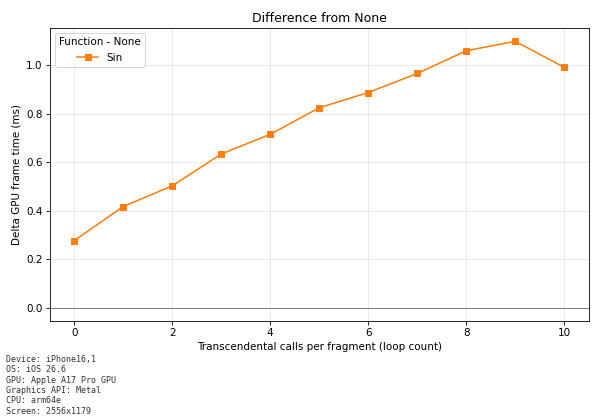
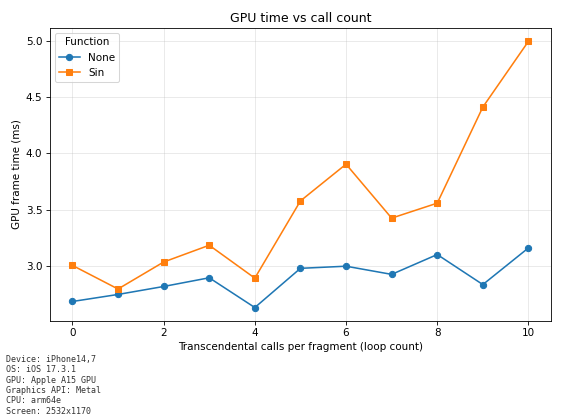
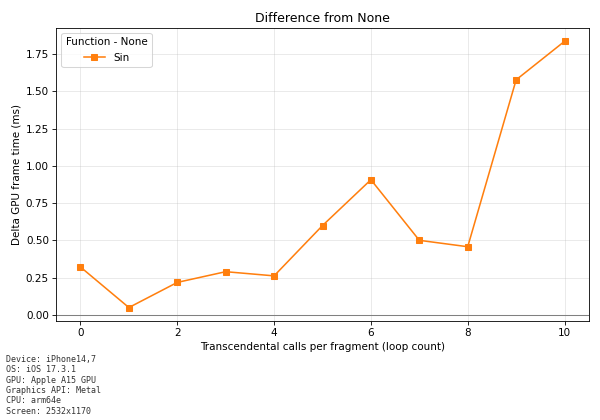
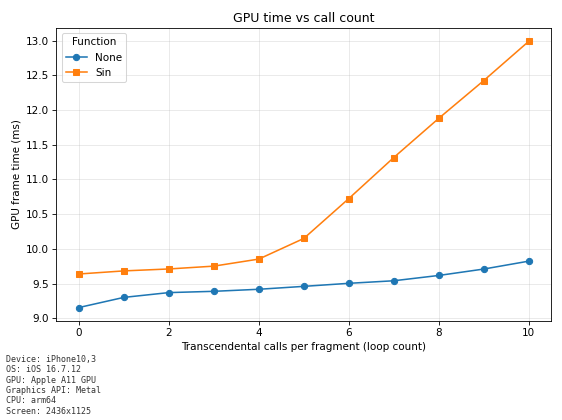
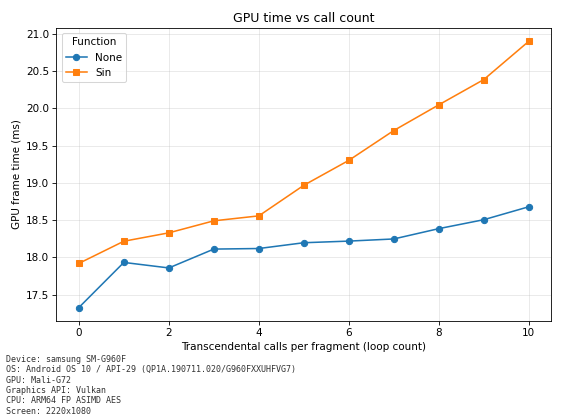
ループ回数0〜 10それぞれについて、フレーム内の処理に要したGPU時間を計測します。各計測点について、10秒間の計測を行い、GPU時間をグラフにまとめてみました。
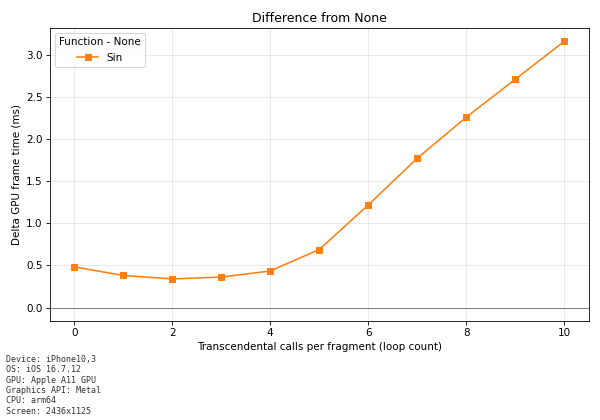
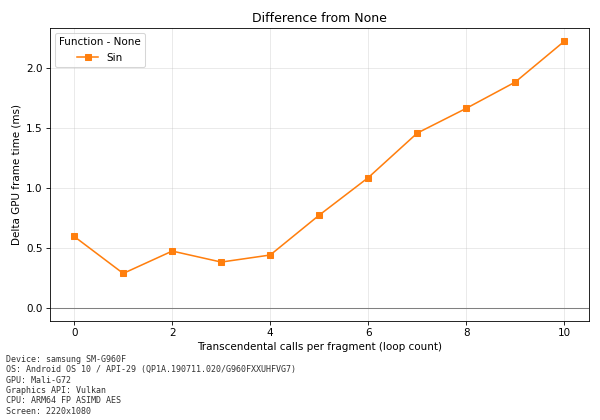
1つ目のグラフ : ループ回数に対応したGPU時間2つ目のグラフ : ループ回数に対応したGPU時間とNoneの差分。
計測にはFrameTimingManagerを使用しました。
4.7.1 iPhone15 Pro
sin命令がシェーダー内に存在することで、0.25msほど増加していました。sin呼び出しが1回増えるごとに、0.1msほど処理負荷が増加しています。
4.7.2 iPhone14
sin命令がシェーダー内に存在することで、GPU時間が0.25msほど増加していました。sin呼び出しが1回増えるごとに、0.1〜 0.2msほど処理負荷が増加しています。
4.7.3 iPhoneX
sin命令がシェーダー内に存在することで、0.5msほど増加していました。sin呼び出しが4回までであれば、GPU時間の増加はほぼみられませんが、5回を超えた場合sin呼び出しが1回増えるごとに、0.6msほど処理負荷が増加しています。
4.7.4 Galaxy S9
sin命令がシェーダー内に存在することで、0.5msほど増加していました。sin呼び出しが4回までであれば、GPU時間の増加はほぼみられませんが、5回を超えてから、sin呼び出しが1回増えるごとに、0.2〜0.3msほど処理負荷が増加しています。
4.7.5 sin関数の負荷のまとめ
| 端末 | sin関数によるGPU負荷の増加 | 特記事項 |
|---|---|---|
| iPhone 15 Pro | +0.25ms (ベースライン) | 呼び出し1回につき約0.1ms増加 |
| iPhone 14 | +0.25ms (ベースライン) | 呼び出し1回につき約0.1〜0.2ms増加 |
| iPhone X | +0.5ms (ベースライン) | 5回を超えると呼び出し1回につき約0.6ms増加 |
| Galaxy S9 | +0.5ms (ベースライン) | 5回を超えると呼び出し1回につき約0.2〜0.3ms増加 |
※表の「ベースライン」はシェーダー内にsin関数が存在する場合の初期負荷増加を指します。
シェーダー内にsin関数が増加する場合、sin関数を実行しなくてもGPU時間の増加が確認できました。これはレジスタープレッシャーによる負荷の増加であると考えられます。
4.8 sin関数の放物線近似
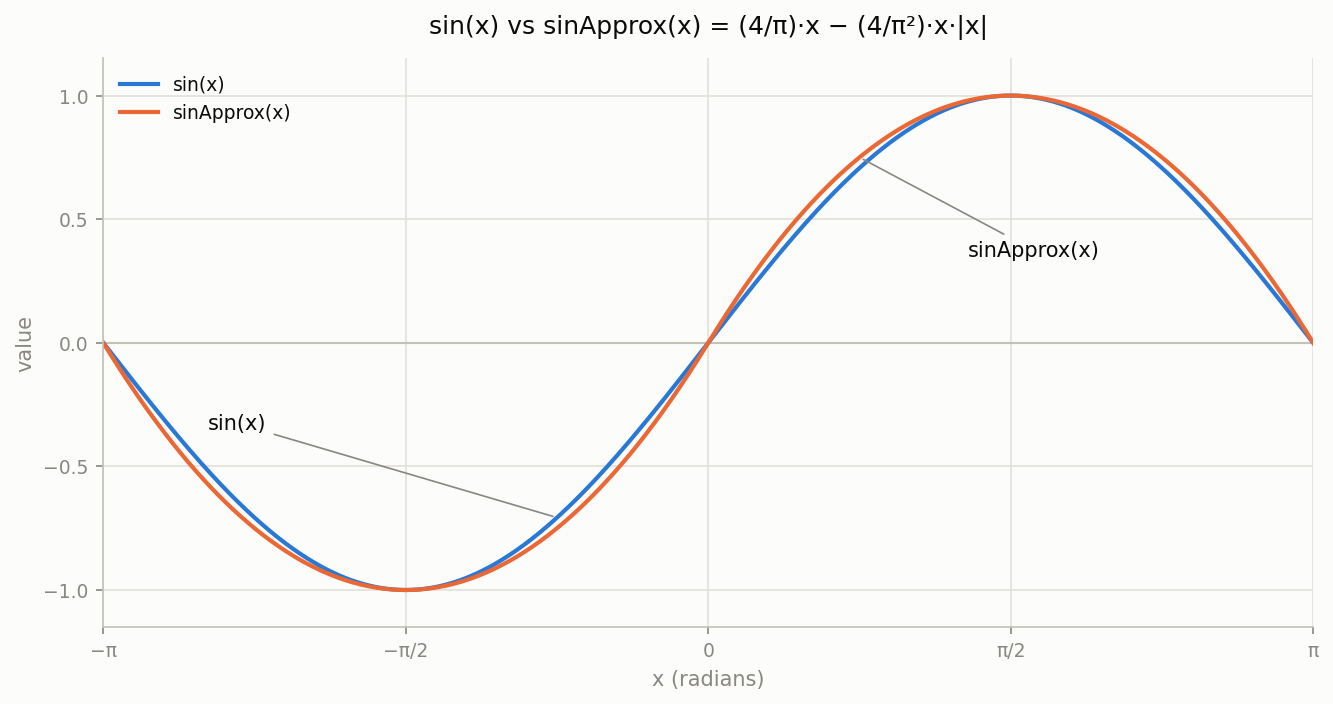
次のような多項式を用いてsinを近似する手法が知られています。
float sinApprox = (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
乗算と絶対値 abs() だけで計算できるため、非常に軽量です。
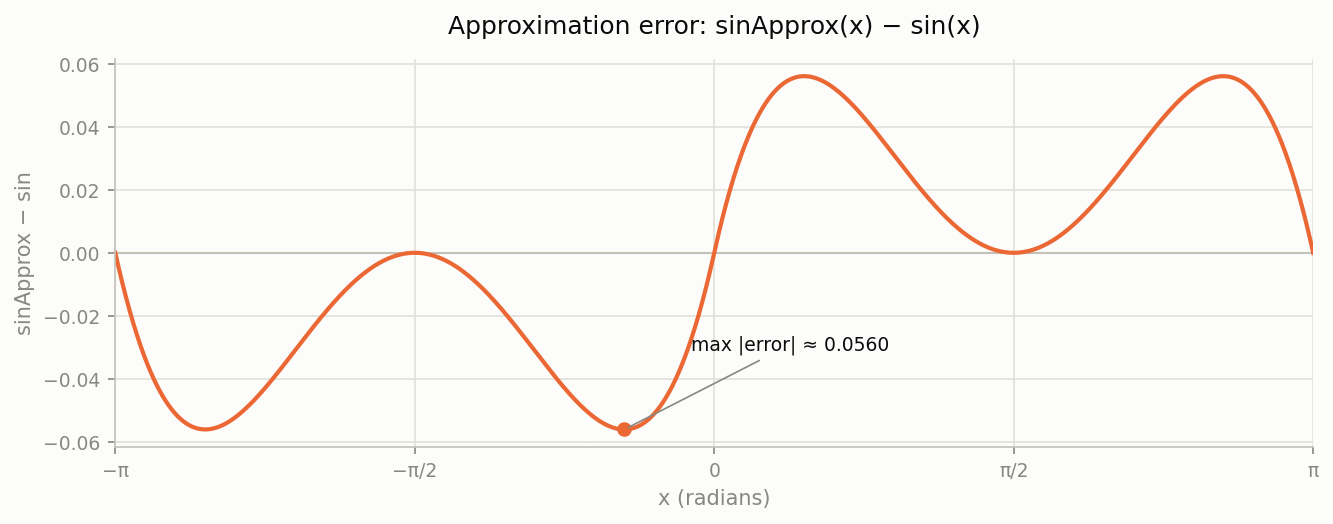
sinの放物線近似は、sinと非常に近い値を出力します (-PI<=x<=PI)
誤差の最大値は 0.056 程度です。
4.9 sin近似の負荷の計測
sinの放物線近似sinApproxの負荷を計測し、グラフにまとめてみました。
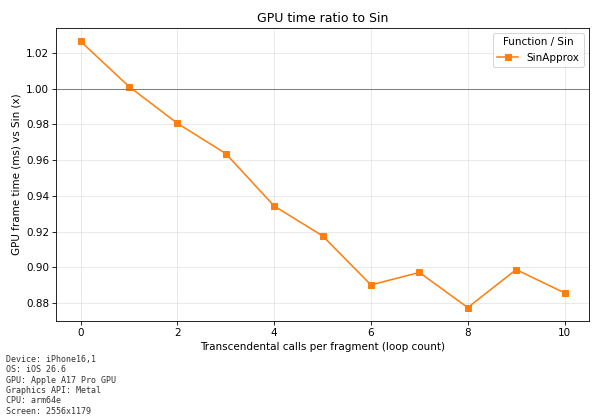
4.9.1 iPhone15 Pro
sin関数よりも負荷が低いことが確認できます。
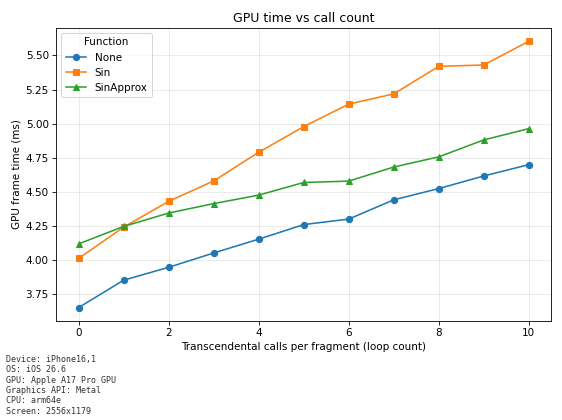
sin関数と近似計算の比較
関数を10回実行した時、0.6msほど負荷が低くなっています。
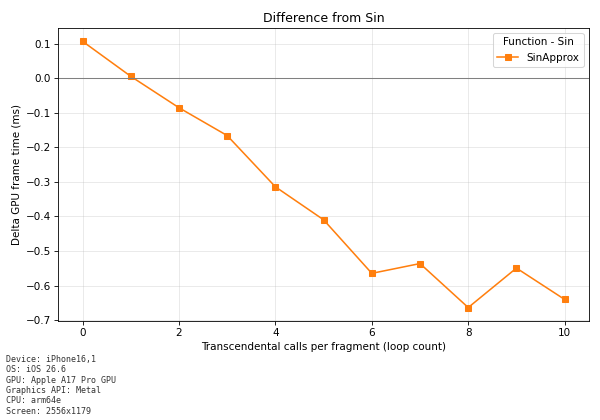
関数を10回実行した時のsinApproxの負荷はsinの90%ほどとなりました。
4.9.2 iPhone14
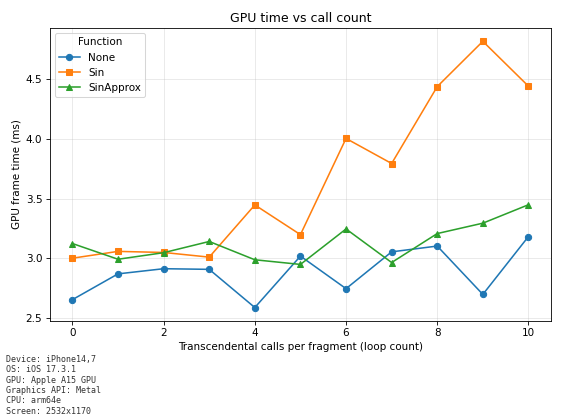
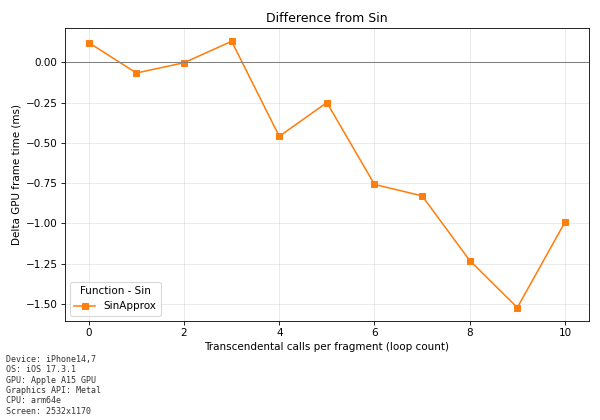
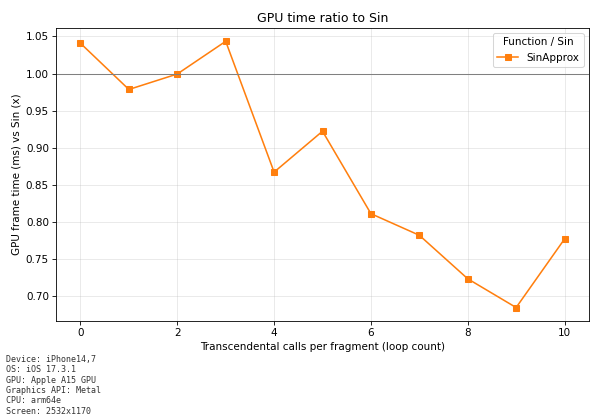
sin関数と近似計算の比較
関数を10回実行した場合は、1msほどGPU時間が短くなっています。
sinApproxを10回実行した時の負荷は、sinの80%程度でした。
4.9.3 iPhoneX
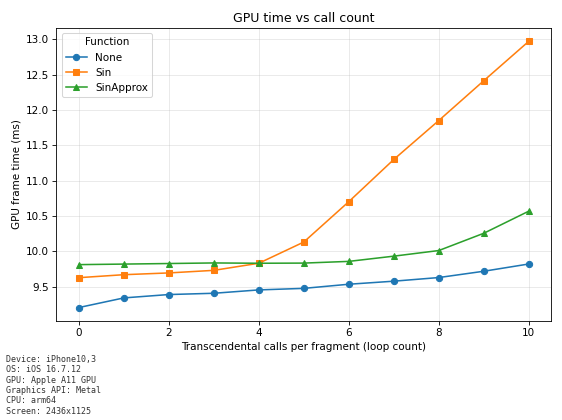
sin関数と近似計算の比較
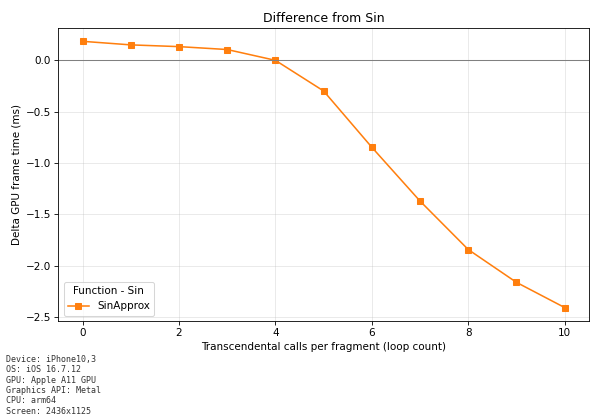
sinApproxを10回実行した時の負荷は、sinを実行した時と比較して2.5msほど短くなりました。
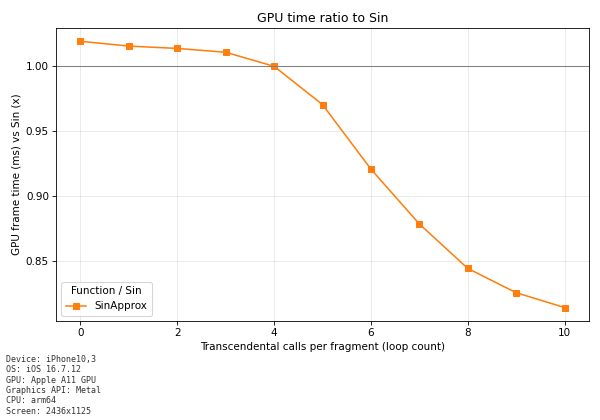
sinApproxを10回実行した時のGPU時間はsinの80%程度でした。
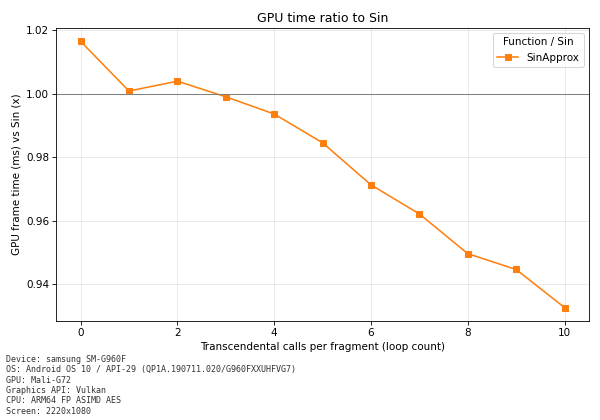
4.9.4 Galaxy S9
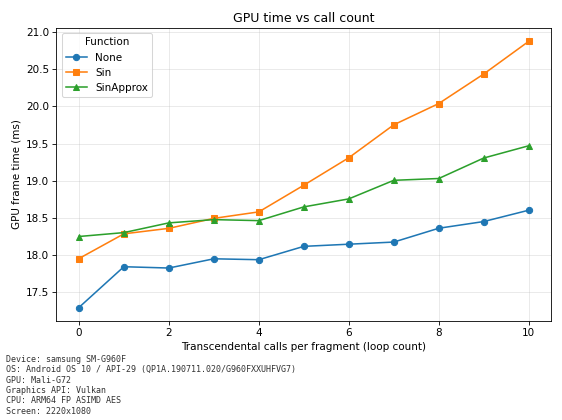
sin関数と近似計算の比較
関数を10回実行した場合は、1.3msほどGPU時間が短くなっています。
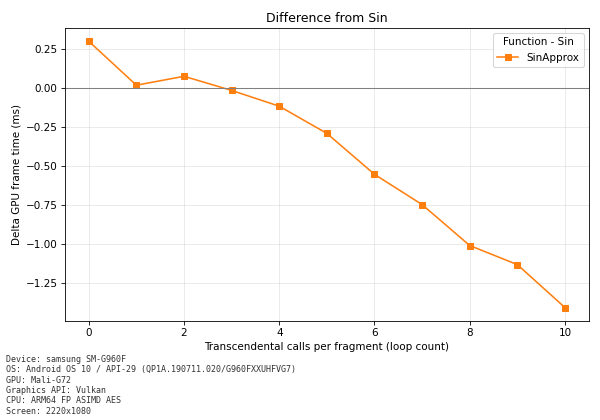
sinApproxを10回実行した時の負荷は、sinの94%程度でした。
4.9.5 sin近似の負荷のまとめ
sinApproxによるGPU削減効果を表にまとめると、このような結果になりました。
| 端末 | sin関数の負荷 | sinApproxによる削減効果 | 特記事項 |
|---|---|---|---|
| iPhone 15 Pro | 基準 | 約0.6ms 削減 | sinApproxの負荷はsinの約90% |
| iPhone 14 | 基準 | 約1.0ms 削減 | sinApproxの負荷はsinの約80% |
| iPhone X | 基準 | 約2.5ms 削減 | sinApproxの負荷はsinの約80% |
| Galaxy S9 | 基準 | 約1.3ms 削減 | sinApproxの負荷はsinの約94% |
※削減効果は、ループ回数10回におけるGPU時間の差分です。
4.10 tan関数の負荷
tan関数の負荷も計測してみました。tan関数の内部では除算が呼ばれているため、sin関数やcos関数よりも負荷が高くなります。
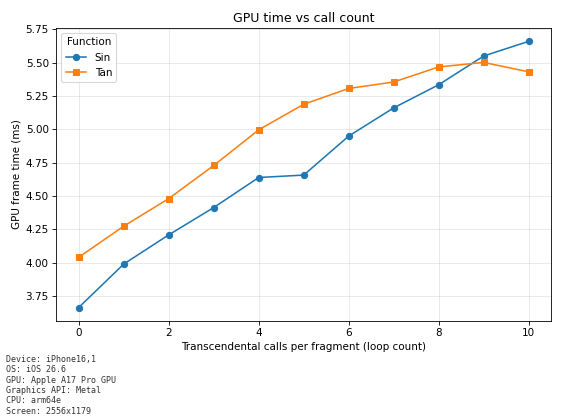
4.10.1 iPhone15Pro
sin関数よりも負荷が高いですが、実行回数が9回を超えると、sin関数の方が負荷が高くなりました。
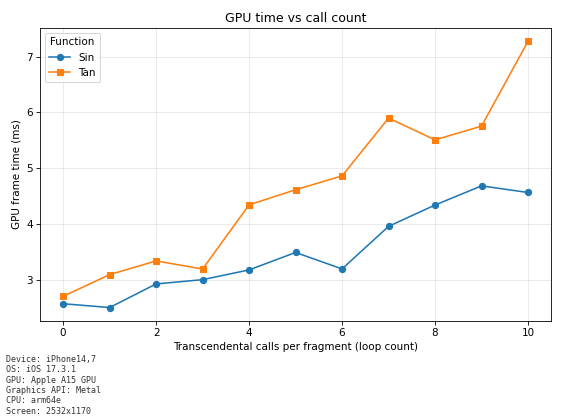
4.10.2 iPhone14
sin関数よりもtan関数の方が負荷が高くなりました。
4.10.3 iPhoneX
sin関数よりもtan関数の方が負荷が高くなりました。
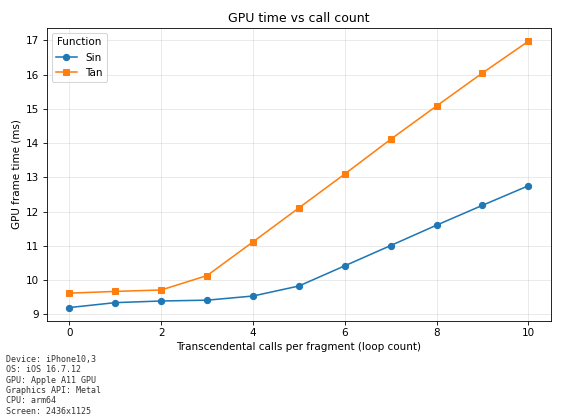
4.10.4 Galaxy S9
sin関数よりもtan関数の方が負荷が高くなりました。
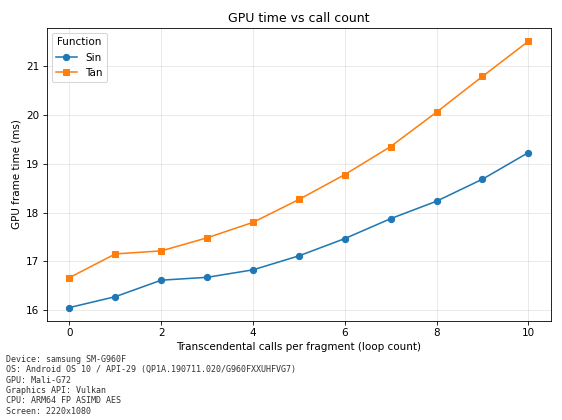
4.11 tan関数の近似
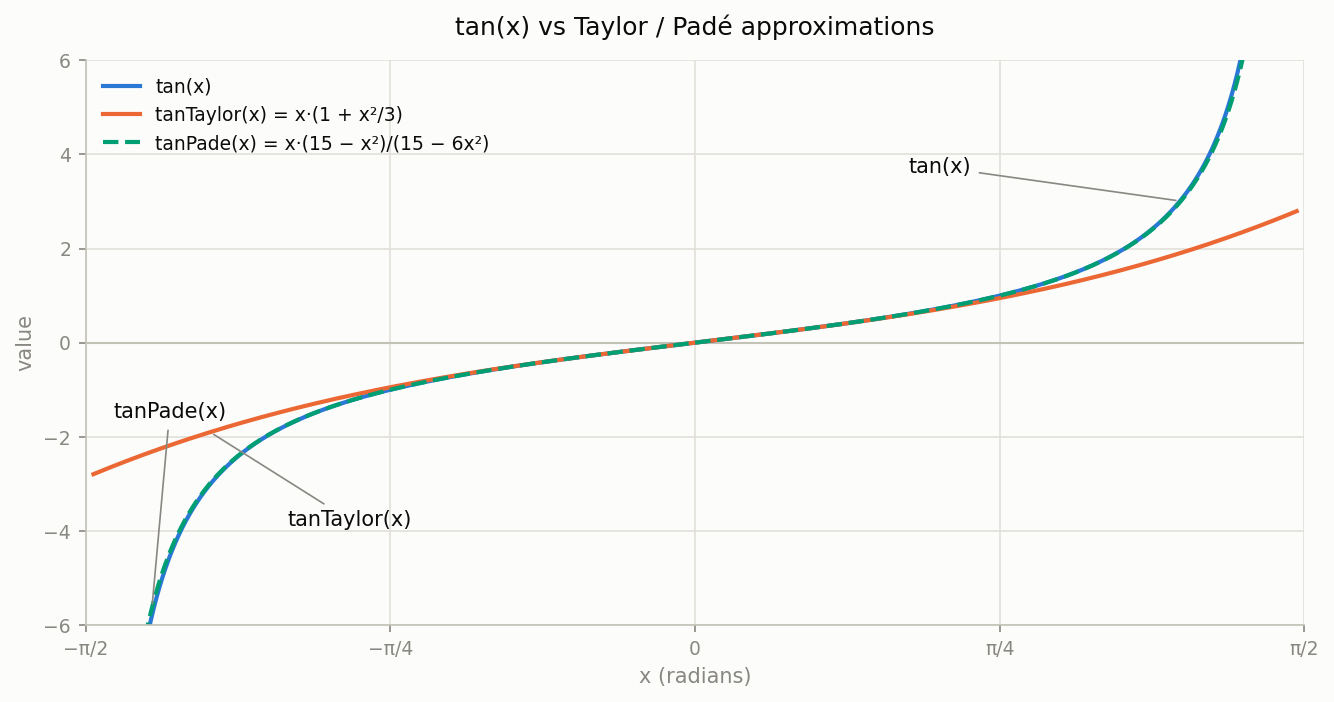
tan関数の近似手法として、 テイラー展開をそのまま活用する方法や、パデ近似を利用する方法があります。テイラー展開の方が負荷が低いですが、精度も低いです。パデ近似の方が精度が良いですが、負荷も高いです。
4.11.1 手法1. テイラー展開による近似
tanのテイラー展開を利用した近似計算です。
|x|がPI/2に近づくほど、誤差が大きくなります。
float tanTaylor(float x) {
    float x2 = x * x;
    return x * (1.0 + x2 * 0.3333333);
}
4.11.2 手法2. パデ近似
tanのpade近似を利用した手法です。
|x| < PI/4 の範囲で、tan(x)に非常に近い値を出力します。
float tanPade(float x) {
    float x2 = x * x;
    return x * (15.0 - x2) / (15.0 - 6.0 * x2);
}
4.12 tan関数近似のグラフ
紹介したtanTaylorとtanPadeをグラフにプロットしてみました。
tan関数との誤差
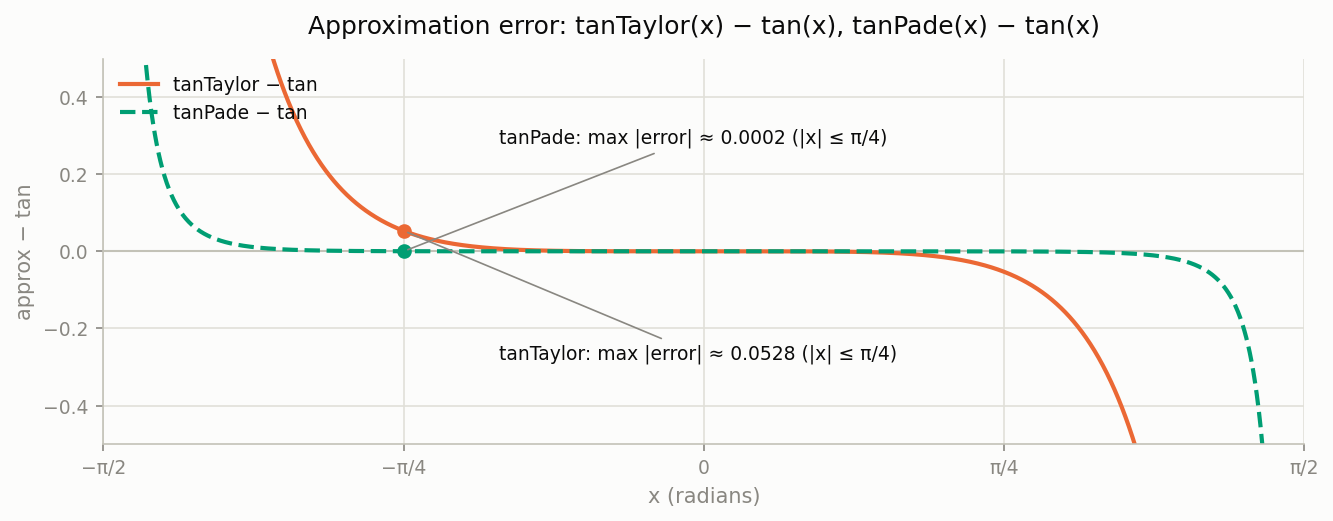
4.13 tan関数近似の負荷計測
tan関数の近似計算の負荷を計測してみました。
4.13.1 iPhone15 Pro
実行回数が少ない場合、レジスタープレッシャーによるオーバーヘッドが目立ちますが、実行回数が増えてくると、近似計算の方が負荷が低く抑えられています。
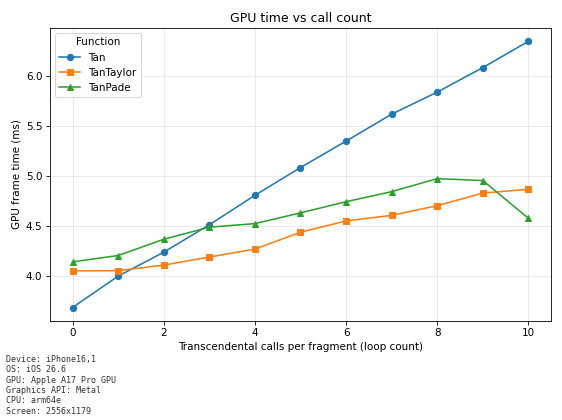
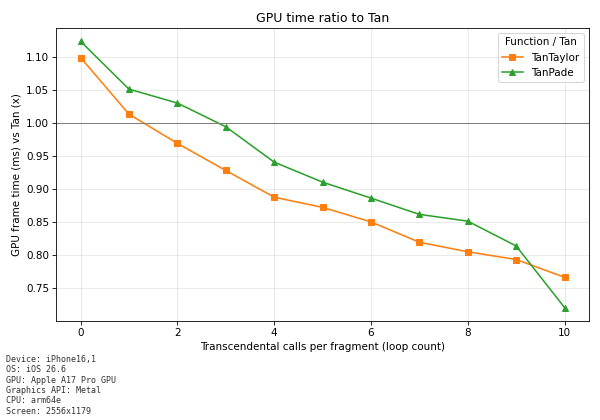
tan関数と近似計算の比較
関数を10回実行した場合、近似計算のGPU時間はtan関数の80%ほどのGPU時間となっていました。
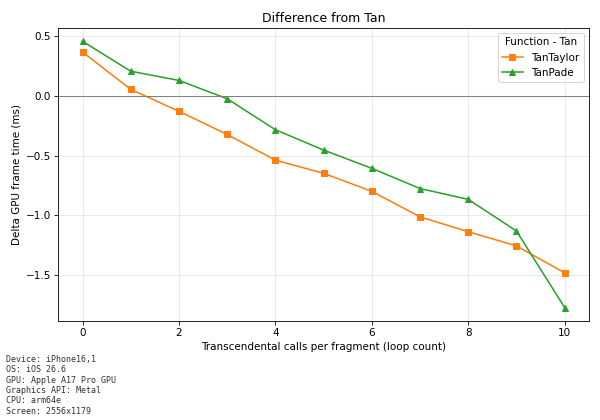
10回実行した時、近似計算の方が1msほど処理時間が少なくなりました。
4.13.2 iPhone14
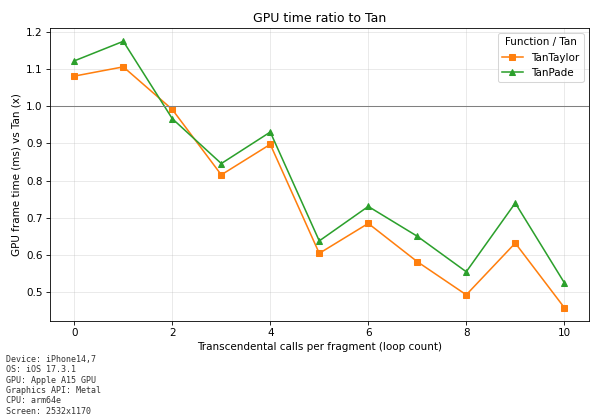
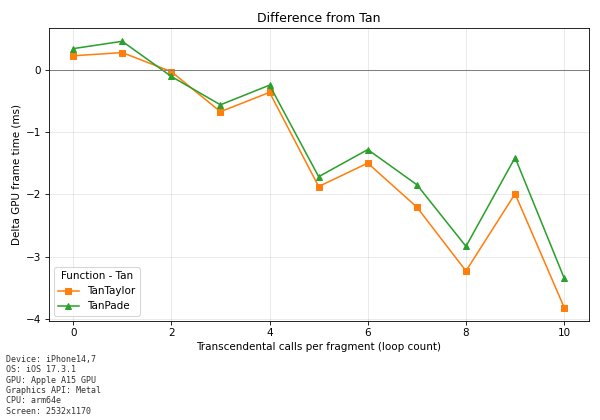
実行回数が少ない場合、レジスタープレッシャーによるオーバーヘッドがわずかにみられます。実行回数が増えてくると、近似計算の方が負荷が低く抑えられています。
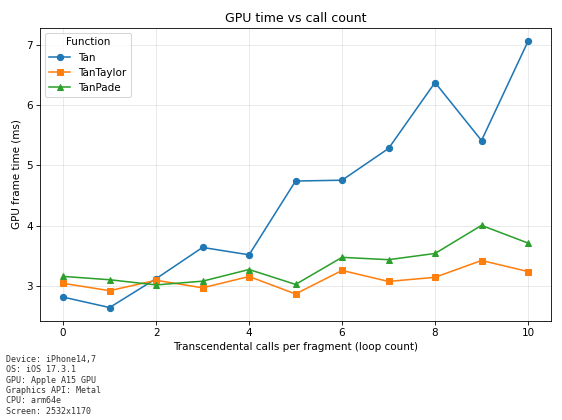
tan関数と近似計算の比較 (iPhone14)
関数を10回実行した場合、近似計算のGPU時間はtan関数の50%ほどのGPU時間となっていました。
10回実行した時、近似計算の方が3msほど処理時間が少なくなりました
4.13.3 iPhoneX
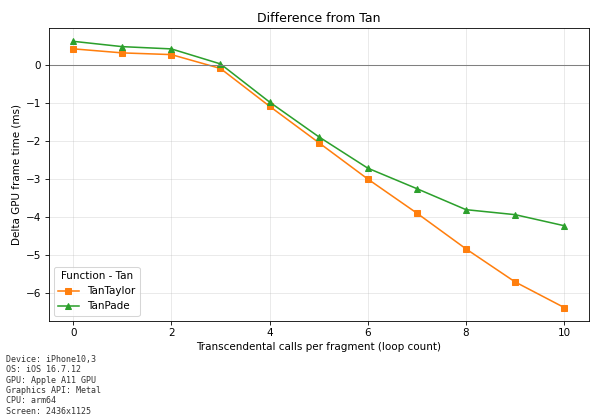
実行回数が少ない場合、レジスタープレッシャーによるオーバーヘッドがわずかにみられます。実行回数が増えてくると、近似計算の方が負荷が低く抑えられています。テイラー展開の場合、処理負荷の増加はほとんどありませんが、パデ近似は処理負荷がわずかに上昇しています。
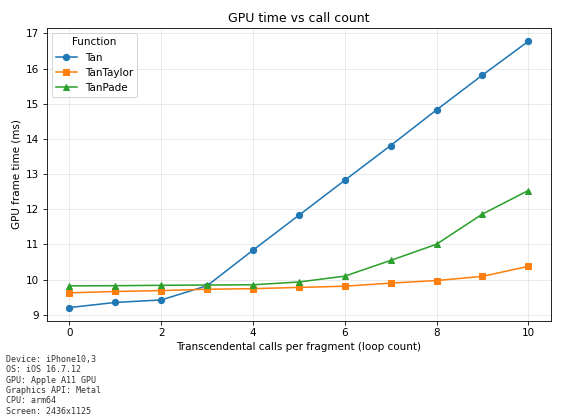
tan関数と近似計算の比較
関数を10回実行した場合、テイラー展開のGPU時間はtan関数の60%ほどのGPU時間となっていました。パデ近似は75%ほどのGPU時間となっていました。
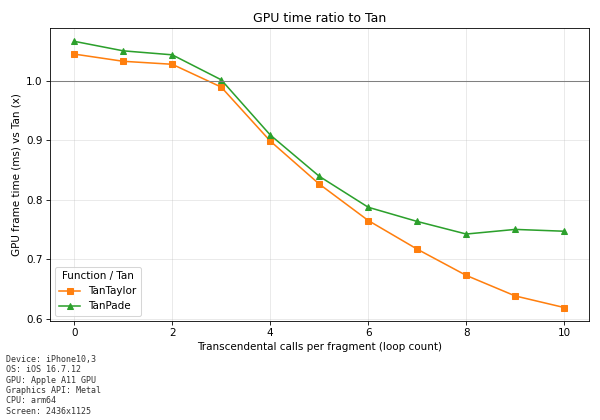
関数を10回実行した時、テイラー展開は6msほど短く、パデ近似は4msほど短い結果となりました。
4.13.4 Galaxy S9
実行回数が少ない場合、レジスタープレッシャーによるオーバーヘッドがわずかにみられます。実行回数が増えてくると、近似計算の方が負荷が低く抑えられています。
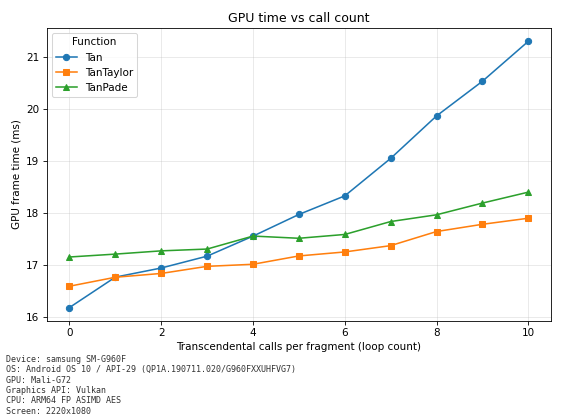
tan関数と近似計算の比較
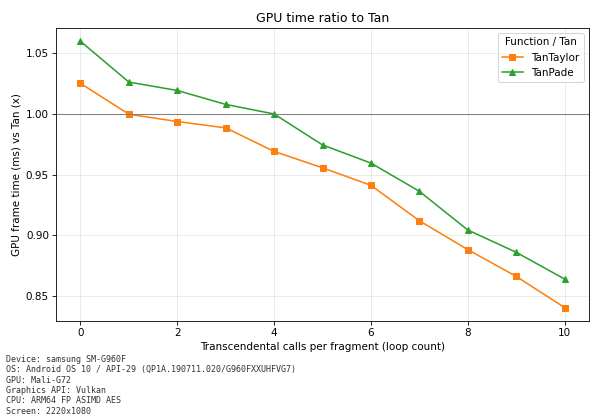
関数を10回実行した時、近似計算はtan関数の85%ほどのGPU時間となっていました。
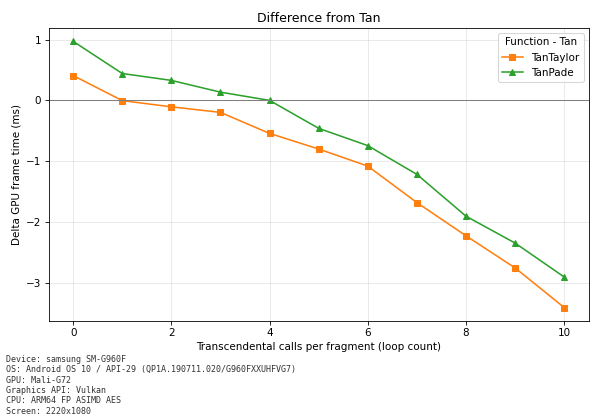
関数を10回実行した時、テイラー展開は3msほど短い結果となりました。
4.13.5 tan関数近似の負荷のまとめ
| 端末 | GPU負荷の傾向 | 特記事項 |
|---|---|---|
| iPhone 15 Pro | 近似計算の方が約20%低い | 近似計算により約1msの処理時間削減 |
| iPhone 14 | 近似計算の方が約50%低い | 近似計算により約3msの処理時間削減 |
| iPhone X | 近似計算の方が約25〜40%低い | テイラー展開は約6ms、パデ近似は約4ms削減 |
| Galaxy S9 | 近似計算の方が約15%低い | 近似計算により約3msの処理時間削減 |
※「GPU負荷の傾向」は、標準の tan 関数と比較した際の、近似計算(テイラー展開またはパデ近似)実行時のGPU時間のおおよその削減率です。