第3章 VATによるボーンアニメーション負荷軽減
3.1 はじめに
Unityにおける一般的なボーンアニメーションでは、ボーンの更新といった再生用の計算を毎フレームCPUが行います。そのため、アニメーションするオブジェクトが増えるほどCPU負荷が積み上がり、フレームレート低下の原因になります。本章では、この実行時の計算をまるごと事前計算に置き換えることで負荷を軽減する手法、VATを紹介します。
3.2 VATとは
VATはVertex Animation Textureの略で、アニメーションによる頂点の変形情報をあらかじめテクスチャにベイクしておき、頂点シェーダーで読み取って再生する手法です。テクスチャのピクセル1つ1つが「ある頂点の、あるフレームでの位置」に対応しており、再生時間に合わせて読み取る場所をずらしていくことでメッシュが動いて見える仕組みです(図3.1)。なお、位置は精度を確保するため0から1に正規化した値で格納されており、頂点シェーダーで実際の座標へ復元します。
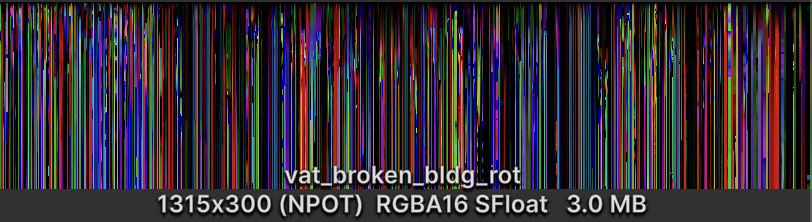
図3.1: VATテクスチャの仕組み。横軸が頂点、縦軸がフレームに対応する
VATを使用することで、ボーンの更新といった実行時の再生計算をまるごと事前計算に置き換えられます。これはGPU Skinningでもできない効率化です。
一方で、以下の短所があります。
- VAT用の専用アセットを用意する必要があります
- 頂点数とフレーム数に応じてテクスチャサイズが大きくなります
- 正確な値が必要なためテクスチャ圧縮と相性が悪く、事実上非圧縮で扱います
- テクスチャに焼き込んだ時点で動きが固定されるため、工夫次第である程度の制御はできるものの、細かい制御には不向きです
これらの特性から、VATは大量のオブジェクトに決まったアニメーションを再生させる場合にとくに有効です。たとえば建物の破壊表現や群衆、背景の装飾物のような、個別の制御を必要としない演出に適しています(図3.2)。
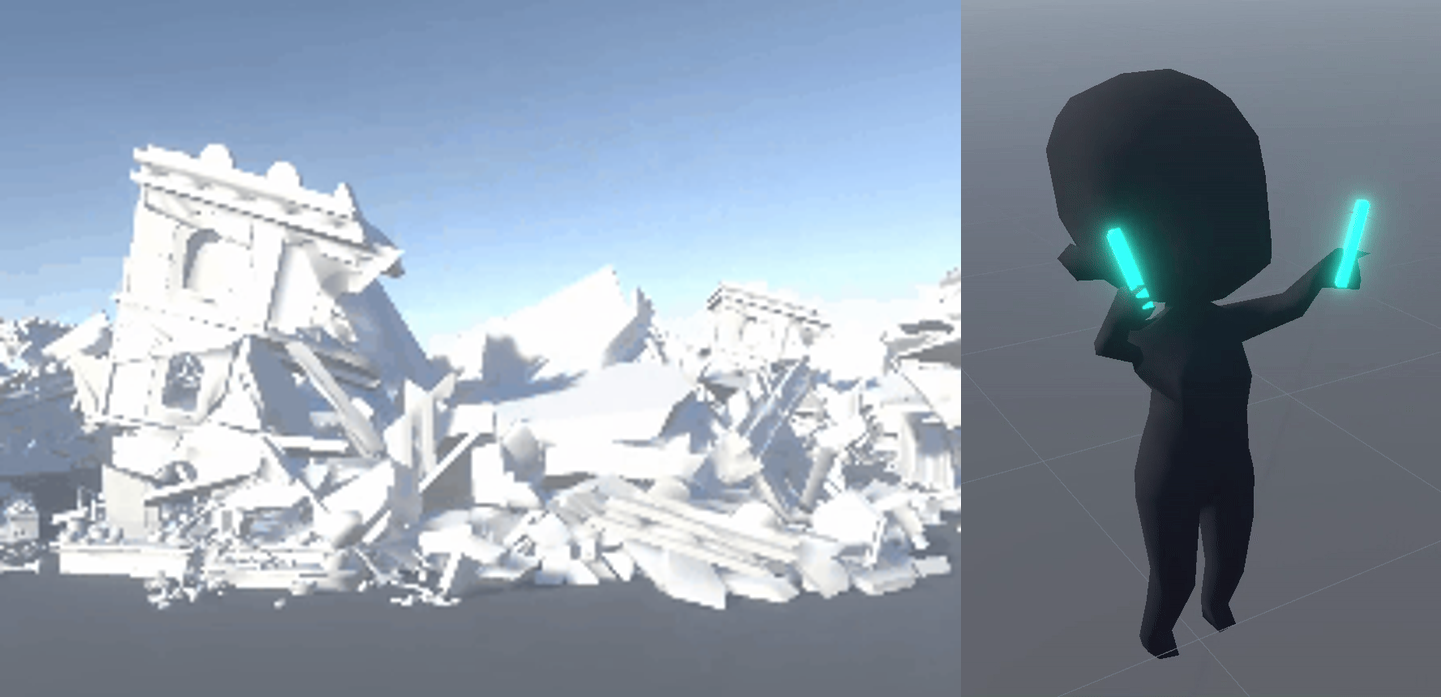
図3.2: VATによるアニメーション(左:剛体、右:ソフトボディ)
3.3 性能検証
VATの性能を、他のアニメーション方式と実機で比較した結果を紹介します。
3.3.1 計測環境と比較条件
計測環境を 表3.1 に示します。
表3.1: 計測環境
| 項目 | 内容 |
|---|---|
| 実機 | Pixel 8a(GPU: Mali-G715) |
| グラフィックスAPI | Vulkan |
| Unityバージョン | 6000.3.2f1 |
| 計測API | FrameTimingManager、ProfilerRecorder |
| モデル | 建物の倒壊アニメーション(85,209頂点、破片1,315個) |
| アニメーション | 300フレーム |
| 計測方法 | オブジェクト数を0〜16体まで変化、各条件300フレーム×3回の中央値 |
比較した3つの方式を 表3.2 に示します。
表3.2: 比較条件
| 方式 | 構成 | 有効にした最適化 |
|---|---|---|
| FBX方式 | 各破片を個別のMesh Rendererとして配置し、Animatorで再生 | SRP Batcher |
| Skin方式 | 1破片1ボーンで1つのSkinnedMeshRendererに統合し、Animatorで再生 | SRP Batcher |
| VAT方式 | 全破片の動きをテクスチャに焼き込み、1つのメッシュとして描画(Rigid-Body Dynamicsモード) | GPU Instancing |
FBX方式は、各破片を個別のMesh Rendererとして持ち、Animatorで再生する構成です(破片はTransformで動く剛体で、スキニングは不使用)。Skin方式は、破片1つごとにボーン1本を割り当てて、全体を1つのSkinned Meshにまとめた構成です。1,315個の破片がそのまま1,315本のボーンになり、Rendererは1つです。アニメーションの再生はCPUのAnimatorが担い、頂点の変形はGPU Skinningで行われます。VAT方式は、全破片の動きをテクスチャに焼き込み、1つのメッシュとして描画します。見た目は3方式とも同一です。
描画の効率化設定は、それぞれの方式に有利なものを有効にした状態で比較しています。SkinnedMeshRendererはGPU Instancingに対応していないため、Skin方式に使える最善はSRP Batcherになります。なお、Skin方式のボーン化にも専用の変換パイプラインが必要で、この点はVATと同条件です。
3.3.2 CPU処理時間
CPU処理時間(メインスレッド)の計測結果を 図3.3 に示します。16体表示時、FBX方式が154.3msまで伸びるのに対し、Skin方式は16.5ms、VAT方式は12.6msとほぼ横ばいでした。
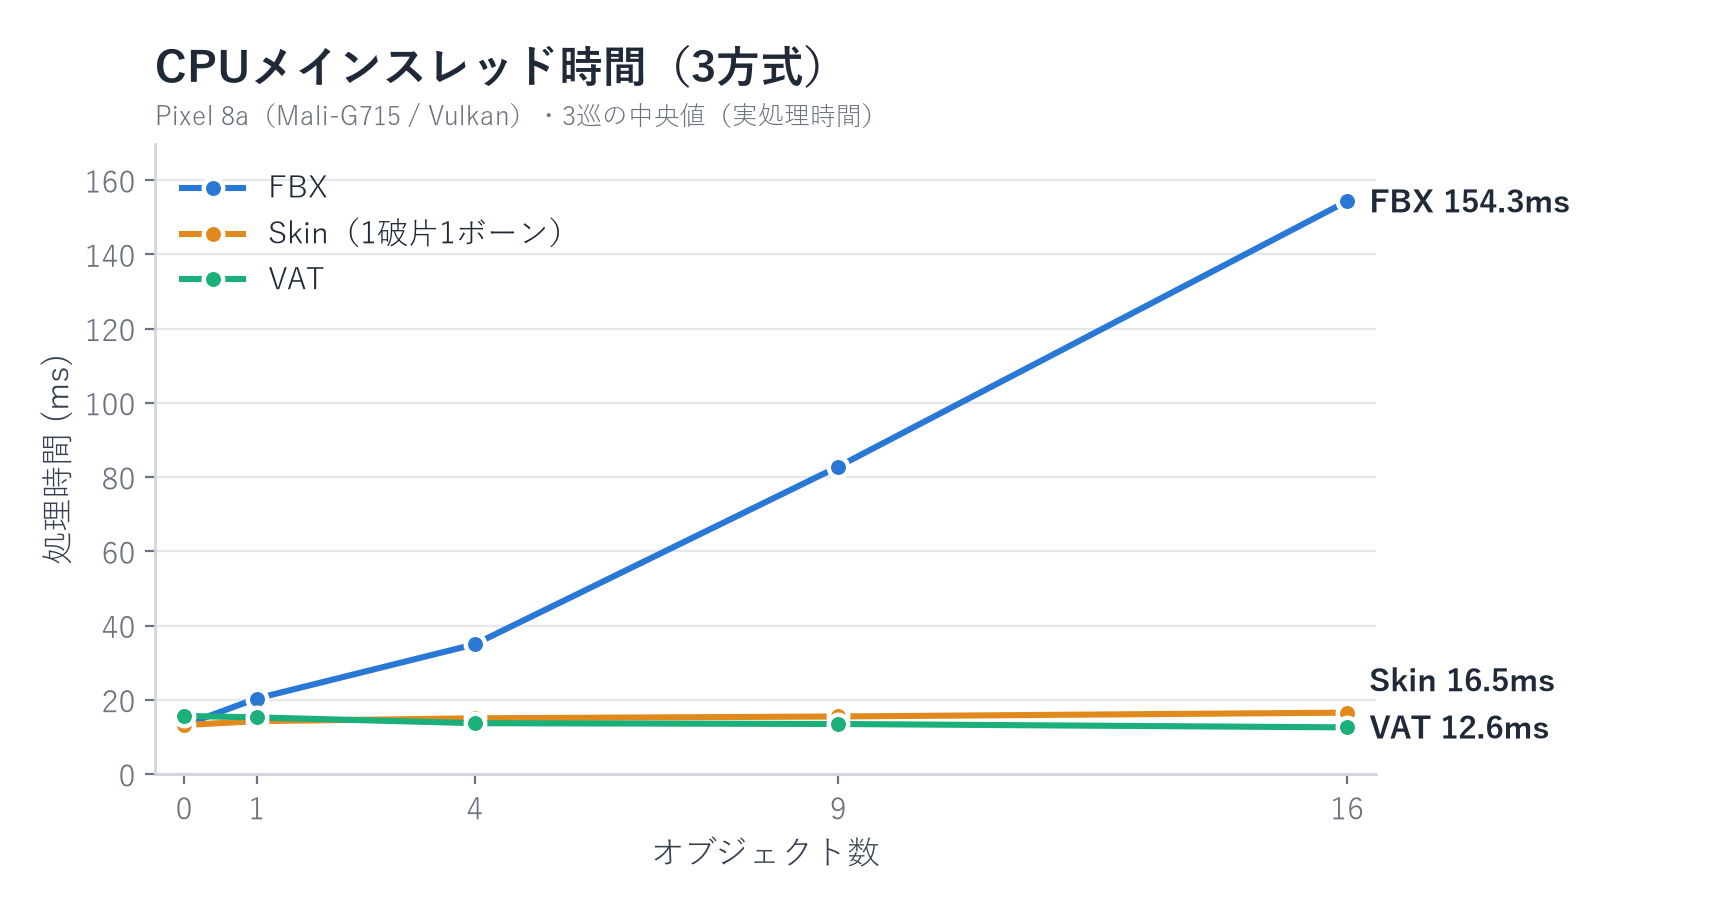
図3.3: オブジェクト数ごとのCPUメインスレッド処理時間
内訳を 表3.3 に示します。FBX方式と他2方式の差の最大の要因はドローコールの送信処理です。FBX方式ではモデル1つごとに1,315個の破片が描画対象になるのに対し、1つのメッシュにまとまっている2方式ではこの処理がほぼ消えます。破片ごとのバウンディングボックス計算やカリングも同様です。一方、Skin方式とVAT方式の差はAnimatorの更新です。Skin方式は再生をCPUが担うため16体で4.5msが残りますが、VAT方式は再生そのものがGPUへ移るため、まるごとなくなります。この差は体数に応じて広がります。
表3.3: 16体表示時のCPU処理時間の内訳(ms)
| 処理 | FBX方式 | Skin方式 | VAT方式 |
|---|---|---|---|
| メインスレッド合計 | 154.30 | 16.53 | 12.56 |
| うちドローコール送信(SRPBatcher.Flush) | 76.17 | 0.03 | 0.02 |
| うちAnimator更新 | 5.30 | 4.54 | 0.02 |
3.3.3 GPU処理時間
GPU処理時間の計測結果を 図3.4 に示します。16体時はFBX方式の77.1msに対し、Skin方式が22.2msで最速、VAT方式は32.5msでした。
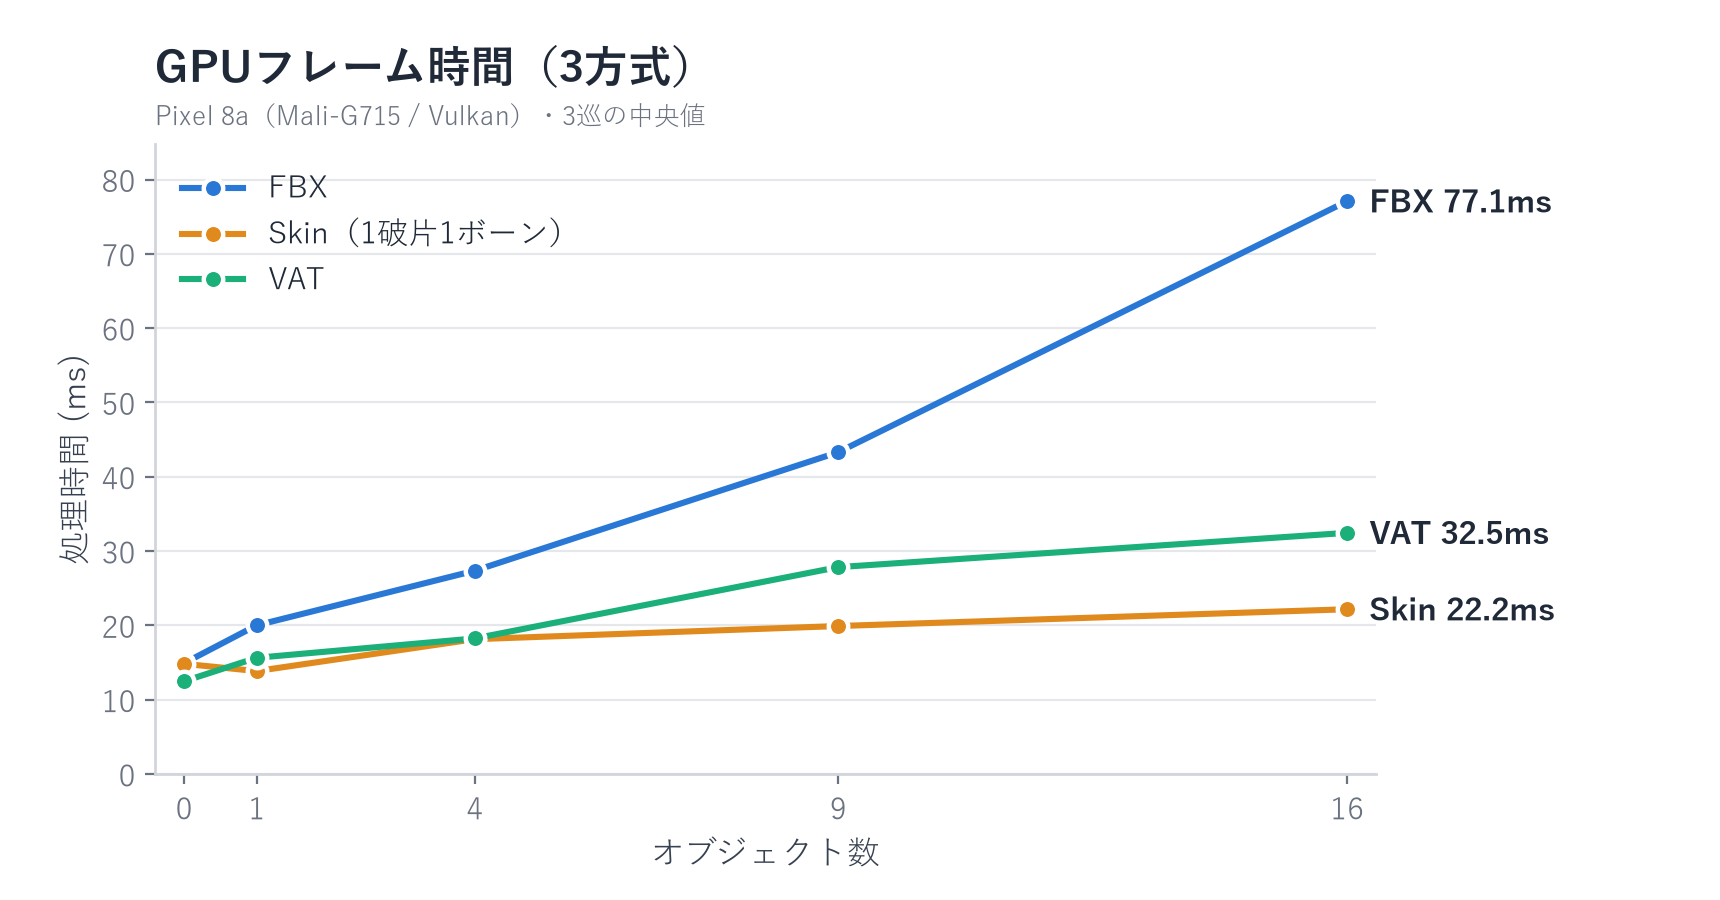
図3.4: オブジェクト数ごとのGPU処理時間
FBX方式と他2方式の差の主因は、描画命令の分割数です。FBX方式は破片が各描画パスで個別に描画命令を発行するため1フレームあたり約21万回に達していたのに対し、VAT方式はインスタンス描画にまとまり99回でした。Skin方式も1体につきRendererが1つのため同水準に収まります。描画命令には1回ごとに固定のコストがかかるため、分割数の差がそのまま処理時間の差として現れます。
Skin方式とVAT方式の差は、変形計算の回数によるものです。GPU Skinningは変形をフレームに1回だけ計算し、その結果をシャドウやデプスなどすべての描画パスが再利用します。対してVATは、パスのたびに頂点シェーダーでテクスチャから変形をやり直します。今回の環境はシャドウのカスケードが4枚という、パス数が多いシーン構成のため、その分Skin方式との差が開きました(シャドウマップ描画はFBX方式44.3ms、Skin方式7.4ms、VAT方式16.0ms)。頂点計算を行うパス数が少ない構成では、この差は縮まります。
3.3.4 GPUメモリ確保量
GPUメモリの計測結果を 図3.5 に示します。値はOSが計上するグラフィックスドライバの実測値(GL mtrack)です。0体から16体への増分は、FBX方式が+411.8MB(1体あたり約26MB)、Skin方式が+38.2MB(1体あたり約2.4MB)、VAT方式はほぼ±0でした。
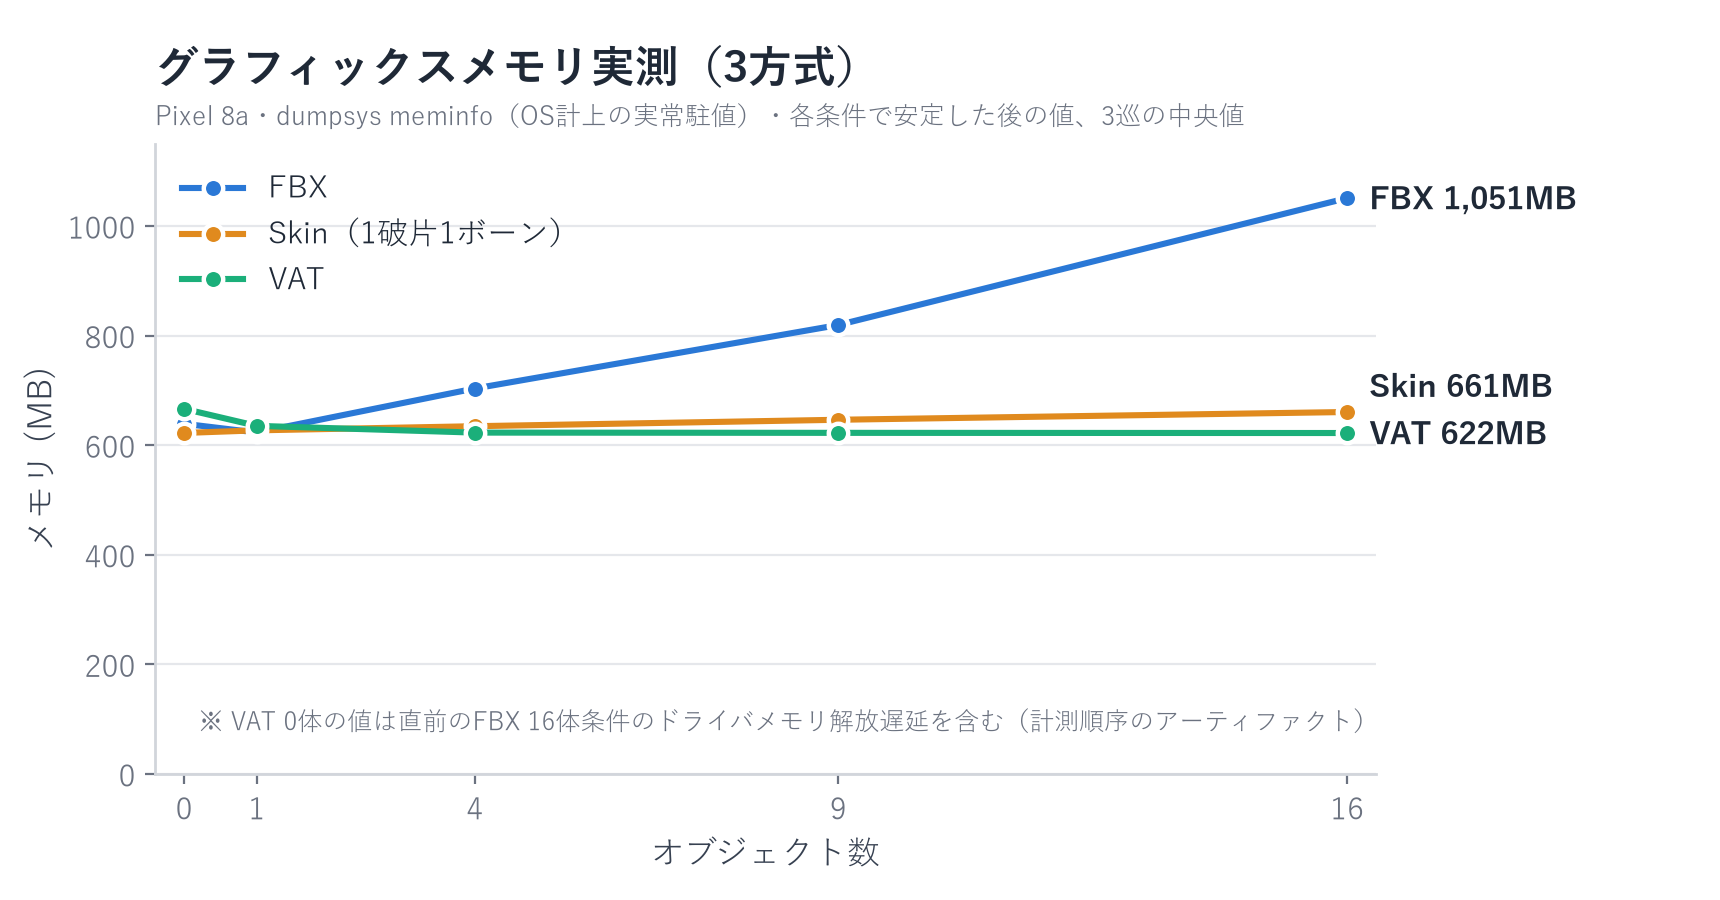
図3.5: オブジェクト数ごとのGPUメモリ確保量
この差は、1体増えたときに何が増えるかという構造の違いによるものです。FBX方式は、行列などの描画用データが破片の数だけGPUメモリに確保されます。Skin方式で増えるのは、スキニングの変形結果を書き出す頂点バッファが1体につき1本だけです。VAT方式は変形をその場で計算するだけで新しいバッファを持たないため、増えません。なお、VATのテクスチャは非圧縮で約6.6MBありますが、増分の差に対して十分小さい値です。
3.3.5 検証結果のまとめ
16体表示時の実測値を 表3.4 にまとめます。
表3.4: 16体表示時の実測値まとめ
| 指標 | FBX方式 | Skin方式 | VAT方式 |
|---|---|---|---|
| CPUメインスレッド(ms) | 154.3 | 16.5 | 12.6 |
| GPUフレーム(ms) | 77.1 | 22.2 | 32.5 |
| 描画命令数(回/フレーム) | 約210,000 | VAT方式と同水準 | 99 |
| GPUメモリ増分(0→16体、MB) | +411.8 | +38.2 | ほぼ±0 |
FBX方式に対しては、Skin方式・VAT方式のどちらも全指標で大きく優位でした。要因は「1つのメッシュとして扱えること」に集約されます。
Skin方式とVAT方式の比較は一長一短で、GPU処理時間はSkin方式、CPUメインスレッドとメモリはVAT方式が有利です。VAT方式のGPU処理時間は、頂点変形の処理が多くかかるパス構成かどうかに大きく依存します。そのため、頂点計算を行うパス数が少ない構成や、CPU負荷の削減を目的とする場合は、VATが第一候補になります。
なお、今回の比較は剛体破壊という、ボーンで表現しやすい題材でした。布や人体のように、ボーン数が多くなるか近似処理になってしまうモデルや、オブジェクト数が多い場合はCPUの負荷が顕著になるため、よりVATが優位になると考えられます。
3.4 VATアセットの作成
VATアセットの作成には、Houdiniに付属するLabs Vertex Animation Textures ROP(以降、VAT ROP)を使用する方法が手軽です*1。HoudiniはSideFX社のDCCツールで、プロシージャル生成に強みがあります。VAT ROPにはUnity用のプリセットと対応シェーダーが用意されており、Houdini内のシミュレーション結果だけでなく、他のDCCツールで作成したFBXアニメーションも入力にできます。
VAT ROPには 表3.5 の4つのモードがあります。
表3.5: VAT ROPのモード
| モード | 用途 |
|---|---|
| Soft-Body Deformation | 基本的な頂点変形。トポロジーが変化しないことが条件 |
| Rigid-Body Dynamics | 剛体破壊に最適化。破片単位で動きを記録するためテクスチャサイズを小さく抑えられる |
| Dynamic Remeshing | 液体や破ける布など、トポロジーが変化するものに対応 |
| Particle Sprites | パーティクルシミュレーション用 |
手順は、Input GeometryにVAT化したいアニメーションのノードを、Modeに使用するモードを、Target EngineにUnityを指定し、Render Allボタンを押すだけです。表3.6 のアセットが一括出力されます。
表3.6: VATの再生に必要なアセット
| アセット | 役割 |
|---|---|
| ポジション用テクスチャ | 各頂点の各フレームにおける位置(0〜1に正規化) |
| 回転用テクスチャ | 変形後の面の向き。法線・接線を再構築して陰影を保つ |
| 頂点カラー用テクスチャ | Houdini側アトリビュートのベイク先。補間品質の向上などに使える自由枠 |
| FBX | テクスチャの参照位置を示す識別番号がUVに埋め込まれたメッシュ |
| マテリアル | フレーム数・FPS・バウンディングボックスなどの補助データが設定済み |
| シェーダー | 各モードに対応した再生計算の本体(別途インストール) |
シェーダーは出力ファイルに含まれません。計算処理はアニメーションによらず固定のためです。UnityのPackage ManagerからSideFX Vertex Animation Texturesパッケージを別途インストールします(格納先はVAT ROPのReal-Time Shadersタブから確認できます)。パッケージには4モード対応のShader Graphのほか、ドキュメントとインポート設定用のPresetが同梱されています。
3.5 導入時の注意点
VATは精度が足りないとアニメーションが壊れてしまうため、テクスチャに適したフォーマットを指定する必要があります。同様に、FBX側にも推奨されるインポート設定があります。パッケージ同梱の「VAT Import Settings Guide」に従い、テクスチャ圧縮の無効化をはじめとする専用のインポート設定を適用しましょう。
また、公式のShader Graphはあくまでテンプレートという位置づけで、実用上はカスタマイズが必要です。テンプレートを直接利用するのではなく、プロジェクト用にコピーしてから使うことになります。ただし、コピー先のShader Graphはパッケージ側のSub Shader Graphを参照したままになるため、コピーした側へ参照を挿げ替えておく点に注意しましょう。
なお、出力ファイルのインポート設定や、マテリアルへのテクスチャ・シェーダーの割り当てといった参照設定は手作業で行う必要があり、設定漏れによるトラブルが起きやすい部分です。量産するプロジェクトでは、Scripted Importerなどでインポート設定と参照解決を自動化する余地があります。このあたりの改良についてはCEDiLにアップロードされている資料を確認してください*2。
3.6 まとめ
VATは、アニメーションをテクスチャに焼き込み、GPUで再生する手法です。ドローコールを大きく削減できるのが特徴で、破片ごとにRendererを持つ構成に対しては、Skin方式と並んで大幅に効率的でした。両者は一長一短で、GPU処理時間はSkin方式、CPU処理時間とメモリはVAT方式が有利です。頂点計算を行うパス数が少ない構成や、CPU負荷の削減が目的の場合は、VATが第一候補になります。専用アセットの準備や動きが固定されるといった制約はありますが、大量のオブジェクトに決まったアニメーションを再生させる場面では強力な選択肢になります。
[*1] SideFX Labsパッケージに含まれるツールです。本章の検証にはバージョン3.0を使用しています。