第5章 UnityのLTO設定とAndroid・iOSでの性能比較
Unity 6000.5に追加されたAndroid向けのリンク時最適化(LTO)設定は、エンジンコードにしか適用されません。自作のC#から生成されるコードにもLTOを適用するには、別の設定が必要です。両方の設定を試し、ベンチマークと実タイトルで性能、バイナリサイズ、ビルド時間を測りました。
5.1 IL2CPPのコンパイルと翻訳単位
UnityのAndroidビルド(IL2CPP)では、C#をリスト5.1の流れで機械語に変換します。
リスト5.1: IL2CPPビルドの処理フロー
1 2 3 4 5 6 7 8 | C# ソース ↓ C# コンパイル IL アセンブリ (.dll) ↓ IL2CPP 変換 大量の C++ (.cpp) ← 「IL2CPP 生成コード」 ↓ clang でコンパイル(.cpp ごとに個別最適化) ↓ リンク libil2cpp.so ← C# コードから生成された最終的なネイティブバイナリ |
clangはcppを翻訳単位(通称TU)ごとにコンパイルし、オブジェクトファイルとして生成します。TUはコンパイラが個別に読み込み、最適化する単位を指します。
通常のC++ビルドでは、別のTUにある関数本体を参照できないため、短い関数でもインライン化されず、call命令が残ることがあります。IL2CPP生成コードには小さな関数や安全チェックが多く、この制約の影響を受けやすい構造です。例えばbuf[idx]というC#の1行は、おおよそリスト5.2のC++になります。
リスト5.2: IL2CPPが生成する配列アクセスコードの例
1 2 3 | if (buf == NULL) ThrowNullReferenceException(); // null チェック if ((uint32_t)idx >= buf->max_length) ThrowIndexOutOfRange(); // 境界チェック val = buf->m_Items[idx]; |
生成コードの規模が大きくなるほど、TUをまたぐ呼び出しも増え、呼び出しにかかる時間の合計も増えます。
5.2 LTO / ThinLTOとは
LTO(Link Time Optimization)は、リンク時にTUをまたいだインライン化、定数伝播、不要コード削除を行うclang/LLVMの仕組みです。コンパイル時にはオブジェクトファイルをLLVM bitcode(最適化前の中間表現)として出力します。リンク時にそれらをまとめて最適化し、機械語を生成します。
full LTOは、全ての中間表現を一つにまとめて最適化します。最適化できる範囲は最も広いものの、中間表現の統合と最適化が単一プロセスに集中するため、大規模なビルドでは多くのメモリを使います。今回も実タイトルのビルド中にメモリ使用量が20GBに達し、OSによってプロセスが強制終了されました。
ThinLTOは、コンパイル時に各TUのサマリを作成します。リンク時には必要な関数を他のTUから取り込み(import)、並列に最適化します。full LTOよりもメモリ使用量と処理時間を抑えやすく、大規模ビルドで広く使われています。
5.3 エンジンコードのThinLTO設定
Unity 6000.5で、Link Time Optimizationトグルが追加されました。
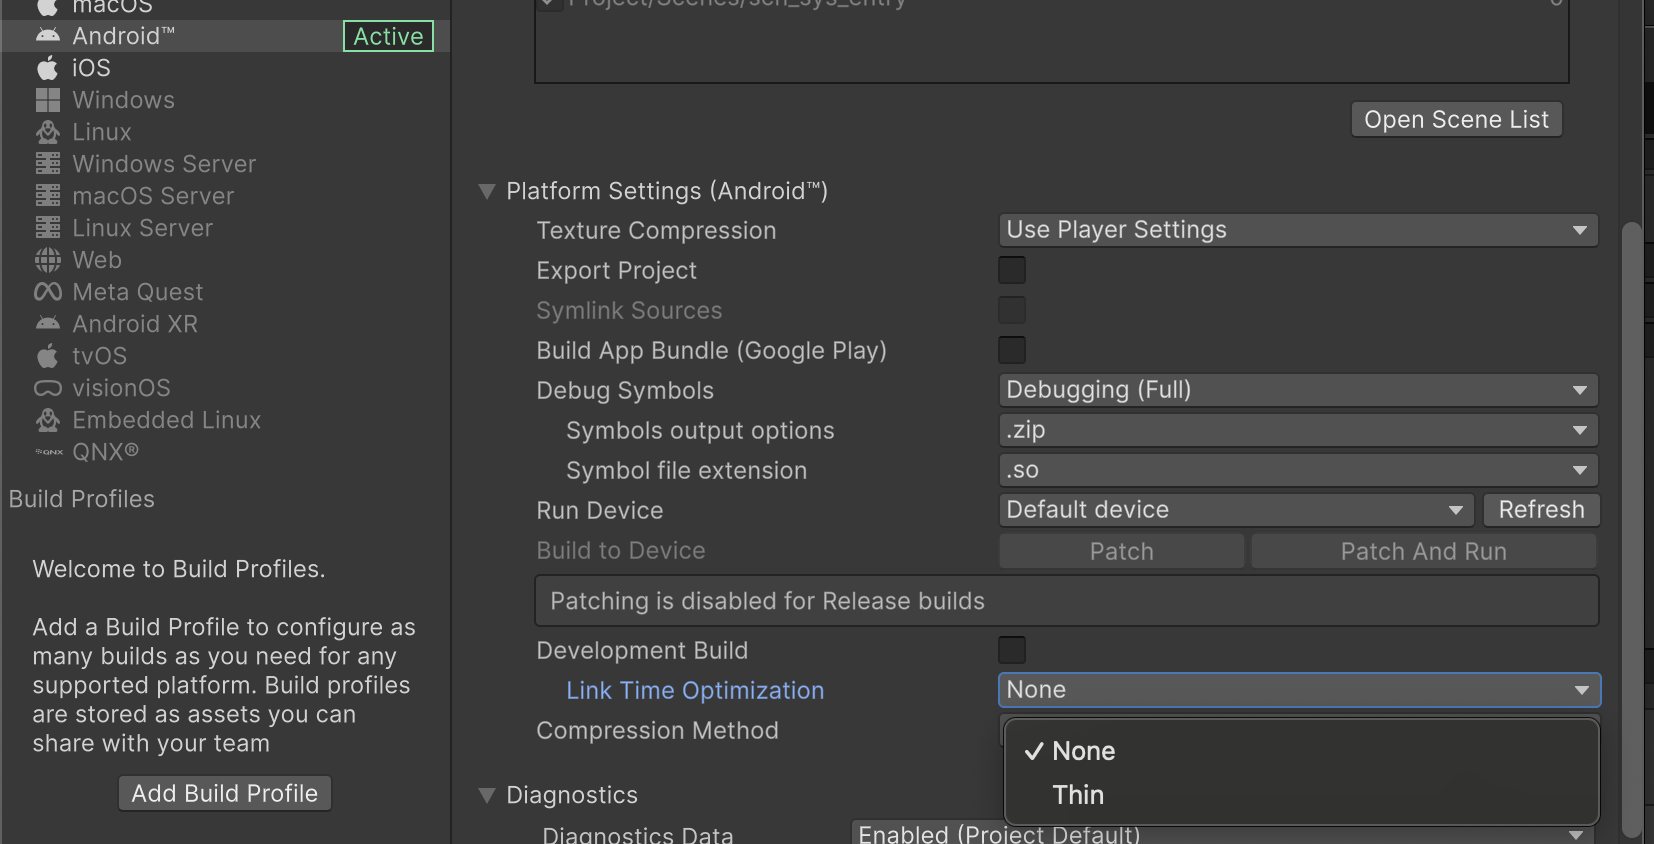
図5.1: Build Profiles > Player Settings > Android
このトグルを有効にすると、Unityが提供するThinLTO適用済みのエンジンバイナリが選択されます。対象はUnityエンジンコードで、IL2CPP生成コード(C#由来のコード)は含まれません。エディタのインストールフォルダには、通常版とThinLTO版の事前ビルドされたsoファイルが同梱されています。
リスト5.3: Android Playerに同梱されるlibunity.soのバリアント
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Libs/arm64-v8a/libunity.so 29,032,960 bytes └── Release_ThinLTO/Libs/arm64-v8a/libunity.so 30,042,536 bytes (+3.5%) |
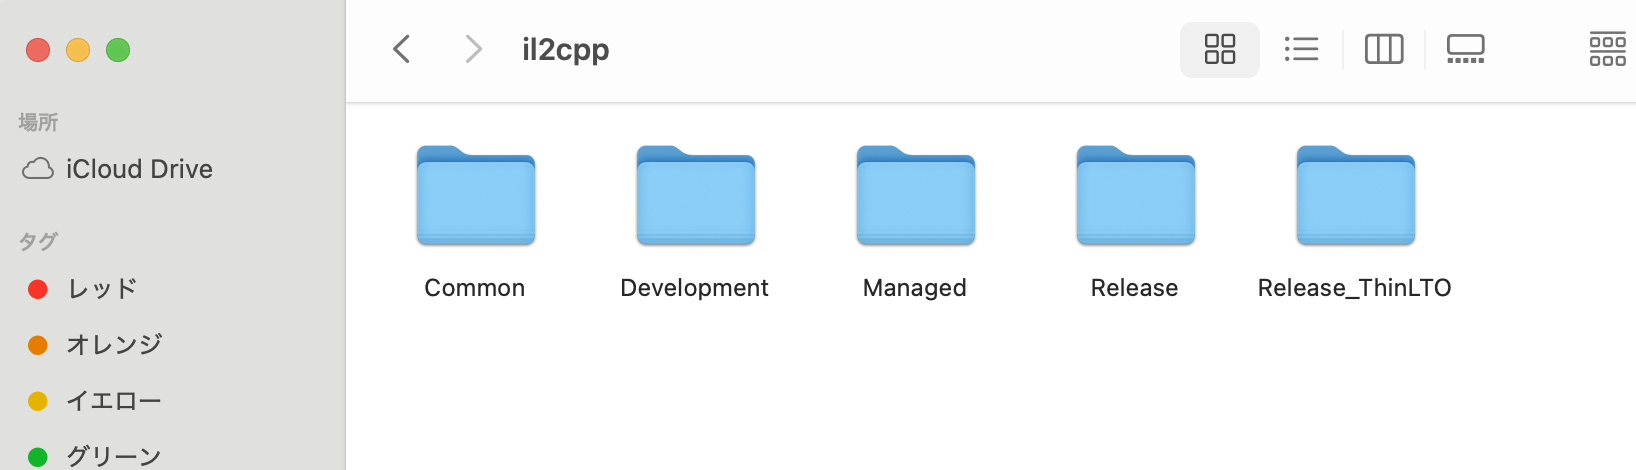
図5.2: エディタのインストールフォルダ。ReleaseとRelease_ThinLTOが両方とも同梱されており、ビルド時にどちらかが選ばれます
5.3.1 有効条件と、満たさない場合の動作
トグルが有効になる条件は次の3つです。いずれかを満たさない場合、エラーや警告は出ず、LinkTimeOptimizationはNoneとしてビルドされます。
- IL2CPPスクリプティングバックエンド
- Strip Engine Codeが無効(未ストリップのprebuiltをそのまま使うため)
- 非Developmentビルド
Development Buildが有効な場合は、トグル自体が表示されません。適用の有無は、リスト5.4の2点で確認できます。
リスト5.4: エンジンコードLTOトグルの適用確認コマンド
1 2 3 4 | # ① ビルド入力で ThinLTO が指定されているか grep -o 'LinkTimeOptimization"[: ]*"[A-Za-z]*"' Library/Bee/Player*-inputdata.json # ② APK 内の libunity.so が Release_ThinLTO 版と一致するか unzip -p out.apk lib/arm64-v8a/libunity.so | md5 |
5.4 エンジンコードLTOトグルの効果
同梱されている通常版とThinLTO版のバイナリを比較し、変更が多いサブシステムを中心に実機で性能を測定しました。
5.4.1 同梱バイナリの関数サイズを比較する
Unityは両バリアントのシンボル付きの.soをエディタのインストールフォルダに同梱しています。
リスト5.5: Android Playerに同梱されるシンボル付きlibunity.so
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Symbols/arm64-v8a/libunity.sym.so └── Release_ThinLTO/Symbols/arm64-v8a/libunity.sym.so |
llvm-nm --defined-only --print-size --demangleで得た関数名を照合し、名前空間とクラス名を使ってサブシステム別に集計しました(表5.1)。
表5.1: エンジンコードLTOトグルによるサブシステム別の関数差分
| サブシステム | 関数数 (Release → ThinLTO) | サイズが変わった関数数 | サイズ変化率 | .text差 |
|---|---|---|---|---|
| Particle | 1,419 → 1,290 | 1,043 | 80.9% | +49.66% |
| Serialization/Asset | 2,890 → 1,387 | 1,040 | 75.0% | -16.61% |
| Mesh/Geometry | 1,055 → 765 | 483 | 63.1% | +6.79% |
| Scripting | 8,924 → 7,680 | 4,302 | 56.1% | +10.27% |
| Gfx/Shader/Texture | 5,062 → 3,935 | 2,044 | 52.1% | +24.21% |
| Physics | 2,680 → 2,439 | 1,229 | 51.1% | +15.92% |
| NavMesh | 739 → 582 | 296 | 51.1% | +11.87% |
| XR/VFX/Video/その他 | 3,828 → 2,483 | 1,230 | 49.6% | +13.94% |
| Transform/Scene/Obj | 2,027 → 1,630 | 781 | 47.9% | +10.95% |
| Animation/Mecanim | 3,226 → 2,428 | 1,134 | 46.8% | +13.18% |
| Box2D | 2,169 → 1,562 | 712 | 46.4% | -0.43% |
| JobSystem/Threading | 244 → 181 | 78 | 43.6% | +3.16% |
| UI/UIToolkit | 883 → 701 | 293 | 42.0% | +1.38% |
| TextCore/Font/ICU | 3,500 → 2,101 | 861 | 41.9% | -5.73% |
| (未分類) | 29,193 → 21,077 | 7,511 | 37.6% | +3.37% |
| Renderer/Culling | 2,789 → 2,199 | 785 | 35.7% | +27.58% |
| C++標準/圧縮/インフラ | 13,158 → 9,484 | 3,071 | 32.6% | -13.31% |
| curl/TLS/HTTP | 1,809 → 1,558 | 318 | 21.0% | +1.17% |
| Audio/FMOD | 2,996 → 2,680 | 496 | 18.5% | +2.77% |
| Android/JNI | 1,445 → 1,186 | 193 | 16.3% | -5.52% |
| PhysX | 6,000 → 5,997 | 0 | 0.0% | -0.05% |
| 合計 | 96,036 → 73,345 | 27,900 | 38.8% | +4.41% |
※ 「サイズが変わった関数数」は関数の本数です。「サイズ変化率」は、ReleaseとThinLTOの両方に存在する関数のうち、サイズが変わった関数の割合を表します。
全体の関数数は96,036から73,345に減りましたが、.textのサイズは4.41%増えました。
5.4.2 13本のワークロードによるベンチマーク
表5.1を基にして、1つのAPKに13本のワークロードを入れたベンチマークシーンを作りました。
表5.2: エンジンコードLTOトグルのベンチマークワークロード
| ワークロード | 対象サブシステム | 内容 |
|---|---|---|
particle | Particle | 20,000粒子 + noise/size/colorモジュール、Simulate |
gfx | Gfx/Shader | MaterialPropertyBlockに16プロパティ × float/vector + matrixを書いてClear |
cull | Renderer/Culling | CalculateFrustumPlanes + 4,096 AABBのTestPlanesAABB |
physbind | Physicsバインディング | Rigidbody / Colliderプロパティ往復 |
anim | Animation | legacy Animation 48リグ × 8ボーン × 10カーブをSample() |
json | Serialization | JsonUtilityの往復 |
instantiate | Serialization | Instantiate → DestroyImmediate(ネイティブのclone/transfer経路) |
xform | Transform/Scene | 階層つきTransformの書き換え |
bind | Scriptingバインディング | 極小のバインディング呼び出しを大量に |
mesh | Mesh/Geometry | 96×96手続きメッシュの再構築 |
phys2d | Box2D | 2D剛体のSimulate |
text | TextCore/Font | TextGenerator.Populate |
physics | PhysX | 3D剛体のSimulate |
※ 表5.1のサブシステムのうち、1サンプル100ms程度の安定した合成負荷をC#から作るのが難しいものは、測定対象から外しました。これらについては性能への影響を評価していません。
5.4.3 ワークロード別の測定結果
libunity.soだけが異なるAPKをPixel 8a(Tensor G3)で、先ほど紹介したワークロードを測定しました。Release / ThinLTO / ThinLTO / ReleaseのABBA順を3回繰り返し、合計12セッションを実行しています。セッションごとにアプリを再インストールし、間には90秒のクールダウンを挟みました。
値は1回の操作にかかる時間(ns/op)です。操作の単位はワークロードごとに異なるので、絶対値は同じ行の中で比較してください。
表5.3: エンジンコードLTOトグルのワークロード別ベンチマーク結果
| ワークロード | Release (ns/op) | ThinLTO (ns/op) | 差 |
|---|---|---|---|
gfx | 990.46 | 852.49 | -13.93% |
cull | 96,520 | 87,499 | -9.35% |
text | 275,043 | 265,123 | -3.61% |
instantiate | 14,620 | 14,206 | -2.83% |
xform | 6,071.8 | 6,008.1 | -1.05% |
phys2d | 222,269 | 220,327 | -0.87% |
mesh | 2,340,210 | 2,334,143 | -0.26% |
json | 15,864.8 | 15,934.4 | +0.44% |
bind | 140.80 | 141.47 | +0.47% |
physbind | 607.28 | 610.74 | +0.57% |
particle | 265,635 | 267,335 | +0.64% |
anim | 28,100 | 28,563 | +1.65% |
physics | 484,641 | 482,796 | -0.38% |
| [合成: 幾何平均] | 21,918 | 21,380 | -2.46% |
※ 単位が行ごとに違うため、合成値は比率としてのみ意味を持ちます。
改善が大きかったgfxとcullは、C#から小さな関数を1サンプルあたり数百万回呼び出す処理です。textのTextGenerator.Populateも内部でグリフ単位のループを実行します。1回の処理が小さく、呼び出し回数が多い経路で、TUをまたぐインライン化の効果が大きく現れました。
5.4.4 導入時の性能・サイズ・メモリの比較
今回の測定では、バインディング呼び出しの多い一部の経路でCPU時間が短縮する効果がありました。ただし、実タイトルでの改善幅は、フレーム内でこうした呼び出しが占める割合に左右されます。
導入時に払わないといけないコストを表5.4にまとめました。
表5.4: エンジンコードLTOトグル採用時のコスト
| 区分 | 実測差 |
|---|---|
| Strip Engine Code OFFによるサイズ増加 | APK +5.67MB / インストール +20.3MB |
| Strip Engine Code OFFによるメモリ増加 | RSS +18.0MB / うち回収されにくい領域 +8.0MB |
| engine ThinLTO本体 | APKサイズ +398KB(30,621,595 → 31,019,967)/ メモリは未測定 |
※ インストールサイズの増分は、APKの増分と、端末で展開された.soの増分(arm64の.so合計で +14.65MB)の合計です。
Unityは同じトグルについて、5プロジェクトでコールドスタートを10回ずつ測定した結果を公開しています。CPU時間は13.88msから13.36ms(-3.7%)、初期表示までの時間は247.96msから229.90ms(-7.3%)に短縮し、APKサイズは +3.3%、ビルド時間への影響は軽微と報告されています*1。
CPUの改善幅は今回の測定と近い水準です。ただし、公開値のAPKサイズ +3.3%はStrip Engine Codeを無効にした構成どうしの比較のため、無効化に伴うインストールサイズ +20.3MB、メモリ +8.0MBの増加は含まれません。
5.5 libil2cpp.soにLTOをかける方法
C#から変換されたコードを含むlibil2cpp.soにLTOを適用するには、UnityのMaster構成を使う方法と、clangフラグを直接渡す方法があります。
5.5.1 Master構成とIL2CPP LTO Modeの設定
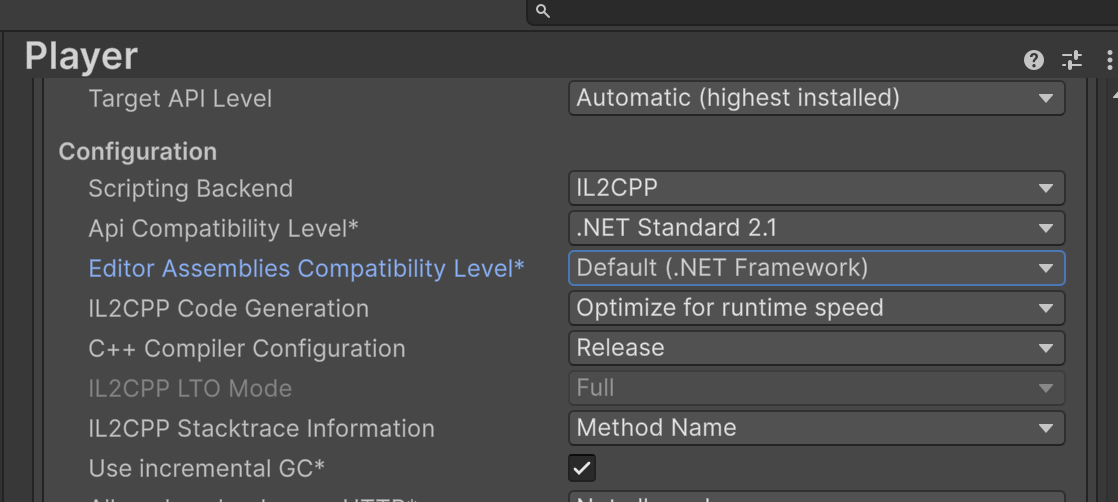
図5.3: IL2CPP LTO ModeとC++ Compiler Configurationの設定画面
Player Settings > ConfigurationのC++ Compiler ConfigurationをMasterにすると、libil2cpp.soへのLTOが有効になります。IL2CPP LTO Modeは、その際に使うThin / Fullのモードを選ぶ項目です。
Unityの公式記事によると、IL2CPP LTO Modeは6000.5から追加されました。6000.5より前のAndroidでは、LTOの有無についてReleaseとMasterに差はありません。ただ6000.5でAndroidプラットフォームではトグルの選択はできずThin固定で、6000.6からMaster構成でThin / Fullを選択できるようになりました。6000.7時点でも、Release構成のままLTOだけを有効にする項目はありませんでした。
Player SettingsのC++ Compiler Configurationに対応するフラグは、BeeビルドグラフのIl2CppCompilerConfigurationから確認できます。
表5.5: UnityのC++ Compiler Configuration別コンパイラフラグ
| バージョン | Release | Master |
|---|---|---|
| Android 6000.3 (arm64) | -Os(サイズ優先)、LTOなし | -Os、LTOなし(同一) |
| Android 6000.5 (arm64) | -Os | -O2(速度とコードサイズのバランスを取る最適化) + ThinLTO |
| iOS 6000.3 / 6000.5 | -O3(コードサイズが増える可能性と引き換えに、より積極的に速度を追う最適化)、LTO OFF | -O3、LTO OFF(同一) |
5.5.2 Release構成に-flto=thinを追加する
先述の通り、Master構成に切り替えることが最速でLTOの効果を得られる道ですが、LTOと同時に最適化レベルも-Osから-O2に変わり(表5.5)、デメリットとしてサイズとビルド時間が増えます。Release構成を維持したままThinLTOだけを適用すれば、LTOの効果を分けて測れるうえ、サイズとビルド時間の増加も抑えられます。自作のC#から生成されたlibil2cpp.soにThinLTOを適用するには、リスト5.6のようにclangフラグを直接渡す方法が考えられます。
リスト5.6: Release構成でThinLTOを有効化するビルド前処理
1 2 3 4 5 6 7 8 9 10 11 12 13 | // 既存の追加引数を退避 → 追記 → 必ず元に戻す var saved = PlayerSettings.GetAdditionalIl2CppArgs(); try { var extra = "--compiler-flags=-flto=thin --linker-flags=-flto=thin"; PlayerSettings.SetAdditionalIl2CppArgs( string.IsNullOrEmpty(saved) ? extra : saved + " " + extra); BuildPipeline.BuildPlayer(options); } finally { PlayerSettings.SetAdditionalIl2CppArgs(saved); } |
適用できたかは、2段階で確認します(リスト5.7)。
1つ目は、ビルドコマンドにフラグが渡ったかです。Unityのビルドシステム(Bee)は、実行したコンパイルとリンクのコマンドをLibrary/Bee/Player*.dag.jsonに記録します。このファイルを-flto=thinで検索し、IL2CPP生成コードのコンパイルとlibil2cpp.soのリンクの両方に含まれているかを見ます。
2つ目は、生成されたオブジェクトファイルがLLVM bitcodeになっているかです。LTOを有効にすると、コンパイル結果の.oは機械語ではなくbitcodeになります。1つ目で見つけたコンパイルコマンドの出力ファイルを1つ選び、先頭4バイトを表示します。
リスト5.7: IL2CPP ThinLTOの適用確認コマンド
1 2 3 4 | # 1. コンパイルとリンクのコマンドに -flto=thin があるか rg -n -- '-flto=thin' Library/Bee/Player*.dag.json # 2. 生成オブジェクトの先頭4バイト(1. で見つけた .o を指定) xxd -l 4 Library/Bee/artifacts/Android/.../GeneratedCode.o |
bitcodeなら4243 c0de(BC..)、通常の機械語のオブジェクトなら7f45 4c46(.ELF)が表示されます。フォルダ内の.oを適当に選ぶと、LTOの対象外であるサードパーティ製ライブラリのオブジェクトを拾うことがあります。2つ目のコマンドには、必ず1つ目の検索結果に出てきたファイルを指定してください。
5.5.3 ベンチマークの設計
合成コードの生成
このベンチマークでは、通常のコンパイルでは最適化できないTUをまたぐ呼び出しを主な測定対象にします。asmdefの境界とC++のTU境界は同じ概念ではないため、IL2CPP変換後の生成C++とBeeのコンパイルグラフで、呼び出し元と呼び出し先が別TUになることも確認しました。コードジェネレータで生成した内容は次のとおりです。
- asmdefアセンブリ16個 × クラス24個 × メソッド8個 = 3,072メソッド
- 呼び出しチェーンが1周で16のアセンブリ境界を通過、全メソッドが共有アセンブリのヘルパー(
Core.Mix/Core.Idx/ 構造体演算)も追加で呼ぶ - ベンチマークが全クラスを巡回するためmanagedストリッピングに消されない
- メソッドごとに定数を変えてICFによる折り畳みを防止
生成する3,072個のメソッドの例をリスト5.8に示します。
リスト5.8: 合成ベンチマークで生成するメソッドの例
1 2 3 4 5 6 | public static int M2(int sel, int x, int[] buf) { x = Core.Mix(x, 655663086); // 共有アセンブリへの境界越え呼び出し x += buf[Core.Idx(x, 7)]; // 境界チェック付き配列アクセス(Idx は & 1023 でマスク) return M3(sel, x, buf); // 小関数チェーン } |
2つのワークロード
表5.6: IL2CPP ThinLTOの合成ベンチマークワークロード
| ワークロード | 何を測るか |
|---|---|
| direct | クロスアセンブリ静的呼び出しチェーン(LTOが最も効くはずの形) |
| iface | 同種の演算をインターフェイスディスパッチ経由で実行(LTOが呼び出し先を直接化しにくい形) |
どちらもlibil2cpp.soの中だけで完結します。各構成で生成されたバイナリは、APKから抽出したlibil2cpp.soのmd5で毎回確認しています。1サンプルが約100msになるよう、実行時に反復回数を調整します。実行ごとに回数が異なるため、1 passあたりの時間に正規化して比較します。
ifaceでは、各アセンブリにIGenOpを実装したクラスを4個ずつ(計64個)生成し、ベンチマークがインターフェイス経由で順に呼び出します(リスト5.9)。メソッド本体ではdirectと同じCore.Mix / Core.Idxを呼びますが、どのクラスのApplyが呼ばれるかは実行時に決まります。
リスト5.9: ifaceワークロードで生成するクラスと呼び出しループ
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | sealed class Op0 : IGenOp { int m_State = 20612; public int Apply(int x, int[] buf) { x = Core.Mix(x, 347275849); // 共有アセンブリへの境界越え呼び出し x += buf[Core.Idx(x ^ m_State, 7)]; // directと同種の配列アクセス m_State = (m_State + x) | 1; return x; } } // ベンチマーク側:64個の実装をインターフェイス経由で巡回 for (int i = 0; i < ops.Count; i++) a += ops[i].Apply(a ^ p, buf); // 呼び出し先は実行時に決まる |
5.5.4 CPU実測(Pixel 8a)
表5.7: Pixel 8aにおけるIL2CPP ThinLTOのCPU実測結果
| 構成 | direct (us/pass) | iface (us/pass) |
|---|---|---|
| off(Release, -Os) | 19.88 | 0.404 |
| thin(手動ThinLTO) | 15.54 (-21.8%) | 0.375 (-7.3%) |
手動ThinLTOにより、directは21.8%、ifaceは7.3%短縮しました。
directの関数呼び出しと命令数
§5.3.1と同じ呼び出し構造について、LTOの有無で逆アセンブル結果を比較しました。
表5.8: directワークロードの逆アセンブル比較
C000_M2 | LTOなし | ThinLTO |
|---|---|---|
| 命令数 | 15 | 11 |
関数呼び出し(bl) | 2 | 0 |
| スタックフレーム | あり | なし |
| callee-savedレジスタの退避 | x19、x20、x29、x30 | なし |
| メモリアクセス | 5回 | 1回 |
Core.MixとCore.Idxの本体が呼び出し元へ展開され、bl命令2個と、スタックやレジスタの退避処理が不要になりました。両関数をまたいだ式もまとめて最適化されます。directの21.8%短縮は、この変化が3,072メソッド分積み重なった結果です。
ifaceの改善が小さい理由
IL2CPPが生成するinterface呼び出しは、概略するとリスト5.10の形です。
リスト5.10: IL2CPPが生成するinterface呼び出しコードの概略
1 2 3 | const VirtualInvokeData& invokeData = il2cpp_codegen_get_interface_invoke_data(slot, obj, declaringInterface); return ((Func)invokeData.methodPtr)(obj, p1, p2, invokeData.method); |
呼び出し先は実行時に得るinvokeData.methodPtrなので、通常のC++ vtable呼び出しのようには直接化できません。ただし、メソッド本体から別TUのヘルパーを呼ぶ部分はインライン化でき、ifaceでも7.3%短縮しました。
interface / virtual呼び出しに時間がかかっている場合は、sealed、具象型での受け取り、ジェネリクスによる静的ディスパッチも検討できます。ThinLTOで改善しやすいのは、別TUの小さな関数を静的に呼び出す部分です。
5.5.5 サイズとビルド時間
表5.9: IL2CPP ThinLTOのサイズとビルド時間
| 構成 | libil2cpp.so (MB) | 同.text | コールドビルド |
|---|---|---|---|
| off | 37.36 | 基準 | 62s |
| thin | 38.16 (+2.2%) | +2.3% | 71s (+15%) |
この構成では、インライン展開の影響でlibil2cpp.soが2.2%増えました。LTOは不要コードを削除する場合もあるため、サイズ変化の方向はコードベースと最適化内容に依存します。コールドビルドは62sから71sへ15%増えました。ThinLTOでは、TUをまたいだ最適化と機械語の生成をリンク時に行うため、その分リンクの時間が延びます。
5.6 Master構成で有効になる最適化
Master構成ではLTOと同時に最適化レベルも変わります(表5.5)。CPU時間の短縮がどの設定によるものかを調べるため、それぞれを分けて測定しました。最適化レベル(-Os → -O2)とLTOの影響を個別に調べるため、{-Os, -O2} × {LTOなし, ThinLTO} の2×2を実測しました(Android 6000.5 / arm64)。
表5.10: 最適化レベルとThinLTOのCPU実測比較
| direct (us/pass) | LTOなし | ThinLTO |
|---|---|---|
| -Os(Release) | 19.64(基準) | 15.54 (-20.9%) |
| -O2(Master) | 18.47 (-5.9%) | 15.54 (-20.9%) |
表5.11: 最適化レベルとThinLTOのlibil2cpp.soサイズ比較
| libil2cpp.so | LTOなし | ThinLTO |
|---|---|---|
| -Os | 37.36MB | 38.16MB (+2.2%) |
| -O2 | 39.14MB | 44.14MB (+12.8%) |
CPU時間の短縮率は-O2単独で5.9%、ThinLTOを含む構成で20.9%でした。このベンチマークでは、Master構成の改善の大半をThinLTOで得られたことになります。Release +手動ThinLTOとMasterのCPU時間は同じ15.54usでしたが、最終的なlibil2cpp.soのサイズは38.16MBと44.14MBで、Release +手動ThinLTOの方が約13.5%小さくなりました。
表5.12: Release + ThinLTOとMasterのコールドビルド時間
| 構成 | コールドビルド |
|---|---|
Release (-Os、LTOなし) | 62s |
| Release + ThinLTO | 71s (+15%) |
Master (-O2 + ThinLTO) | 86s (+39%) |
コールドビルドは71sと86sで、ReleaseにThinLTOだけを追加した構成の方が15秒短くなりました。Unityの公開測定でも、Master構成(libil2cpp.so側)はCPU -2.3%、初期表示までの時間 -5.7%に対して、libil2cpp.soサイズ +18.7%、ビルド時間 +30〜35%でした。CPUの改善幅はUnityの -2.3%に対して、本章のベンチマークでは -20.9%でした。ただし、Unityは実プロジェクトのメインスレッド全体、本章は小さな関数を繰り返し呼ぶ経路だけを測っているため、数字をそのまま比較することはできません。一方、サイズとビルド時間は本章のMasterでも +18.2%、+38.7%で、Unityの公開値と近い結果です。
5.7 実タイトルでの検証
ベンチマークより規模の大きい2つの実タイトルでもThinLTOを試しました。Unityバージョン、アセンブリ数、ソースコード量、バイナリサイズを表5.13に示します。
表5.13: 実タイトルのUnityバージョンとコード規模
| 項目 | タイトルA | タイトルB |
|---|---|---|
| Unityバージョン | 6000.5.3f1 | 6000.3.15f1 |
| プレイヤーに乗るアセンブリ数 | 158 | 285 |
コンパイルされる.cs | 6,969ファイル | 16,700ファイル |
| 同 行数 | 約138万行 | 約319万行 |
| うち自社コード | 1,943ファイル / 約35万行 | 8,606ファイル / 約154万行 |
libil2cpp.so(非圧縮) | 189.0MB | 294.3MB |
5.7.1 Release + ThinLTOのサイズと適用確認
表5.14: タイトルAのサイズとビルド時間
| 項目 | baseline | ThinLTO | 差分 |
|---|---|---|---|
| libil2cpp.so(非圧縮) | 189.01MB | 194.70MB | +5.69MB (+3.0%) |
同.text | 8.54MB | 8.98MB | +0.44MB (+5.1%) |
| APK | 165.85MB | 166.94MB | +1.08MB (+0.65%) |
| プレイヤービルド部分 | 約396s | 約433s | 約 +9% |
.text +5.1%はベンチマーク(+2.3%)より大きく、asmdefを細かく分けるほどモジュールをまたぐインライン化が増えるという予想に合う結果でした。189MBのlibil2cpp.soでも、ローカルマシンでThinLTOのリンクを完了できました。
タイトルBでは、llvm-readelf -Sでlibil2cpp.soのセクションごとのサイズを比較しました(表5.15)。
表5.15: タイトルBのlibil2cpp.soセクション差分
| 項目 | baseline | ThinLTO | 差分 |
|---|---|---|---|
| libil2cpp.so(ファイル全体) | 294.30MB | 304.12MB | +3.34% |
il2cpp | 145.85MB | 162.22MB | +11.23% |
.text | 10.69MB | 11.14MB | +4.18% |
.rela.dyn | 50.28MB | 45.01MB | -10.48% |
.got | 1.76MB | 1.4KB | -99.92% |
.gcc_except_table | 3.70MB | 3.62MB | -2.32% |
.textの増加率4.18%は、タイトルA(5.1%)とベンチマーク(2.3%)の間に収まりました。.gotは1.76MBから1.4KBに減っています。LTOによってモジュールをまたぐ参照が解決され、GOT経由の間接参照が直接参照へ変換されたことを示す結果です。動的再配置エントリを含む.rela.dynの10.5%削減も、この変化に対応します。
5.7.2 実タイトルでのMasterとfull LTO (タイトルA)
§6のMaster構成とfull LTOの比較を、実タイトル規模で試しました。
表5.16: タイトルAのビルド構成比較
| タイトルA | baseline | Release + thin | Master | full LTO |
|---|---|---|---|---|
| libil2cpp.so | 189.0MB | 194.7MB (+3.0%) | 222.2MB (+17.6%) | — |
| ビルド | 453s | 465s | 537s(9分) | 2,903s(48分)後に失敗 |
| リンカ経路のピークRSS | — | — | 12.9GB | 20GB → Killed: 9(OOM) |
full LTOは48分のビルド後、リンク中のメモリ使用量が20GBに達し、OSによって強制終了されました。§5.3のベンチマークでも、full LTOはCPU時間がThinLTOと同等のまま、コールドビルドが71sから247sへ約3.5倍になりました。このタイトルではビルドを完了できず、ThinLTOの方が実用的でした。
Masterのlibil2cpp.soのサイズはbaselineから約33MB増加しましたが、CPU性能はRelease + thinと同等でした。Release + thinではサイズの増加が約5.7MBに収まるため、このタイトルでもMaster同等の性能をより小さいバイナリで得られました。
5.7.3 実タイトルでのCPUサイクル (タイトルB)
アウトゲームの定常画面で、Pixel 8aの全スレッドのCPUサイクルを合算して測りました。ThinLTOとbaselineを交互に3セッションずつ測定し、各セッションの値は20秒の計測を6回行った平均です。
表5.17: タイトルBのセッション別CPUサイクル
| セッション | 総サイクル (Gcyc) | UnityMain (Gcyc) |
|---|---|---|
| ThinLTO #1 | 44.88 | 27.48 |
| ThinLTO #2 | 45.18 | 27.36 |
| ThinLTO #3 | 45.54 | 27.60 |
| baseline #1 | 46.06 | 29.05 |
| baseline #2 | 45.71 | 27.89 |
| baseline #3 | 46.15 | 28.23 |
| 平均(ThinLTO vs baseline) | 45.20 vs 45.97 → -1.68% | 27.48 vs 28.39 → -3.21% |
5.7.4 Unity公開値との比較
Unityが公開したMaster構成(libil2cpp.so側)の測定値を、タイトルBの結果と比較します。§6のベンチマーク結果も併記しました。
表5.18: Unity公開値と本章の実測結果の比較
| 指標 | Unity公開(6プロジェクト・Master) | ベンチマーク | タイトルB |
|---|---|---|---|
| CPU | メインスレッド -2.3% | direct -21.8% | UnityMain -3.21% / 総サイクル -1.68% |
libil2cpp.so | +18.7% | +2.2%(Release+thin)/ +18.2%(Master) | +3.0% |
| ビルド時間 | +30〜35% | +15%(Release+thin)/ +38.7%(Master) | +9〜15% |
UnityのCPU時間短縮率 -2.3%と、タイトルBのUnityMain -3.21%は、どちらも数%の改善でした。ベンチマークの -21.8%との差は、実タイトルの測定にはLTOの対象外の処理も含まれることで説明できます。Unityが測定した6プロジェクトでも同様の傾向が見られます。
サイズとビルド時間は構成によって差が出ました。Unityの公開値はMaster構成でそれぞれ +18.7% / +30〜35%です。本章で測ったMaster構成の +18.2%(44.14MB / 37.36MB)/ +38.7%(86s / 62s)とも近い値でした。基準となるlibil2cpp.soのサイズも37.26MB / 37.36MBと近くなっています。
ReleaseにThinLTOだけを追加した場合は、同等のCPU性能を、サイズ +2〜3%、ビルド時間 +9〜15%で得られました。§6の2×2比較から、Master構成でのサイズとビルド時間の増加は、主に-O2への変更によるものと考えられます。
5.7.5 最適化の対象範囲と実タイトルでの改善幅
タイトルBでの改善はメインスレッドに集中しています。UnityMainが -3.21%だったのに対し、非UnityMain全体は +0.8%で、セッション間のドリフト4%の範囲内でした。
バイナリでも、libil2cpp.so以外の.soはほぼ変化していません。ネイティブプラグイン2本はmd5が完全に一致し、残る1本の.textの差は +0.008%で、ビルドの非決定性の範囲でした。今回の--compiler-flagsによる最適化は、これらのプラグインには及んでいません。
UnityMainの -3.2%は、ベンチマークの -22%より小さくなりました。この画面では、表情・まばたき・髪や衣装の揺れ・IKなどがジョブとして実行されます。これらはlibil2cpp.soの外にあるネイティブバイナリに含まれ、今回のフラグによる最適化の対象外です。
対象外の処理を除いたIL2CPP生成コードだけの改善幅は、UnityMain全体の -3.21%より大きいと考えられます。ただし、正確な値を求めるには、プロファイラで対象内外の処理時間を分離する必要があります。ジョブはスケジューリングによってメインスレッドでも実行されるため、UnityMainの測定値にも対象外の処理が含まれます。
5.8 iOSのThinLTO適用
タイトルBのiOS版でもThinLTOを適用しました。検証用ベンチマークでは効果を確認できましたが、実タイトルではビルド時間の増加に見合う改善は得られませんでした。
5.8.1 iOSでのLTOの構造
表5.19: AndroidとiOSにおけるLTO構造の比較
| 観点 | Android | iOS |
|---|---|---|
| il2cppの出力 | libil2cpp.so | libGameAssembly.a |
| 最終リンク | il2cppが呼ぶLLD | XcodeがUnityFrameworkを作るときのld64 |
| 渡す引数 | --compiler-flags=-flto=thin --linker-flags=-flto=thin | --compiler-flags=-flto=thinだけ |
| ビルド時間が増える場所 | Unityのビルドステップ | Build ipa(xcodebuild)ステップ |
iOSでは、il2cppはアーカイブを作成するだけなので、--linker-flagsは渡しません。LTOのコード生成は、このbitcodeを含むアーカイブを読み込むXcode側のリンク時に行われます。
生成コードのコンパイルはil2cppが担当するため、フラグはAdditionalIl2CppArgsに指定しなければなりません。XcodeのLLVM_LTO = YES_THINを変更しても、生成コードには適用されません。
エンジンコードは事前ビルド済みのlibiPhone-lib.aとして提供され、bitcodeを持ちません。そのためLTOの対象外となります。AndroidのエンジンコードLTOトグル(§3)のように、LTO適用済みのエンジンへ差し替える設定もありませんでした。
5.8.2 iPhone 13の検証用ベンチマーク
まず、§5.3と同じ検証用ベンチマークをiOSに移植し、生成コードへのThinLTOがiOSでも機能するかを確かめました。directは16個のasmdefに分かれた3,072個の小さなメソッドをまたいで呼ぶ、ThinLTOが最も効果を出しやすい構成です。したがって、ここでの改善率は一般的なタイトルでそのまま得られる値ではなく、条件が合った場合の上限に近い値として扱います。
端末はiPhone 13(iPhone14,5 / iOS 18.7.8)です。Unity 6000.5.3f1、IL2CPP Release、OptimizeSpeedを使いました。baselineとThinLTOの違いは--compiler-flags=-flto=thinの有無だけです。XcodeはReleaseForRunning、開発署名はget-task-allow=trueで、UnityのDevelopment Buildは無効にしています。
セッションごとにアンインストール、再インストール、起動を行い、5回のウォームアップ後に30サンプルを記録しました。測定順はbaseline / ThinLTO / ThinLTO / baselineを3ブロック、合計12セッションです。全セッションでサーマル状態はNominalでした。処理回数はセッションごとに自動調整されるため、directとifaceは1 pass当たり、Physicsは1 step当たりに正規化しています。
表5.20: iPhone 13の検証用ベンチマーク結果
| ワークロード | baseline | ThinLTO | 差分 |
|---|---|---|---|
direct | 21,231.31ns/pass | 16,184.31ns/pass | -23.77% |
iface | 366.96ns/pass | 370.39ns/pass | +0.93% |
| Physics(対象外の対照) | 147.82us/step | 147.36us/step | -0.31%(分布は重複) |
directは3ブロックすべてで -23.6〜-23.9%となり、baselineとThinLTOの全セッションが完全に分離しました。Androidの -21.8%(§5.4)とも近く、生成コードへのThinLTOがiOSでも実際に機能することを確認できます。一方、ifaceはわずかに悪化し、対象外のPhysicsには差が出ませんでした。ThinLTOの効果は、静的な小関数呼び出しがTUをまたぐ経路に偏っています。同じベンチマークのバイナリサイズを表5.21に示します。
表5.21: iPhone 13検証用ベンチマークのバイナリサイズ
| 項目 | baseline | ThinLTO | 差分 |
|---|---|---|---|
| UnityFramework | 98.76MB | 107.52MB | +8.76MB(+8.87%) |
__text | 20.09MB | 20.46MB | +0.37MB(+1.83%) |
il2cpp | 22.49MB | 30.78MB | +8.30MB(+36.89%) |
5.8.3 タイトルBの結果とiOSで採用を見送った理由
次に、タイトルBのiOS版にThinLTOを適用しました。UnityFrameworkのサイズを表5.22、ビルド時間を表5.23に示します。
表5.22: iOS UnityFrameworkのセクション差分
| セクション | baseline | ThinLTO | 差分 |
|---|---|---|---|
| UnityFramework(ファイル全体) | 316.53MB | 393.47MB | +24.31% |
__TEXT(セグメント) | 261.83MB | 338.53MB | +29.29% |
il2cpp | 167.02MB | 240.26MB | +43.85% |
__text | 57.99MB | 61.70MB | +6.41% |
__gcc_except_tab | 6.85MB | 6.63MB | -3.16% |
__unwind_info | 3.44MB | 3.38MB | -1.75% |
__got | 18.8KB | 18.8KB | ±0 |
| ipa(アーカイブ全体) | 233.83MB | 246.93MB | +5.60% |
表5.23: iOSのビルド時間
| ステップ | baseline | ThinLTO |
|---|---|---|
Build ipa(xcodebuild) | 357s(5m57s) | 3,094s(51m34s) |
UnityFrameworkは +24.31%、ipaは +5.60%増えました。ビルド時間は約9倍、46分の増加でした。増加分の大半はXcode側のリンクとdsymutilによるもので、Androidの +9〜15%に比べて大幅に長くなっています。GCC_OPTIMIZATION_LEVELを-Osに下げた構成(-Os + thin)でも53m51sかかり、短縮できませんでした。
タイトルBの定常画面では、cpu/wallの単純平均はThinLTOが +1.08%とわずかに悪化し、サーマル状態が揃った組でも -1.45%の改善にとどまりました。baselineとThinLTOの分布は重なっており、大きなCPU改善を分離できませんでした。メモリ差の +0.40%もセッション内のばらつき以下です。検証用ベンチマークの -23.77%は、ThinLTOに有利な呼び出しを集めた場合の値であり、実タイトル全体には当てはまりませんでした。
実タイトルで明確な改善を確認できず、コールドビルドやCIで毎回約46分の追加時間が必要になるため、今回の検証ではiOSへの手動ThinLTOを不採用としました。
5.9 自分のタイトルに導入するには
Androidでは、まずRelease構成に-flto=thinを追加する方法を勧めます。今回のベンチマークではMasterと同等のCPU性能を、より小さいバイナリと短いビルド時間で得られました。実タイトルの定常画面でも総サイクルが1.68%、UnityMainが3.21%減りました(§7.3)。
エンジンコードLTOトグル(§3)は、Strip Engine Codeの無効化によるサイズとメモリの増加が大きいため、今回の構成では勧めません。
iOSへの手動ThinLTOはビルド時間の増加に見合う改善がなく、採用を見送りました。
採用前に、ReleaseビルドのProfilerキャプチャでPlayerLoop内のスクリプティング時間を調べてください。手動フラグの対象はlibil2cpp.so内で、レンダースレッド・GPU・エンジン内部・GCは対象外です。別のAOTパイプラインでコンパイルされるジョブも含まれません(§7.5)。DOTS/Jobを多用するタイトルでは、その処理時間も確認します。
例えば33msのフレームのうちスクリプティングが8msなら、その部分を約20%短縮できてもフレーム全体では約1.6msの短縮です。フレーム全体でのスクリプティングの割合が大きく改善の余地があるか、高いフレームレートを維持せねばならない状態でのみ、導入を検討すると良いでしょう。
ビルド時間の増加が開発中の作業に響く場合は、日常の開発ビルドには適用せず、ステージング以降のビルドだけに適用する方法もあります。フラグはビルド前処理で追加するため(リスト5.6)、ビルドの種類ごとに切り替えられます。
設定後は §3.1と §5.2の手順で適用を確かめます。inputdata、バイナリのmd5、コンパイルコマンドの-flto、オブジェクトファイルのbitcodeが確認箇所です。LTOの条件を満たさなくてもビルドは成功することがあるため、ビルド結果だけでは適用の有無を判断できません。
[*1] Unity Androidプラットフォームチーム「Boosting Android performance with LTO optimizations in Unity 6.5」https://discussions.unity.com/t/boosting-android-performance-with-lto-optimizations-in-unity-6-5/1720008。以降、本章で「Unityの公開値」と書くのはこの記事の数字です。