第1章 Unity 6 Render Graph タイルメモリ最適化
1.0.1 はじめに
本章では、Unity 6のRender Graphを利用して、モバイルGPU(タイルベースレンダリングアーキテクチャ)のタイルメモリを活用し、GPU時間・メモリ帯域・メモリ使用量を削減する方法を解説します。モバイルのゲーム開発では、GPUの演算性能よりも先にメモリ帯域がボトルネックになることが多くあります。また、メモリ帯域の消費は消費電力と発熱に直結するため、フレームレートだけでなく端末の発熱やバッテリー消費にも影響してきます。本章では次の4つをテーマとして解説していきます。それぞれに同名の節をあてています。
- タイルメモリのロード/ストア
- Render Pass/Subpass
- フレームバッファフェッチ
- メモリーレス
1.1 タイルベースレンダリングの基礎
この節では、なぜモバイルGPUがタイルメモリを持っているのかについて解説します。
1.1.1 モバイルGPUとメモリ帯域
現代のGPUは、演算速度とメモリの読み書き速度の差がどんどん大きくなっており、メモリアクセスが大きなボトルネックになっています。GPUコアの演算性能(FLOPS)は世代ごとに大きく伸びる一方で、メモリ帯域の伸びはそれに追いついていません。PCのディスクリートGPUは、この問題をGDDRのようなグラフィックス専用の広帯域メモリを搭載することで軽減しています。しかし、モバイルSoCではそうはいきません。
| 項目 | PC(ディスクリートGPU) | モバイルSoC |
|---|---|---|
| グラフィックスメモリ | 専用(GDDR6等、数百GB/s) | なし(LPDDRをCPU/GPU/ISP等で共有) |
| 帯域の規模感 | 数百GB/s~1TB/s | 数十GB/s(かつ共有) |
| 電力の制約 | 数百W級の電源と冷却 | 数W、パッシブ冷却のみ |
モバイルGPUには専用のグラフィックスメモリがなく、CPUと同じLPDDRメモリを共有しています。しかも共有相手はCPUだけでなく、カメラのISPや機械学習アクセラレータなどSoC上のあらゆるブロックです。帯域そのものが細いうえに、取り合いになります。さらに、メインメモリ(DRAM)へのアクセスはSoCの中でも特に電力を消費する操作です。帯域を使えば使うほど消費電力が増え、発熱し、サーマルスロットリングによってCPU/GPUのクロックが下がり、フレームレートが落ちます。つまりモバイルでは、
メモリ帯域の消費 → 消費電力の増加 → 発熱 → スロットリング → 性能低下
という流れが起きます。最初の数分は60FPSで動くのに、しばらく遊んでいるとフレームレートが落ちてくるという場合、この帯域と発熱が原因になっていることがよくあります。この制約の中で絵を描き切るために生まれたのが、タイルベースレンダリング(TBR: Tile-Based Rendering)アーキテクチャのGPUです。
1.1.2 IMRとTBR
TBRを理解するために、まずPCのGPUで主流のイミディエイトモードレンダリング(IMR: Immediate Mode Rendering)と比較してみましょう。IMRは、ドローコールで投入されたプリミティブをその場でラスタライズし、フラグメントシェーダーを実行し、結果をメモリ上のレンダーターゲットに書き込んでいく方式です。深度テストやブレンディングのたびにレンダーターゲットへの読み書きが発生しますが、PCのGPUは広帯域なグラフィックスメモリと大容量キャッシュでこれを受け止めています。一方TBRは、画面を小さなタイルに分割し、タイル1枚ずつレンダリングを完結させる方式です。各シェーダーコアにはタイルメモリと呼ばれる小さなオンチップメモリが搭載されており、タイル内の描画(カラー、深度、ステンシルの読み書き、ブレンディング)はすべてこのタイルメモリ上で行われます。メインメモリへのアクセスは、原則としてタイルの描画開始時(ロード)と終了時(ストア)の2回だけになります。
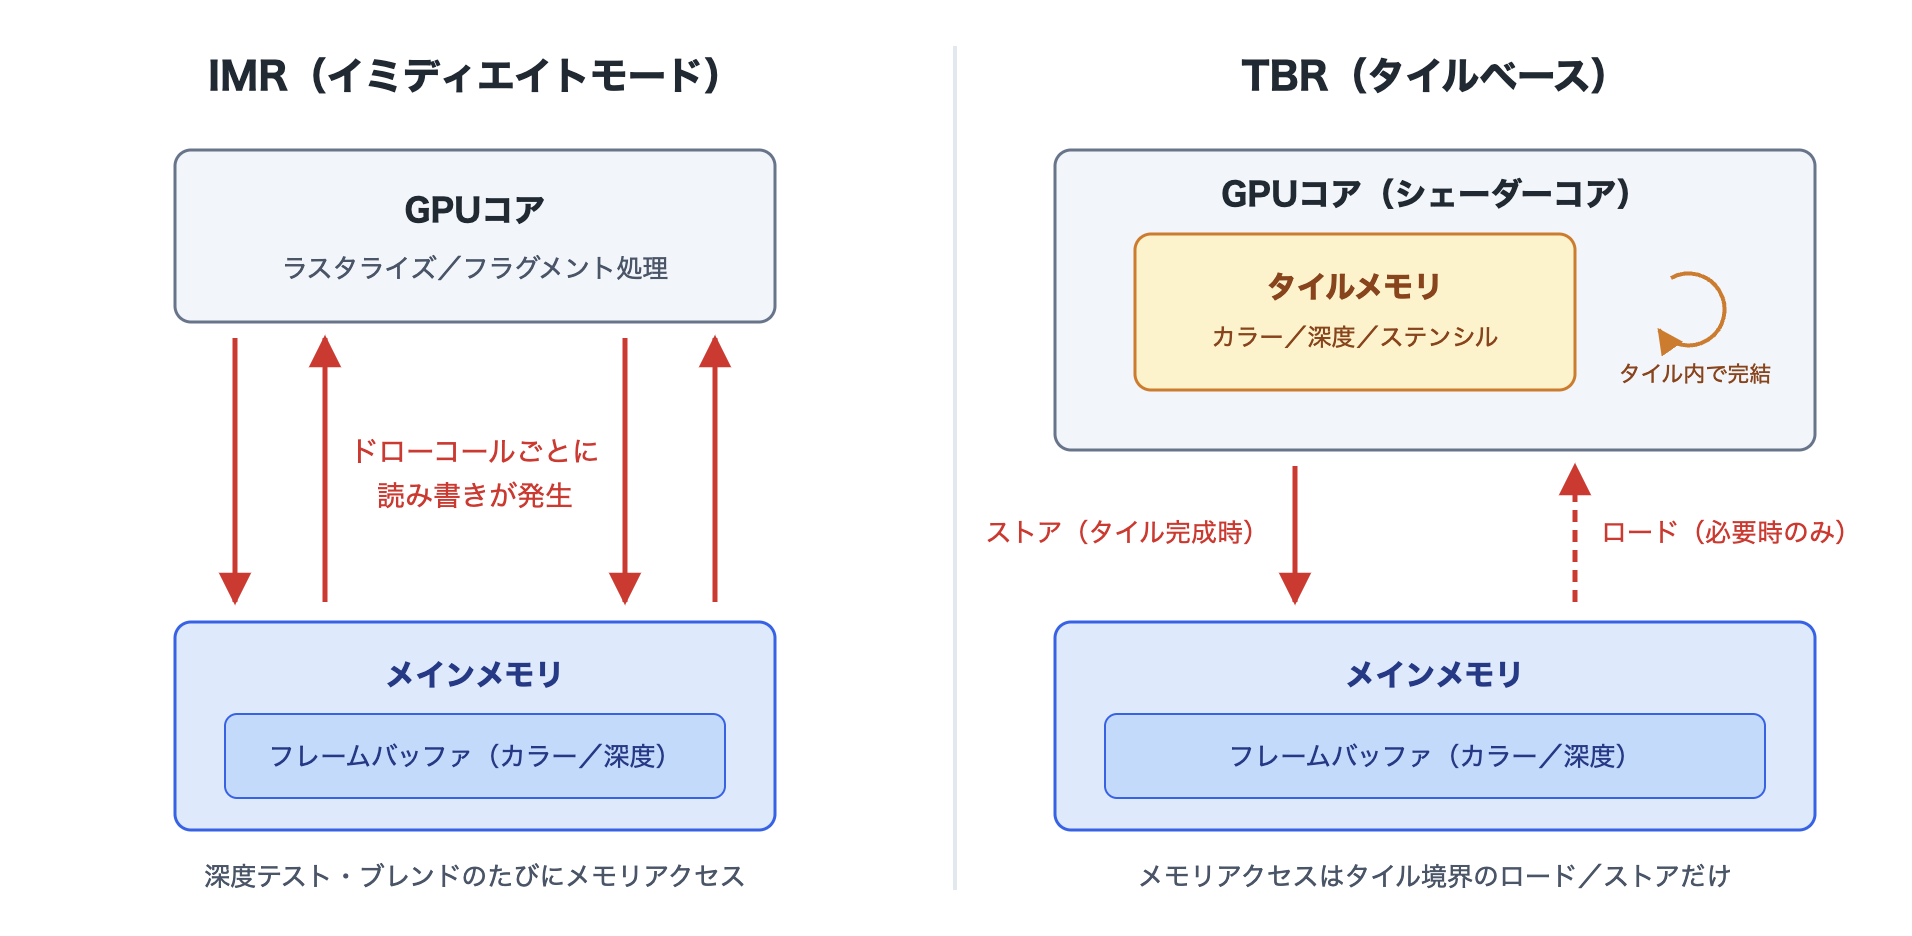
図1.1: IMRとTBRの比較
次の図はTBRのGPUにおけるシェーダーコアの概念図です。シェーダーコアにタイルメモリが直結しています。オンチップかつ物理的距離が近いため、タイルメモリへのアクセスはメインメモリへのアクセスと比べて桁違いに高速かつ低消費電力です。実際のGPUでもこの構造は確認でき、たとえばARM Mali-G71の公式資料のシェーダーコア設計図には、タイルメモリがシェーダーコアに直結している様子が示されています。
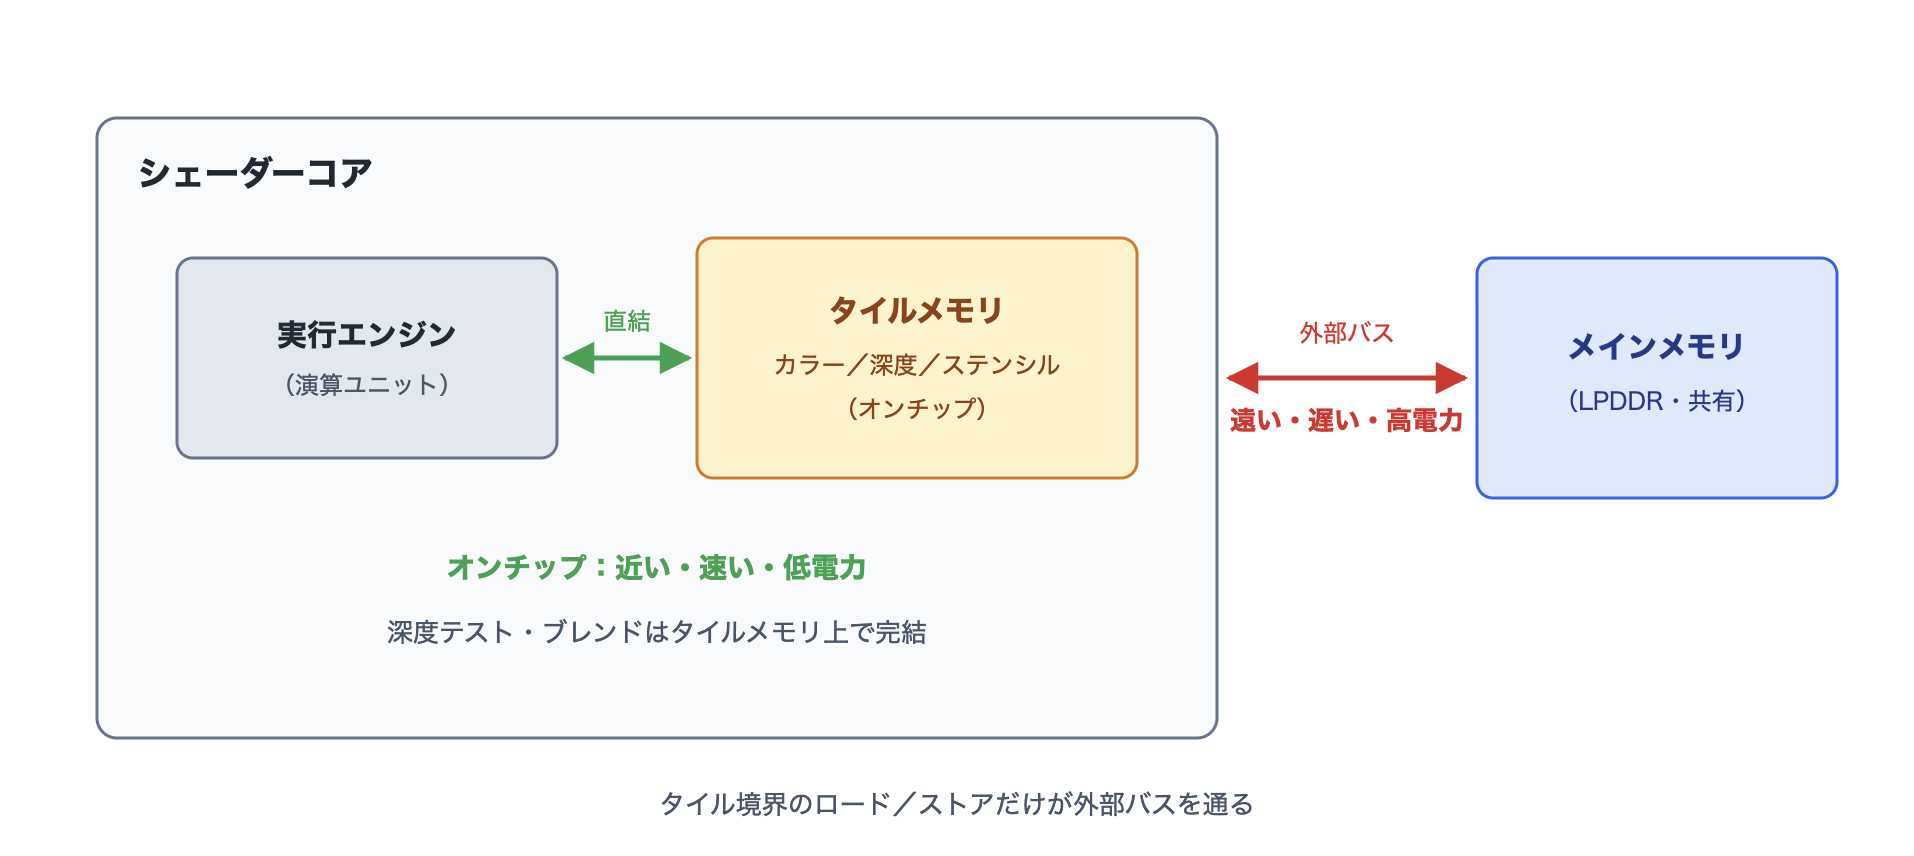
図1.2: シェーダーコアとタイルメモリ(概念図)
このように、IMRでは最もメモリアクセスが激しかった深度テストとブレンディングが、TBRではタイルメモリ内で完結します。
1.1.3 TBRの2フェーズ
TBRのGPUは、1フレームの描画を大きく2つのフェーズに分けて実行します。
ビニングフェーズ(ジオメトリフェーズ)
まず、フレーム内の全ドローコールの頂点シェーダー(の位置計算部分)を実行し、各プリミティブがどのタイルにかかるかを分類(ビニング)します。分類結果は「タイルごとのプリミティブリスト」としてメインメモリに書き出されます。ここで注意したいのは、ビニングフェーズ自体もメインメモリへの帯域を消費するという点です。頂点データが多いほどプリミティブリストの読み書きは増えます。TBRのGPUでハイポリゴンなシーンが不利になりやすいのはこのためです。
ラスタライズフェーズ(レンダリングフェーズ)
続いて、タイルを1枚ずつ処理していきます。各タイルについて、
- 必要であればレンダーターゲットの既存内容をタイルメモリにロード
- そのタイルにかかるプリミティブをラスタライズし、フラグメントシェーダーを実行(読み書きはすべてタイルメモリ上)
- 完成したタイルの内容をメインメモリにストア
という手順で描画が進みます。この手順1と3が、本章のテーマであるロード/ストアです。詳しくは次節「タイルメモリのロード/ストア」で扱いますが、タイルの描画そのものよりも、タイル境界でのメインメモリとのやり取りの方が高くつく、というのがTBRのコスト構造です。
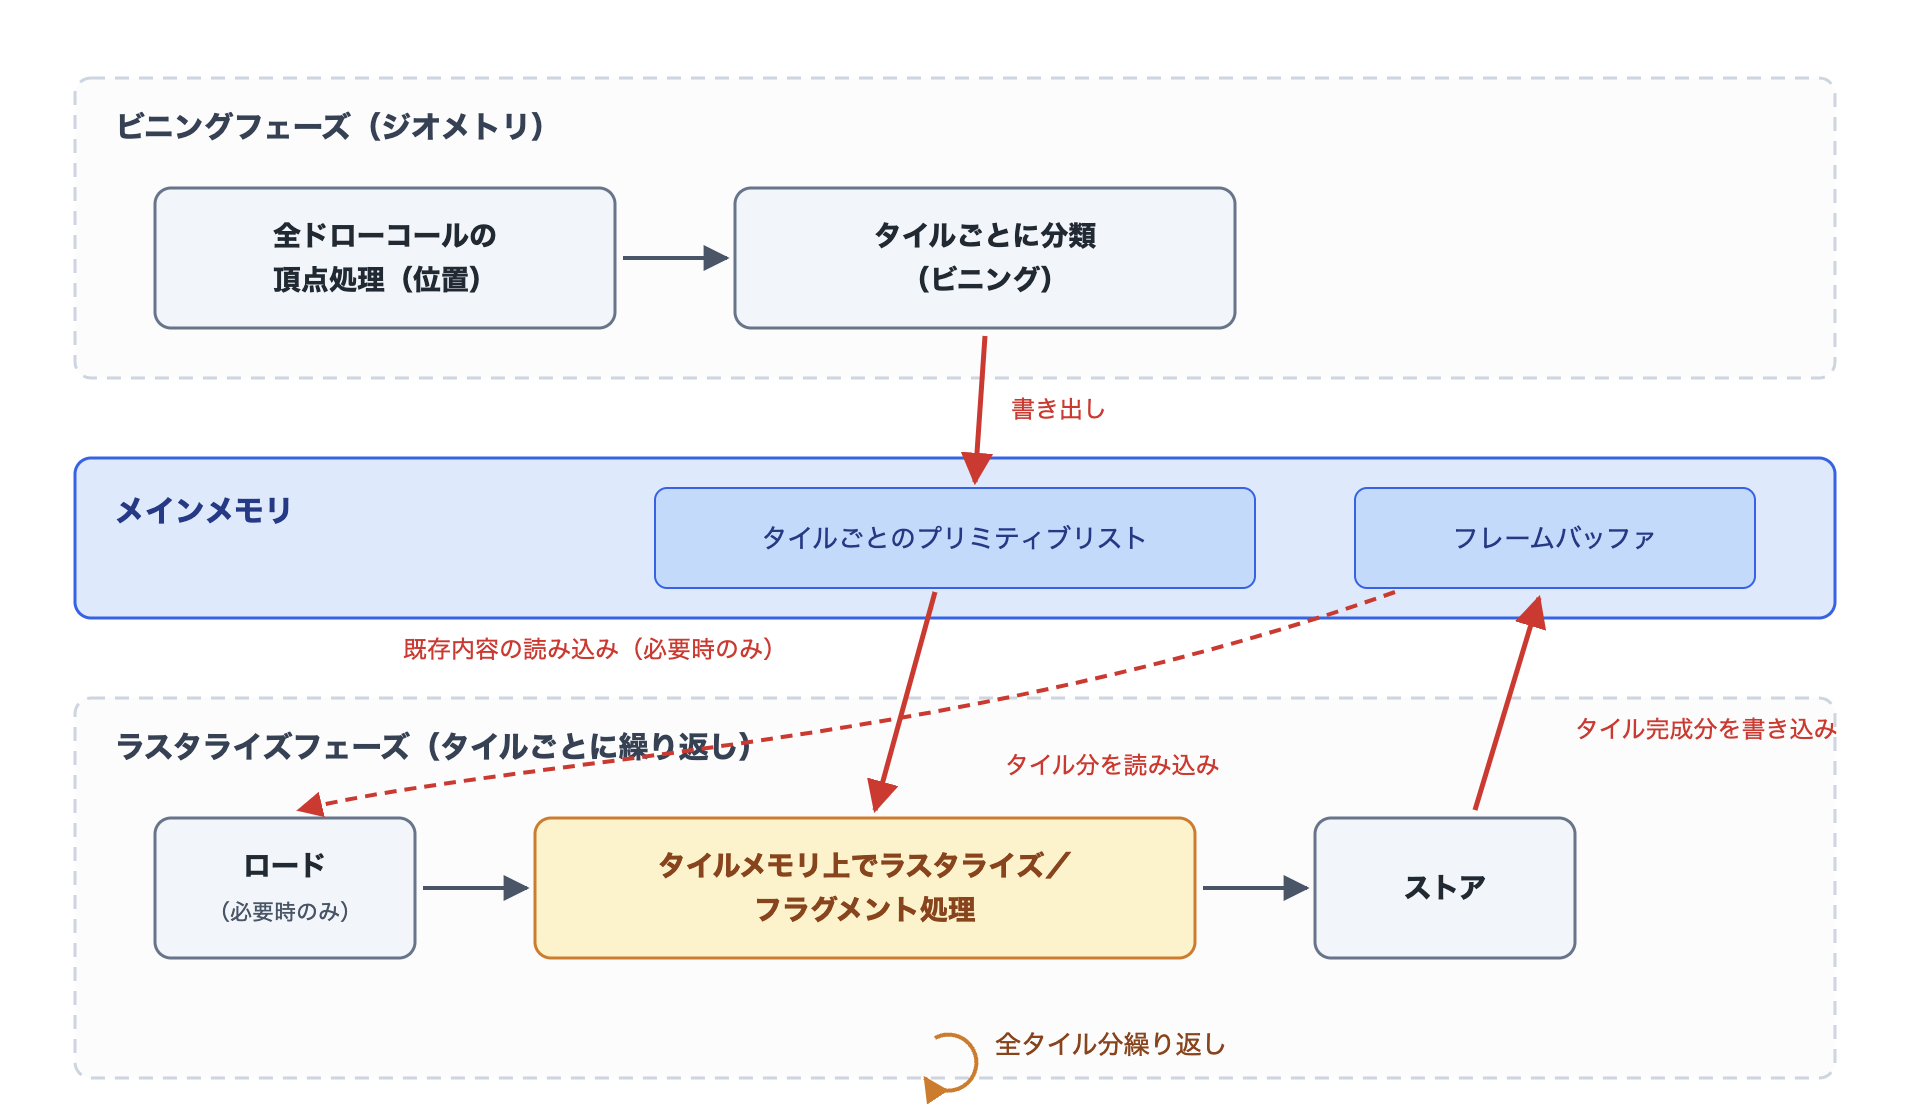
図1.3: ビニングフェーズとラスタライズフェーズ
ベンダーごとの呼称と特性
TBRの基本構造は共通ですが、GPUベンダーごとに呼称や細部の実装が異なります。本章では以降、総称としてタイルメモリ/ビニングという言葉を使います。
| ベンダー(GPU) | フェーズ/機構の呼称 | 特記事項 |
|---|---|---|
| Qualcomm Adreno | Binning / GMEM | GMEMと呼ぶオンチップメモリを分割して使う。描画内容によってIMR的動作へ切り替わるモードを持つ |
| ARM Mali | Tiler / Tile Memory | タイルは16×16ピクセルが基本 |
| Imagination(PowerVR/IMG) | TBDR | 隠面除去(HSR)をハードウェアで行うTBDR。Pixel 10のIMG DXTもこの系譜 |
| Apple GPU | Tile Memory | PowerVR系譜のTBDR。Metalからタイルメモリを明示的に扱える |
1.1.4 本章で扱う4つのテーマ
ここまでで、タイル境界のロード/ストアがコストになることが分かりました。では、そのコストはどうやって削ればいいのでしょうか。本章で扱う4つのテーマは、いずれもこの問いに対する手段です。
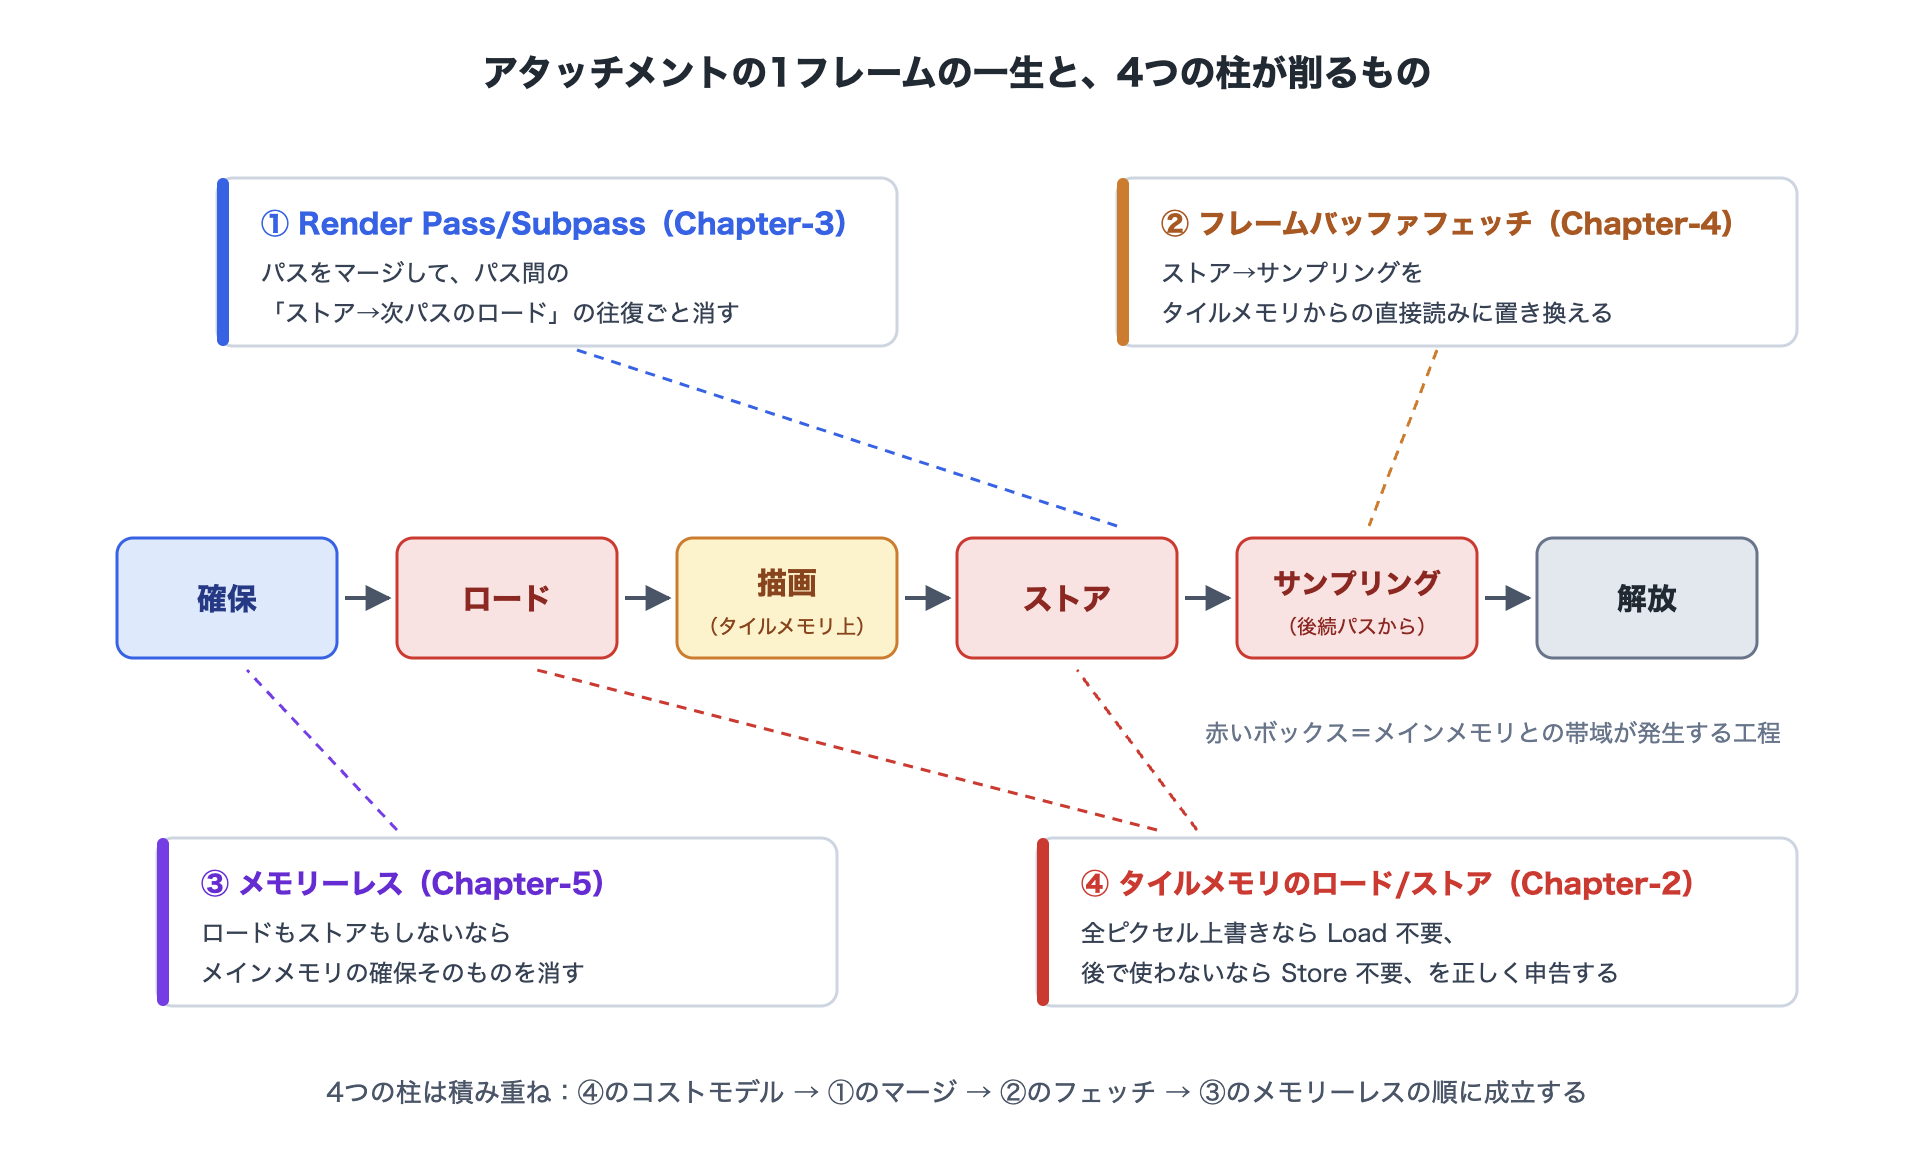
図1.4: アタッチメントの一生と4つのテーマの関係
あるレンダーターゲット(アタッチメント)の1フレームのライフサイクルを考えてみます。
確保 → ロード → 描画 → ストア → (後続パスでテクスチャとして)サンプリング → 解放
このライフサイクルのどこを削るかで、4つのテーマは次のように整理できます。
| テーマ | 削るもの | 考え方 | 節 |
|---|---|---|---|
| ロード/ストア | 不要なロードと不要なストア | 「全ピクセル上書きするならロード不要」「後で使わないならストア不要」を明示する | 「タイルメモリのロード/ストア」 |
| Render Pass/Subpass | パスとパスの間のストア→ロード往復 | 複数のパスを1つのRender Passに統合(マージ)し、中間結果をタイルメモリに留める | 「Render Pass / Subpass」 |
| フレームバッファフェッチ | ストア→サンプリングの往復 | 前のサブパスの結果をタイルメモリから直接読む | 「フレームバッファフェッチ」 |
| メモリーレス | メインメモリの確保そのもの | ロードもストアもしないなら、メインメモリ上の実体は不要 | 「メモリーレス」 |
この4つは独立したテクニックではありません。パスがマージされて初めてフレームバッファフェッチが使え、ロードもストアも消えて初めてメモリーレスが成立します。本章の節構成も、コストモデル(ロード/ストア)→ 仕組み(Subpass)→ 活用(フェッチ)→ 仕上げ(メモリーレス)というこの依存関係に沿っています。また、Render Graphはパスごとのリソース利用情報(何を読み、何に書くか)を集めてからレンダリングの実行計画を立てるシステムです。そのため、パスのマージ、ロード/ストアアクションの決定、メモリーレス化といった最適化を自動的に行えます。本章で解説するのは、これらの最適化が働くように、リソースの使い方を正しくRender Graphに伝える方法だと言えます。
1.1.5 検証ツールの使い方
本章では、パイプラインの状態をツールで確認してから計測する、という流れを繰り返します。使うのは主に次の3つです。
1.1.6 Frame Debugger
UnityのFrame Debugger(Window > Analysis > Frame Debugger)は、パスの構造を確認する基本ツールです。本章で特に見るのはイベント名の(RP n:m)表記です。RP 4:0、RP 4:1のように、同じRender Pass番号(n)にサブパス番号(m)が連番で並んでいれば、それらのパスは1つのNative Render Passにマージされています。なお、パスのマージ(Native Render Pass)が機能するのはVulkan/Metalなどの環境です。エディタのグラフィックスAPIがD3D等になっているとマージを観察できないため、エディタで確認する場合はGraphics APIをVulkanに変更するか、実機ビルドに対してFrame Debuggerをアタッチしてください。
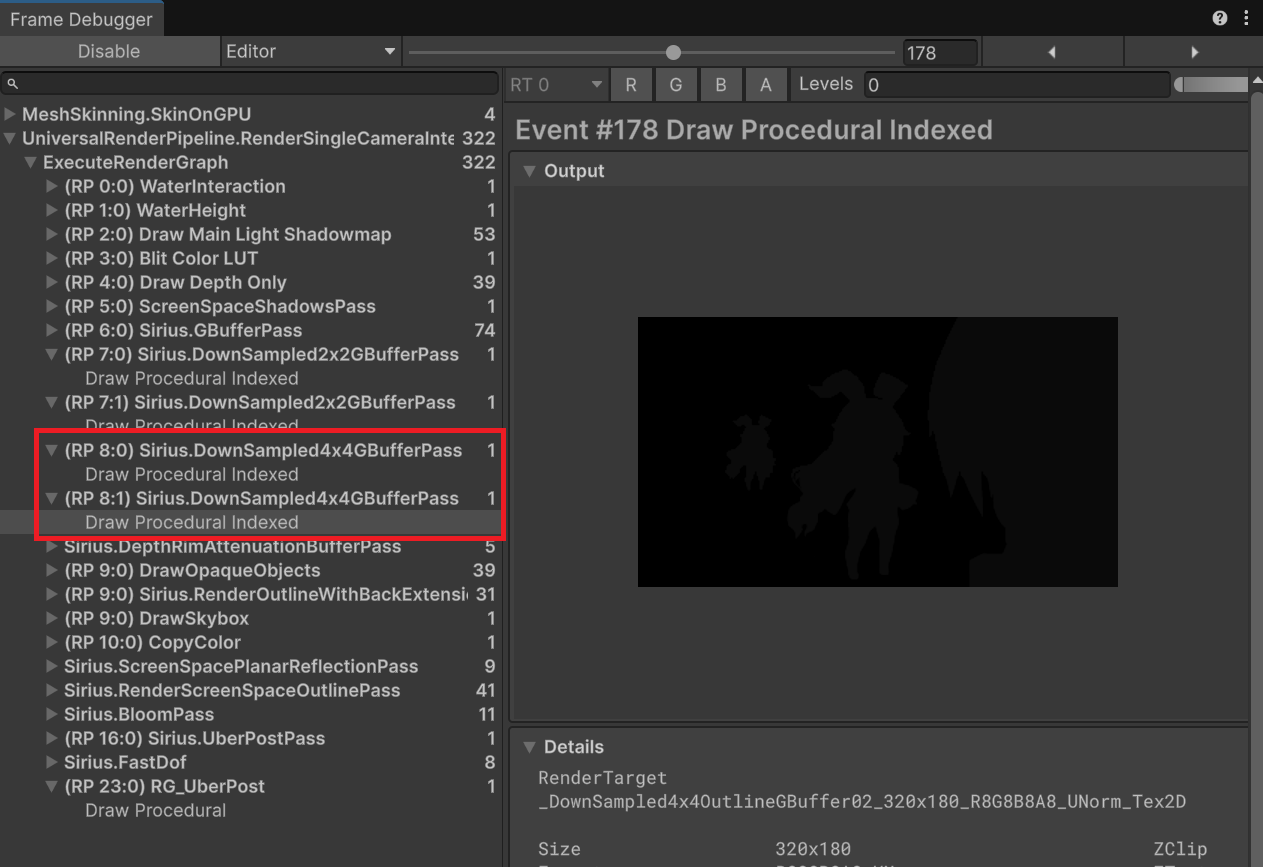
図1.5: Frame Debuggerでのマージ状態
1.1.7 Render Graph Viewer
Render Graph Viewer(Window > Analysis > Render Graph Viewer)は、Render Graphが構築した実行計画そのものを可視化するツールです。
- パスの一覧と、各パスがアクセスするリソースのタイムライン(どのリソースがいつ生成され、いつ破棄されるか)
- アタッチメントごとのLoad Action / Store Action、そしてMemorylessの状態の表示。本章ではこの表示を使って最適化の結果を確認していきます
- パスがマージされているかどうかの表示
- なぜマージされなかったのか(Pass Break Reasoning)の表示
4つ目のPass Break Reasoningは、「マージされるはずのパスがマージされない」ときに最初に確認する情報です。「Render Pass / Subpass」の節以降で繰り返し使います。
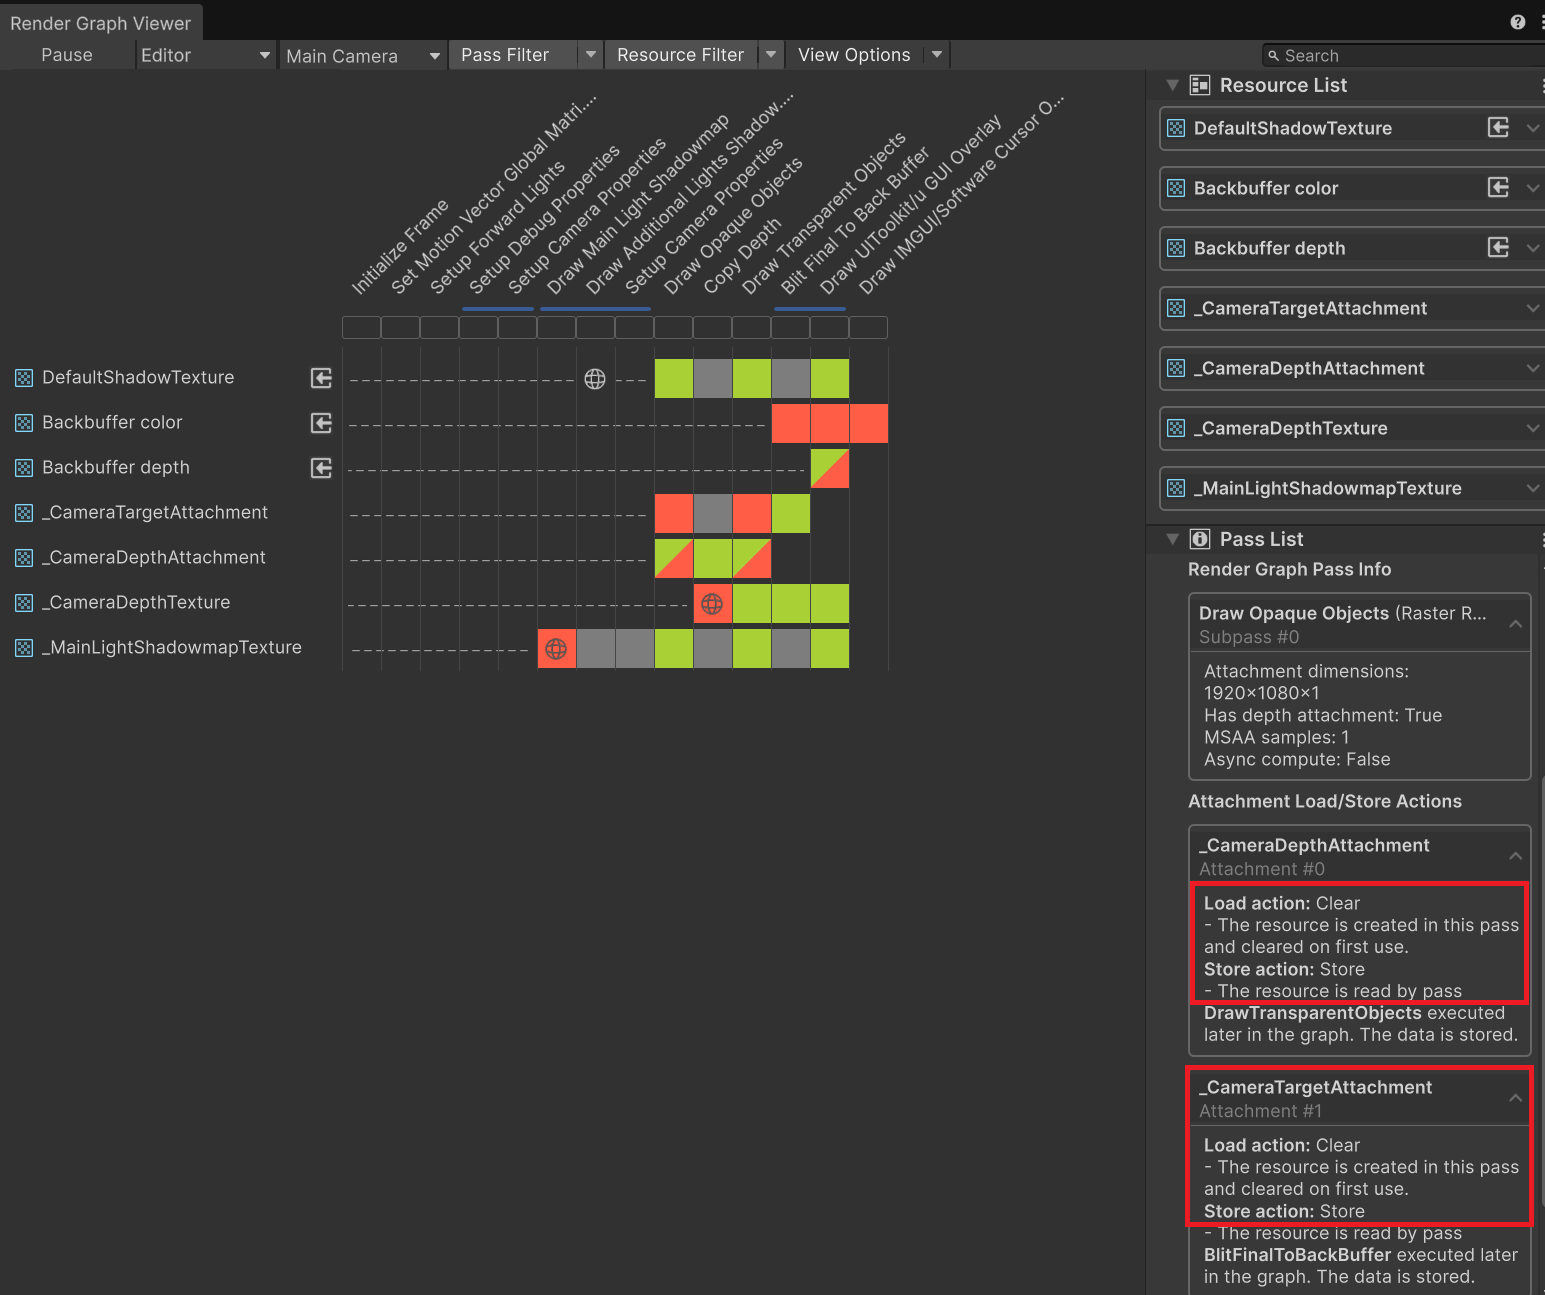
図1.6: Render Graph Viewerでのマージ状態とロード/ストアアクションの確認
1.1.8 RenderDoc
RenderDocでVulkanのキャプチャを取ると、各Render Passのアタッチメントに指定されたloadOp/storeOpをAPIレベルで確認できます。Render Graph Viewerの表示をもう一段掘りたいときや、Unityの表示とドライバに渡っている値を突き合わせたいときに使います。
1.2 タイルメモリのロード/ストア
この節では、本章全体の土台となるロード/ストアアクションについて解説します。
1.2.1 ロード/ストアアクションとは
TBRのGPUはタイルの描画開始時にレンダーターゲットの既存内容をタイルメモリへ読み込み(ロード)、描画終了時にタイルメモリの内容をメインメモリへ書き出します(ストア)。ただし、ロードとストアは常に必要なわけではありません。グラフィックスAPIには、アタッチメントごとに「開始時にどうするか」「終了時にどうするか」を指定するためのアクションが用意されています。
ロードアクション
| アクション | 動作 | 帯域コスト |
|---|---|---|
| Load | メインメモリの既存内容をタイルメモリへ読み込む | 高い(解像度×フォーマット分の読み込み) |
| Clear | タイルメモリを指定色でクリアする | ほぼゼロ(タイルメモリ内の操作のみ) |
| DontCare | 何もしない(タイルメモリの初期値は不定) | ゼロ |
ストアアクション
| アクション | 動作 | 帯域コスト |
|---|---|---|
| Store | タイルメモリの内容をメインメモリへ書き出す | 高い(解像度×フォーマット分の書き込み) |
| Resolve | MSAAのサンプルを解決した結果だけを書き出す | 中(解決後の1サンプル分のみ) |
| DontCare | 何も書き出さない(内容は破棄される) | ゼロ |
つまり、帯域を消費するのはLoadとStore(およびResolve)だけです。逆に言えば、Clear/DontCareで開始してDontCareで終了できるアタッチメントは、メインメモリと一切やり取りしません。この状態が後で扱うメモリーレスの前提条件になります。ロード/ストアを最適化するには、各アタッチメントについて次の2点を確認していくことになります。
- 開始時、以前の内容は必要か? 全ピクセルを上書きするパスなら不要(DontCare)です。クリアから始めるならClear、以前の描画結果に重ね描きするときだけLoadになります。
- 終了時、この内容を後で使うか? 後続のパスや次フレームで使うならStore、このRender Pass内で使い終わるならDontCareです。
1.2.2 帯域コストの試算
ロード/ストア1回のコストは単純な掛け算で概算できます。
1回のロード(またはストア)のデータ量 = 横解像度 × 縦解像度 × 1ピクセルのバイト数
1080p(1920×1080)での代表的なフォーマットの値を示します。
| フォーマット | 1ピクセル | 1回のロード/ストア | 60FPS時の帯域 |
|---|---|---|---|
| R8G8B8A8 (RGBA8) | 4バイト | 約7.9MB | 約475MB/s |
| B10G11R11_Float | 4バイト | 約7.9MB | 約475MB/s |
| R16G16B16A16_Float | 8バイト | 約15.9MB | 約950MB/s |
| D24S8 / D32(深度) | 4バイト | 約7.9MB | 約475MB/s |
たとえば「カメラカラー(RGBA8)をストアし、次のパスでロードする」だけで往復約16MB、60FPSなら約950MB/sの帯域を消費します。モバイルSoCの実効帯域が数十GB/sで、しかもCPUと取り合いであることを考えると、無視できる量ではありません。さらに次の点にも注意してください。
- MSAAは倍率がかかります。4xMSAAのカラーバッファをResolveせずにStoreすると、データ量は4倍になります(MSAAとストアの関係は「メモリーレス」の節で扱います)。
- ロードとストアは両方数えます。パスをまたぐたびに「前のパスのStore+次のパスのLoad」が対で発生します。
- ストアした結果を後続パスでサンプリングすれば、(キャッシュに乗らない分は)さらに読み込みが発生します。
開発中のゲームのレンダリングパイプラインについて、1フレームで何MBがタイルメモリとメインメモリの間を往復しているかを一度調べることをおすすめします。Render Graph Viewerで各パスのアタッチメントとアクションを確認して上の表を掛け算するだけで、どのパスから削るべきかの優先順位が見えてきます。
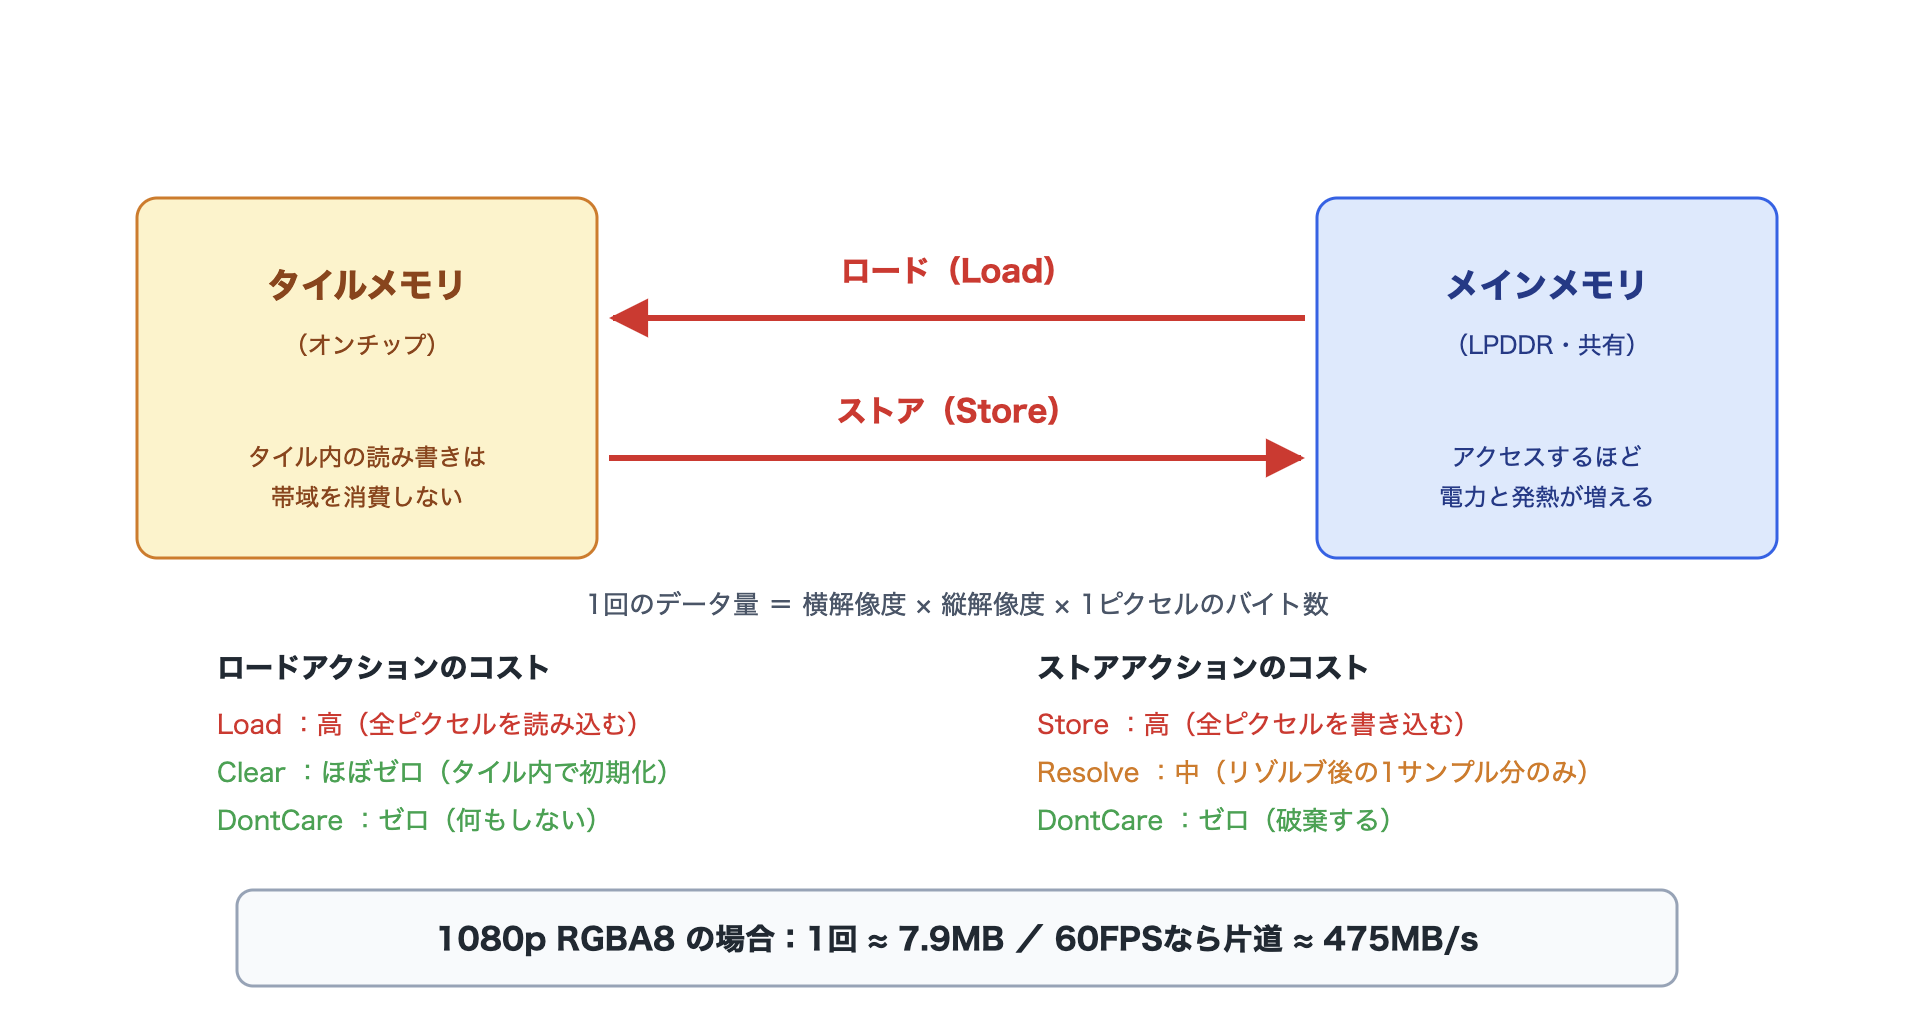
図1.7: タイルメモリ⇔メインメモリのロード/ストアと帯域コスト
1.2.3 AccessFlagsによるリソース利用の申告
では、このロード/ストアアクションをRender Graphではどう指定するのでしょうか。実は、Render Graphではロード/ストアアクションを直接指定しません。パスを追加するときにビルダーへリソースの使い方を申告し、Render Graphがその情報からアクションを決定します。このとき申告に使うのがAccessFlagsです。
リスト1.1: AccessFlagsによるリソース申告
1 2 3 4 5 6 7 8 9 10 | public override void RecordRenderGraph(RenderGraph renderGraph, ContextContainer frameData) { using (var builder = renderGraph.AddRasterRenderPass<PassData>("Example", out var passData)) { // 出力アタッチメントを申告する。 // AccessFlags.WriteAll = このパスは全ピクセルを書き込む(以前の内容は不要) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); ... } } |
AccessFlagsの主な値と意味は次の通りです。
| AccessFlags | 意味 | アクションへの影響 |
|---|---|---|
| Read | 以前の内容を読む | ロードアクションがLoadになる |
| Write | 書き込む(一部のピクセルかもしれない) | 以前の内容の保全が必要になり、ロードがLoadになり得る |
| ReadWrite | 読み書き両方 | ロードがLoadになる |
| Discard | 以前の内容は破棄してよい | ロードをDontCareにできる |
| WriteAll | 全ピクセルを書き込む(Write + Discard) | ロードをDontCareにできる |
ここで特に注意したいのがWriteとWriteAllの違いです。単なるWriteは「一部のピクセルにしか書かないかもしれない」という申告なので、Render Graphは書かれなかったピクセルの内容を保全するためにロードアクションをLoadにせざるを得ません。全画面Blitのように必ず全ピクセルを上書きするパスではWriteAllを指定してください。1080pのRGBA8であれば、この指定の違いだけで約8MB/フレームのロードが発生するかどうかが変わります。一方、ストアアクションを決めるのは、そのリソースが後続のパスで使われるかどうかです。これは開発者が指定するのではなく、Render Graphがグラフ全体を見て判断します。次の項でそのルールを見ていきましょう。
1.2.4 Render Graphがアクションを決定するルール
Render Graphは、記録されたすべてのパスのリソース利用情報からNative Render Passを構築する際に、各アタッチメントのロード/ストアアクションを決定します。判断ルールを整理すると次のようになります。
ロードアクションの決定
| 条件 | 決定されるアクション |
|---|---|
| AccessFlags.WriteAll(またはDiscard)で申告された | DontCare |
| リソースの最初の利用で、クリアが要求されている | Clear |
| 以前の内容への読み込み/部分書き込みがある | Load |
ストアアクションの決定
| 条件 | 決定されるアクション |
|---|---|
| 後続のどのパスからも利用されない | DontCare |
| 後続のパスからUseTexture(テクスチャとして利用)される | Store |
| 後続のパスからSetInputAttachment(入力アタッチメント)としてのみ利用され、同一Native Render Pass内にマージされた | DontCare(タイルメモリ内で受け渡し) |
| グローバルテクスチャとして設定されている | Store(後続の利用がRender Graphから見えないため保守的にストア) |
| MSAAでリゾルブ先がある | Resolve |
このルールから、実務上の指針が2つ導けます。
- グローバルテクスチャ化は最後の手段にする。
SetGlobalTextureAfterPass等でグローバル化されたテクスチャは、Render Graphから利用状況を追跡できなくなるため、常にストアされ、メモリーレス化の対象からも外れます。とりあえずグローバルにしておく、という書き方をすると最適化が効かなくなってしまいます。 UseTextureとSetInputAttachmentは帯域の面ではまったくの別物です。同じ「前のパスの結果を読む」でも、前者はストア→サンプリングの往復が発生し、後者はタイルメモリ内で完結し得ます(「フレームバッファフェッチ」の節で詳しく扱います)。
インポートしたテクスチャの扱い
RTHandleなど、アプリケーション側で管理しているテクスチャをrenderGraph.ImportTextureでインポートした場合、Render Graphはそのテクスチャがグラフの外でどう使われるかを知りません。そのため、デフォルトでは保守的に扱われます(初回利用でもロードされ、最後の利用後もストアされる)。インポート時にImportResourceParamsを渡すことで、この保守的な挙動を緩和できます。
リスト1.2: インポート時のパラメータ設定
1 2 3 4 5 6 | var importParams = new ImportResourceParams { clearOnFirstUse = true, // 初回利用時にクリアする(ロードをClearにできる) discardOnLastUse = true, // 最後の利用後は破棄してよい(ストアをDontCareにできる) }; var handle = renderGraph.ImportTexture(_rtHandle, importParams); |
インポートしたテクスチャが「毎フレーム作り直すので以前の内容は不要」なのであれば、clearOnFirstUse/discardOnLastUseを設定してください。なお、Render Graph管理のテクスチャ(renderGraph.CreateTextureで作成したもの)であれば、これらはすべて自動で判断されます。ライフサイクル管理が本当に必要なテクスチャ以外は、Render Graph管理に任せるのが基本です。
ロード/ストアアクションを読み解く
ルールが分かったところで、実際のフレームを読み解いてみましょう。URPの標準的なフォワードレンダリングのフレームをRender Graph Viewerで見ると、たとえば次のような構造が観察できます。
| パス | アタッチメント | Load | Store |
|---|---|---|---|
| MainLightShadow | シャドウマップ(深度) | Clear | Store |
| DrawOpaqueObjects | カメラカラー | Clear | (後続次第) |
| カメラ深度 | Clear | (後続次第) | |
| DrawTransparentObjects | カメラカラー | (マージ時は継続) | Store |
| FinalBlit | バックバッファ | DontCare | Store |
読み解きのポイントは次の通りです。
- シャドウマップは「描いて、後でサンプリングする」ものなので、Store以外になりようがありません。これは削れないストアです。
- 不透明→半透明が1つのNative Render Passにマージされていれば、その間のカメラカラーのストア/ロードは発生しません。逆に、間に何かが挟まってマージが切れると、そこに往復が生まれます。
- カメラ深度のストアアクションにも注目してください。Depth Textureをオンにするとカメラ深度がStoreされるようになります。シェーダーやポストプロセスが
_CameraDepthTextureを要求していないのに設定だけオンになっている、というのは実プロジェクトでよくある無駄です。
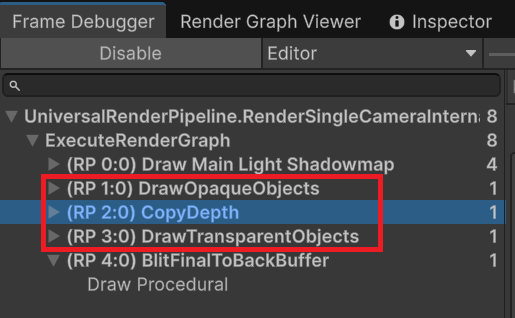
図1.8: Copy DepthによってDraw Opaque ObjectsとDraw Transparent Objectsが分断
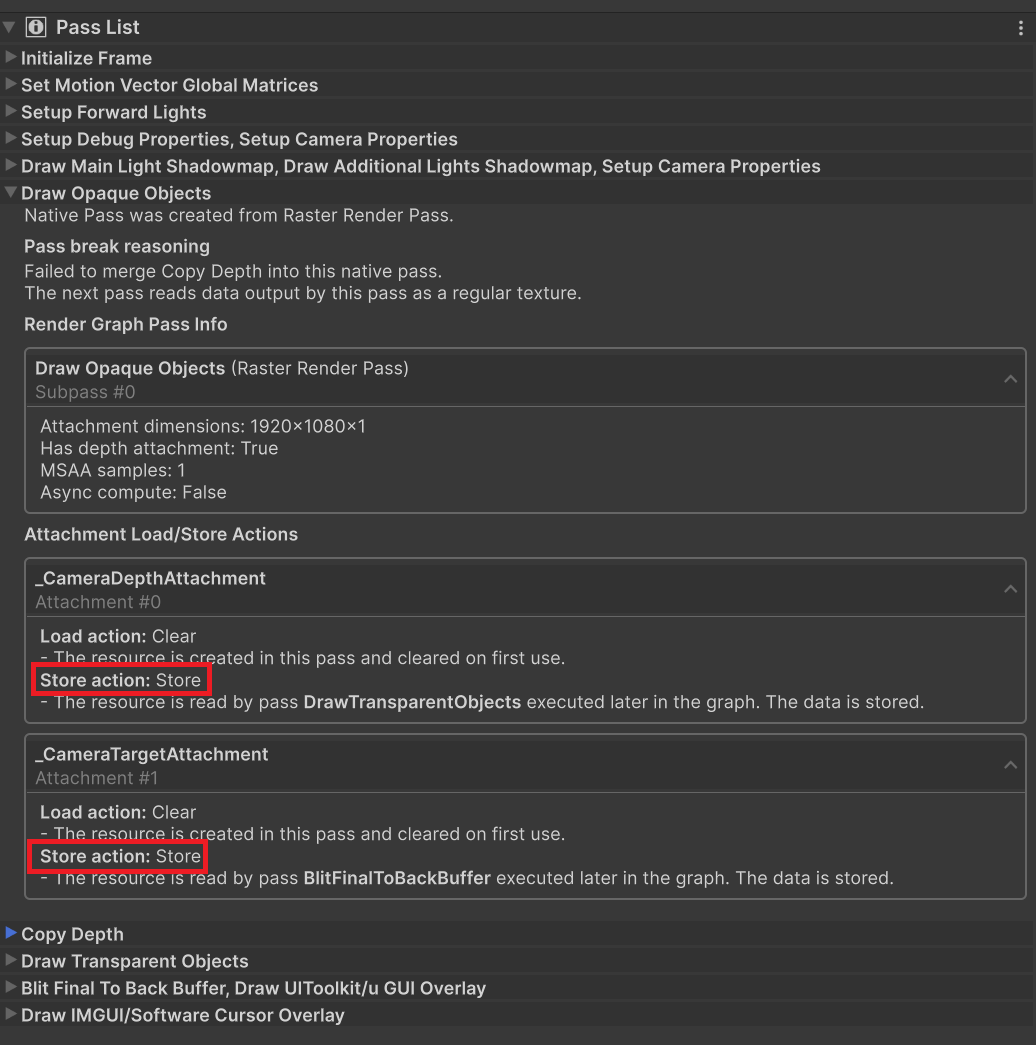
図1.9: 分断されているためDraw Opaque Objects終了時にStore
このように、各アタッチメントのStoreに正当な理由(後続の利用)があるかを1つずつ確認していくのが、タイルメモリ最適化の基本の流れです。
1.2.5 AccessFlagsによる削減例
最後に、AccessFlagsの指定だけでアクションが変わることを実例で確認します。全画面Blitを行うパスで、出力アタッチメントの申告をWriteにした場合とWriteAllにした場合を比較します。
リスト1.3: AccessFlagsのWriteとWriteAllの比較
1 2 3 4 5 | // パターンA: Write(全ピクセル書き込みを申告しない) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.Write); // パターンB: WriteAll(全ピクセル書き込みを申告する) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); |
描画結果はどちらも同じです。しかしRender Graph Viewerで確認すると、パターンAではロードアクションがLoadに、パターンBではDontCareになります。全画面Blitなので、ロードされた内容は全ピクセル上書きされて捨てられます。つまりパターンAのロードは無駄になっています。
1.3 Render Pass / Subpass
ここまでで、パスとパスの間のストア→ロード往復がコストになることが分かりました。この節では、そのコストを消すための仕組みであるRender Pass/Subpassと、Render Graphによるパスマージについて解説します。
1.3.1 リソース依存性とDAG
ゲームの絵を完成させるまでの1フレームの工程をレンダリングパイプライン、それを構成する一つ一つの処理をレンダリングパスと呼びます。各パスは「どのリソースを読み、どのリソースへ書くか」というリソース依存性を持っています。たとえばディファードレンダリングを含む典型的なジオメトリ描画は、次のような依存関係を持ちます。
- 深度プリパスで深度バッファを作成
- G-Bufferに不透明オブジェクトを描画(深度バッファを使用)
- 不透明バッファにディファードライティング(G-Bufferと深度バッファを使用)
- 半透明バッファに半透明オブジェクトを描画(深度バッファを使用)
- 不透明バッファと半透明バッファを合成してフレームバッファに描画
パスをノード、リソース依存性をエッジとして描くと、このパイプラインは有向非巡回グラフ(DAG: Directed Acyclic Graph)になります。4番のパスは2番・3番の出力を使っていないため、依存性さえGPUに伝われば並列実行が可能です。
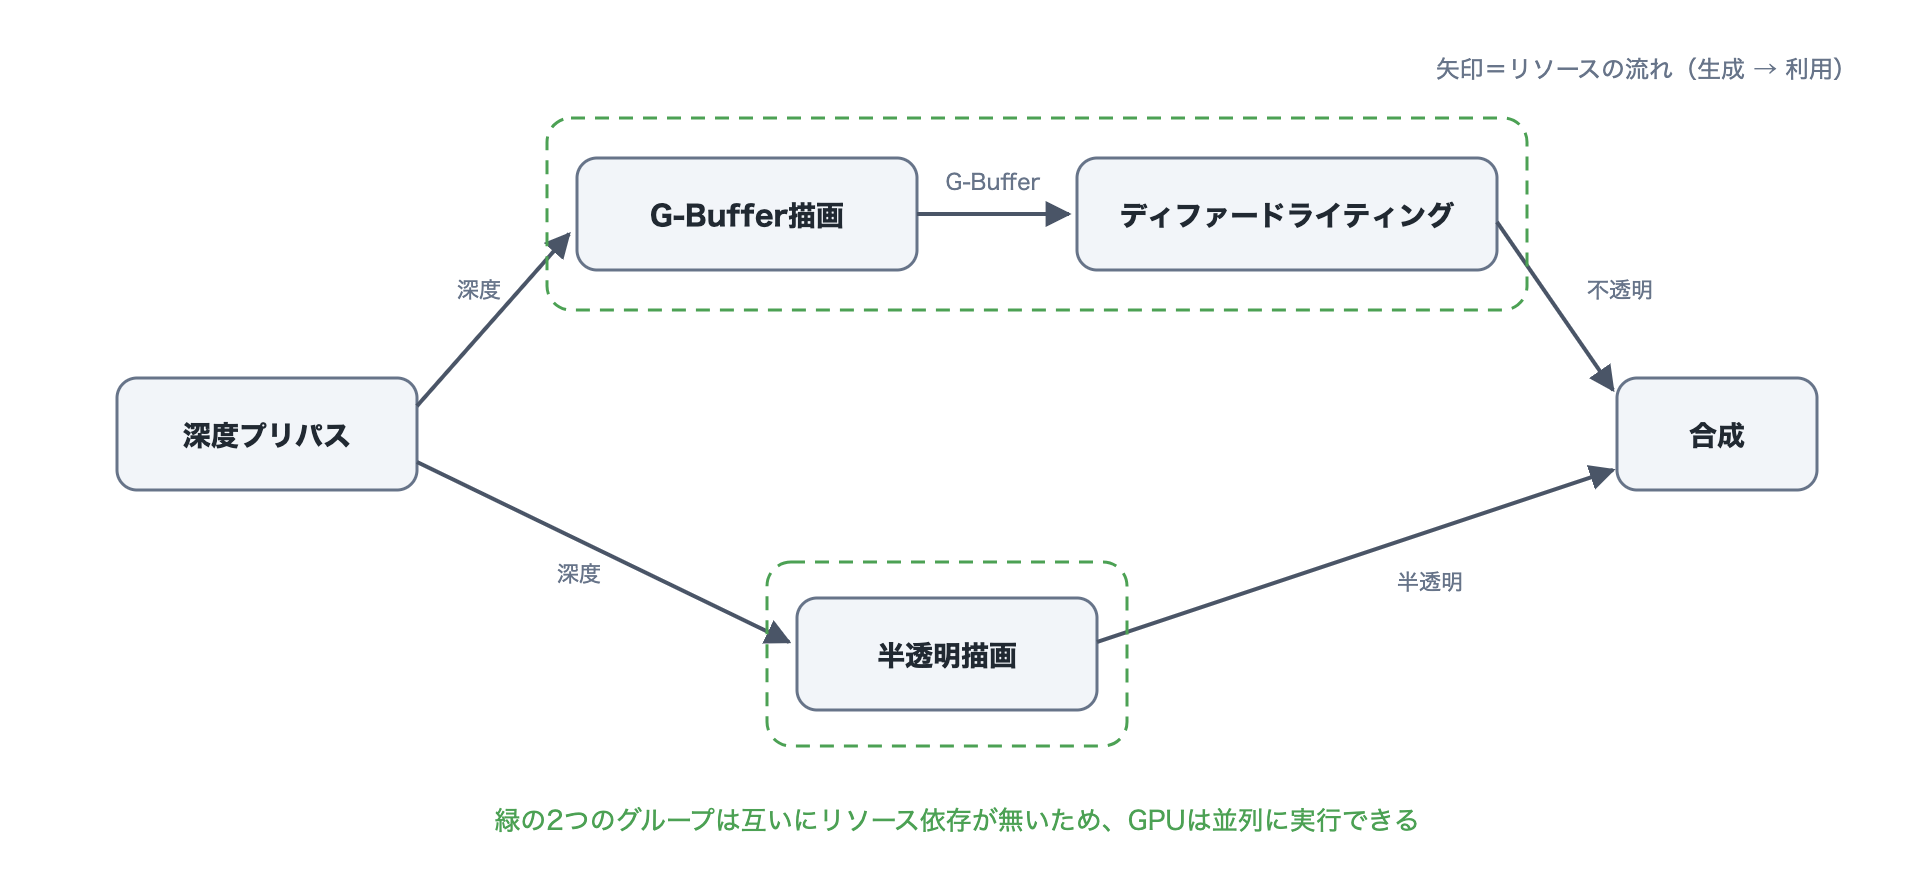
図1.10: レンダリングパスのDAGと並列化
Render Graphという名前の「Graph」はこのDAGを指しています。Render Graphは、パスのリソース依存性を集めてDAGを構築し、それをもとに実行計画を立てるシステムです。
1.3.2 VulkanのRenderPass/Subpass
リソース依存性をGPUに伝える仕組みとして、VulkanにはRenderPass/Subpassという概念があります。Render Graphが最終的に構築するのはこのVulkanのRenderPassなので、少しだけAPIレベルの話をします。VulkanのRenderPassは次の要素で構成されます。
- アタッチメント:RenderPassで使うレンダーターゲットの宣言。各アタッチメントには
loadOp(ロードアクション)とstoreOp(ストアアクション)を指定します。前節「タイルメモリのロード/ストア」で見たアクションの正体はこれです。 - サブパス:RenderPass内の描画の単位。各サブパスは出力アタッチメント(カラー/深度)と入力アタッチメントを宣言します。
- サブパス依存性:サブパス間の実行順序とメモリの依存関係の宣言。
ここで押さえておきたい性質が2つあります。
- ロード/ストアはRenderPassの境界でのみ発生し、サブパス間では発生しません。つまり複数の処理を1つのRenderPassのサブパスとして構成できれば、その間の中間結果はタイルメモリに留まります。
- 入力アタッチメントを使うと、前のサブパスの結果を同一ピクセル位置に限って読めます。これが次節で扱うフレームバッファフェッチのAPI上の姿です。
先ほどのジオメトリ描画をRenderPass/Subpassで表現すると次のようになります。
- ジオメトリ描画(RenderPass)
- 深度プリパス(Subpass) ― 出力: 深度
- G-Buffer描画(Subpass) ― 入力: 深度 / 出力: G-Buffer
- ディファードライティング(Subpass) ― 入力: G-Buffer / 出力: 不透明バッファ
- 半透明描画(Subpass) ― 入力: 深度 / 出力: 半透明バッファ
- 合成(Subpass) ― 入力: 不透明・半透明バッファ / 出力: フレームバッファ
この構成なら、深度・G-Buffer・不透明バッファ・半透明バッファはすべてサブパス間の受け渡しであり、RenderPass境界をまたぐのは最終出力のフレームバッファだけです。ストアが5回発生し得た構成が、ストア1回になります。ちなみにMetalにも同等の仕組みがあります。MetalのRender Passはロード/ストアアクションを持ち、タイルメモリ上のカラーアタッチメントをフラグメント関数から直接読むこと(およびタイルシェーダー)ができます。Vulkanのような明示的なSubpassの宣言はありませんが、Render Graphが行う最適化はMetal上でも同様に機能します。
1.3.3 UnityのNative Render Pass
では、Render GraphはこのVulkanのRenderPass/Subpassをどう扱うのでしょうか。まず押さえておきたいのは、AddRasterRenderPassで追加したパスがそのままサブパスになるわけではないという点です。RecordRenderGraphで追加されるパスは、あくまでRender Graphの論理的なパスです。Render Graphはフレーム内の全パスの記録が終わった後、コンパイル工程で次を行います。
- リソース依存性からDAGを構築し、不要なパスを刈り取る(カリング)
- 隣接するパスのうち、条件を満たすものを1つのNative Render Pass(VulkanのRenderPassに相当)にマージし、マージされた各パスをサブパスにする
- 各アタッチメントのロード/ストアアクションを決定する(前節の「Render Graphがアクションを決定するルール」参照)
- 可能なリソースをメモリーレス化する(「メモリーレス」の節)
つまり開発者側の仕事は、サブパスを手で組むことではなく、マージ可能な形でパスを設計して、リソースの使い方を正しく申告することです。マージの成否はFrame Debuggerの(RP n:m)表記とRender Graph Viewerで確認していきます。
1.3.4 パスマージの条件
Render Graphがパスをマージする条件を整理します。
- 両方がRaster Render Passである。
AddComputePassやAddUnsafePassはマージされません。Rasterパスの列の間にComputeパスが挟まると、そこでNative Render Passが切れます。 - パスが連続して記録されている。マージはグラフ上で隣接するパス同士で行われます。
- 出力アタッチメントの解像度が一致している。中間バッファの解像度を変える(ダウンサンプリングする)と、その境界ではマージできません。
- MSAAサンプル数が一致している。
- 前のパスの出力を、後のパスがテクスチャとして利用していない。
UseTextureでの利用はストア→サンプリングを要求するためマージを妨げます。SetInputAttachment(入力アタッチメント)としての利用はマージを妨げません。入力アタッチメントとテクスチャは別物です。 - アタッチメントの合計数が上限(8枚)を超えない。マージ後のNative Render Passが使うアタッチメントの総数には上限があります。
- グローバルテクスチャ化など、Render Graphの追跡を外れる利用がない。
条件を1つでも満たさないと、そのパスは単独のNative Render Passになります。マージされなかった理由はRender Graph ViewerのPass Break Reasoningに表示されるので、マージされないときはまずそこを確認してください。
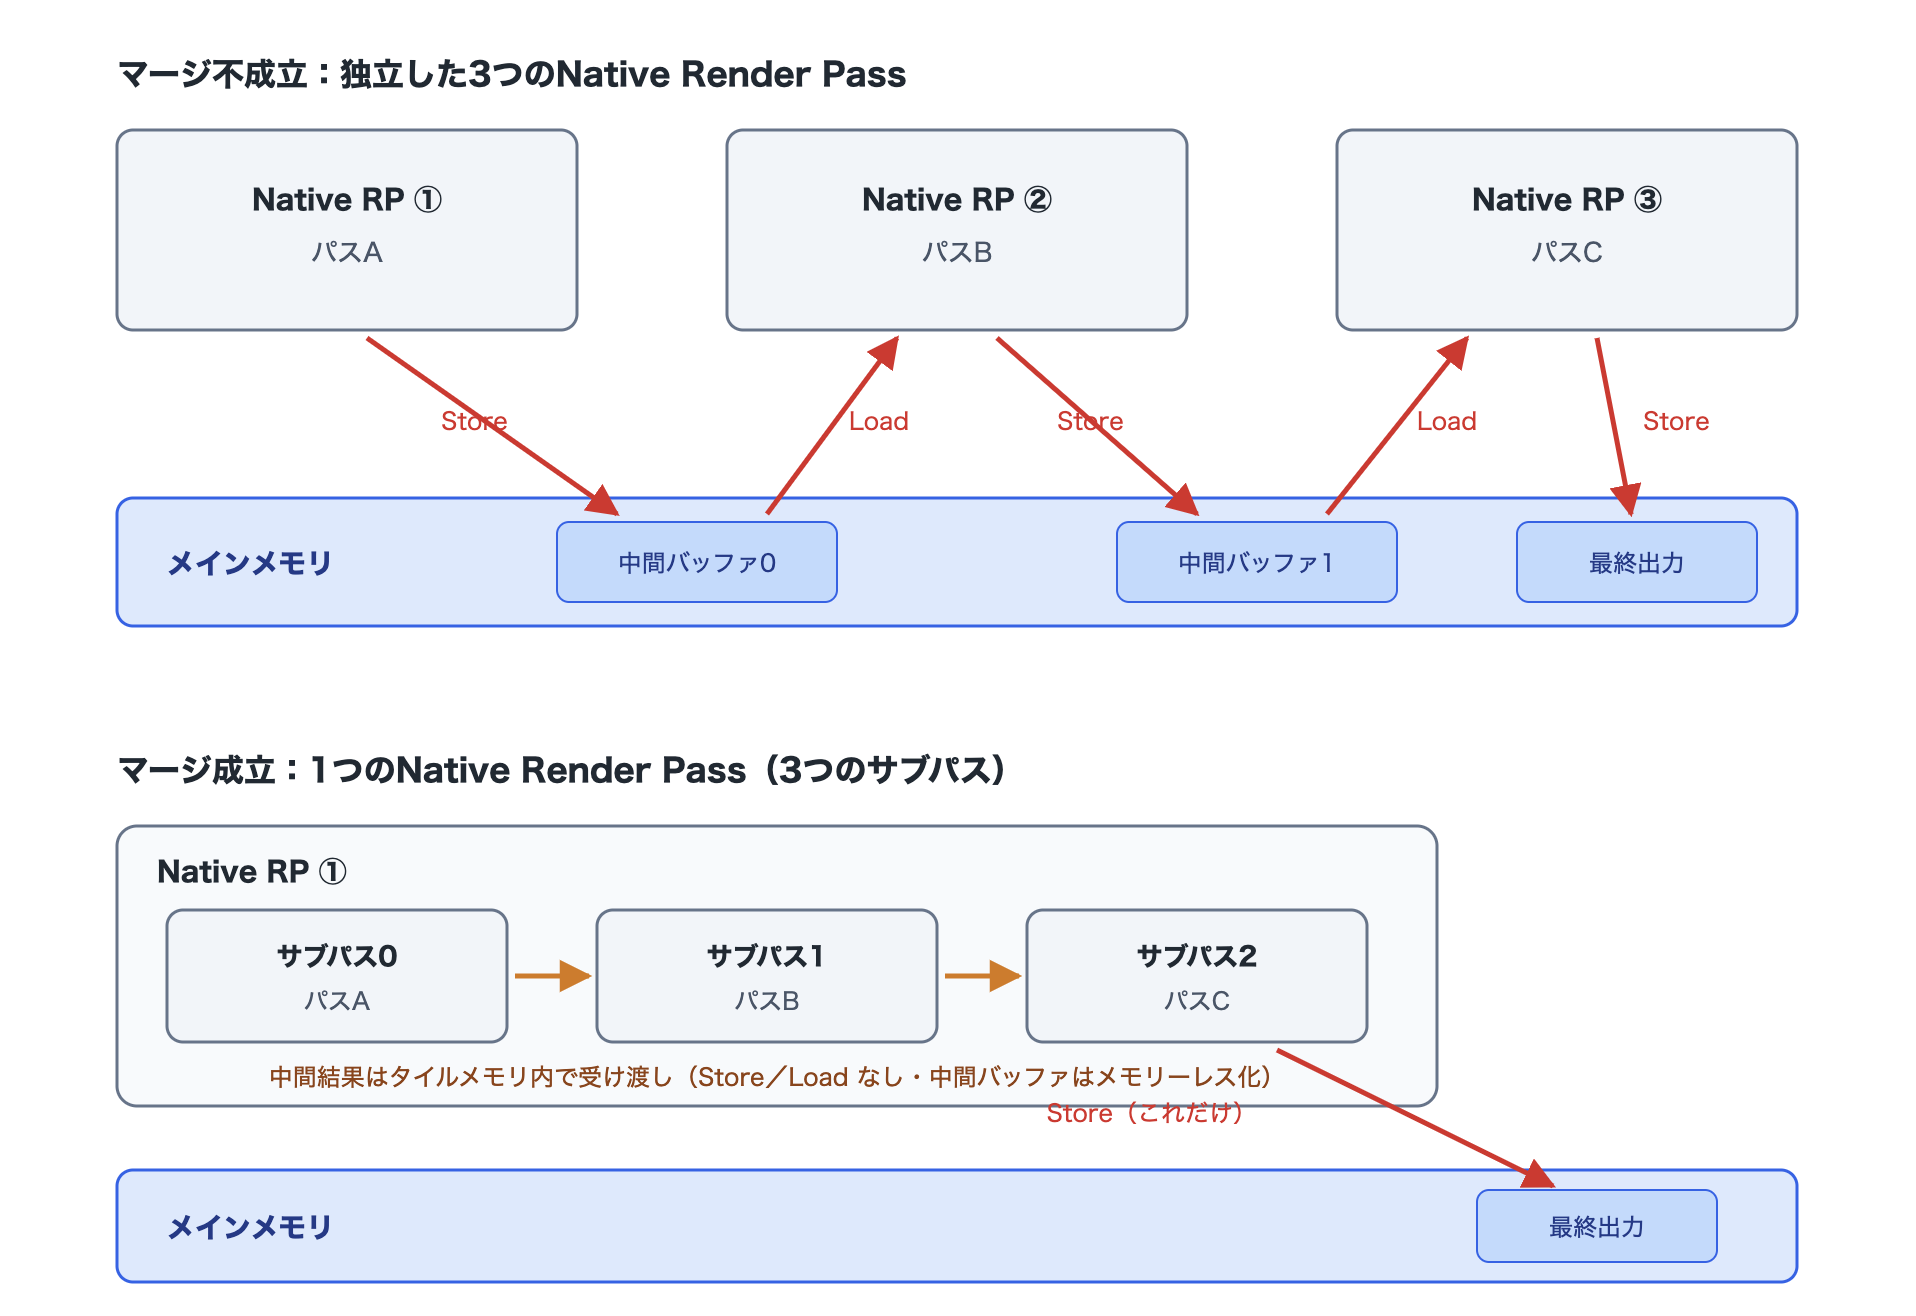
図1.11: マージ前後のNative Render Pass構造の比較
1.4 フレームバッファフェッチ
条件を満たすことでパスを1つのNative Render Passにマージできることが分かりました。この節では、マージされたサブパス間で前のサブパスの結果をタイルメモリから直接読む技術、フレームバッファフェッチ(Frame Buffer Fetch、以下FBF)について解説します。
1.4.1 フレームバッファフェッチとは
G-Bufferを作成してライティングを行うディファードレンダリングを例に考えます。シンプルに実装すると処理は次のようになります。
- G-Bufferの作成(アルベド、法線、マテリアル情報をタイルメモリに書き込む)
- アルベド、法線、マテリアル情報をメインメモリにストアする
- ストアされたG-Bufferをテクスチャとしてサンプリングしてディファードライティングを行う
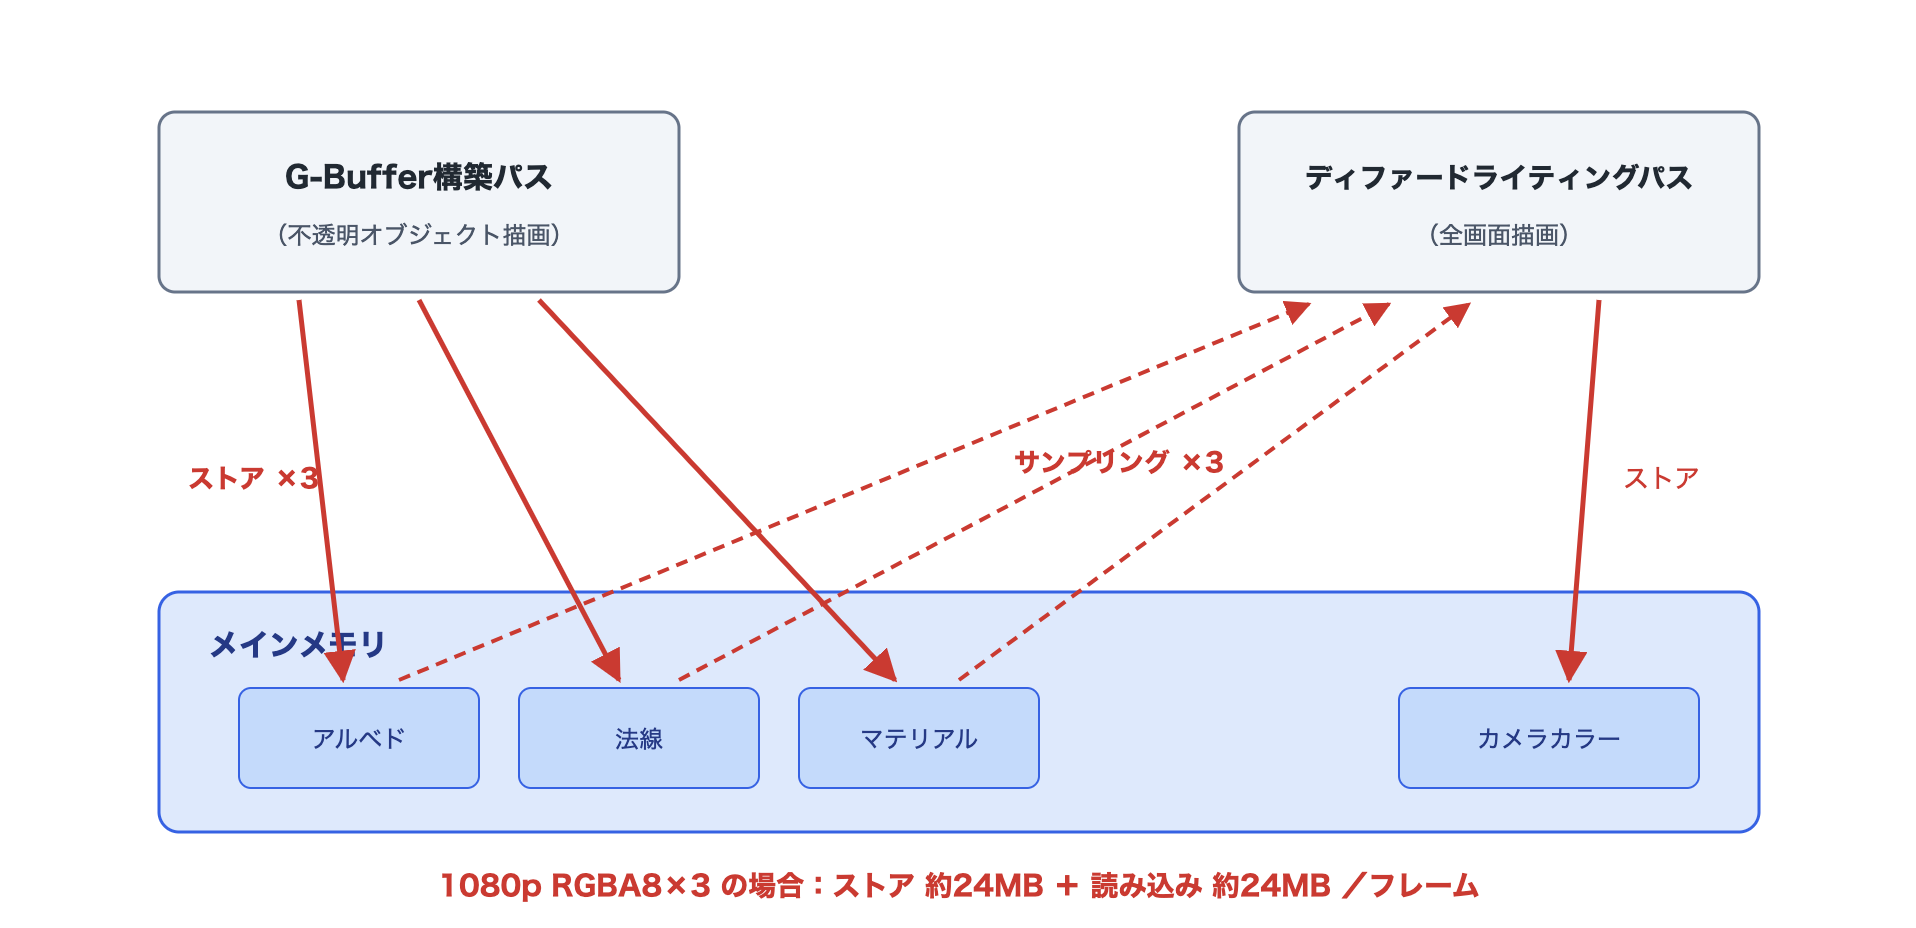
図1.12: シンプルなディファードレンダリングのデータフロー
ここで一つ疑問が生まれます。ライティングのパスが読みたいのは「いま処理しているピクセルの」G-Bufferの値です。その値は、直前のパスが同じタイルのタイルメモリに書き込んだばかりです。メインメモリを往復せずに、タイルメモリから直接読むことはできないのでしょうか。それを可能にするのがFBFです。FBFを使うと処理は次のようになります。
- G-Bufferの作成(タイルメモリに書き込む)
- タイルメモリからG-Bufferを直接読んでディファードライティングを行う
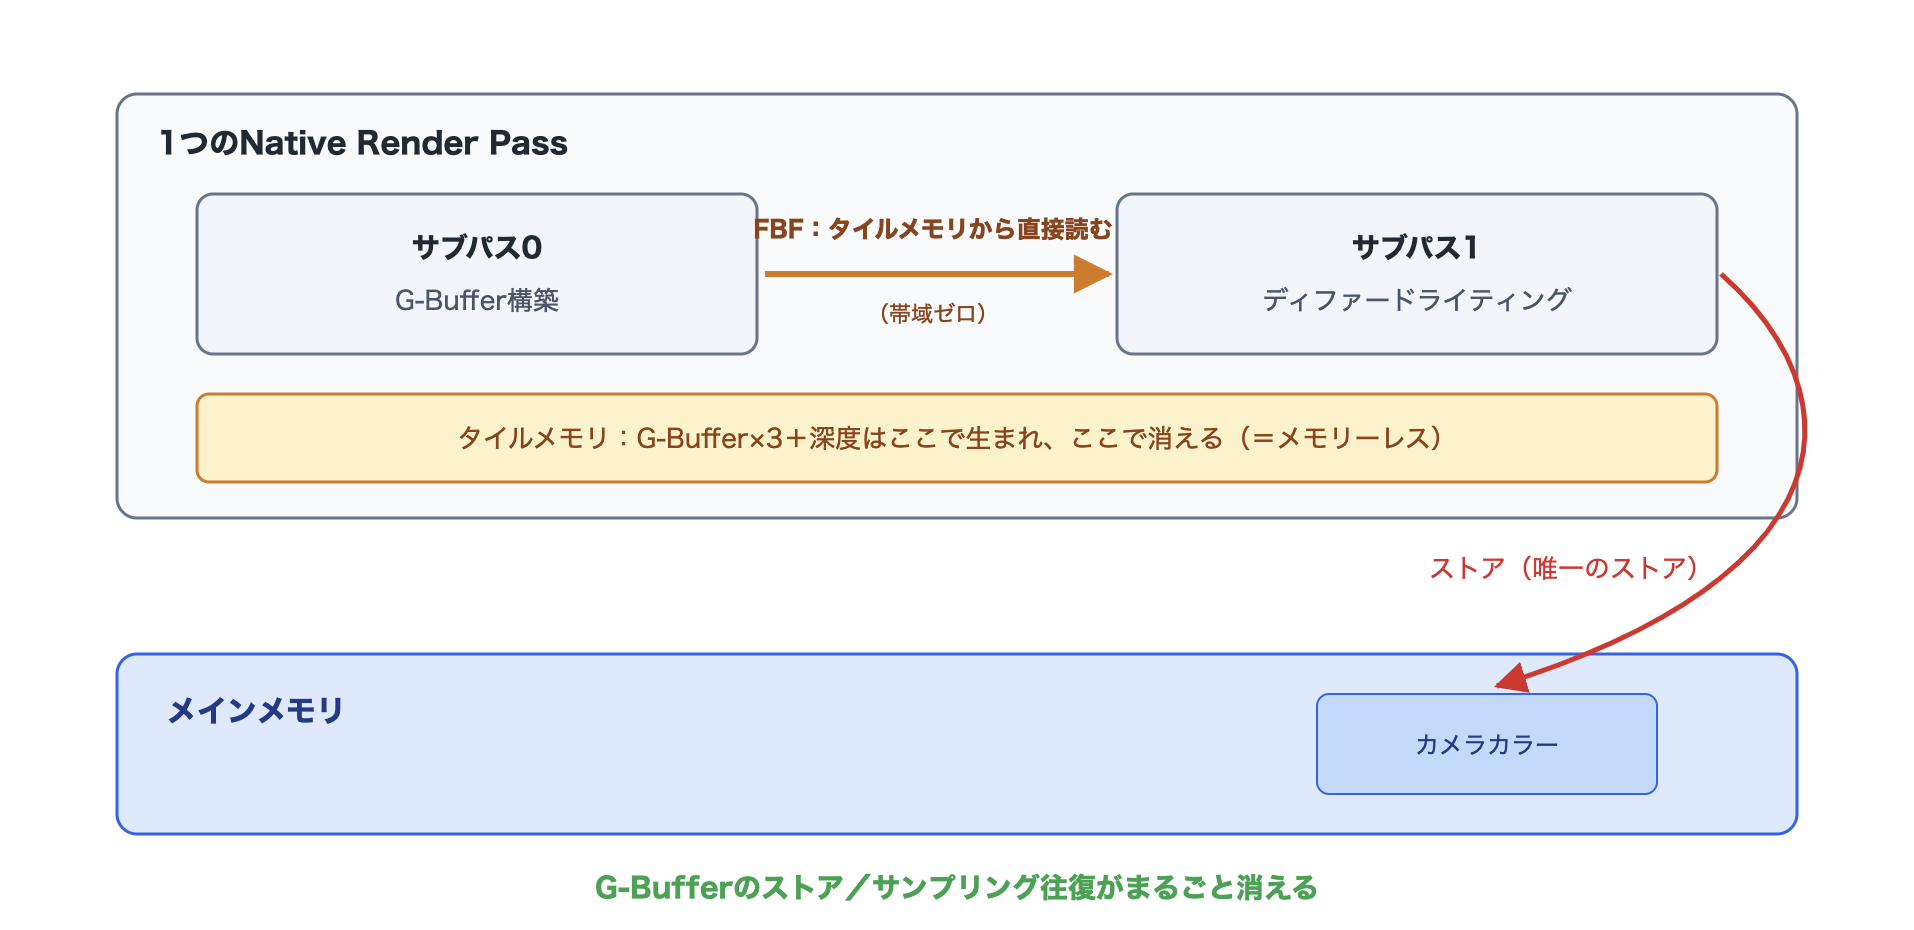
図1.13: フレームバッファフェッチを使ったディファードレンダリングのデータフロー
G-Buffer3枚分のストアと、それをサンプリングするための読み込みがなくなります。1080pのRGBA8×3枚なら、ストアだけで約24MB/フレーム、60FPSで約1.4GB/sの帯域削減です。APIレベルでは、FBFは前節「VulkanのRenderPass/Subpass」で触れたVulkanの入力アタッチメント(Metalではカラーアタッチメントの直接読み取り)として実現されます。したがってFBFが使えるのは同一Render Pass内のサブパス間だけです。パスがマージされていることがFBFの前提条件になります。
1.4.2 制約の理解
FBFはテクスチャサンプリングの置き換えではありません。次の制約があります。
- 処理中のフラグメントと同じピクセル位置しか読めません。タイルメモリには「いま処理しているタイル」の内容しかないため、オフセットサンプリング(周辺ピクセルの読み取り)は原理的に不可能です。
- フィルタリングやミップマップは使えません。単一の値のロードだけです。
- 入力側と出力側の解像度が一致している必要があります(マージ条件でもあります)。
制約1が効く実例を見てみましょう。「モノクロ/セピア合成の結果に、UVを歪ませるノイズ加工を重ねる」という処理を考えます。ノイズ加工のシェーダーは次のようにUVをずらしてサンプリングします。
リスト1.4: ノイズ加工シェーダー
1 2 3 4 5 | // ノイズを使ってUVをゆがませる float2 distortedUV = input.texcoord + noise * 0.02; // ゆがませたUVでテクスチャをサンプリング。 // ロードする位置がフラグメントの位置と違うためフレームバッファフェッチは使えない。 half4 color = SAMPLE_TEXTURE2D_X(_BlitTexture, sampler_LinearClamp, distortedUV); |
読みたい位置が処理中のフラグメントの位置と異なるため、このパスはFBFを使えません。合成結果をUseTextureで申告する必要があり、合成パスとノイズパスの間でストア→サンプリングの往復が発生します。このため、エフェクトを設計する段階で「このパスは同一ピクセルしか読まないか?」を確認しておくと、FBFが使えるかどうかを早めに判断できます。同一ピクセルで済む処理(トーンマッピング、カラーグレーディング、合成、ディファードライティング)はFBFの候補になり、周辺を読む処理(ブラー、歪み、Bloom)はテクスチャ利用になります。
1.4.3 シェーダーAPIの内部
UnityのシェーダーからFBFを使うには、SRP Coreが提供するマクロを利用します。
リスト1.5: フレームバッファフェッチの使い方
1 2 3 4 5 6 7 8 9 | // 入力アタッチメント0番を宣言する FRAMEBUFFER_INPUT_X_HALF(0); half4 frag(Varyings input) : SV_Target { // 入力アタッチメント0番から、処理中のフラグメント位置の値をロードする half4 color = LOAD_FRAMEBUFFER_X_INPUT(0, input.positionCS.xy); ... } |
マクロには精度と用途に応じたバリエーションがあります。
| 宣言マクロ | ロードマクロ | 用途 |
|---|---|---|
| FRAMEBUFFER_INPUT_HALF(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | half精度のカラー |
| FRAMEBUFFER_INPUT_FLOAT(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | float精度 |
| FRAMEBUFFER_INPUT_X_HALF(n) | LOAD_FRAMEBUFFER_X_INPUT(n, pos) | XR(シングルパスインスタンシング)対応版 |
_X付きのバリエーションはTEXTURE2D_X系マクロと同じく、XRのレンダーターゲット配列に対応したものです。XR対応の可能性があるプロジェクトでは_X付きで統一しておくと安全です。このマクロがプラットフォームごとに何に展開されるかを知っておくと、挙動やfallbackを理解しやすくなります。
| プラットフォーム | 展開先 | 実体 |
|---|---|---|
| Vulkan | subpassInput + subpassLoad | Render Passの入力アタッチメント |
| Metal | [[color(n)]]属性によるカラーアタッチメント読み取り | タイルメモリの直接読み取り |
| OpenGL ES | GL_EXT_shader_framebuffer_fetch等の拡張(対応GPUのみ) | 拡張非対応時は下のfallback |
| 非対応環境 | 通常のテクスチャ(_UnityFBInput0等)+ ロード命令 | FBFにならず、通常のテクスチャ読み込みになる |
注意したいのは最後の行です。マクロは非対応環境でも動作はするようにfallbackしますが、その場合は帯域削減の効果がありません。つまり、動作しているからといってFBFが効いているとは限りません。効果が出ているかどうかは、Render Graph Viewerのアクション表示(入力側バッファのストアがDontCareになっているか)と実機の帯域計測で確認してください。
1.4.4 SetInputAttachmentとUseTextureの違い
C#側では、FBFで読みたいリソースをSetInputAttachmentで申告します。
リスト1.6: 入力アタッチメントの申告
1 2 3 4 5 6 7 8 9 | using (var builder = renderGraph.AddRasterRenderPass<PassData>("Lighting", out var passData)) { builder.SetRenderAttachment(cameraColor, 0, AccessFlags.Write); // シェーダーの FRAMEBUFFER_INPUT_X_HALF(0) に対応する builder.SetInputAttachment(gBufferAlbedo, 0); // FRAMEBUFFER_INPUT_X_HALF(1) に対応する builder.SetInputAttachment(gBufferNormal, 1); ... } |
SetInputAttachmentの第2引数のインデックスが、シェーダー側のFRAMEBUFFER_INPUT_X_HALF(n)のnに対応します。ここで、「タイルメモリのロード/ストア」の節から繰り返し登場しているUseTextureとの違いを表で整理しておきます。
| 項目 | UseTexture | SetInputAttachment |
|---|---|---|
| 読める位置 | 任意のUV(オフセット、フィルタリング、ミップ可) | 処理中のフラグメント位置のみ |
| 前のパスとのマージ | 妨げる | 妨げない |
| 前のパスの出力のストア | Storeが強制される | マージ成立時はDontCareにできる |
| 帯域コスト | ストア+サンプリング読み込み | ゼロ(タイルメモリ内で完結) |
| シェーダー側の読み方 | SAMPLE_TEXTURE2D系 | LOAD_FRAMEBUFFER系 |
1.4.5 深度のフェッチ
カラーだけでなく深度もタイルメモリ上にあります。深度をフェッチできれば、ソフトパーティクルやデカール、フォグのような「シーンの深度を参照する処理」からも_CameraDepthTextureのストア→サンプリング往復を消せる可能性があります。SRP Coreには深度用の入力アタッチメントを扱うためのマクロ群が用意されていますが、深度アタッチメントの入力化はプラットフォームとURPのバージョンによる制約が出やすい領域です。検証結果が出るまでの本章の推奨は、確実に動作する次の代替案です。代替案として、深度をカラーアタッチメントに書いてフェッチする方法があります。G-Buffer構築のサブパスで、線形化した深度値をカラーアタッチメントの1チャンネル(R16_Float等)に書き込み、後続サブパスではそれをFBFで読みます。アタッチメントが1枚増えますが、メモリーレス化されれば実メモリのコストはゼロであり、深度テクスチャのストア往復は確実になくせます。
1.4.6 プラットフォーム差と落とし穴
最後に、FBFを使う際に確認しておきたいプラットフォーム差をまとめます。
| 環境 | FBFの利用 | 備考 |
|---|---|---|
| Vulkan (Adreno) | ○ 入力アタッチメント | 広くサポート。ドライバ品質は端末による |
| Vulkan (Mali) | ○ 入力アタッチメント | 広くサポート |
| Vulkan (IMG / Pixel 10) | ○ 入力アタッチメント | TBDR系。ドライバ固有の挙動差に注意(最終節の「GPUベンダー差」) |
| Metal (Apple) | ○ カラーアタッチメント読み取り | 安定して機能する |
| OpenGL ES | △ 拡張依存 | GL_EXT_shader_framebuffer_fetch対応GPUのみ。非対応はfallback |
| エディタ (D3D等) | × fallback動作 | 通常テクスチャとして動く。動作確認はできるが効果測定はできない |
特に注意したい点は次の3つです。
- エディタでは効果が見えません。fallbackで正しく描画されてしまうため、実機で計測して初めて差が分かることを前提にワークフローを組んでください。
- MSAA併用時はマージ条件(サンプル数一致)に引っかかりやすくなります。MSAAが有効なカメラカラーと、MSAAなしで作った中間バッファはマージできません。中間バッファのTextureDescは
GetTextureDesc(cameraColor)のように元のDescから複製し、サンプル数を引き継ぐようにしてください。 - 1つのサブパスで読める入力アタッチメント数には上限があります。アタッチメント合計8枚の制約(前節の「パスマージの条件」)は入力側も含めた話です。G-Bufferを設計するときはチャンネルパッキングで枚数を節約してください。
1.5 メモリーレス
ここまでで、中間バッファのロードもストアも消せるようになりました。ここで一つ考えてみたいことがあります。ロードもストアもしないバッファに、メインメモリ上の実体は必要なのでしょうか。
1.5.1 メモリーレスとは
実は必要ありません。タイルメモリ上でだけ使われて、タイルメモリ上で破棄されるリソースには、メインメモリの確保そのものが要りません。この状態をメモリーレスと呼びます。Vulkan/Metalには、リソースを「タイルメモリ(オンチップメモリ)にのみ存在させ、メインメモリのバッキングストアを持たない」ものとして作成するモードがあります(VulkanではLAZILY_ALLOCATEDメモリ、MetalではMTLStorageMode.memoryless)。メモリーレスが指定されたリソースは次の性質を持ちます。
- メインメモリを消費しない(アプリのメモリフットプリントが減る)
- ロードアクションにLoadを、ストアアクションにStoreを指定できない(読み書きする実体がないため)
つまりメモリーレスは、ここまでの節でロード/ストアを消した結果として成立するものです。ロード/ストアが消えていればメモリーレス化でき、メモリーレス化できない場合は、どこかにまだロードかストアが残っています。
1.5.2 成立条件
あるリソースがメモリーレス化できる条件を、これまでの言葉で書くと次のようになります。
- ロードアクションがClearまたはDontCareである(以前の内容をメインメモリから読まない。「AccessFlagsによるリソース利用の申告」の項で見たWriteAll/Discard申告、または初回利用のClear)
- ストアアクションがDontCareである(後続のパスからテクスチャとして利用されず、次フレームにも持ち越さない。「Render Graphがアクションを決定するルール」の項を参照)
- 利用が1つのNative Render Pass内で完結している(サブパス間の受け渡し、つまり入力アタッチメント/FBFは使ってもよい。「Render Pass / Subpass」の節のマージ、「フレームバッファフェッチ」の節のFBF)
見ての通り、この3条件はここまでの節で解説してきた内容そのものです。
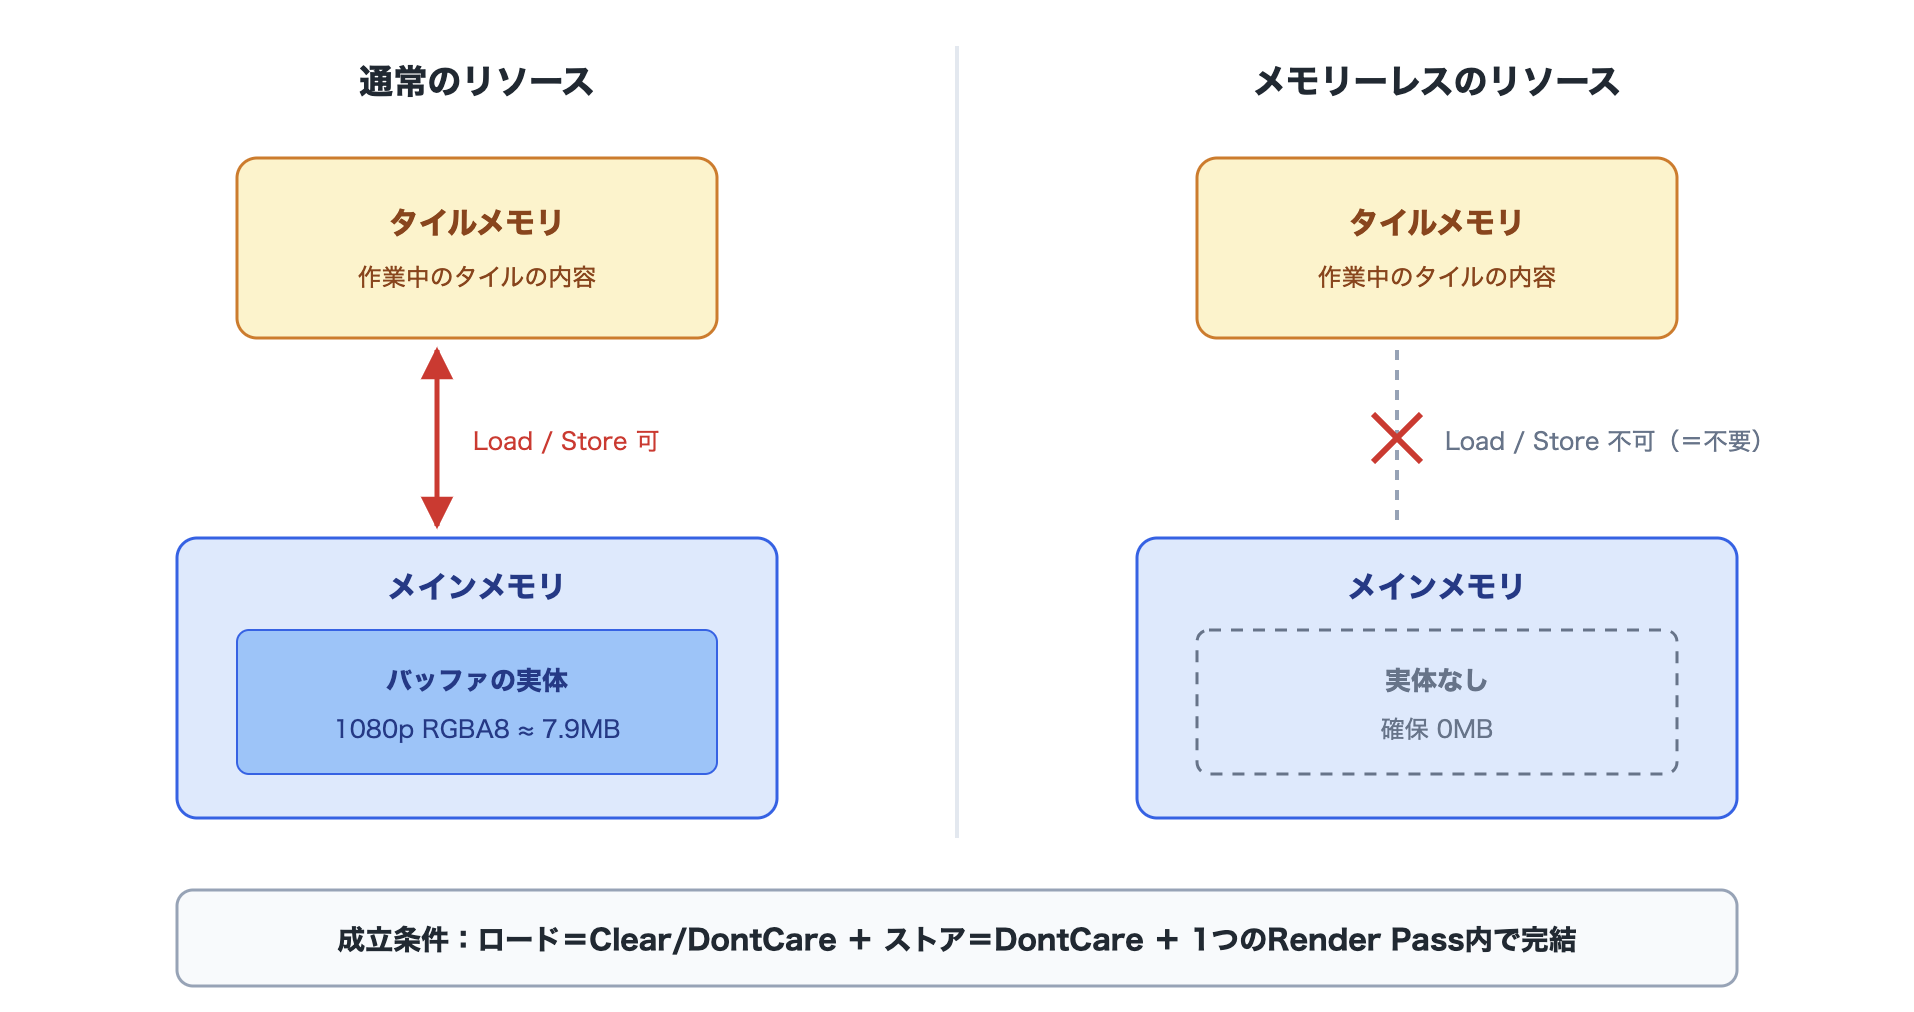
図1.14: メモリーレス化前後のメモリマップ比較
自動メモリーレス化と明示指定
UnityのRender Graphでは、メモリーレスは2つの経路で実現されます。
自動メモリーレス化
Render Graph管理のテクスチャ(renderGraph.CreateTextureで作成)が「成立条件」の項の3条件を満たす場合、Render Graphが自動的にメモリーレス化します。開発者は何も指定する必要がありません。メモリーレス化されているかどうかはRender Graph ViewerのResource Listで確認することができます。
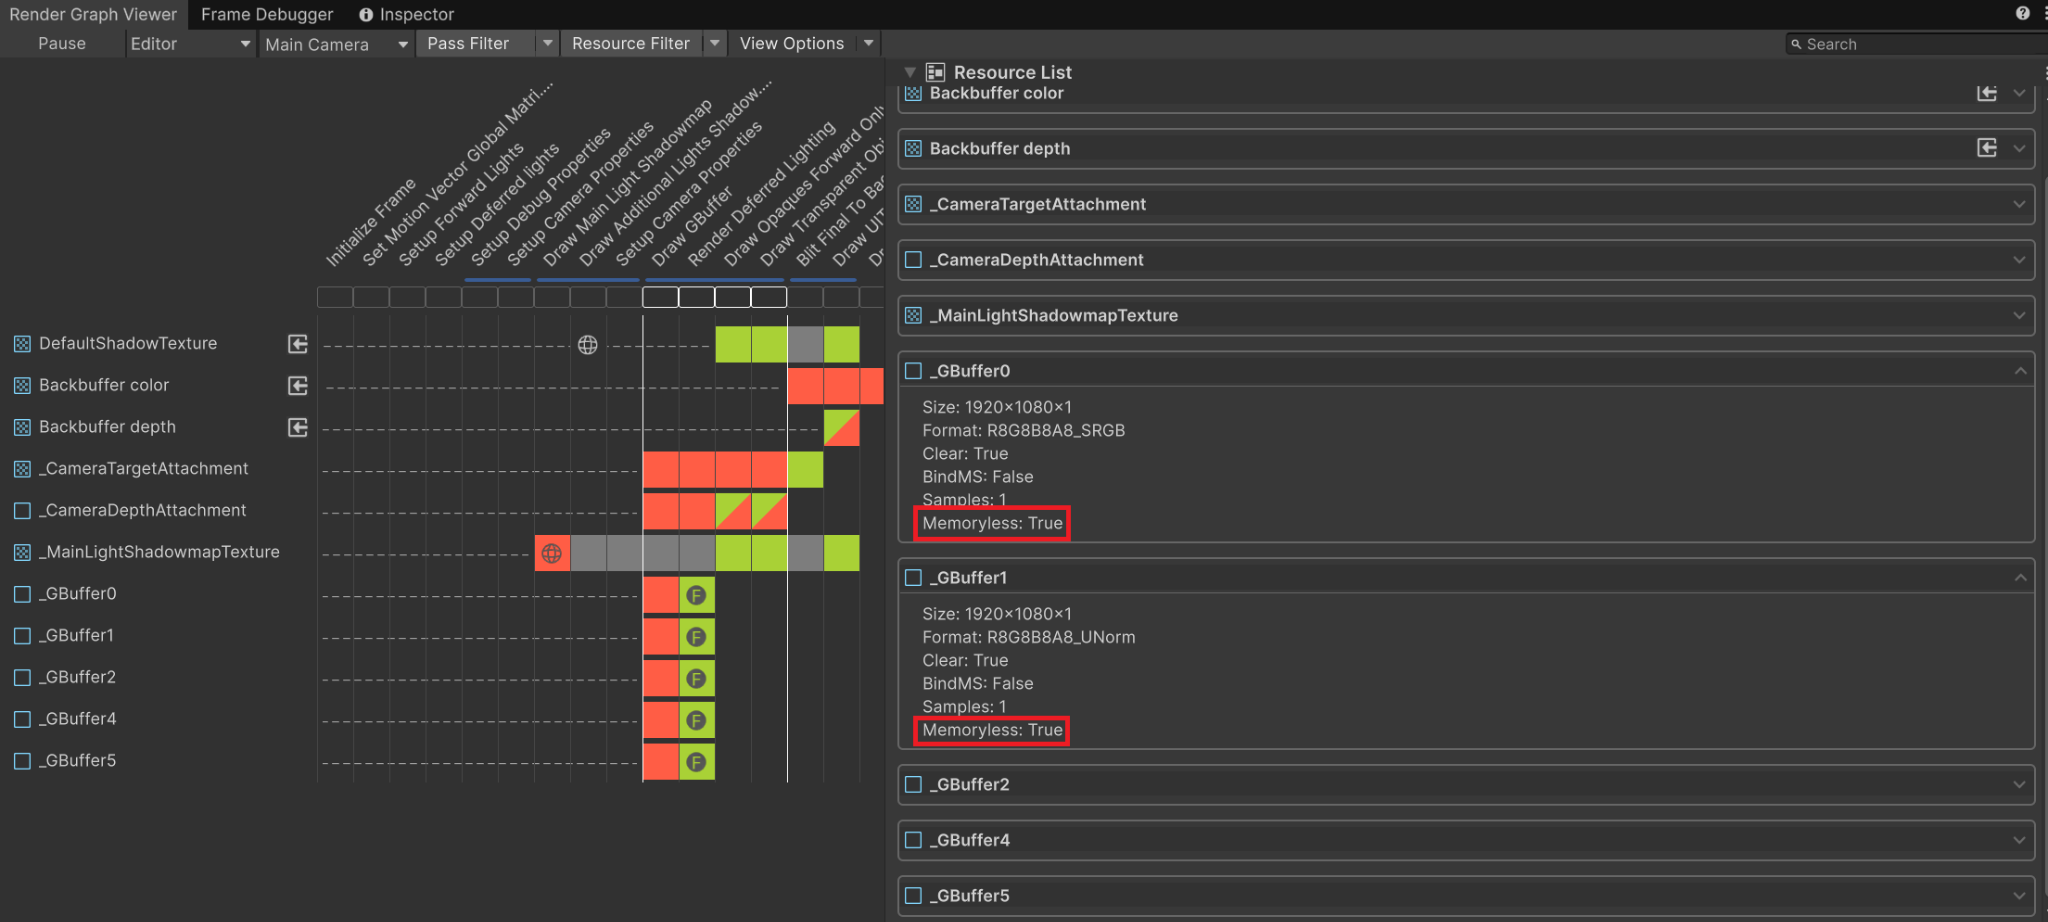
図1.15: Render Graph ViewerでのMemoryless表示
明示指定
TextureDescのmemorylessフィールドで明示的に指定することもできます。
リスト1.7: メモリーレスの明示指定
1 2 3 4 | var desc = renderGraph.GetTextureDesc(universalResourceData.cameraColor); desc.memoryless = RenderTextureMemoryless.Color; // メモリーレスを指定 desc.name = "Intermediate Texture"; var handle = renderGraph.CreateTexture(desc); |
明示指定には、設計意図をコードに残せるという利点があります。メモリーレスを指定したリソースをうっかり後続パスでUseTextureしようとすると、その時点で構成の矛盾が顕在化します。自動に任せていると、リファクタリングでどこかにUseTextureが紛れ込んだ場合に、メモリーレスが外れたこと(=メモリ使用量と帯域が増えたこと)に気づけません。このリソースはタイルメモリ内で完結させる、という設計意図があるなら、明示指定でコードに残しておくのがおすすめです。
1.5.3 削減量の定量化
メモリーレス化の削減量は計算で求められます。1080pでの代表例を示します。
| リソース構成 | 計算 | 削減量 |
|---|---|---|
| RGBA8 中間バッファ1枚 | 1920×1080×4B | 約7.9MB |
| RGBA16F 中間バッファ1枚 | 1920×1080×8B | 約15.9MB |
| G-Buffer 3枚(RGBA8)+深度 | 7.9MB×4 | 約31.7MB |
| 4xMSAA RGBA8 カラー | 1920×1080×4B×4 | 約31.7MB |
| 4xMSAA 深度(D32) | 1920×1080×4B×4 | 約31.7MB |
表の通り、削減量が大きいのはMSAAとG-Bufferです。特に4xMSAAはカラーと深度を合わせて60MB超になるため、これが消えるかどうかはアプリ全体のメモリバジェットにかなり効いてきます。なお、メモリーレスによる削減は「メモリ使用量」であり、帯域の削減はここまでの節で行ってきたロード/ストア削減によるものです。両者は別の指標であることに注意してください(メモリーレスはロード/ストア削減の結果として成立するので、実務上はセットで達成されます)。
1.5.4 MSAAレンダーターゲットのメモリーレス化
メモリーレスの効果が最も大きいのがMSAAです。仕組みから見ていきましょう。4xMSAAでは、タイルメモリ上に1ピクセルあたり4サンプルのカラーと深度が保持されます。しかし最終的に画面に表示するのは、4サンプルを平均(リゾルブ)した1サンプル分だけです。ここでストアアクションの選択肢が効いてきます。
- Storeを選ぶと、4サンプル分のデータがそのままメインメモリに書き出されます(帯域4倍、メモリ4倍)。
- Resolveを選ぶと、タイルメモリ上でリゾルブが行われ、リゾルブ後の1サンプル分だけが書き出されます。
TBRのGPUではリゾルブはタイルメモリ上でほぼコストなしに行えます。そしてResolveを選んだ場合、4サンプル分のMSAAバッファ自体はストアされないため、メモリーレスの条件を満たします。つまり正しく構成されたMSAAは、
- MSAAカラーバッファ(4サンプル) → メモリーレス(メインメモリ確保なし、ストアなし)
- リゾルブ先バッファ(1サンプル) → 通常のストア
- MSAA深度バッファ(4サンプル) → メモリーレス+ストアなし(深度を後続で使わない場合)
という構成になります。TBRのGPUでMSAAが(IMRと比べて)低コストだと言われるのはこのためです。URPでは、Universal Render PipelineアセットのMSAA設定を有効にすると、Render Graphがこの構成を自動的に組みます。確認すべきはそれが壊れていないかどうかです。Render Graph ViewerでMSAAカラーバッファのストアアクションがResolveになっているか、Memorylessがyesになっているかを確認してください。壊れる典型例は、MSAAバッファそのものを後続パスがテクスチャとして要求してしまうケース(カスタムパスでの誤った申告、Opaque Textureの構成ミスなど)です。
1.5.5 GPUベンダー差
本章で扱った技術はいずれも標準的なVulkan/Metalの機能の上に成り立っており、主要ベンダーで機能します。そのうえで、ベンダーごとの特性差を把握しておくと計測結果の解釈やトラブル対応がしやすくなります。
| ベンダー | アーキテクチャ特性 | 注意点 |
|---|---|---|
| Qualcomm Adreno | GMEMベースのビニング。描画内容によってダイレクトモード(IMR的動作)に切り替わることがある | ダイレクトモードに切り替わるとタイルメモリ前提の最適化効果が変わる。プロファイラでどちらのモードかを確認する |
| ARM Mali | 16×16タイル基本のTBR | 外部帯域カウンタが充実しており、本章の帯域計測の基準ベンダー |
| Imagination (IMG) | ハードウェア隠面除去(HSR)を持つTBDR。Pixel 10のIMG DXTが該当 | HSRにより不透明オーバードローが元々少なく、最適化の効きどころが他ベンダーと異なる。新しいドライバのため挙動差の検証を推奨 |
| Apple | PowerVR系譜のTBDR。Metalでタイルメモリを明示的に扱える | FBF/メモリーレスが安定して機能する。iOSで効果を確認してからAndroidの検証に進むのも有効 |
1.5.6 おわりに
本章で扱った4つのテーマを、最後にもう一度まとめます。Render Graphを使う場合、開発者がやることは、リソースの使い方を正しく申告することと、Frame DebuggerやRender Graph Viewerで結果を確認することの2つです。地味な作業ですが、その積み重ねが端末の発熱やバッテリー消費の差になって表れます。本章が皆さんのプロジェクトの最適化に役立てば幸いです。
1.5.7 参考文献
- ARM, "Arm GPU Best Practices Developer Guide", https://developer.arm.com/documentation/101897/latest/
- Qualcomm, "Adreno GPU Best Practices", https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Apple, "Metal Best Practices Guide", https://developer.apple.com/library/archive/documentation/3DDrawing/Conceptual/MTLBestPracticesGuide/
- Unity, "Render graph system" (URP Documentation), https://docs.unity3d.com/Manual/urp/render-graph.html
- 『学園アイドルマスター』モバイルでも"ライティングと反射"を描き切る!【CEDEC2024】, https://gamemakers.jp/article/2025_01_29_90729/
- モバイルで爆速なDeferred Renderingを行う方法, CEDiL, https://cedil.cesa.or.jp/cedil_sessions/view/2457
- Unity6からRenderGraphを使いこなそう ― 基本機能編, https://blog.sge-coretech.com/entry/2024/06/04/171757
- Unity6からRenderGraphを使いこなそう!応用実装編1「RenderPassの構築」, https://blog.sge-coretech.com/entry/2024/09/11/105032
- シェーダー最適化入門 第2回「タイルベースレンダリングのGPUとは?」, https://blog.sge-coretech.com/entry/2025/01/27/145242