依課題查詢的索引指南
依症狀列出應先查看的數值,以及探討該症狀的章節。先確認測量的進行方式,之後依容量、記憶體、CPU、GPU 的順序,可由課題查起。
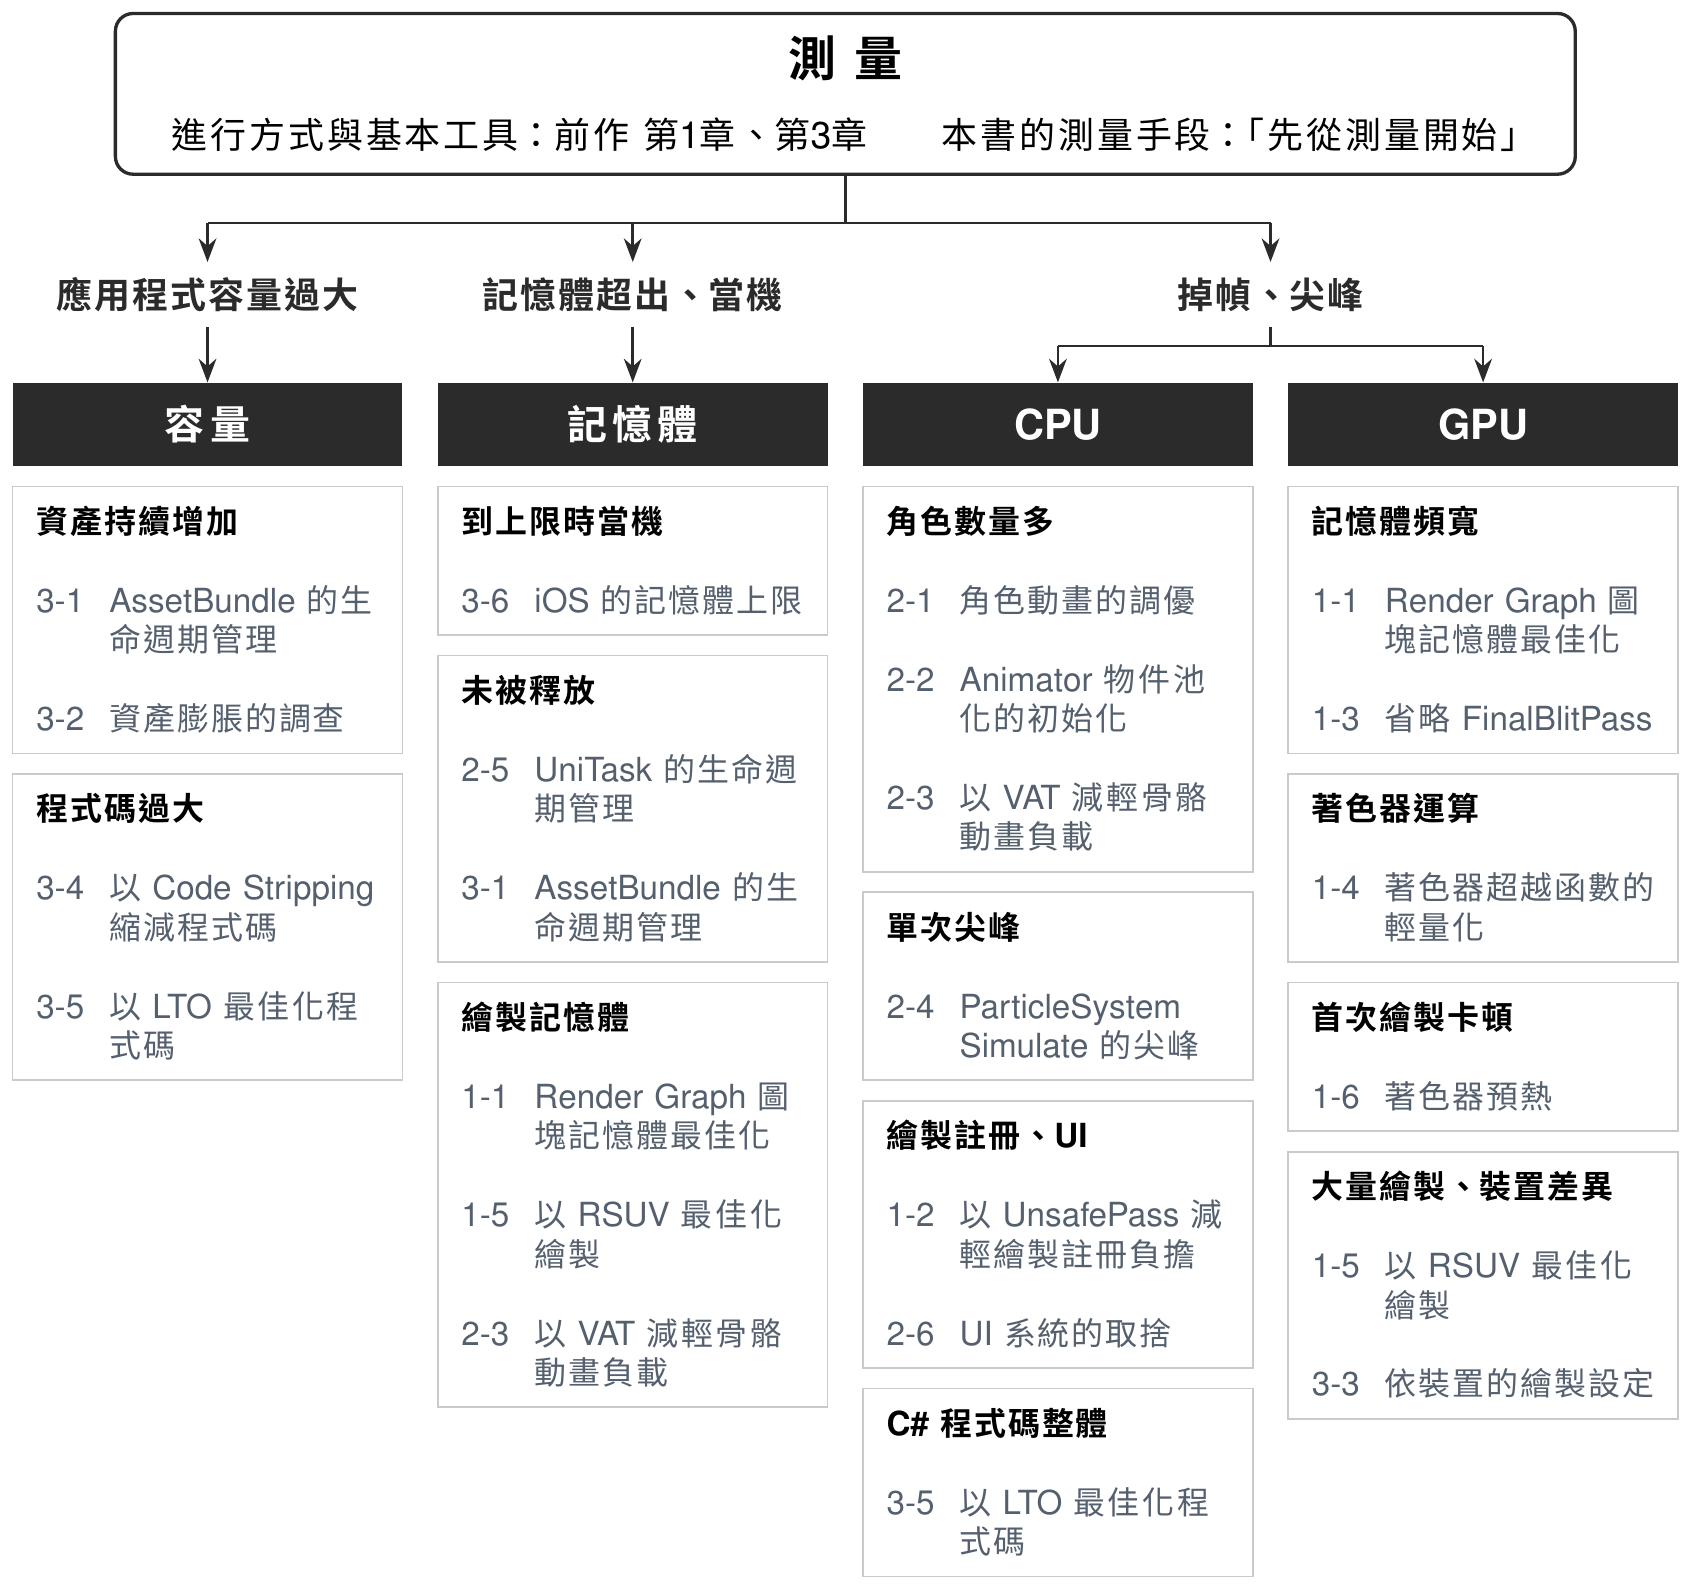
先從測量開始
先確定哪裡慢,再著手處理。以測量而非推測來找出原因、比較修正前後的結果,這樣的進行方式,以及記憶體超出與掉幀的區分方法,已在前作《Unity Performance Tuning Bible》的第 1 章「開始進行效能調優吧」中解說。Unity Profiler、Frame Debugger、RenderDoc 等的基本用法,也彙整於第 3 章「效能分析工具」。
這裡介紹前作未涵蓋的測量手段,以及在既有工具中新增可確認的項目。若是 iOS 平台,Metal Performance HUD 與 Performance Trace 不依賴 Development Build 旗標即可使用,因此即使尚未內建測量處理,或維持接近正式發行的組態,也能大致掌握負載的所在。
(第 4 部第 1 章「在 Unity 中活用 iOS 標準的效能測量功能」)
繪製方面,測量之前先確認管線的狀態。Frame Debugger 以事件名稱的 (RP n:m) 標記顯示 Pass 是否已合併,Render Graph Viewer 則除了各附件的載入/儲存動作與 Memoryless 的狀態之外,還會顯示未能合併的原因(Pass Break Reasoning)。若想對照 Unity 的顯示與傳遞給驅動程式的值,可用 RenderDoc 擷取 Vulkan,在 API 層級確認 loadOp / storeOp。
(第 1 部第 1 章「Unity 6 Render Graph 圖塊記憶體最佳化」)
若要每天進行測量本身,有一種架構是:以應用程式內的遠端操作讓裝置農場借用的實機進行畫面轉換,並在每次建置時傳送記憶體快照與已篩選的 Profiler 擷取資料。其中也一併探討了在裝置上篩選影格的機制、閾值的決定方式,以及讓長時間巡覽符合裝置容量的作法。
(第 4 部第 2 章「自動化每日建置的實機效能分析」)
若希望在審查階段而非測量階段發揮作用,可以將本書的知識本身轉換為 AI 程式設計代理的評估規則。本章介紹了將前作的 77 條規則與本書的 86 條規則整合為 163 條規則並做成技能的案例。
(第 4 部第 3 章「將調優寶典做成 AI 程式設計代理的技能」)
容量
應用程式容量在逐一縮減個別資產之前,先將增長的原因分類,會更快止住。壓縮設定錯誤、解析度過高、多餘的附帶資料、格式選擇錯誤這 4 種可在 Import 時判定,而整理方式不一致與 Bundle 之間的重複,則取決於與其他資產的關係,因此需要在建置前進行檢查。尤其是重複,從外觀上看不出來。未登錄到 Addressables 的共用資產,會依參照來源的 Bundle 各自複製,因此即使只有 2 個 Prefab 參照一張 4MB 的紋理,合計也會變成 10MB,若登錄到專用群組則可降至 6MB。
(第 3 部第 2 章「營運階段的資產膨脹與以 Project Auditor 進行調查」)
程式碼方面也有可縮減的空間。將 Managed Stripping Level 從 Minimal 提高到 High,即使是只放了一個結束處理腳本的簡單場景,受管理組件也減少了約 6.7%。
(第 3 部第 4 章「Unity Managed Code Stripping 實踐指南」)
在此之上,將「哪些資產需要持續到何時」保留為設計。把載入與釋放的入口集中到基礎層,並配合 AssetBundle 的粒度決定生命週期的分類,就能避免壽命不同的資產混在同一個 Bundle 中。
(第 3 部第 1 章「AssetBundle 的生命週期管理」)
記憶體
在 iOS 上,只要啟用 Xcode 的一項設定,套用於應用程式的記憶體上限有時就會提高。在所提供的實機觀測中,Increased Memory Limit 使 4GB 裝置增加了約 240MB、6GB 裝置增加了約 1GB 的餘裕。不過 3GB 裝置在啟用與停用時沒有差異。若 footprint 尚有餘裕卻配置失敗,可考慮擴大虛擬位址空間的 Extended Virtual Addressing。
(第 3 部第 6 章「iOS 的記憶體上限與虛擬位址空間」)
在減少常駐量本身方面,首先要懷疑已載入資產的釋放遺漏。
(第 3 部第 1 章「AssetBundle 的生命週期管理」)
在非同步處理中,CancellationTokenSource 的 Dispose 遺漏會保留來自連結來源的參照,表現為不需要的物件無法釋放。
(第 2 部第 5 章「UniTask 與取消處理的生命週期管理」)
繪製端的記憶體由結構決定。顯示 16 個會播放動畫的物件時,GPU 記憶體的增量在 FBX 方式為 +411.8MB、Skin 方式為 +38.2MB,VAT 方式則幾乎沒有增加。
(第 2 部第 3 章「以 VAT 減輕骨骼動畫的負載」)
材質的複製也會推高記憶體。讓 10000 個 Renderer 各自持有材質時增加了 15.79MB,但若以 RSUV 傳遞值,增量僅需 1.66KB。
(第 1 部第 5 章「活用 Renderer Shader User Value 的圖形最佳化」)
若將既不載入也不儲存的附件設為無記憶體(memoryless),就不需要在主記憶體上保有實體。
(第 1 部第 1 章「Unity 6 Render Graph 圖塊記憶體最佳化」)
在建置設定方面,藉由 Managed Code Stripping,可以從一開始就不讓未使用的程式碼載入記憶體。
(第 3 部第 4 章「Unity Managed Code Stripping 實踐指南」)
CPU
在大量顯示角色的場合,Transform 階層的處理會有影響。以 Optimize Game Objects 將階層扁平化後,在 300 個角色的組態中,主執行緒的 MeshSkinning.Update 從 6.23ms 降至約 1.5ms,蒙皮矩陣的計算在所有執行緒合計 36.6ms 則完全消失。Playable Graph 的手動更新只能以圖為單位平行化,因此將 600 個角色整合為 1 個圖,可使 8.396ms 降為 4.500ms。IK 若不在主執行緒求解而移至 Animation Job,在 300 個角色各求解 64 次的組態中,9.094ms 降為 2.795ms。發揮效果的並非 Burst,而是改變了執行的執行緒。
遠景的角色每 N 影格才更新一次。與其個別呼叫 Animator.Update(),不如透過 Animator.enabled 的切換或各相位的手動圖,回到 Unity 的批次更新,成本更低;600 個角色改為每 2 影格更新一次,可使 5.037ms 降為 3.082ms。若將每影格更新的角色錯開,即使每 4 影格才更新一次,p95 也能從 9.470ms 降至 2.707ms,不會形成尖峰。
(第 2 部第 1 章「Unity 3D 角色動畫的調優」)
在將骨骼更新本身改為預先計算的 VAT 中,顯示 16 個角色時的 CPU 主執行緒從 154.3ms 降至 12.6ms。這是因為 Instancing 使繪製命令從每影格約 21 萬個降至 99 個,而 SRPBatcher.Flush 的 76.17ms 幾乎消失。
(第 2 部第 3 章「以 VAT 減輕骨骼動畫的負載」)
從物件池取回的 Animator 的初始化,也應納入此設計一併考量。
(第 2 部第 2 章「以 ResetControllerState 安全地進行 Animator 物件池化」)
單次的大型尖峰,需要用另一種方式尋找。對啟用了 Noise 模組的 ParticleSystem 傳入 ParticleSystem.Simulate(20f, false, false) 這類較大的秒數,NoiseJob 會被呼叫約 2000 次,並產生約 50ms 的尖峰。
(第 2 部第 4 章「以 ParticleSystem 長時間 Simulate 會產生巨大尖峰」)
繪製的登錄成本也屬於 CPU 負載。將無法合併的 Pass 鏈整合為 1 個 UnsafePass,可削減每個 RasterRenderPass 約 1.8µs 的固定成本。在 100 個 Pass 的乒乓 Blur 中,1080.7µs 降為 898.5µs。
(第 1 部第 2 章「應使用 Render Graph 的 UnsafePass 的情境」)
在大量繪製時,不必複製材質即可傳遞逐物件數值的 RSUV 很有效。在 iPhone 12 上每影格變更 10000 個 Sphere 的參數的測量中,逐 Renderer 持有材質為 8.1FPS,而併用 RSUV 與 GPU Resident Drawer 則維持在 60.0FPS。
(第 1 部第 5 章「活用 Renderer Shader User Value 的圖形最佳化」)
在 UI 方面,uGUI 只要變更一個元素就會重建整個 Canvas 的網格,而 UI Toolkit 只更新有變化的部分。
(第 2 部第 6 章「UI 系統的取捨 — IMGUI / uGUI / UI Toolkit」)
作為對整個 C# 程式碼都有效的手段,有 LTO。在 Android 上,只要在 Release 建置加入 -flto=thin,基準測試的直接呼叫就縮短了 21.8%,遠超過切換到 Master(-O2)時的 5.9%。在實際遊戲的穩定畫面中,UnityMain 縮短了 3.21%。
(第 3 部第 5 章「Unity 的 LTO 設定與 Android、iOS 上的效能比較」)
GPU
在行動裝置上,記憶體頻寬會比 GPU 的運算效能更早成為瓶頸。僅將 1080p 的 RGBA8 儲存一次並在下一個 Pass 載入,來回就約 16MB,以 60FPS 計算則消耗約 950MB/s。削減這些的手段有明確指定載入/儲存動作、合併 Pass、Framebuffer Fetch、無記憶體(memoryless)這 4 種,條件都是要將資源的使用方式正確傳達給 Render Graph。
例如必定覆寫所有像素的 Pass,只要以 AccessFlags.WriteAll 宣告,在 1080p 下就能省去約 8MB/影格的載入。若以 Framebuffer Fetch 讀取延遲渲染的 G-Buffer,僅 3 張的儲存就能削減約 24MB/影格、60FPS 下約 1.4GB/s 的頻寬。MSAA 若使用 Resolve 而非 Store,會在圖塊記憶體上完成解析,並可讓 4 個取樣份的緩衝區成為無記憶體(memoryless)。
(第 1 部第 1 章「Unity 6 Render Graph 圖塊記憶體最佳化」)
最後只執行一次的全螢幕 Blit,在高解析度下也是不可忽視的成本。在 AfterRenderingPostProcessing 之後插入自訂 Pass,幾乎必定會加入 URP 的 FinalBlitPass,但從 Unity 6.3 起,在最後一個攝影機的最終 Pass 中呼叫 SwitchActiveTexturesToBackbuffer(),即可直接輸出到 BackBuffer 而省略它。在自訂 FXAA 的範例中,Unity 6.0 需要 2 次的 Blit 變成 1 次,中間紋理也變得不需要。
(第 1 部第 3 章「省略 URP 的 FinalBlitPass 的方法」)
在著色器內部,超越函數特別顯眼。sin 可替換為只用乘法與 abs() 的拋物線近似,在執行 10 次時,於 iPhone X 上削減約 2.5ms、於 Galaxy S9 上削減約 1.3ms 的 GPU 時間。tan 的近似在執行 10 次時,GPU 時間降為原本的 80%(iPhone 15 Pro)或 50%(iPhone 14)。不過在執行次數較少時,暫存器壓力所造成的額外負擔會比較明顯。
(第 1 部第 4 章「行動裝置著色器最佳化:超越函數的測量與輕量化」)
首次繪製時的卡頓,原因在於 GPU 端的編譯。在 Metal 與 Vulkan 上,產生一次 PSO 有時需要數十毫秒,可使用 GraphicsStateCollection 在任意時機預先完成。若以 WarmUpProgressively() 指定每影格的件數,也能避免預熱本身造成尖峰。導入後仍殘留卡頓時,則要懷疑 Shader Stripping 造成的變體缺漏或中繼資料不一致。在 iOS 上,應將著色器整合為單一 Bundle 以避免重複載入,而使用 SubPass 的著色器則要在載入畫面中先繪製一次以建立 PSO。
(第 1 部第 6 章「使用 GraphicsStateCollection 進行著色器預熱」)
若仍無法解決,則依裝置切換繪製設定本身。以 deviceModel、graphicsDeviceName、systemMemorySize 判定裝置,切換 Quality Level,或直接操作 RenderPipelineAsset 的 renderScale 與陰影的 Cascade 數量。對於自製的 RendererFeature,也先準備好降低暫存紋理的格式或解析度、減少 Blit 數量、替換為簡易著色器等切換入口,就能以同樣的機制調整負載。
(第 3 部第 3 章「依裝置切換繪製設定」)