第1章. Unity 6 Render Graph 圖塊記憶體最佳化
1.0.1. 前言
本章說明如何利用 Unity 6 的 Render Graph,活用行動裝置 GPU(圖塊式渲染架構)的圖塊記憶體,以削減 GPU 時間、記憶體頻寬與記憶體用量。在行動裝置的遊戲開發中,記憶體頻寬往往比 GPU 的運算效能更早成為瓶頸。此外,記憶體頻寬的消耗直接關係到功耗與發熱,因此不只影響影格率,也會影響裝置的發熱與電池消耗。本章以下列 4 個主題進行說明,並分別安排了同名的小節。
- 圖塊記憶體的載入/儲存
- Render Pass/Subpass
- Frame Buffer Fetch
- 無記憶體(memoryless)
1.1. 圖塊式渲染的基礎
本節說明行動裝置 GPU 為什麼會配備圖塊記憶體。
1.1.1. 行動裝置 GPU 與記憶體頻寬
在現代 GPU 中,運算速度與記憶體讀寫速度的差距持續擴大,記憶體存取已成為主要瓶頸。GPU 核心的運算效能(FLOPS)每一代都大幅提升,記憶體頻寬的成長卻跟不上。PC 的獨立 GPU 透過搭載 GDDR 這類圖形專用的高頻寬記憶體來緩解這個問題。然而行動裝置 SoC 無法這麼做。
| 項目 | PC(獨立 GPU) | 行動裝置 SoC |
|---|---|---|
| 圖形記憶體 | 專用(GDDR6 等,數百 GB/s) | 無(LPDDR 由 CPU/GPU/ISP 等共用) |
| 頻寬規模 | 數百 GB/s~1TB/s | 數十 GB/s(且為共用) |
| 電力限制 | 數百 W 等級的電源與散熱 | 數 W,僅有被動散熱 |
行動裝置 GPU 沒有專用的圖形記憶體,而是與 CPU 共用同一塊 LPDDR 記憶體。而且共用的對象不只 CPU,還包括相機的 ISP、機器學習加速器等 SoC 上的所有區塊。頻寬本身就窄,還得互相爭搶。此外,存取主記憶體(DRAM)是 SoC 中特別耗電的操作。頻寬用得越多,功耗就越高、越容易發熱,進而因熱降頻導致 CPU/GPU 時脈下降、影格率降低。也就是說,在行動裝置上會發生
記憶體頻寬消耗 → 功耗增加 → 發熱 → 降頻 → 效能下降
這樣的連鎖反應。如果遊戲在最初幾分鐘能以 60FPS 運作,玩一陣子後影格率卻逐漸下降,原因經常就是這種頻寬與發熱的問題。為了在這樣的限制下完成畫面繪製而誕生的,就是圖塊式渲染(TBR: Tile-Based Rendering)架構的 GPU。
1.1.2. IMR 與 TBR
為了理解 TBR,先與 PC GPU 主流的立即模式渲染(IMR: Immediate Mode Rendering)做比較。IMR 會將繪製呼叫送入的圖元當場光柵化、執行片段著色器,並將結果寫入記憶體上的渲染目標。每次深度測試或混合都會對渲染目標進行讀寫,但 PC 的 GPU 靠高頻寬的圖形記憶體與大容量快取來承受這些存取。而 TBR 則是將畫面分割成小圖塊,逐一圖塊完成渲染。每個著色器核心都配備一小塊稱為圖塊記憶體的晶片內建記憶體,圖塊內的繪製(顏色、深度、模板的讀寫以及混合)全部在這塊圖塊記憶體上進行。原則上,對主記憶體的存取只有圖塊繪製開始時(載入)與結束時(儲存)兩次。
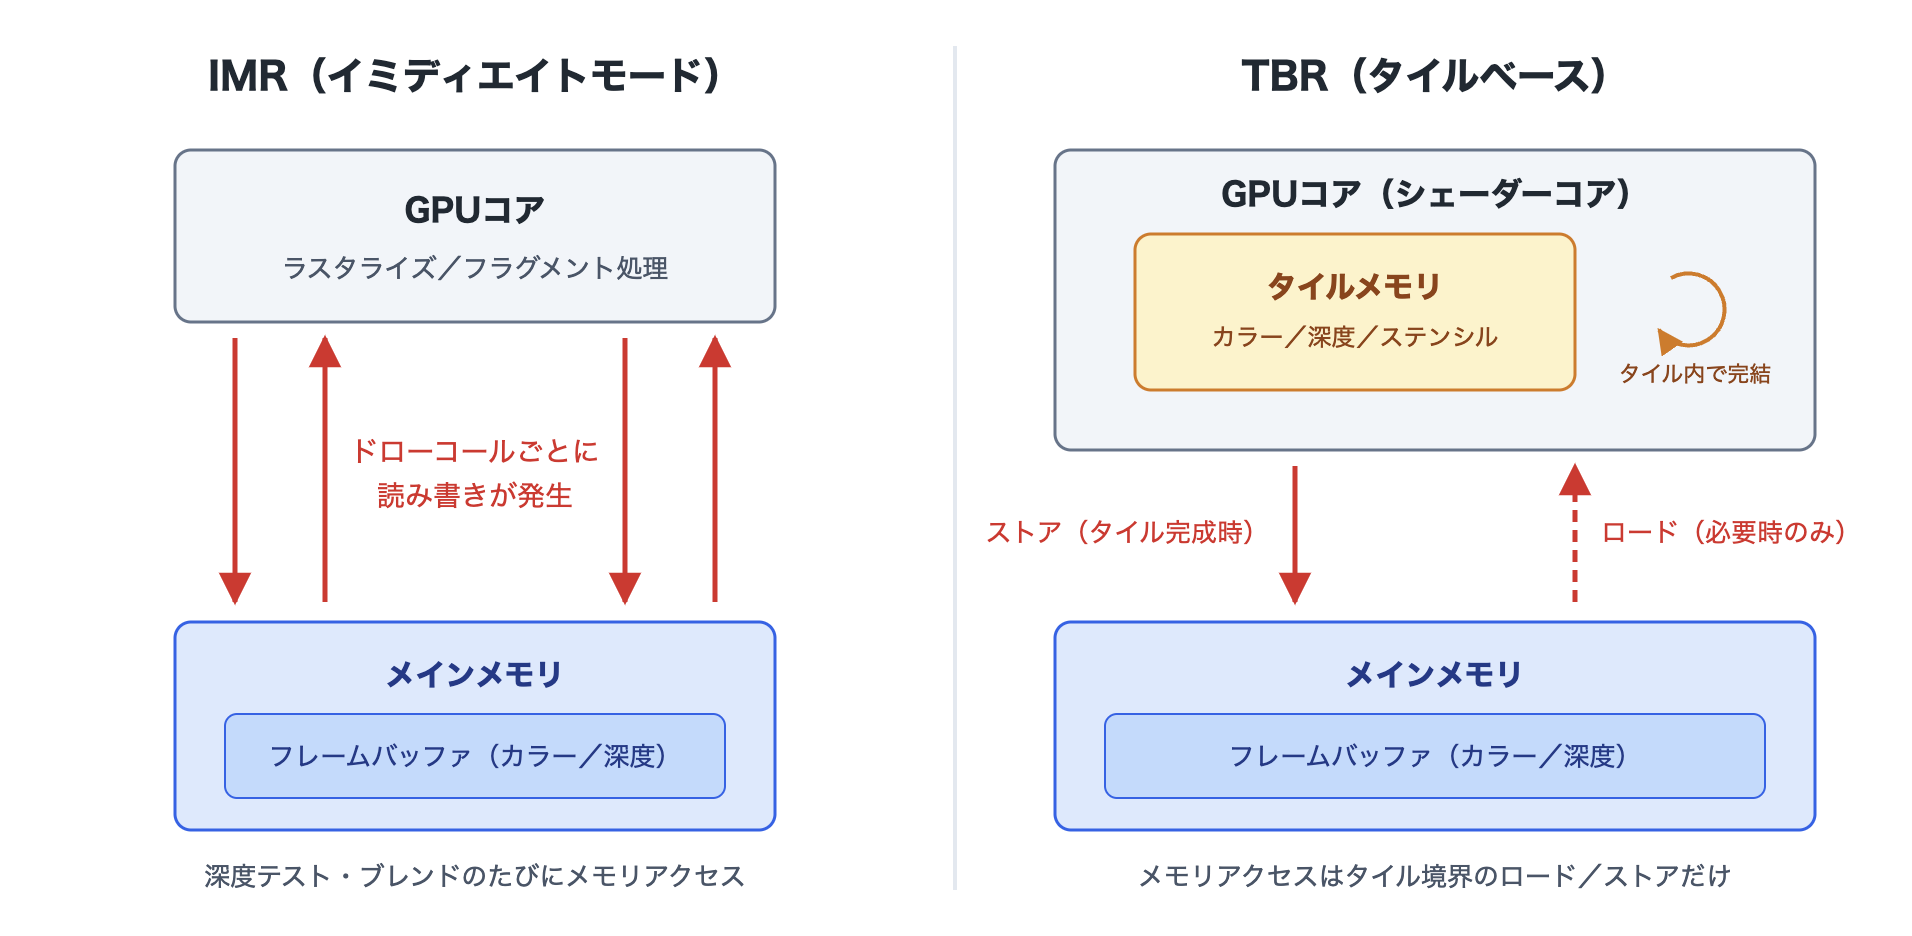
圖 1.1: IMR 與 TBR 的比較
下圖是 TBR GPU 中著色器核心的概念圖。圖塊記憶體直接連接著色器核心。由於位於晶片內且實體距離近,存取圖塊記憶體比存取主記憶體快上好幾個數量級,功耗也低得多。實際的 GPU 也能確認這種結構,例如 ARM Mali-G71 官方資料中的著色器核心設計圖,就顯示了圖塊記憶體直接連接著色器核心的樣子。
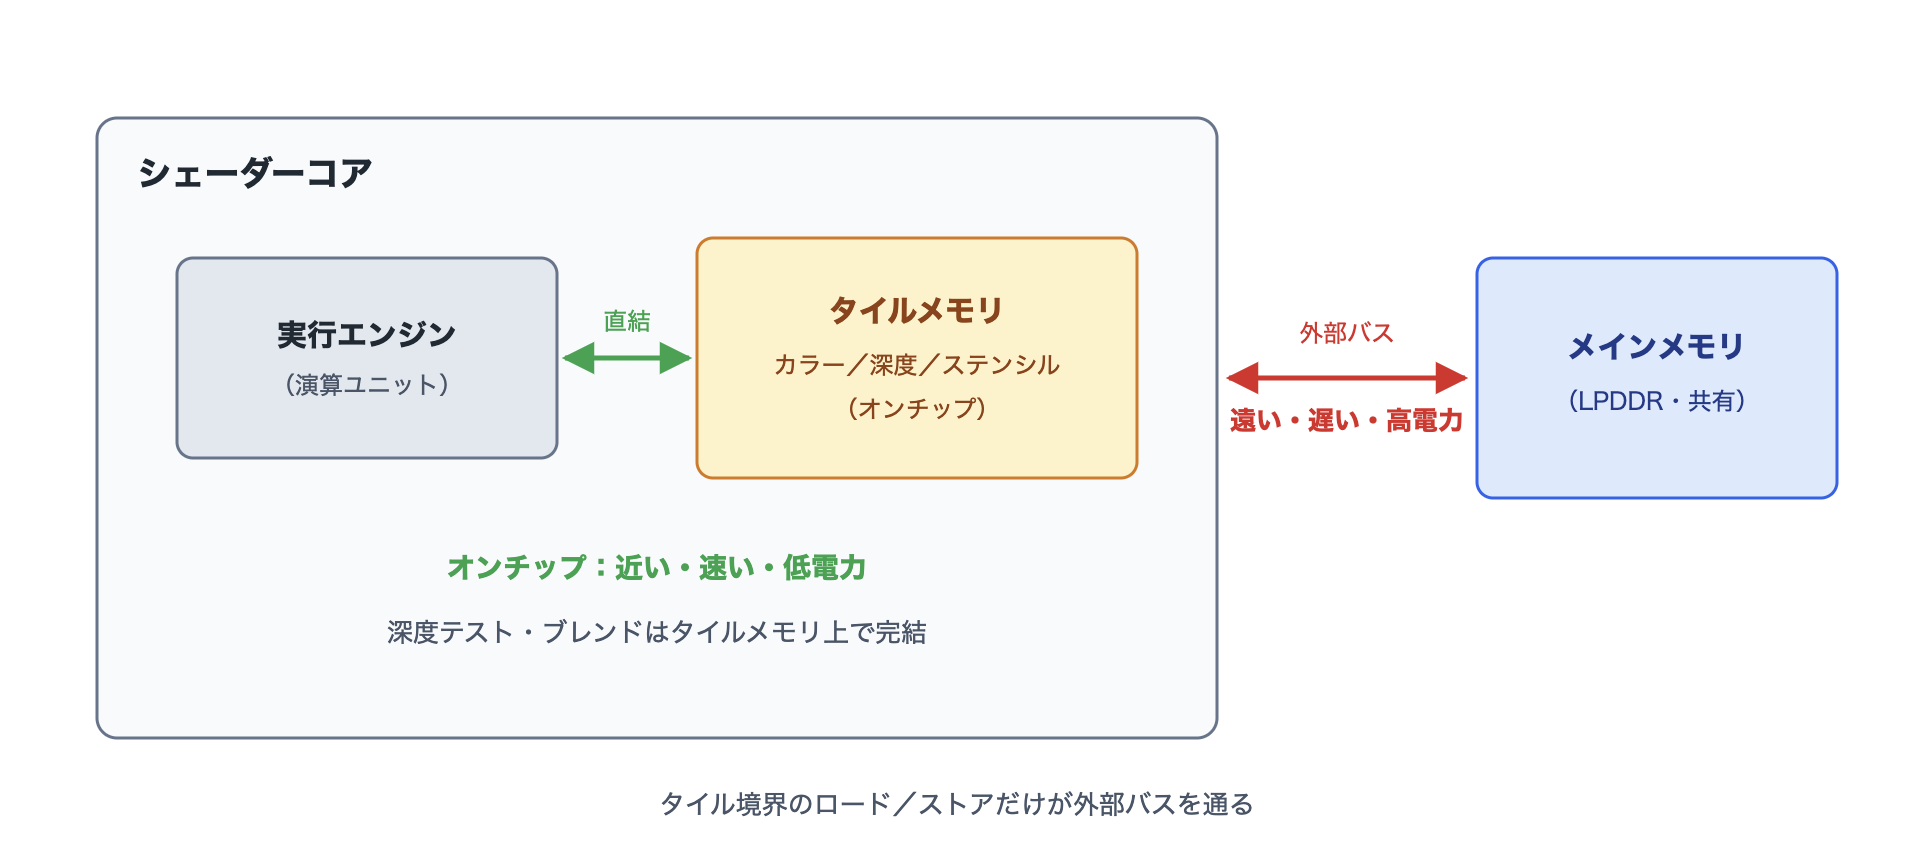
圖 1.2: 著色器核心與圖塊記憶體(概念圖)
如此一來,在 IMR 中記憶體存取最頻繁的深度測試與混合,在 TBR 中就能在圖塊記憶體內完成。
1.1.3. TBR 的 2 個階段
TBR 的 GPU 會將 1 個影格的繪製大致分成 2 個階段執行。
分箱階段(幾何階段)
首先,執行影格內所有繪製呼叫的頂點著色器(其中的位置計算部分),將各圖元依其覆蓋的圖塊進行分類(分箱,Binning)。分類結果以「每個圖塊的圖元清單」的形式寫入主記憶體。這裡要注意的是,分箱階段本身也會消耗主記憶體的頻寬。頂點資料越多,圖元清單的讀寫就越多。TBR 的 GPU 在高多邊形場景中容易居於劣勢,原因就在這裡。
光柵化階段(渲染階段)
接著,逐一處理每個圖塊。對於每個圖塊,
- 必要時將渲染目標的既有內容載入圖塊記憶體
- 將覆蓋該圖塊的圖元光柵化並執行片段著色器(讀寫全部在圖塊記憶體上進行)
- 將完成的圖塊內容儲存至主記憶體
繪製依照上述步驟進行。其中步驟 1 與 3 就是本章的主題:載入/儲存。詳細內容將在下一節「圖塊記憶體的載入/儲存」中說明,但 TBR 的成本結構是:相較於圖塊的繪製本身,在圖塊邊界與主記憶體之間的資料往返反而更昂貴。
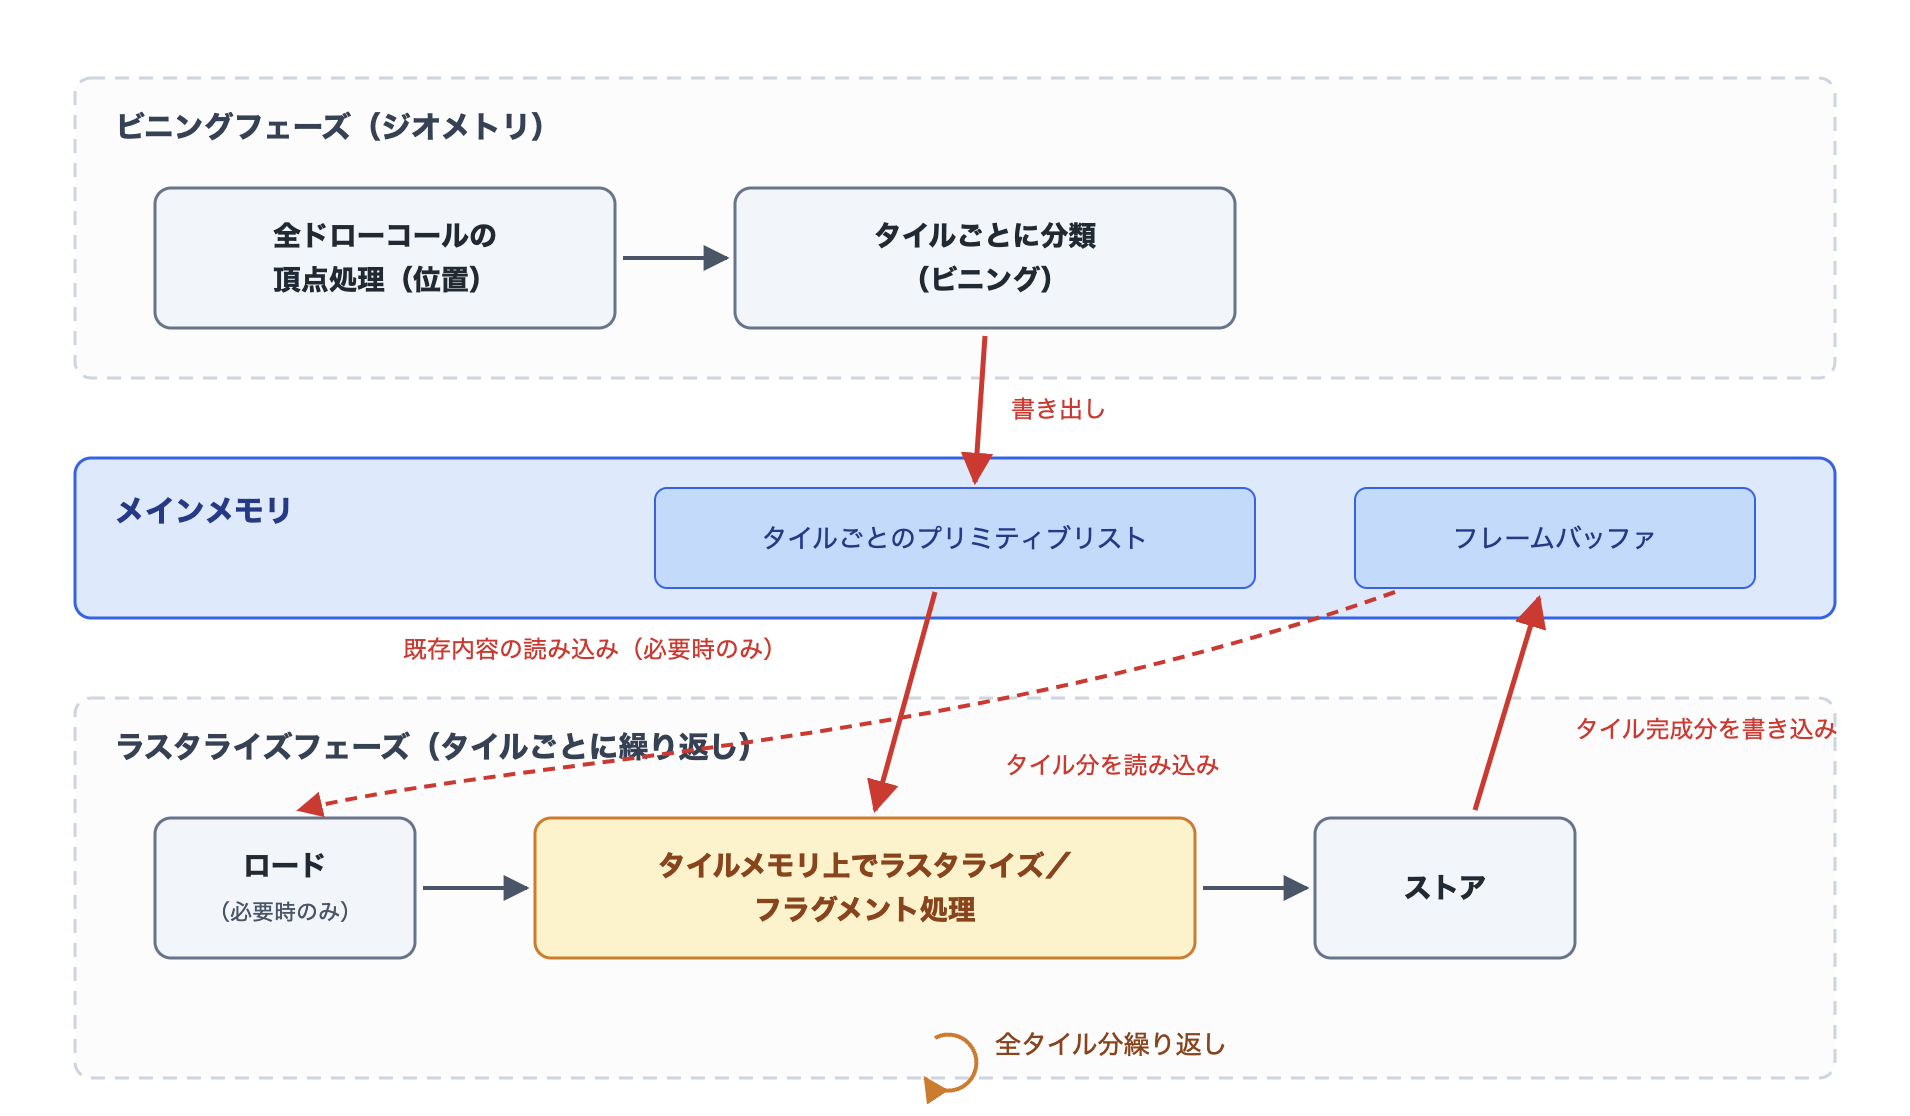
圖 1.3: 分箱階段與光柵化階段
各廠商的名稱與特性
TBR 的基本結構是共通的,但各 GPU 廠商的名稱與細節實作有所不同。本章以下統一使用圖塊記憶體/分箱作為總稱。
| 廠商(GPU) | 階段/機制的名稱 | 特別說明 |
|---|---|---|
| Qualcomm Adreno | Binning / GMEM | 將稱為 GMEM 的晶片內建記憶體分割使用。具有依繪製內容切換為類 IMR 動作的模式 |
| ARM Mali | Tiler / Tile Memory | 圖塊基本為 16×16 像素 |
| Imagination(PowerVR/IMG) | TBDR | 以硬體執行隱面消除(HSR)的 TBDR。Pixel 10 的 IMG DXT 也屬於這一系譜 |
| Apple GPU | Tile Memory | PowerVR 系譜的 TBDR。可從 Metal 明確操作圖塊記憶體 |
1.1.4. 本章探討的 4 個主題
到此為止,我們已了解圖塊邊界的載入/儲存是一種成本。那麼,該如何削減這項成本呢?本章探討的 4 個主題,都是針對這個問題的手段。
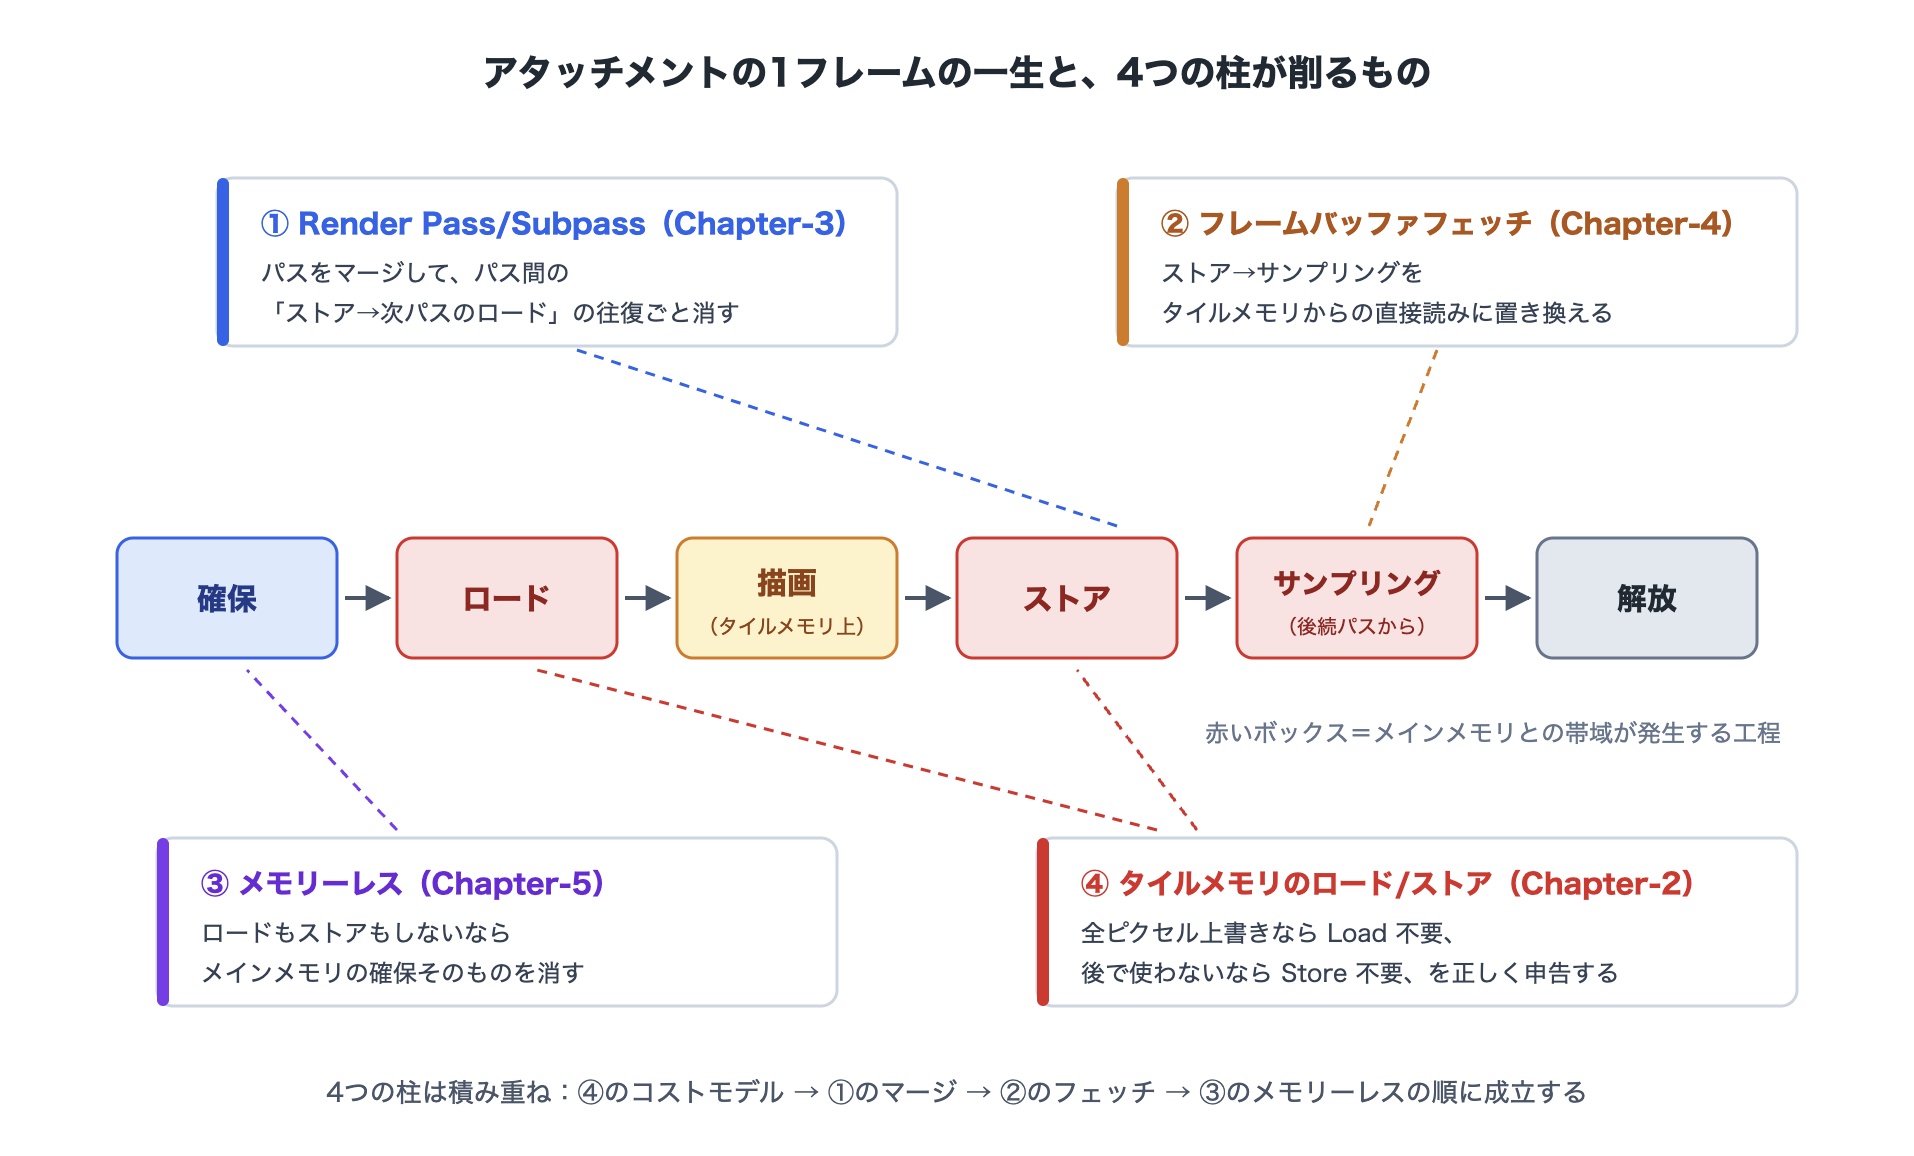
圖 1.4: 附件的生命週期與 4 個主題的關係
試想某個渲染目標(附件)在 1 個影格內的生命週期。
配置 → 載入 → 繪製 → 儲存 → (在後續通道中作為紋理)取樣 → 釋放
依據削減這個生命週期中的哪個環節,4 個主題可整理如下。
| 主題 | 削減的項目 | 思路 | 小節 |
|---|---|---|---|
| 載入/儲存 | 不必要的載入與不必要的儲存 | 明確宣告「若會覆寫全部像素則不需載入」「若之後不再使用則不需儲存」 | 「圖塊記憶體的載入/儲存」 |
| Render Pass/Subpass | 通道與通道之間的儲存→載入往返 | 將多個通道整合(合併)為 1 個 Render Pass,讓中間結果留在圖塊記憶體中 | 「Render Pass / Subpass」 |
| Frame Buffer Fetch | 儲存→取樣的往返 | 直接從圖塊記憶體讀取前一個子通道的結果 | 「Frame Buffer Fetch」 |
| 無記憶體(memoryless) | 主記憶體的配置本身 | 既不載入也不儲存的話,就不需要主記憶體上的實體 | 「無記憶體(memoryless)」 |
這 4 項並非各自獨立的技術。通道合併之後才能使用 Frame Buffer Fetch,載入與儲存都消除之後才能成立無記憶體(memoryless)。本章的小節編排也依循這個相依關係:成本模型(載入/儲存)→ 機制(Subpass)→ 應用(Fetch)→ 收尾(無記憶體(memoryless))。此外,Render Graph 是一個先收集各通道的資源使用資訊(讀取什麼、寫入什麼),再擬定渲染執行計畫的系統。因此它能自動進行通道合併、載入/儲存動作的決定、無記憶體(memoryless)化等最佳化。可以說,本章要說明的,就是如何將資源的使用方式正確地告知 Render Graph,讓這些最佳化得以生效。
1.1.5. 驗證工具的使用方式
本章會反覆進行「先用工具確認管線狀態,再進行測量」的流程。主要使用以下 3 種工具。
1.1.6. Frame Debugger
Unity 的 Frame Debugger(Window > Analysis > Frame Debugger)是確認通道結構的基本工具。本章特別關注事件名稱中的(RP n:m)標記。如果像RP 4:0、RP 4:1那樣,同一個 Render Pass 編號(n)下的子通道編號(m)連續排列,就表示這些通道已合併為 1 個 Native Render Pass。另外,通道合併(Native Render Pass)只在 Vulkan/Metal 等環境下運作。若編輯器的圖形 API 為 D3D 等,將無法觀察到合併,因此在編輯器中確認時,請將 Graphics API 改為 Vulkan,或將 Frame Debugger 附加到實機建置上。
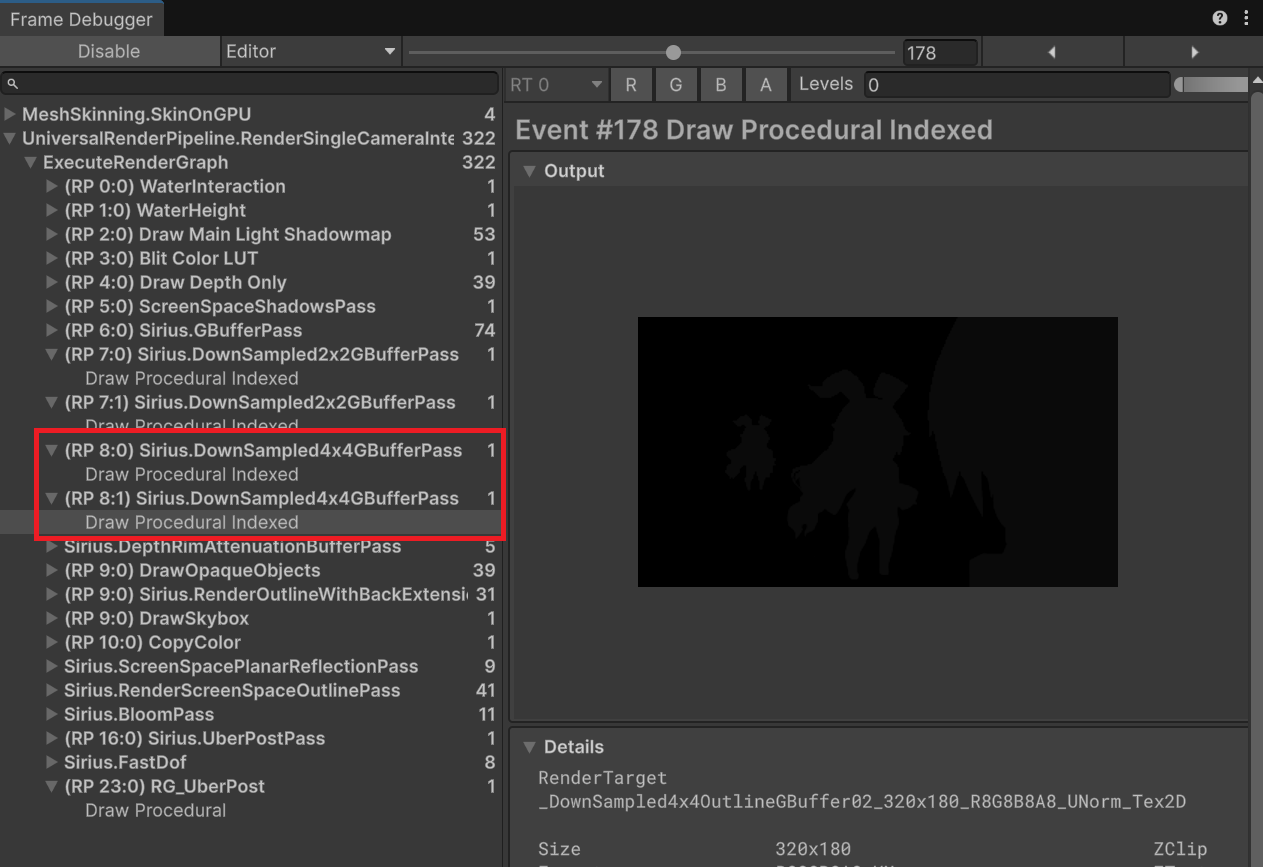
圖 1.5: Frame Debugger 中的合併狀態
1.1.7. Render Graph Viewer
Render Graph Viewer(Window > Analysis > Render Graph Viewer)是將 Render Graph 建構的執行計畫本身視覺化的工具。
- 通道清單,以及各通道所存取資源的時間軸(哪個資源何時建立、何時銷毀)
- 各附件的 Load Action / Store Action,以及 Memoryless 狀態的顯示。本章會使用這項顯示來確認最佳化的結果
- 顯示通道是否已被合併
- 顯示未被合併的原因(Pass Break Reasoning)
第 4 項的 Pass Break Reasoning,是「本應合併的通道卻未合併」時首先要確認的資訊。從「Render Pass / Subpass」一節起會反覆用到。
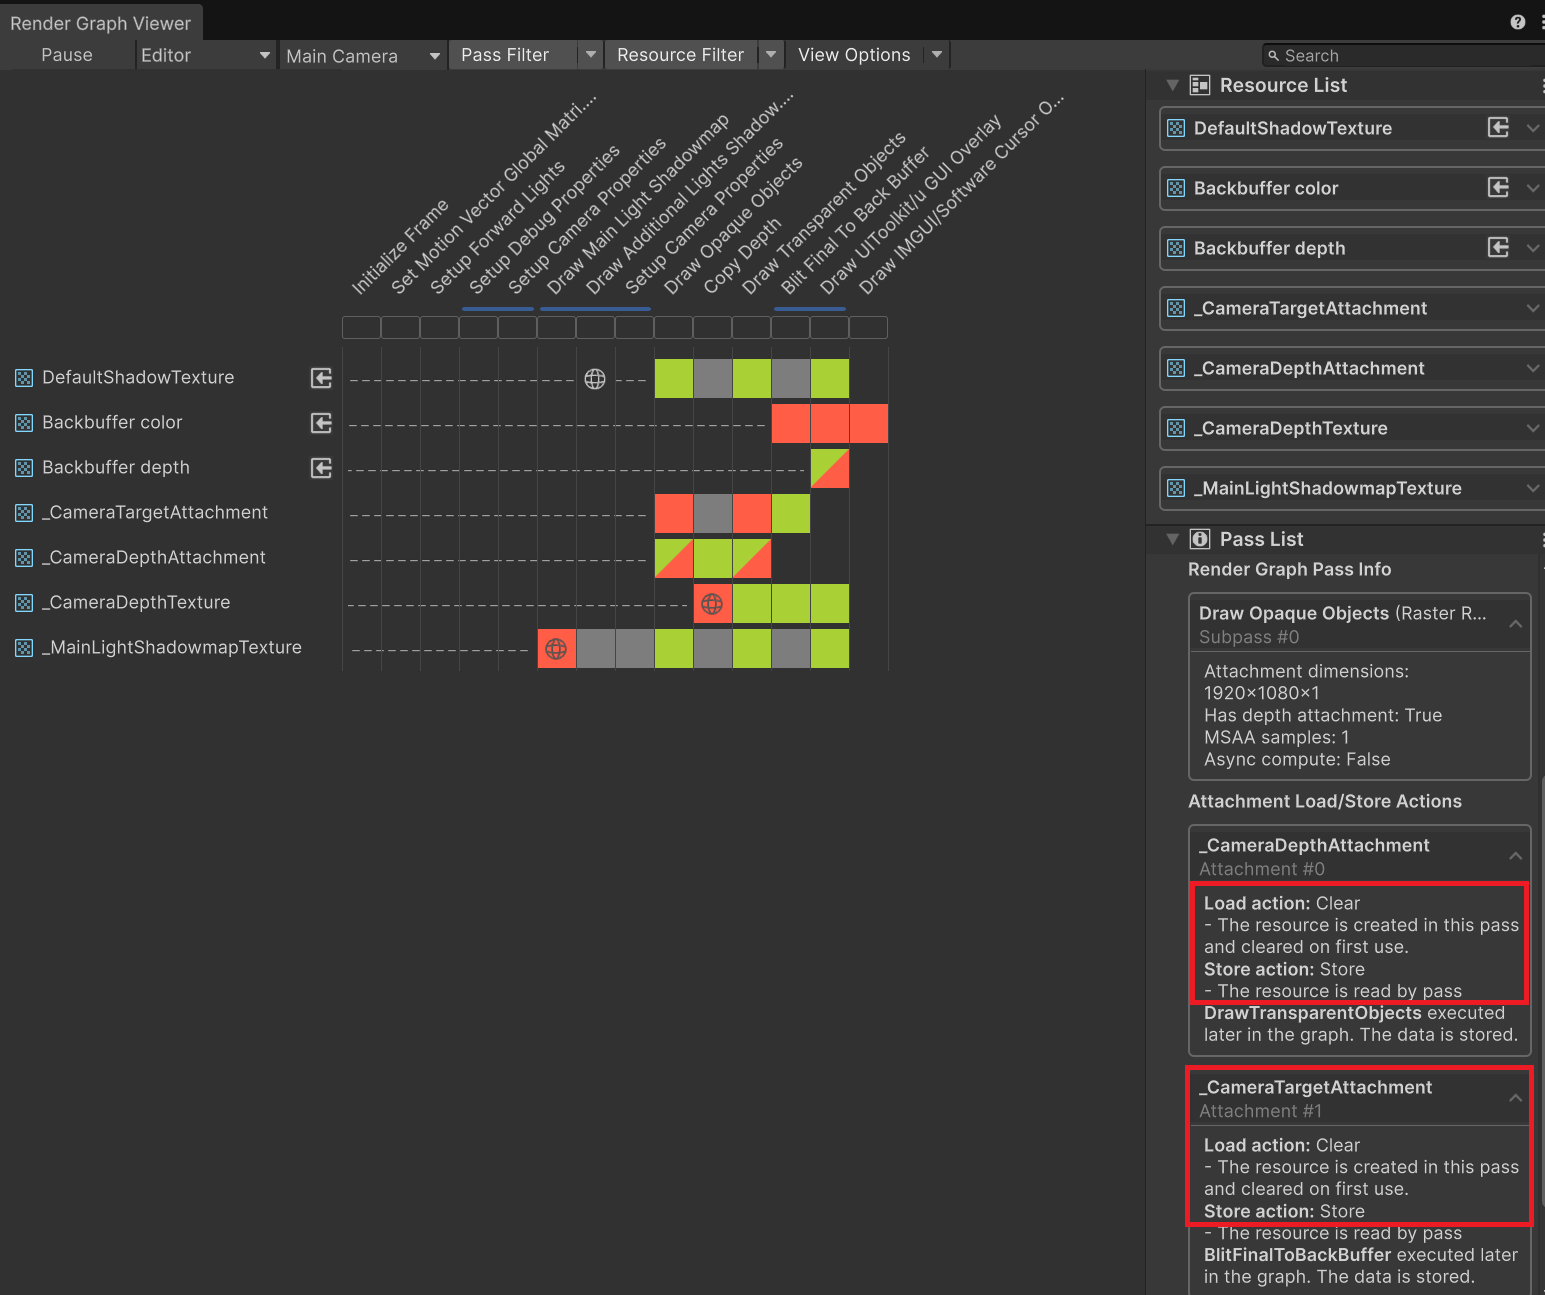
圖 1.6: 在 Render Graph Viewer 中確認合併狀態與載入/儲存動作
1.1.8. RenderDoc
使用 RenderDoc 擷取 Vulkan 的畫面後,可在 API 層級確認各 Render Pass 的附件所指定的loadOp/storeOp。當想進一步深究 Render Graph Viewer 的顯示內容,或想比對 Unity 的顯示與實際傳給驅動程式的值時使用。
1.2. 圖塊記憶體的載入/儲存
本節說明作為本章整體基礎的載入/儲存動作。
1.2.1. 什麼是載入/儲存動作
TBR 的 GPU 在圖塊繪製開始時,會將渲染目標的既有內容讀入圖塊記憶體(載入),在繪製結束時,將圖塊記憶體的內容寫出至主記憶體(儲存)。不過,載入與儲存並非總是必要。圖形 API 提供了可針對每個附件指定「開始時怎麼做」「結束時怎麼做」的動作。
載入動作
| 動作 | 行為 | 頻寬成本 |
|---|---|---|
| Load | 將主記憶體的既有內容讀入圖塊記憶體 | 高(解析度×格式大小的讀取) |
| Clear | 以指定顏色清除圖塊記憶體 | 幾乎為零(僅在圖塊記憶體內操作) |
| DontCare | 不做任何事(圖塊記憶體的初始值不定) | 零 |
儲存動作
| 動作 | 行為 | 頻寬成本 |
|---|---|---|
| Store | 將圖塊記憶體的內容寫出至主記憶體 | 高(解析度×格式大小的寫入) |
| Resolve | 只寫出 MSAA 取樣解析(resolve)後的結果 | 中(僅解析後的 1 個取樣) |
| DontCare | 不寫出任何內容(內容會被捨棄) | 零 |
也就是說,會消耗頻寬的只有 Load 與 Store(以及 Resolve)。反過來說,能以 Clear/DontCare 開始並以 DontCare 結束的附件,完全不會與主記憶體有任何往來。這種狀態正是後面要談的無記憶體(memoryless)的前提條件。要最佳化載入/儲存,就得針對每個附件確認以下 2 點。
- 開始時,是否需要先前的內容? 若是會覆寫全部像素的通道,則不需要(DontCare)。若從清除開始則為 Clear,只有在要疊加於先前繪製結果上時才會是 Load。
- 結束時,這些內容之後是否還會用到? 若後續通道或下一個影格會用到則為 Store,若在此 Render Pass 內就使用完畢則為 DontCare。
1.2.2. 頻寬成本的估算
1 次載入/儲存的成本可用簡單的乘法概算。
1 次載入(或儲存)的資料量 = 水平解析度 × 垂直解析度 × 每像素的位元組數
以下列出 1080p(1920×1080)下代表性格式的數值。
| 格式 | 每像素 | 1 次載入/儲存 | 60FPS 時的頻寬 |
|---|---|---|---|
| R8G8B8A8 (RGBA8) | 4 位元組 | 約 7.9MB | 約 475MB/s |
| B10G11R11_Float | 4 位元組 | 約 7.9MB | 約 475MB/s |
| R16G16B16A16_Float | 8 位元組 | 約 15.9MB | 約 950MB/s |
| D24S8 / D32(深度) | 4 位元組 | 約 7.9MB | 約 475MB/s |
例如,光是「儲存相機顏色(RGBA8),並在下一個通道載入」,往返就約 16MB,在 60FPS 下會消耗約 950MB/s 的頻寬。考慮到行動裝置 SoC 的有效頻寬只有數十 GB/s,而且還得與 CPU 爭搶,這並不是可以忽略的量。此外也請注意以下幾點。
- MSAA 會乘上倍率。若將 4xMSAA 的顏色緩衝區不經 Resolve 直接 Store,資料量會變成 4 倍(MSAA 與儲存的關係將在「無記憶體(memoryless)」一節說明)。
- 載入與儲存兩者都要計算。每跨越一個通道,就會成對產生「前一個通道的 Store+下一個通道的 Load」。
- 若在後續通道中對儲存的結果進行取樣,(未命中快取的部分)還會產生額外的讀取。
建議針對開發中遊戲的渲染管線,調查一次每個影格有多少 MB 在圖塊記憶體與主記憶體之間往返。只要在 Render Graph Viewer 中確認各通道的附件與動作,再套用上表相乘,就能看出該優先削減哪個通道。
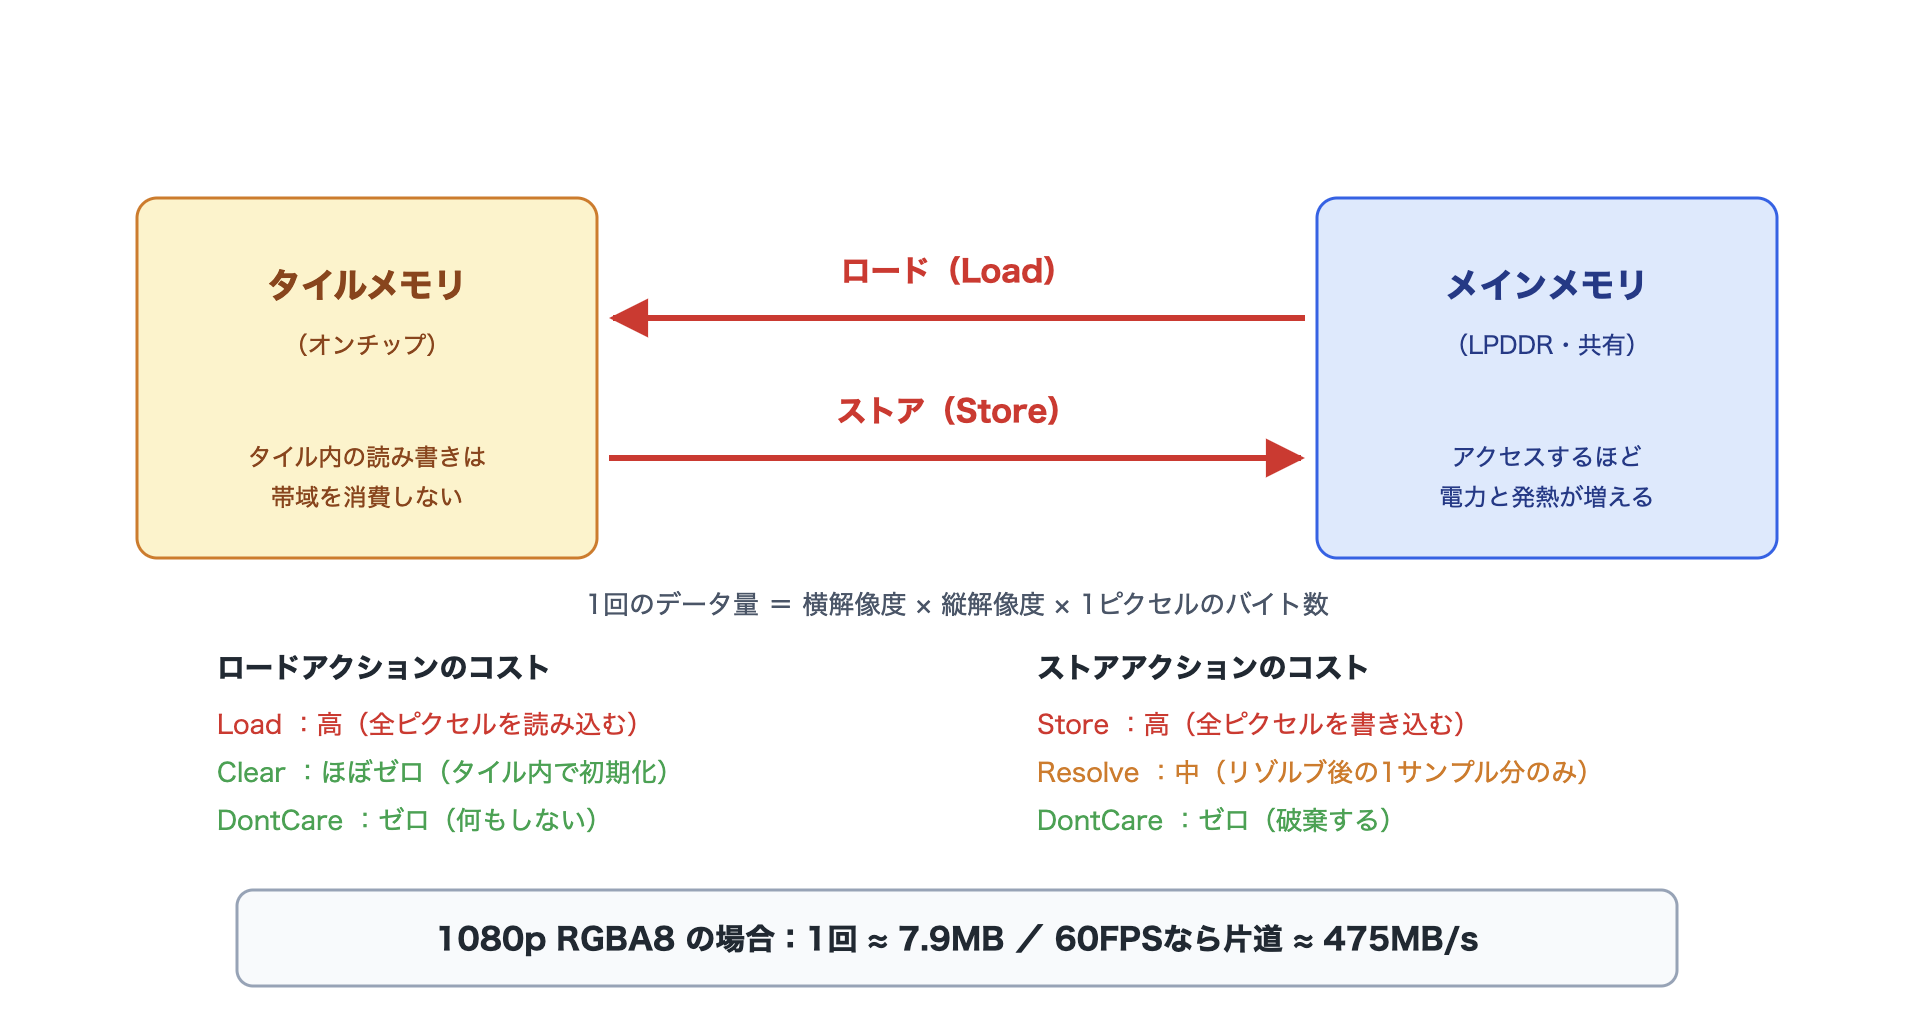
圖 1.7: 圖塊記憶體⇔主記憶體的載入/儲存與頻寬成本
1.2.3. 以 AccessFlags 宣告資源用途
那麼,在 Render Graph 中要如何指定這些載入/儲存動作呢?其實,Render Graph 並不直接指定載入/儲存動作。而是在新增通道時向 builder 宣告資源的使用方式,再由 Render Graph 根據該資訊決定動作。此時用來宣告的就是AccessFlags。
清單 1.1: 以 AccessFlags 宣告資源
1 2 3 4 5 6 7 8 9 10 | public override void RecordRenderGraph(RenderGraph renderGraph, ContextContainer frameData) { using (var builder = renderGraph.AddRasterRenderPass<PassData>("Example", out var passData)) { // 宣告輸出附件。 // AccessFlags.WriteAll = 此通道會寫入全部像素(不需要先前的內容) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); ... } } |
AccessFlags的主要值及其意義如下。
| AccessFlags | 意義 | 對動作的影響 |
|---|---|---|
| Read | 讀取先前的內容 | 載入動作成為 Load |
| Write | 寫入(可能只有部分像素) | 需要保留先前的內容,載入可能成為 Load |
| ReadWrite | 讀寫兩者 | 載入成為 Load |
| Discard | 先前的內容可以捨棄 | 載入可設為 DontCare |
| WriteAll | 寫入全部像素(Write + Discard) | 載入可設為 DontCare |
這裡要特別注意 Write 與 WriteAll 的差異。單純的Write是「可能只寫入部分像素」的宣告,因此 Render Graph 為了保留未被寫入的像素內容,只能將載入動作設為 Load。像全螢幕 Blit 這類必定覆寫全部像素的通道,請指定WriteAll。以 1080p 的 RGBA8 為例,光是這個指定的差異,就決定了每個影格是否會產生約 8MB 的載入。另一方面,決定儲存動作的,是該資源是否會在後續通道中被使用。這不是由開發者指定,而是由 Render Graph 綜觀整個圖來判斷。下一項就來看看這些規則。
1.2.4. Render Graph 決定動作的規則
Render Graph 在根據所有已記錄通道的資源使用資訊建構 Native Render Pass 時,會決定各附件的載入/儲存動作。判斷規則整理如下。
載入動作的決定
| 條件 | 決定的動作 |
|---|---|
| 以 AccessFlags.WriteAll(或 Discard)宣告 | DontCare |
| 資源的首次使用,且要求清除 | Clear |
| 對先前內容有讀取/部分寫入 | Load |
儲存動作的決定
| 條件 | 決定的動作 |
|---|---|
| 後續任何通道都不會使用 | DontCare |
| 後續通道以 UseTexture(作為紋理)使用 | Store |
| 僅被後續通道以 SetInputAttachment(輸入附件)使用,且已合併至同一 Native Render Pass 中 | DontCare(在圖塊記憶體內傳遞) |
| 被設定為全域紋理 | Store(後續用途對 Render Graph 不可見,因此保守地儲存) |
| 有 MSAA 的解析目標 | Resolve |
從這些規則可以導出 2 項實務上的指引。
- 將紋理設為全域應是最後手段。透過
SetGlobalTextureAfterPass等方式設為全域的紋理,Render Graph 將無法追蹤其使用狀況,因此會一律儲存,也會被排除在無記憶體(memoryless)化的範圍之外。若養成「先設成全域再說」的寫法,最佳化就會失效。 UseTexture與SetInputAttachment在頻寬方面是截然不同的兩回事。同樣是「讀取前一個通道的結果」,前者會產生儲存→取樣的往返,後者則可能在圖塊記憶體內完成(將在「Frame Buffer Fetch」一節詳述)。
匯入紋理的處理
以renderGraph.ImportTexture匯入RTHandle等由應用程式端管理的紋理時,Render Graph 並不知道該紋理在圖之外是如何使用的。因此,預設會保守處理(即使是首次使用也會載入,最後一次使用之後也會儲存)。匯入時傳入ImportResourceParams,即可放寬這種保守的行為。
清單 1.2: 匯入時的參數設定
1 2 3 4 5 6 | var importParams = new ImportResourceParams { clearOnFirstUse = true, // 首次使用時清除(載入可設為 Clear) discardOnLastUse = true, // 最後一次使用後可以捨棄(儲存可設為 DontCare) }; var handle = renderGraph.ImportTexture(_rtHandle, importParams); |
如果匯入的紋理「每個影格都會重新產生,不需要先前的內容」,請設定clearOnFirstUse/discardOnLastUse。另外,若是由 Render Graph 管理的紋理(以renderGraph.CreateTexture建立者),這些都會自動判斷。除了真正需要自行管理生命週期的紋理之外,原則上交給 Render Graph 管理即可。
解讀載入/儲存動作
了解規則之後,來實際解讀一個影格。用 Render Graph Viewer 觀察 URP 標準前向渲染的影格,可以觀察到如下的結構。
| 通道 | 附件 | Load | Store |
|---|---|---|---|
| MainLightShadow | 陰影貼圖(深度) | Clear | Store |
| DrawOpaqueObjects | 相機顏色 | Clear | (視後續而定) |
| 相機深度 | Clear | (視後續而定) | |
| DrawTransparentObjects | 相機顏色 | (合併時延續) | Store |
| FinalBlit | 後端緩衝區 | DontCare | Store |
解讀的重點如下。
- 陰影貼圖是「先繪製,之後再取樣」的東西,因此只能是 Store。這是無法削減的儲存。
- 若不透明→半透明已合併為 1 個 Native Render Pass,其間就不會產生相機顏色的儲存/載入。反之,若中間夾了其他東西而使合併中斷,該處就會產生往返。
- 也請注意相機深度的儲存動作。開啟 Depth Texture 後,相機深度就會被 Store。著色器或後處理並未要求
_CameraDepthTexture,卻只是把設定開著,這是實際專案中常見的浪費。
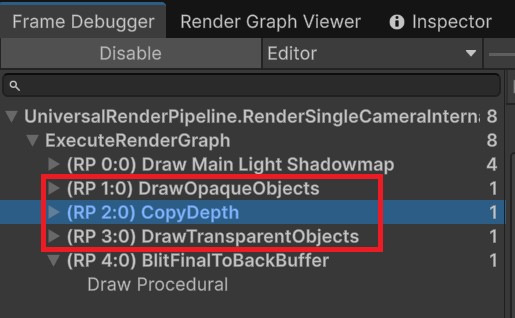
圖 1.8: Copy Depth 將 Draw Opaque Objects 與 Draw Transparent Objects 分隔開
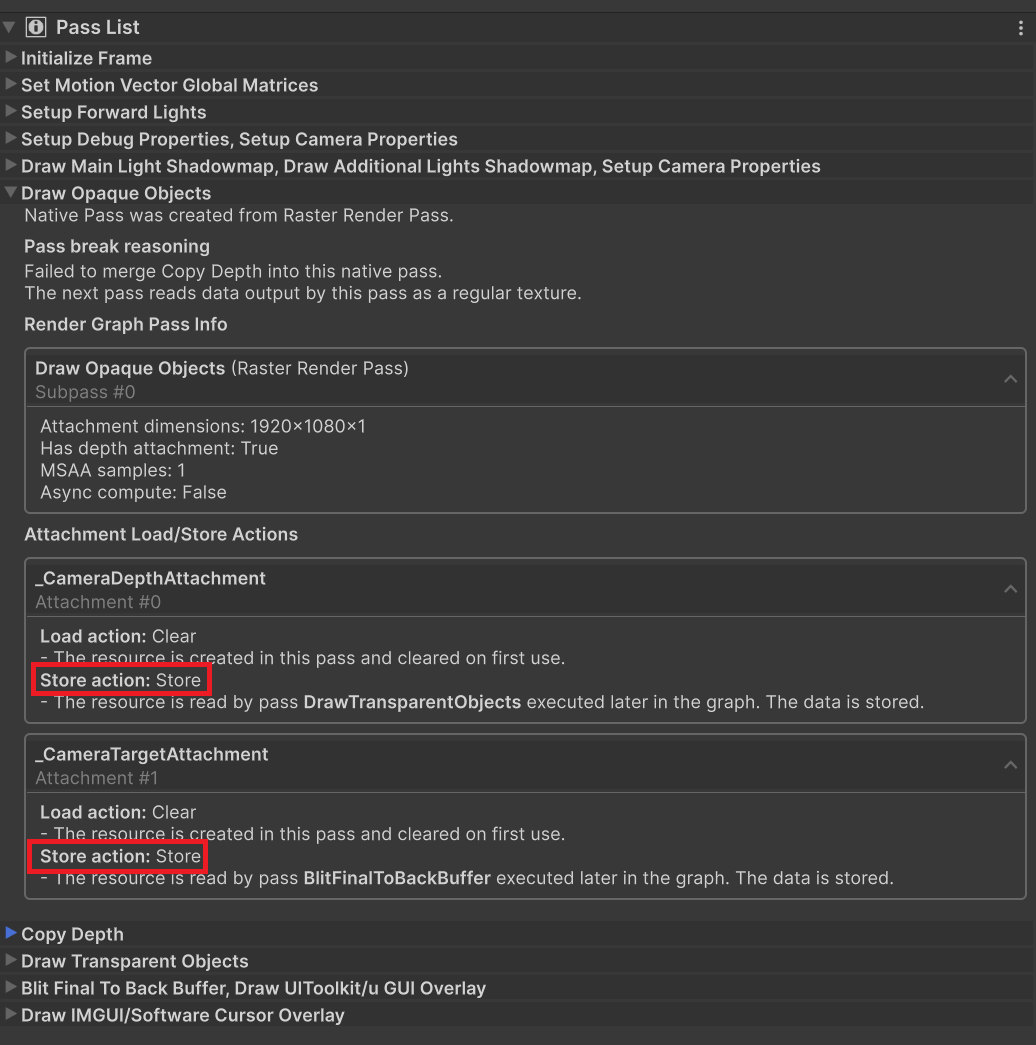
圖 1.9: 因為被分隔,Draw Opaque Objects 結束時會 Store
像這樣逐一確認各附件的 Store 是否有正當理由(後續的使用),就是圖塊記憶體最佳化的基本流程。
1.2.5. 以 AccessFlags 削減的範例
最後,以實際案例確認光是AccessFlags的指定就會改變動作。在執行全螢幕 Blit 的通道中,比較將輸出附件宣告為Write與宣告為WriteAll的情況。
清單 1.3: AccessFlags 的 Write 與 WriteAll 的比較
1 2 3 4 5 | // 模式 A:Write(不宣告寫入全部像素) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.Write); // 模式 B:WriteAll(宣告寫入全部像素) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); |
兩者的繪製結果相同。但在 Render Graph Viewer 中確認後會發現,模式 A 的載入動作為Load,模式 B 則為DontCare。由於是全螢幕 Blit,載入的內容會被全部像素覆寫而丟棄。也就是說,模式 A 的載入是白費的。
1.3. Render Pass / Subpass
到此為止,我們已了解通道與通道之間的儲存→載入往返是一種成本。本節說明用來消除這項成本的機制 Render Pass/Subpass,以及 Render Graph 的通道合併。
1.3.1. 資源相依性與 DAG
完成遊戲畫面所需的 1 個影格的工序稱為渲染管線,構成它的每一個處理稱為渲染通道。每個通道都具有「讀取哪些資源、寫入哪些資源」的資源相依性。例如,包含延遲渲染的典型幾何繪製具有如下的相依關係。
- 以深度預通道建立深度緩衝區
- 將不透明物件繪製到 G-Buffer(使用深度緩衝區)
- 對不透明緩衝區進行延遲光照(使用 G-Buffer 與深度緩衝區)
- 將半透明物件繪製到半透明緩衝區(使用深度緩衝區)
- 合成不透明緩衝區與半透明緩衝區並繪製到影格緩衝區
以通道為節點、資源相依性為邊來繪製,這個管線就成為有向無環圖(DAG: Directed Acyclic Graph)。第 4 個通道沒有使用第 2、3 個通道的輸出,因此只要將相依性告知 GPU,就能平行執行。
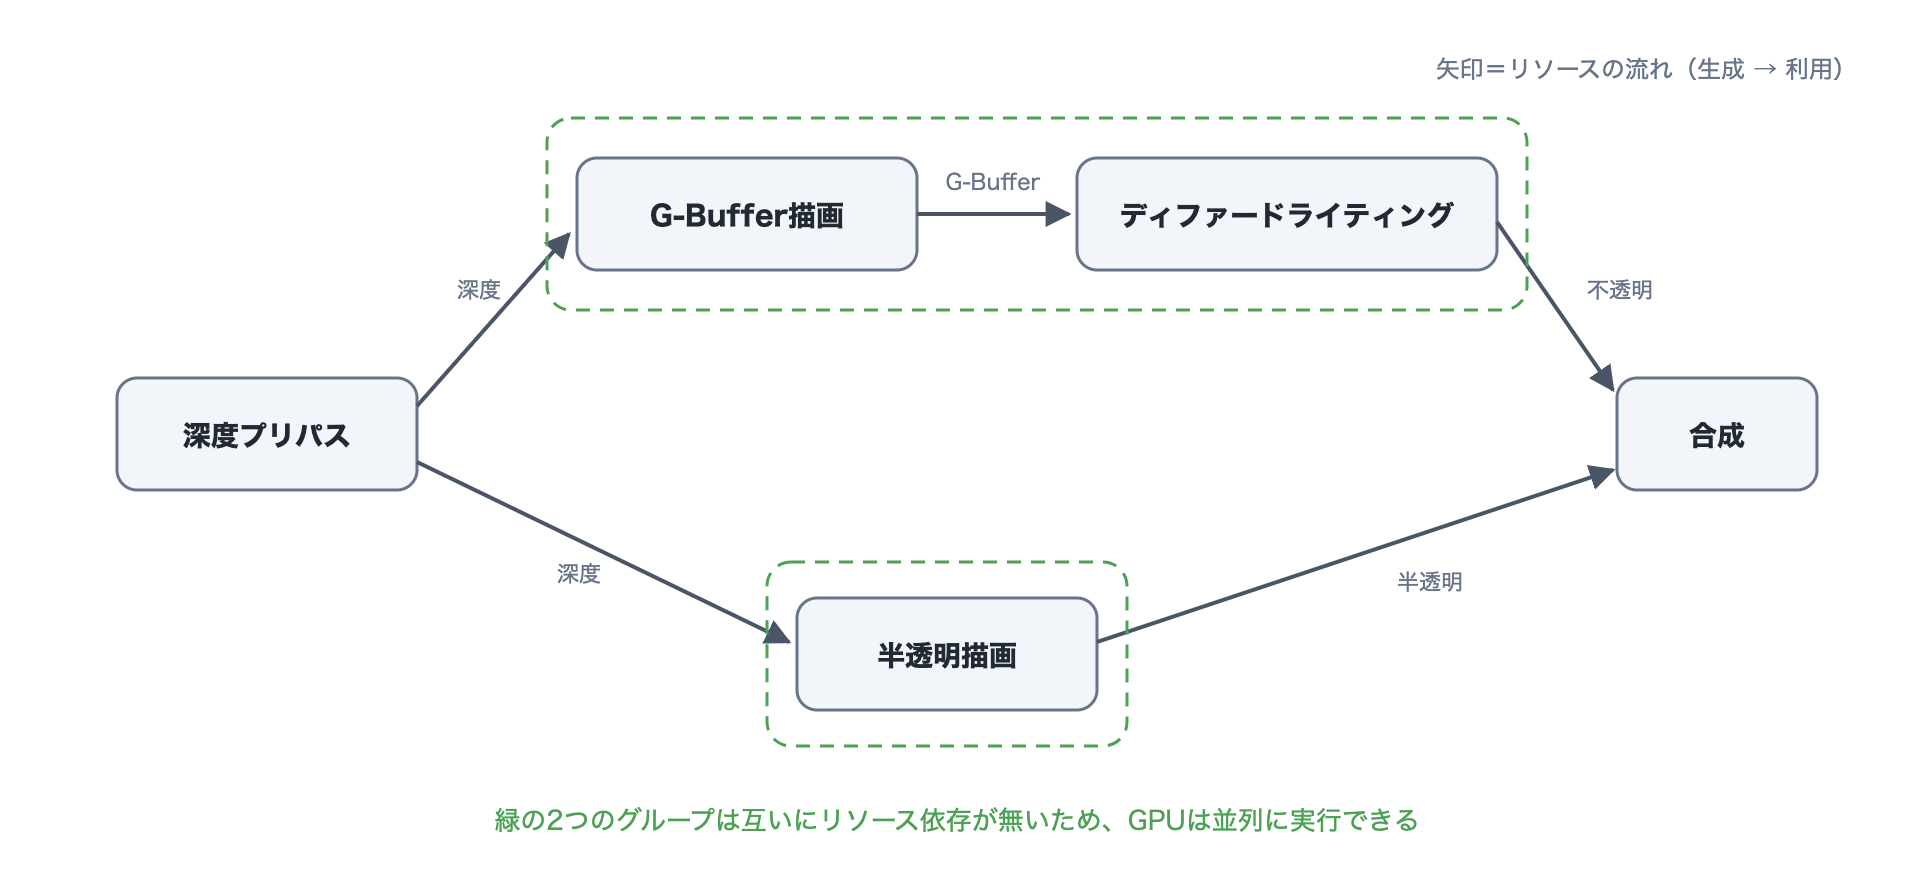
圖 1.10: 渲染通道的 DAG 與平行化
Render Graph 名稱中的「Graph」指的就是這個 DAG。Render Graph 是一個收集通道的資源相依性以建構 DAG,並據此擬定執行計畫的系統。
1.3.2. Vulkan 的 RenderPass/Subpass
作為將資源相依性告知 GPU 的機制,Vulkan 有 RenderPass/Subpass 的概念。Render Graph 最終建構的就是這個 Vulkan 的 RenderPass,因此這裡稍微談一下 API 層級的內容。Vulkan 的 RenderPass 由以下要素組成。
- 附件:RenderPass 中使用的渲染目標的宣告。每個附件都要指定
loadOp(載入動作)與storeOp(儲存動作)。前一節「圖塊記憶體的載入/儲存」所看到的動作,其真面目就是這個。 - 子通道:RenderPass 內的繪製單位。每個子通道宣告其輸出附件(顏色/深度)與輸入附件。
- 子通道相依性:子通道之間執行順序與記憶體相依關係的宣告。
這裡有 2 個要掌握的性質。
- 載入/儲存只在 RenderPass 的邊界發生,子通道之間不會發生。也就是說,只要能將多個處理組成同一個 RenderPass 的子通道,其間的中間結果就會留在圖塊記憶體中。
- 使用輸入附件,可以讀取前一個子通道的結果,但僅限於同一像素位置。這就是下一節要談的 Frame Buffer Fetch 在 API 上的樣貌。
以 RenderPass/Subpass 來表示前述的幾何繪製,會是如下的形式。
- 幾何繪製(RenderPass)
- 深度預通道(Subpass) ― 輸出:深度
- G-Buffer 繪製(Subpass) ― 輸入:深度 / 輸出:G-Buffer
- 延遲光照(Subpass) ― 輸入:G-Buffer / 輸出:不透明緩衝區
- 半透明繪製(Subpass) ― 輸入:深度 / 輸出:半透明緩衝區
- 合成(Subpass) ― 輸入:不透明、半透明緩衝區 / 輸出:影格緩衝區
在這種配置下,深度、G-Buffer、不透明緩衝區、半透明緩衝區全都是子通道之間的傳遞,跨越 RenderPass 邊界的只有最終輸出的影格緩衝區。原本可能產生 5 次儲存的配置,變成只需 1 次儲存。順帶一提,Metal 也有同等的機制。Metal 的 Render Pass 具有載入/儲存動作,可從片段函式直接讀取圖塊記憶體上的顏色附件(以及圖塊著色器)。雖然沒有像 Vulkan 那樣明確的 Subpass 宣告,但Render Graph 所進行的最佳化在 Metal 上同樣有效。
1.3.3. Unity 的 Native Render Pass
那麼,Render Graph 是如何處理這個 Vulkan 的 RenderPass/Subpass 的呢?首先要掌握的是,以AddRasterRenderPass新增的通道並不會直接成為子通道。以RecordRenderGraph新增的通道,終究只是 Render Graph 的邏輯通道。Render Graph 在影格內所有通道記錄完畢後,會在編譯工序中進行以下處理。
- 根據資源相依性建構 DAG,並剔除不需要的通道(剔除)
- 將相鄰通道中符合條件者合併為 1 個 Native Render Pass(相當於 Vulkan 的 RenderPass),並讓合併後的各通道成為子通道
- 決定各附件的載入/儲存動作(參照前一節的「Render Graph 決定動作的規則」)
- 將可行的資源無記憶體(memoryless)化(「無記憶體(memoryless)」一節)
也就是說,開發者的工作不是手動組裝子通道,而是以可合併的形式設計通道,並正確宣告資源的使用方式。合併是否成功,則透過 Frame Debugger 的(RP n:m)標記與 Render Graph Viewer 來確認。
1.3.4. 通道合併的條件
整理 Render Graph 合併通道的條件。
- 兩者都是 Raster Render Pass。
AddComputePass與AddUnsafePass不會被合併。若 Raster 通道序列之間夾了 Compute 通道,Native Render Pass 就會在該處中斷。 - 通道是連續記錄的。合併只在圖上相鄰的通道之間進行。
- 輸出附件的解析度一致。若改變中間緩衝區的解析度(降採樣),該邊界就無法合併。
- MSAA 取樣數一致。
- 後一個通道沒有將前一個通道的輸出作為紋理使用。以
UseTexture使用會要求儲存→取樣,因此會妨礙合併。以SetInputAttachment(輸入附件)使用則不會妨礙合併。輸入附件與紋理是兩回事。 - 附件總數未超過上限(8 個)。合併後的 Native Render Pass 所使用的附件總數有上限。
- 沒有設為全域紋理等脫離 Render Graph 追蹤的用法。
只要有 1 項條件不滿足,該通道就會成為單獨的 Native Render Pass。未被合併的理由會顯示在 Render Graph Viewer 的 Pass Break Reasoning 中,因此未合併時請先確認該處。
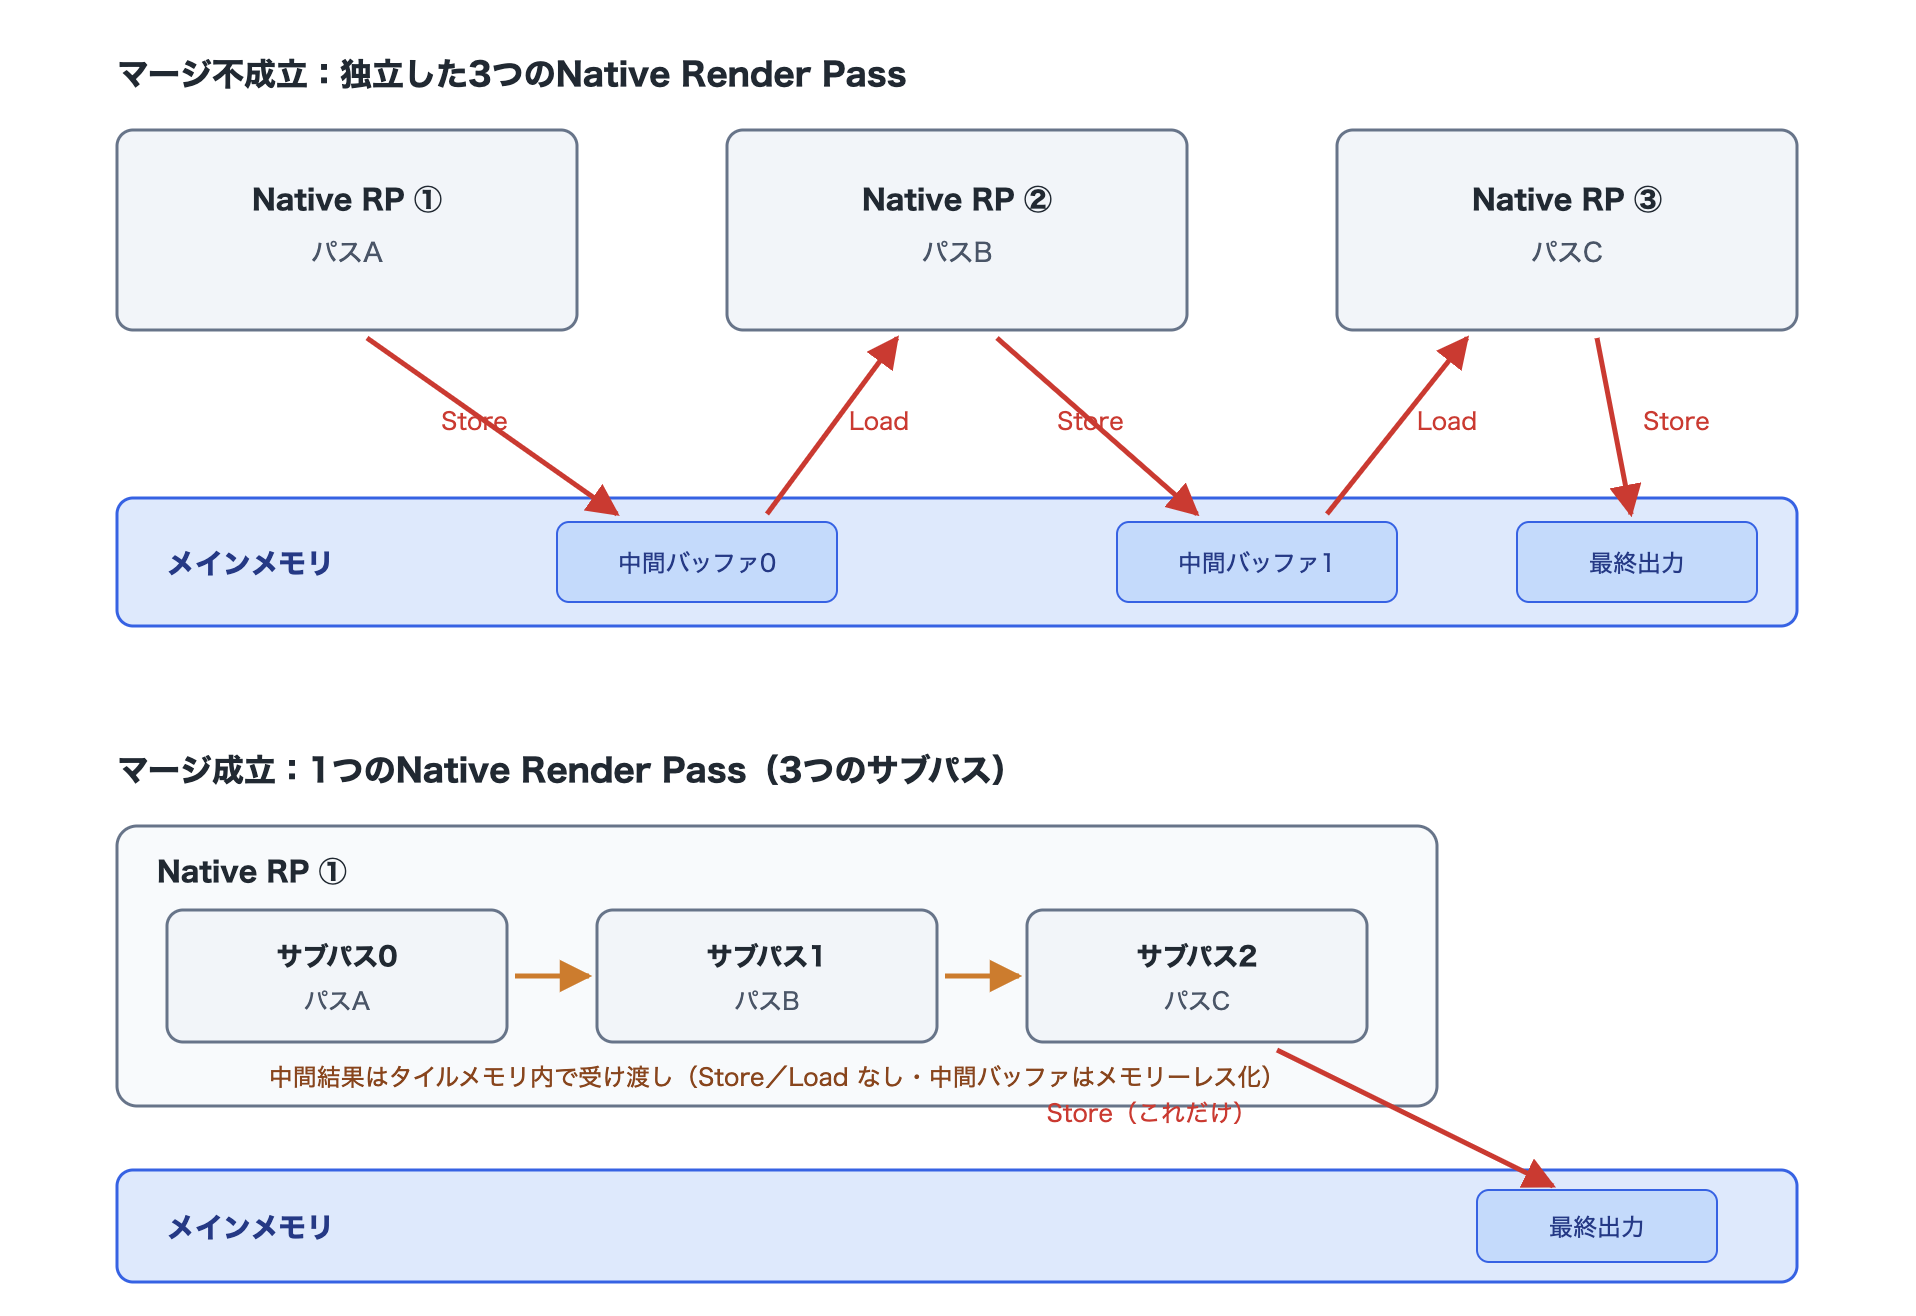
圖 1.11: 合併前後的 Native Render Pass 結構比較
1.4. Frame Buffer Fetch
我們已了解,滿足條件即可將通道合併為 1 個 Native Render Pass。本節說明在已合併的子通道之間,直接從圖塊記憶體讀取前一個子通道結果的技術:Frame Buffer Fetch(以下簡稱 FBF)。
1.4.1. 什麼是 Frame Buffer Fetch
以建立 G-Buffer 後進行光照的延遲渲染為例來思考。若以簡單的方式實作,處理流程如下。
- 建立 G-Buffer(將反照率、法線、材質資訊寫入圖塊記憶體)
- 將反照率、法線、材質資訊儲存至主記憶體
- 將已儲存的 G-Buffer 作為紋理取樣,進行延遲光照
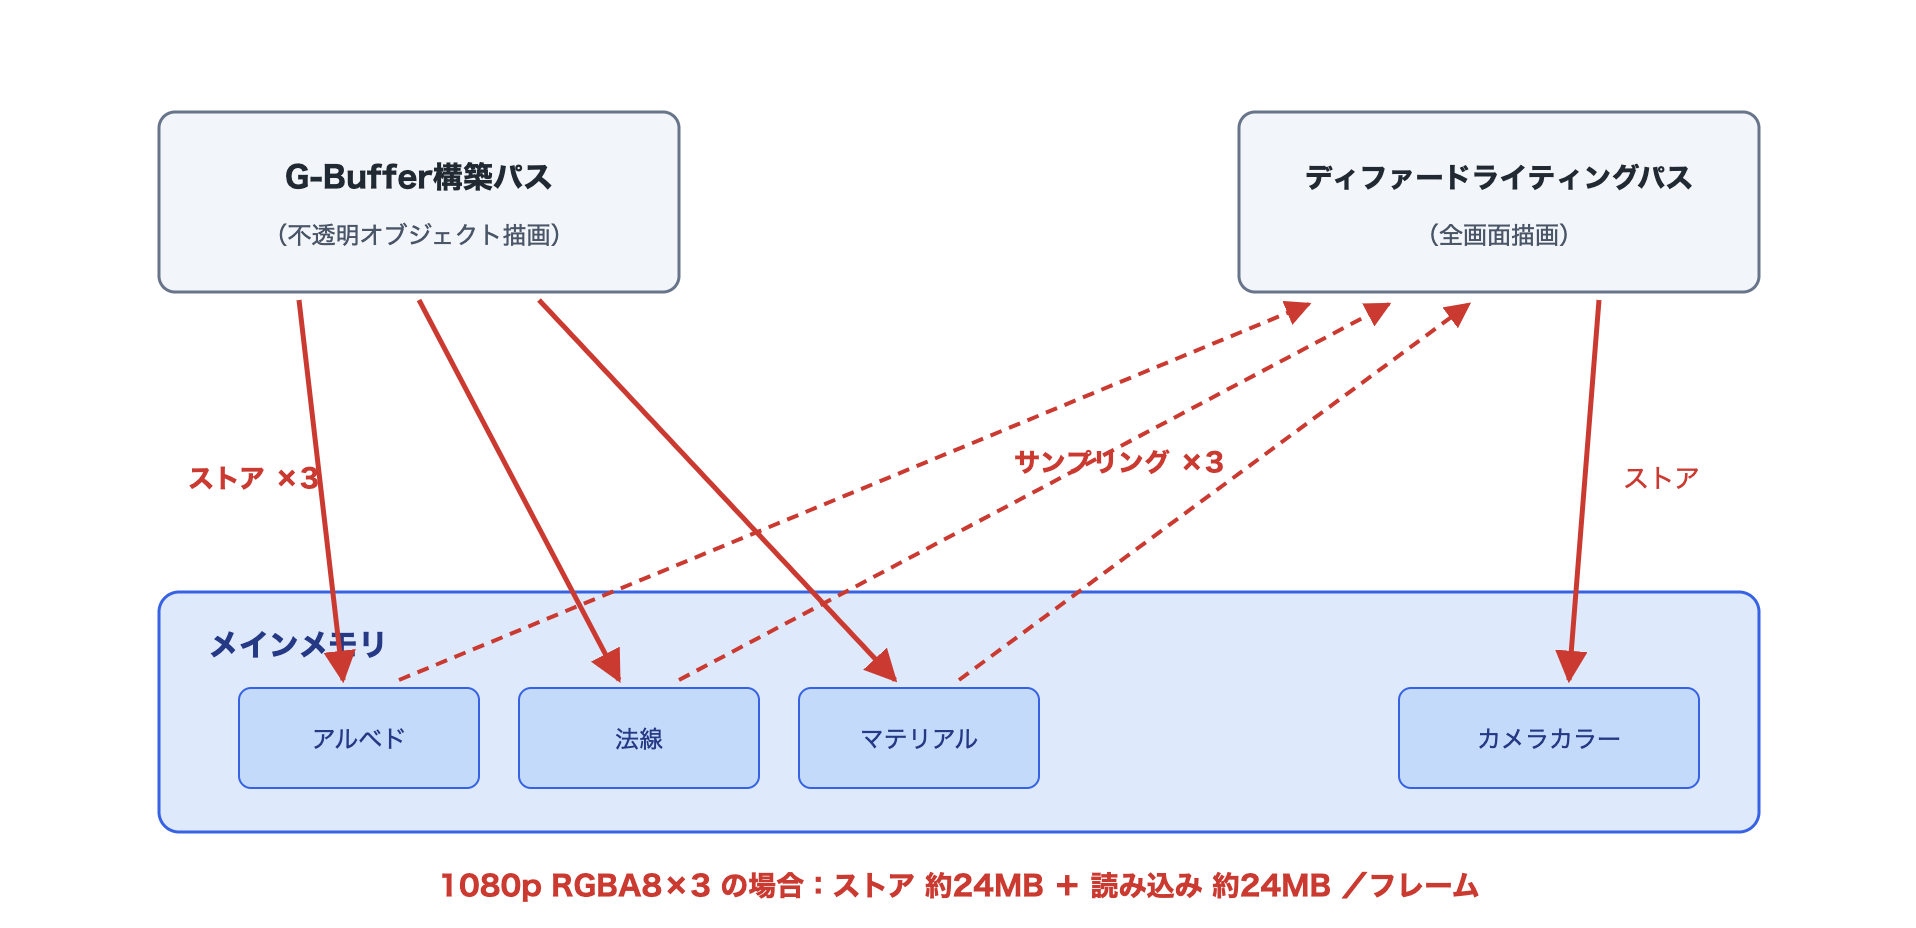
圖 1.12: 簡單延遲渲染的資料流
這裡產生了一個疑問。光照通道想讀取的是「目前正在處理的像素」的 G-Buffer 值。而這個值,前一個通道才剛寫入同一個圖塊的圖塊記憶體。難道不能不經主記憶體往返,直接從圖塊記憶體讀取嗎?讓這件事成為可能的就是 FBF。使用 FBF 後,處理流程如下。
- 建立 G-Buffer(寫入圖塊記憶體)
- 直接從圖塊記憶體讀取 G-Buffer,進行延遲光照
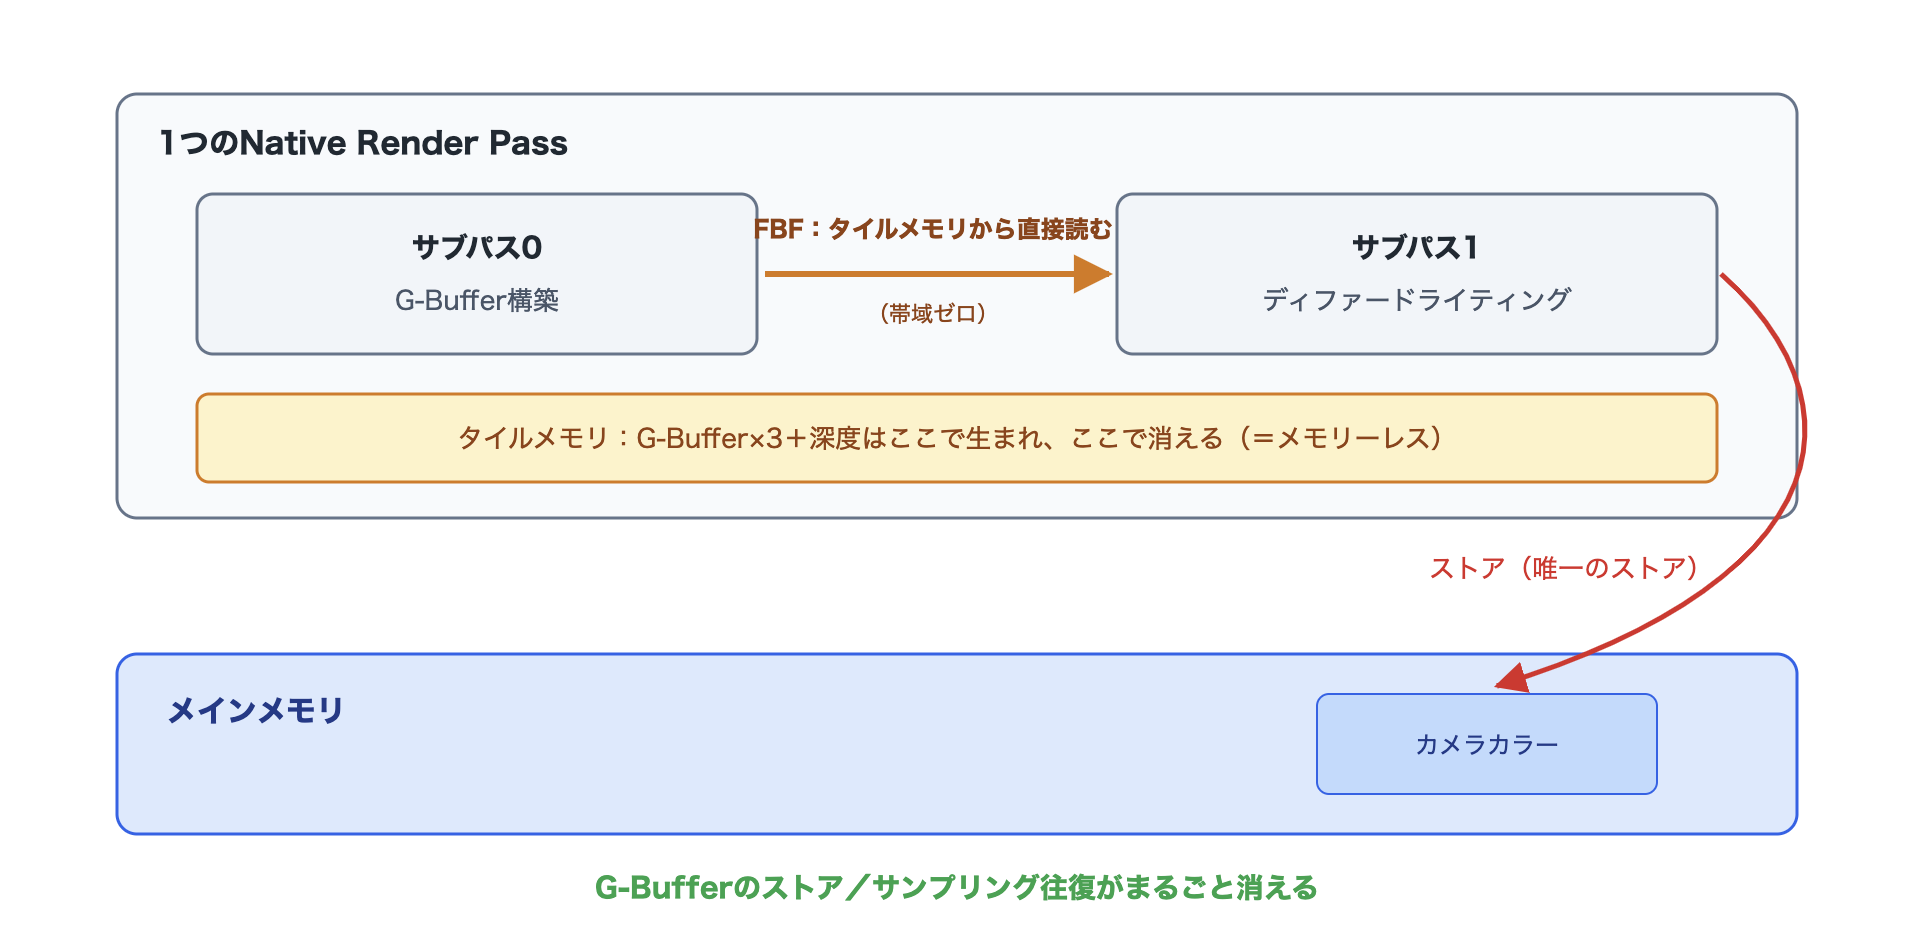
圖 1.13: 使用 Frame Buffer Fetch 的延遲渲染資料流
3 張 G-Buffer 的儲存,以及為了取樣它們所需的讀取都消失了。若是 1080p 的 RGBA8×3 張,光是儲存就能削減約 24MB/影格,在 60FPS 下約 1.4GB/s 的頻寬。在 API 層級,FBF 是以前一節「Vulkan 的 RenderPass/Subpass」提到的 Vulkan 輸入附件(在 Metal 中為直接讀取顏色附件)來實現。因此,FBF 只能用於同一 Render Pass 內的子通道之間。通道已合併是 FBF 的前提條件。
1.4.2. 理解限制
FBF 不是紋理取樣的替代品。它有以下限制。
- 只能讀取與處理中片段相同的像素位置。圖塊記憶體中只有「目前正在處理的圖塊」的內容,因此偏移取樣(讀取周邊像素)在原理上不可能。
- 無法使用濾波與 mipmap。只能載入單一的值。
- 輸入側與輸出側的解析度必須一致(這也是合併條件)。
來看一個限制 1 發揮作用的實際案例。考慮「在黑白/懷舊色調合成的結果上,再疊加扭曲 UV 的雜訊處理」。雜訊處理的著色器會如下偏移 UV 後取樣。
清單 1.4: 雜訊處理著色器
1 2 3 4 5 | // 使用雜訊扭曲 UV float2 distortedUV = input.texcoord + noise * 0.02; // 以扭曲後的 UV 對紋理取樣。 // 因為載入位置與片段位置不同,無法使用 Frame Buffer Fetch。 half4 color = SAMPLE_TEXTURE2D_X(_BlitTexture, sampler_LinearClamp, distortedUV); |
由於想讀取的位置與處理中片段的位置不同,這個通道無法使用 FBF。合成結果必須以UseTexture宣告,合成通道與雜訊通道之間會產生儲存→取樣的往返。因此,在設計特效的階段就先確認「這個通道是否只讀取同一像素?」,就能及早判斷能否使用 FBF。只需同一像素即可完成的處理(色調映射、調色、合成、延遲光照)是 FBF 的候選,而需要讀取周邊的處理(模糊、扭曲、Bloom)則採用紋理方式。
1.4.3. 著色器 API 的內部
要從 Unity 的著色器使用 FBF,需使用 SRP Core 提供的巨集。
清單 1.5: Frame Buffer Fetch 的使用方式
1 2 3 4 5 6 7 8 9 | // 宣告第 0 號輸入附件 FRAMEBUFFER_INPUT_X_HALF(0); half4 frag(Varyings input) : SV_Target { // 從第 0 號輸入附件載入處理中片段位置的值 half4 color = LOAD_FRAMEBUFFER_X_INPUT(0, input.positionCS.xy); ... } |
巨集依精度與用途有不同的變體。
| 宣告巨集 | 載入巨集 | 用途 |
|---|---|---|
| FRAMEBUFFER_INPUT_HALF(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | half 精度的顏色 |
| FRAMEBUFFER_INPUT_FLOAT(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | float 精度 |
| FRAMEBUFFER_INPUT_X_HALF(n) | LOAD_FRAMEBUFFER_X_INPUT(n, pos) | 支援 XR(單通道實例化)的版本 |
帶_X的變體與TEXTURE2D_X系列巨集相同,是對應 XR 渲染目標陣列的版本。在可能支援 XR 的專案中,統一使用帶_X的版本會比較安全。了解這些巨集在各平台會展開成什麼,有助於理解其行為與 fallback。
| 平台 | 展開結果 | 實體 |
|---|---|---|
| Vulkan | subpassInput + subpassLoad | Render Pass 的輸入附件 |
| Metal | 透過 [[color(n)]] 屬性讀取顏色附件 | 直接讀取圖塊記憶體 |
| OpenGL ES | GL_EXT_shader_framebuffer_fetch 等擴充(僅支援的 GPU) | 不支援擴充時使用下方的 fallback |
| 不支援的環境 | 一般紋理(_UnityFBInput0 等)+ 載入指令 | 不構成 FBF,成為一般的紋理讀取 |
要注意的是最後一列。巨集在不支援的環境下也會 fallback 使其能夠運作,但此時沒有削減頻寬的效果。也就是說,能運作並不代表 FBF 有生效。效果是否出現,請透過 Render Graph Viewer 的動作顯示(輸入側緩衝區的儲存是否為 DontCare)與實機的頻寬測量來確認。
1.4.4. SetInputAttachment 與 UseTexture 的差異
在 C# 端,以SetInputAttachment宣告要用 FBF 讀取的資源。
清單 1.6: 輸入附件的宣告
1 2 3 4 5 6 7 8 9 | using (var builder = renderGraph.AddRasterRenderPass<PassData>("Lighting", out var passData)) { builder.SetRenderAttachment(cameraColor, 0, AccessFlags.Write); // 對應著色器的 FRAMEBUFFER_INPUT_X_HALF(0) builder.SetInputAttachment(gBufferAlbedo, 0); // 對應 FRAMEBUFFER_INPUT_X_HALF(1) builder.SetInputAttachment(gBufferNormal, 1); ... } |
SetInputAttachment的第 2 個引數的索引,對應著色器端FRAMEBUFFER_INPUT_X_HALF(n)的n。這裡以表格整理一下它與從「圖塊記憶體的載入/儲存」一節起反覆出現的UseTexture之間的差異。
| 項目 | UseTexture | SetInputAttachment |
|---|---|---|
| 可讀取的位置 | 任意 UV(可偏移、濾波、mip) | 僅處理中的片段位置 |
| 與前一個通道的合併 | 妨礙 | 不妨礙 |
| 前一個通道輸出的儲存 | 強制為 Store | 合併成立時可設為 DontCare |
| 頻寬成本 | 儲存+取樣讀取 | 零(在圖塊記憶體內完成) |
| 著色器端的讀取方式 | SAMPLE_TEXTURE2D 系列 | LOAD_FRAMEBUFFER 系列 |
1.4.5. 深度的 Fetch
不只顏色,深度也在圖塊記憶體上。若能 Fetch 深度,軟粒子、貼花、霧效等「參照場景深度的處理」也有可能消除_CameraDepthTexture的儲存→取樣往返。SRP Core 提供了處理深度用輸入附件的巨集群,但將深度附件作為輸入,是容易受平台與 URP 版本限制的領域。在驗證結果出爐之前,本章推薦的是以下確實可行的替代方案。作為替代方案,可以將深度寫入顏色附件再 Fetch。在建構 G-Buffer 的子通道中,將線性化後的深度值寫入顏色附件的 1 個 channel(R16_Float 等),在後續子通道中以 FBF 讀取。雖然附件會多 1 個,但只要無記憶體(memoryless)化,實際的記憶體成本就是零,而且能確實消除深度紋理的儲存往返。
1.4.6. 平台差異與陷阱
最後,整理使用 FBF 時應確認的平台差異。
| 環境 | FBF 的使用 | 備註 |
|---|---|---|
| Vulkan (Adreno) | ○ 輸入附件 | 廣泛支援。驅動程式品質依裝置而異 |
| Vulkan (Mali) | ○ 輸入附件 | 廣泛支援 |
| Vulkan (IMG / Pixel 10) | ○ 輸入附件 | TBDR 系。注意驅動程式特有的行為差異(最後一節的「GPU 廠商差異」) |
| Metal (Apple) | ○ 讀取顏色附件 | 穩定運作 |
| OpenGL ES | △ 依賴擴充 | 僅限支援 GL_EXT_shader_framebuffer_fetch 的 GPU。不支援時 fallback |
| 編輯器 (D3D 等) | × fallback 動作 | 以一般紋理運作。可確認動作但無法測量效果 |
特別要注意的有以下 3 點。
- 在編輯器中看不到效果。由於 fallback 會正確地繪製出來,請以「唯有在實機上測量才能看出差異」為前提來安排工作流程。
- 併用 MSAA 時容易卡在合併條件(取樣數一致)。啟用 MSAA 的相機顏色與未使用 MSAA 建立的中間緩衝區無法合併。中間緩衝區的 TextureDesc 請像
GetTextureDesc(cameraColor)那樣從原始 Desc 複製,以繼承取樣數。 - 1 個子通道可讀取的輸入附件數有上限。附件總數 8 個的限制(前一節的「通道合併的條件」)也包含輸入側。設計 G-Buffer 時,請透過 channel 打包來節省數量。
1.5. 無記憶體(memoryless)
到此為止,中間緩衝區的載入與儲存都能消除了。這裡想思考一件事。既不載入也不儲存的緩衝區,需要主記憶體上的實體嗎?
1.5.1. 什麼是無記憶體(memoryless)
其實不需要。只在圖塊記憶體上使用、並在圖塊記憶體上銷毀的資源,根本不需要配置主記憶體。這種狀態稱為無記憶體(memoryless)。Vulkan/Metal 提供一種建立模式,可將資源建立為「只存在於圖塊記憶體(晶片內建記憶體),不持有主記憶體後備儲存」的資源(Vulkan 中為LAZILY_ALLOCATED記憶體,Metal 中為MTLStorageMode.memoryless)。指定為無記憶體(memoryless)的資源具有以下性質。
- 不消耗主記憶體(應用程式的記憶體占用減少)
- 載入動作不能指定 Load,儲存動作不能指定 Store(因為沒有可讀寫的實體)
也就是說,無記憶體(memoryless)是前面各節消除載入/儲存之後的結果。只要載入/儲存已消除就能無記憶體(memoryless)化;若無法無記憶體(memoryless)化,就表示某處仍殘留載入或儲存。
1.5.2. 成立條件
用前面的用語來描述某個資源可無記憶體(memoryless)化的條件,如下所示。
- 載入動作為 Clear 或 DontCare(不從主記憶體讀取先前的內容。即「以 AccessFlags 宣告資源用途」一項中的 WriteAll/Discard 宣告,或首次使用時的 Clear)
- 儲存動作為 DontCare(不會被後續通道作為紋理使用,也不會帶到下一個影格。參照「Render Graph 決定動作的規則」一項)
- 使用在 1 個 Native Render Pass 內完結(子通道之間的傳遞,也就是輸入附件/FBF 可以使用。即「Render Pass / Subpass」一節的合併、「Frame Buffer Fetch」一節的 FBF)
如您所見,這 3 項條件正是前面各節所說明的內容本身。
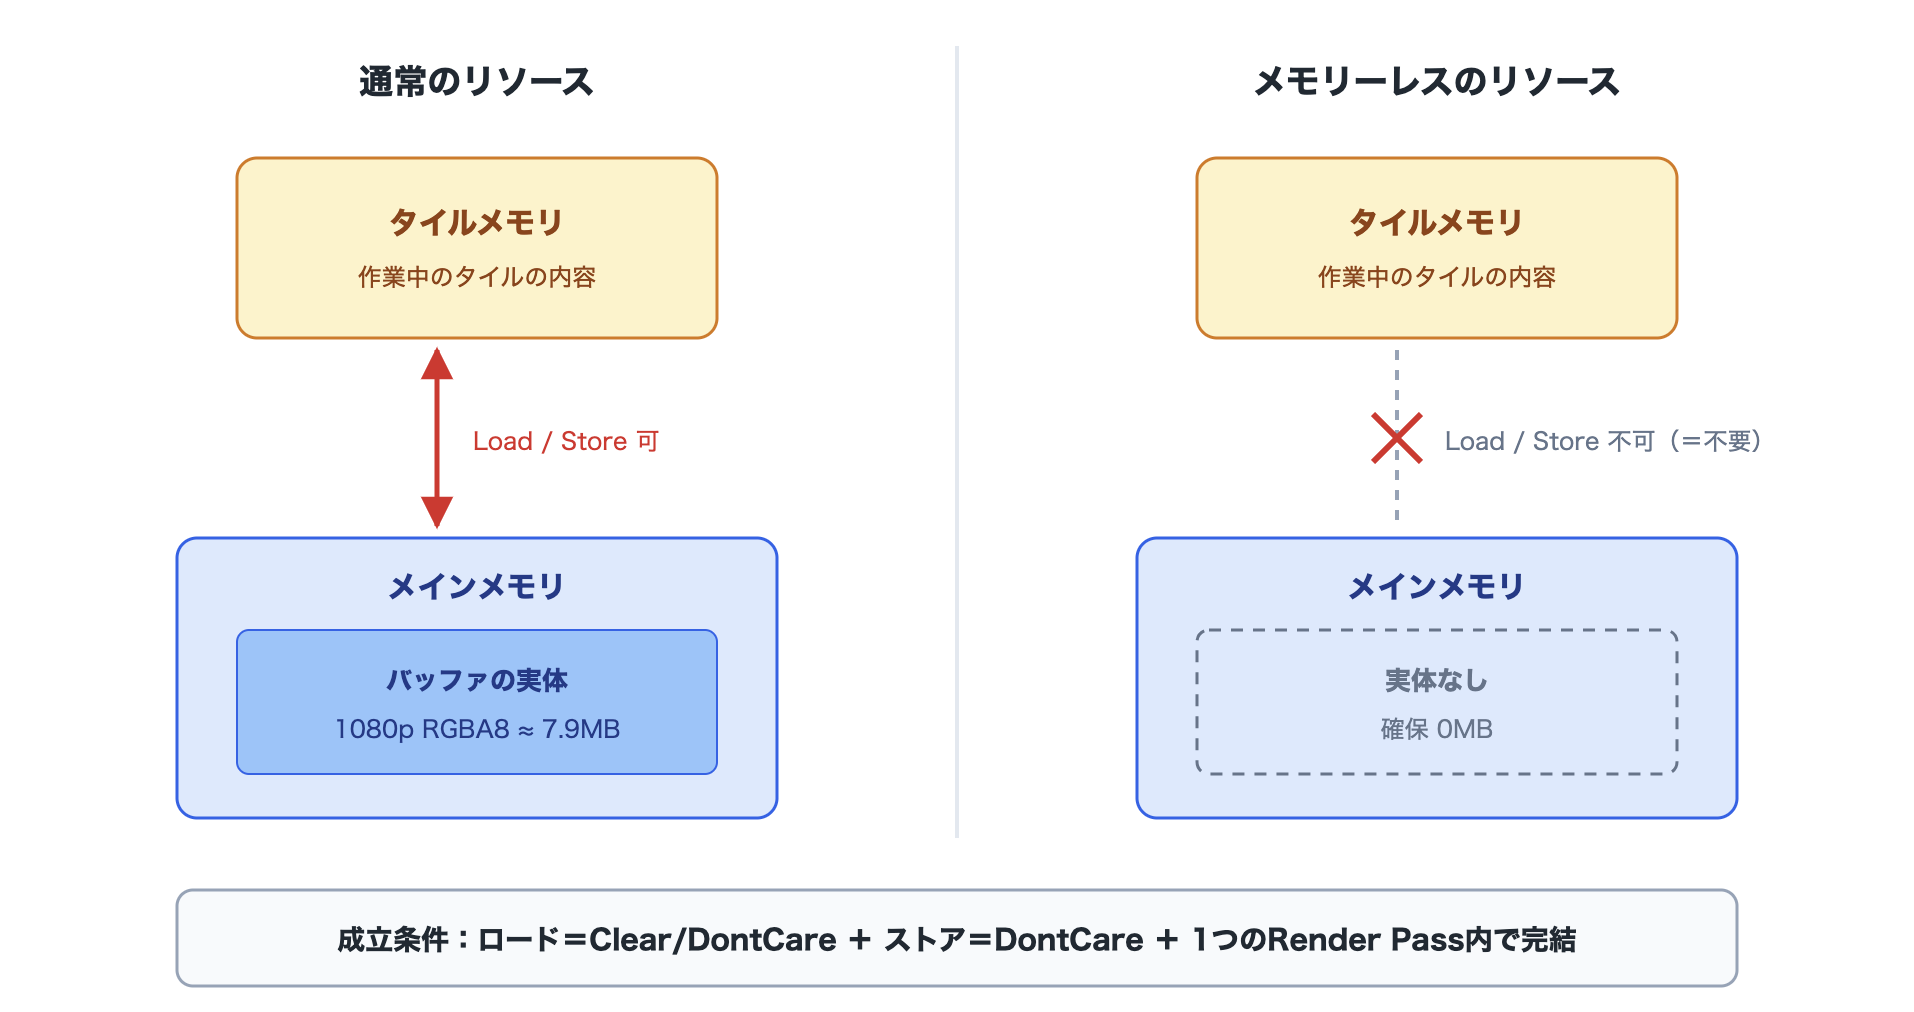
圖 1.14: 無記憶體(memoryless)化前後的記憶體配置圖比較
自動無記憶體(memoryless)化與明確指定
在 Unity 的 Render Graph 中,無記憶體(memoryless)透過 2 種途徑實現。
自動無記憶體(memoryless)化
當 Render Graph 管理的紋理(以renderGraph.CreateTexture建立)滿足「成立條件」一項的 3 項條件時,Render Graph 會自動將其無記憶體(memoryless)化。開發者不需要指定任何東西。是否已無記憶體(memoryless)化,可在 Render Graph Viewer 的 Resource List 中確認。
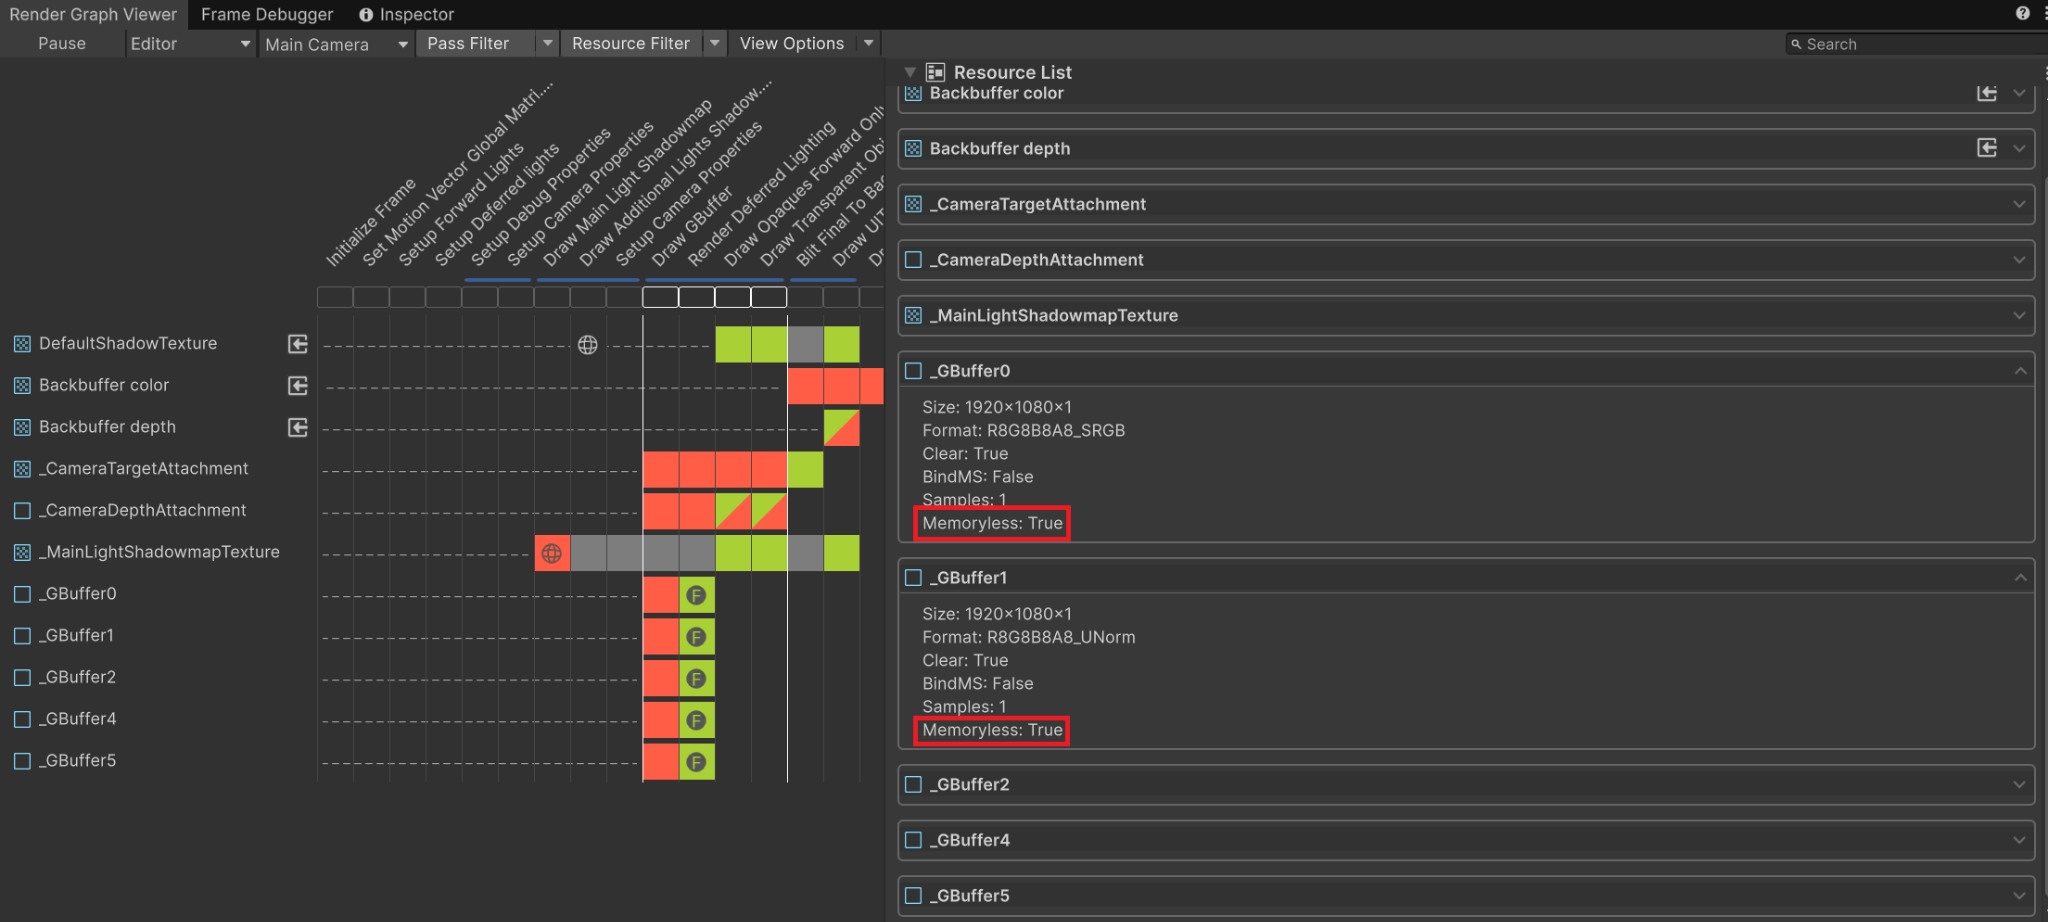
圖 1.15: Render Graph Viewer 中的 Memoryless 顯示
明確指定
也可以透過TextureDesc的memoryless欄位明確指定。
清單 1.7: 無記憶體(memoryless)的明確指定
1 2 3 4 | var desc = renderGraph.GetTextureDesc(universalResourceData.cameraColor); desc.memoryless = RenderTextureMemoryless.Color; // 指定無記憶體(memoryless) desc.name = "Intermediate Texture"; var handle = renderGraph.CreateTexture(desc); |
明確指定的優點是能將設計意圖留在程式碼中。若不小心在後續通道對指定為無記憶體(memoryless)的資源進行UseTexture,配置上的矛盾會在當下顯現。若交給自動處理,當重構時某處混入了UseTexture,就不會察覺無記憶體(memoryless)已失效(=記憶體用量與頻寬增加)。如果有「這個資源要在圖塊記憶體內完結」的設計意圖,建議以明確指定留在程式碼中。
1.5.3. 削減量的量化
無記憶體(memoryless)化的削減量可以透過計算求得。以下列出 1080p 下的代表性例子。
| 資源配置 | 計算 | 削減量 |
|---|---|---|
| RGBA8 中間緩衝區 1 個 | 1920×1080×4B | 約 7.9MB |
| RGBA16F 中間緩衝區 1 個 | 1920×1080×8B | 約 15.9MB |
| G-Buffer 3 個(RGBA8)+深度 | 7.9MB×4 | 約 31.7MB |
| 4xMSAA RGBA8 顏色 | 1920×1080×4B×4 | 約 31.7MB |
| 4xMSAA 深度(D32) | 1920×1080×4B×4 | 約 31.7MB |
如表所示,削減量大的是 MSAA 與 G-Buffer。特別是 4xMSAA,顏色加深度合計超過 60MB,能否消除這部分,對應用程式整體的記憶體預算影響相當大。另外,無記憶體(memoryless)削減的是「記憶體用量」,頻寬的削減則來自前面各節進行的載入/儲存削減。請注意兩者是不同的指標(由於無記憶體(memoryless)是載入/儲存削減的結果,實務上會一併達成)。
1.5.4. MSAA 渲染目標的無記憶體(memoryless)化
無記憶體(memoryless)效果最大的是 MSAA。先從機制看起。在 4xMSAA 中,圖塊記憶體上每個像素會保存 4 個取樣的顏色與深度。但最終顯示在畫面上的,只有將 4 個取樣平均(解析)後的 1 個取樣。此時儲存動作的選擇就發揮作用了。
- 選擇 Store,4 個取樣的資料會原封不動地寫出至主記憶體(頻寬 4 倍、記憶體 4 倍)。
- 選擇 Resolve,則在圖塊記憶體上進行解析,只寫出解析後的 1 個取樣。
在 TBR 的 GPU 上,解析幾乎可以在圖塊記憶體上零成本地完成。而且選擇 Resolve 時,4 個取樣的 MSAA 緩衝區本身不會被儲存,因此滿足無記憶體(memoryless)的條件。也就是說,正確配置的 MSAA 會是
- MSAA 顏色緩衝區(4 取樣) → 無記憶體(memoryless)(不配置主記憶體、不儲存)
- 解析目標緩衝區(1 取樣) → 一般的儲存
- MSAA 深度緩衝區(4 取樣) → 無記憶體(memoryless)+不儲存(後續不使用深度時)
這樣的配置。TBR 的 GPU 上 MSAA(相較於 IMR)被認為成本低,原因就在這裡。在 URP 中,啟用 Universal Render Pipeline 資產的 MSAA 設定後,Render Graph 會自動組成這種配置。該確認的是它有沒有被破壞。請在 Render Graph Viewer 中確認 MSAA 顏色緩衝區的儲存動作是否為 Resolve、Memoryless 是否為 yes。典型的破壞案例是後續通道將 MSAA 緩衝區本身作為紋理要求(自訂通道中的錯誤宣告、Opaque Texture 的配置錯誤等)。
1.5.5. GPU 廠商差異
本章探討的技術都建立在標準的 Vulkan/Metal 功能之上,在主要廠商的 GPU 上皆可運作。在此基礎上,若能掌握各廠商的特性差異,就更容易解讀測量結果與處理問題。
| 廠商 | 架構特性 | 注意事項 |
|---|---|---|
| Qualcomm Adreno | 基於 GMEM 的分箱。可能依繪製內容切換為直接模式(類 IMR 動作) | 切換為直接模式後,以圖塊記憶體為前提的最佳化效果會改變。請用 Profiler 確認處於哪種模式 |
| ARM Mali | 以 16×16 圖塊為基本的 TBR | 外部頻寬計數器完善,是本章頻寬測量的基準廠商 |
| Imagination (IMG) | 具備硬體隱面消除(HSR)的 TBDR。Pixel 10 的 IMG DXT 屬於此類 | 由於 HSR,不透明的 overdraw 原本就少,最佳化的著力點與其他廠商不同。因為是較新的驅動程式,建議驗證行為差異 |
| Apple | PowerVR 系譜的 TBDR。可在 Metal 中明確操作圖塊記憶體 | FBF/無記憶體(memoryless)穩定運作。先在 iOS 上確認效果,再進行 Android 驗證也是有效的做法 |
1.5.6. 結語
最後再次總結本章探討的 4 個主題。使用 Render Graph 時,開發者要做的只有 2 件事:正確宣告資源的使用方式,以及用 Frame Debugger 與 Render Graph Viewer 確認結果。雖然是不起眼的工作,但日積月累就會展現為裝置發熱與電池消耗的差異。希望本章能對各位專案的最佳化有所幫助。
1.5.7. 參考文獻
- ARM, "Arm GPU Best Practices Developer Guide", https://developer.arm.com/documentation/101897/latest/
- Qualcomm, "Adreno GPU Best Practices", https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Apple, "Metal Best Practices Guide", https://developer.apple.com/library/archive/documentation/3DDrawing/Conceptual/MTLBestPracticesGuide/
- Unity, "Render graph system" (URP Documentation), https://docs.unity3d.com/Manual/urp/render-graph.html
- 《學園偶像大師》在行動裝置上也完整呈現「光照與反射」!【CEDEC2024】(日文), https://gamemakers.jp/article/2025_01_29_90729/
- 在行動裝置上實現極速 Deferred Rendering 的方法(日文), CEDiL, https://cedil.cesa.or.jp/cedil_sessions/view/2457
- 從 Unity 6 開始善用 RenderGraph ― 基本功能篇(日文), https://blog.sge-coretech.com/entry/2024/06/04/171757
- 從 Unity 6 開始善用 RenderGraph!應用實作篇 1「RenderPass 的建構」(日文), https://blog.sge-coretech.com/entry/2024/09/11/105032
- 著色器最佳化入門 第 2 回「什麼是圖塊式渲染的 GPU?」(日文), https://blog.sge-coretech.com/entry/2025/01/27/145242