第4章. 行動裝置著色器最佳化:超越函數的測量與輕量化
4.1. 姓名、所屬
Nagatome Ryouhei / 株式會社 Colorful Palette
GitHub 帳號
X 帳號
4.2. 前言
在著色器中使用 sin、exp 等超越函數時,GPU 的處理負載往往會偏高。本文將搭配 Profiler 的測量值,說明這些函數對實際效能的影響程度。此外,也會介紹以近似計算取代超越函數的最佳化手法,並以實測值說明實際能獲得多少負載削減效果。
4.3. 環境
本文使用的 Unity 版本、渲染管線與裝置如下。
| Unity 版本 | Unity6000.3.20f1 |
|---|---|
| 渲染管線 | Universal Render Pipeline 17.3.0 |
| iOS 裝置 | iPhoneX iPhone14 iPhone15 Pro |
| Android 裝置 | Galaxy S9 |
4.4. 超越函數
超越函數是指無法以有限次的四則運算與開方表示的函數。代表性的例子包括三角函數、指數函數與對數函數。
- sin、cos 等三角函數
- pow、pow2 等指數函數
- log、log10 等對數函數
由於超越函數的負載很高,一般建議避免大量使用。
4.4.1. 超越函數負載高的理由
超越函數負載高的理由有以下 3 點。
- 需要的時脈週期數多
- 執行超越函數運算的單元(SFU)數量少
- 暫存器壓力造成的額外負擔
4.4.2. 理由 1:需要的時脈週期數多
智慧型手機等裝置搭載的 GPU,內建大量用於算術運算的運算單元(ALU)。ALU 的設計可在 1 個時脈週期內完成加法與乘法。
然而,超越函數並非能以 1 條指令完成計算的簡單運算。GPU 內部計算超越函數時,會使用泰勒展開或極小極大法等多項式近似演算法,將其分解為大量加法與乘法的組合來計算。
相較於單純的四則運算只需「1 條指令」即可完成,超越函數會被編譯器展開為「數十條指令的四則運算」,因此處理時間較長。
4.4.3. 理由 2:SFU 的數量少
許多 GPU 搭載了名為 SFU(Special Function Unit)的專用硬體,用於高速處理超越函數等運算,超越函數有時也會在 SFU 上執行。
由於 SFU 的數量遠少於 ALU,即使使用 SFU 執行超越函數,處理仍需要較長的時間。
4.4.4. 理由 3:暫存器壓力造成的額外負擔
sin() 這類超越函數的計算比單純的加法與乘法複雜,GPU 內部進行計算時需要更多的暫時暫存器。
GPU 各運算單元(SM:Streaming Multiprocessor)擁有的暫存器總量在實體上是固定的,每個執行緒消耗的暫存器數量增加(暫存器壓力升高)後,1 個 SM 能容納的執行緒數量就會減少。
由於可同時執行的執行緒數量減少,處理便需要較長的時間。
4.5. 各種函數的負載
針對迴圈次數 0〜10 的每一種情況,測量執行各種超越函數時的 GPU 時間,藉此找出哪個超越函數的負載最高。GPU 時間的測量使用 FrameTimingManager。
4.6. 負載測量所使用的著色器
測量使用了如下的著色器。可透過著色器關鍵字選擇要執行的超越函數,並使用變數 _LoopCount 變更迴圈次數。
Shader "Benchmark/Transcendental"
{
    Properties
    {
        // uGUI(CanvasRenderer)會將紋理繫結到 "_MainTex",因此名稱固定
        [PerRendererData][MainTexture] _MainTex("Sprite Texture", 2D) = "white" {}
        [MainColor] _BaseColor("Tint", Color) = (1, 1, 1, 1)

        // Mask(UI/Mask)用的模板設定。Mask 元件會替換 Material 並寫入
        _StencilComp("Stencil Comparison", Float) = 8
        _Stencil("Stencil ID", Float) = 0
        _StencilOp("Stencil Operation", Float) = 0
        _StencilWriteMask("Stencil Write Mask", Float) = 255
        _StencilReadMask("Stencil Read Mask", Float) = 255

        _ColorMask("Color Mask", Float) = 15

        [Toggle(UNITY_UI_ALPHACLIP)] _UseUIAlphaClip("Use Alpha Clip", Float) = 0
    }

    SubShader
    {
        Tags
        {
            "Queue" = "Transparent"
            "RenderType" = "Transparent"
            "RenderPipeline" = "UniversalPipeline"
            "IgnoreProjector" = "True"
            "PreviewType" = "Plane"
            "CanUseSpriteAtlas" = "True"
        }

        Stencil
        {
            Ref [_Stencil]
            Comp [_StencilComp]
            Pass [_StencilOp]
            ReadMask [_StencilReadMask]
            WriteMask [_StencilWriteMask]
        }

        Cull Off
        ZWrite Off
        ZTest [unity_GUIZTestMode]
        Blend SrcAlpha OneMinusSrcAlpha
        ColorMask [_ColorMask]

        Pass
        {
            HLSLPROGRAM

            #pragma vertex vert
            #pragma fragment frag
            // 迴圈次數是 uniform(動態迴圈),因此需要 3.0 而非 2.0
            #pragma target 3.0

            // 支援 RectMask2D / Mask 的 Alpha Clip
            #pragma multi_compile_local _ UNITY_UI_CLIP_RECT
            #pragma multi_compile_local _ UNITY_UI_ALPHACLIP

            // 切換要測量的超越函數。因為想在執行階段以 Shader.EnableKeyword 切換,
            // 所以使用 multi_compile 而非 shader_feature(未使用的 variant 會被剔除)。
            // 每個關鍵字會成為不同的 variant,因此產生的程式碼只會出現所選的函數(沒有分支額外負擔)。
            // 由於是全域關鍵字,可從 TranscendentalBenchmark 端統一控制。
            // 若沒有任何關鍵字啟用,則使用開頭的 _FUNC_NONE variant。
            #pragma multi_compile_fragment _FUNC_NONE _FUNC_SIN _FUNC_SIN_APPROX _FUNC_COS _FUNC_TAN _FUNC_TAN_TAYLOR _FUNC_TAN_PADE _FUNC_ASIN _FUNC_ACOS _FUNC_ATAN _FUNC_EXP _FUNC_EXP2 _FUNC_POW _FUNC_LOG _FUNC_LOG2 _FUNC_LOG10

            #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"

            struct Attributes
            {
                float4 positionOS : POSITION;
                float4 color : COLOR;
                float2 uv : TEXCOORD0;
                UNITY_VERTEX_INPUT_INSTANCE_ID
            };

            struct Varyings
            {
                float4 positionHCS : SV_POSITION;
                float2 uv : TEXCOORD0;
                float4 positionOS : TEXCOORD1; // 以與 _ClipRect 相同的空間(Canvas 區域座標)保存
            };

            TEXTURE2D(_MainTex);
            SAMPLER(sampler_MainTex);

            CBUFFER_START(UnityPerMaterial)
                half4 _BaseColor;
            CBUFFER_END

            // 由 TranscendentalBenchmark 設定的全域值。
            // 不是以材質為單位的值,因此不放進 UnityPerMaterial(放進去會破壞 SRP Batcher)
            int _TranscendentalLoopCount;
            float _PowExponent;

            // 相當於 UnityUI.cginc 的 UnityGet2DClipping(以 HLSL 自行定義)
            float Get2DClipping(float2 position, float4 clipRect)
            {
                float2 inside = step(clipRect.xy, position.xy) * step(position.xy, clipRect.zw);
                return inside.x * inside.y;
            }

            // 將傳給超越函數的值限制在 (0.05, 0.95) 範圍內。
            // 一併避開 asin/acos 的定義域 |x| <= 1、log 系的定義域 x > 0,
            // 以及 exp 系的溢位。由於是所有 variant 共通的前處理,其成本會在差值中相互抵銷。
            float PrepareInput(float seed)
            {
                return seed;
                // return frac(seed) * 0.9 + 0.05;
            }

            float sinApprox(float x)
            {
                // sin 的拋物線近似。只需乘法與 abs,用來觀察與真正的 sin 指令之間的成本差異。
                // 定義域為 |x| <= PI(PrepareInput 的輸出落在此範圍內)。
                // 係數會被常數折疊,因此執行階段沒有除法成本。
                return (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
            }

            float tanTaylor(float x)
            {
                // tan 的泰勒展開取到 3 次項(僅乘法)。用來觀察與真正的 tan 指令之間的成本差異。
                // 定義域為 |x| < PI/2,超過 π/4 後精度會急速下降。
                float x2 = x * x;
                return x * (1.0 + x2 * 0.3333333); // 1.0/3.0
            }

            float tanPade(float x)
            {
                // tan 的 帕德近似(乘法+1 次除法)。定義域為 |x| < PI/2。
                // 分母的零點 x ≈ ±1.581 位於 tan 的極點 ±PI/2 附近,因此能貼近到極點附近。
                float x2 = x * x;
                return x * (15.0 - x2) / (15.0 - 6.0 * x2);
            }

            // 要測量的超越函數。每個關鍵字只會保留 1 個,
            // 因此產生的程式碼中只會出現所選函數的展開結果。
            float Transcendental(float x)
            {
                #if defined(_FUNC_SIN)
                    return sin(x);
                #elif defined(_FUNC_SIN_APPROX)
                    return sinApprox(x);
                #elif defined(_FUNC_COS)
                    return cos(x);
                #elif defined(_FUNC_TAN)
                    return tan(x);
                #elif defined(_FUNC_TAN_TAYLOR)
                    return tanTaylor(x);
                #elif defined(_FUNC_TAN_PADE)
                    return tanPade(x);
                #elif defined(_FUNC_ASIN)
                    return asin(x);
                #elif defined(_FUNC_ACOS)
                    return acos(x);
                #elif defined(_FUNC_ATAN)
                    return atan(x);
                #elif defined(_FUNC_EXP)
                    return exp(x);
                #elif defined(_FUNC_EXP2)
                    return exp2(x);
                #elif defined(_FUNC_POW)
                    // 若指數為常數,會被折疊成 pow(x, 2) -> x * x 的形式,
                    // 因此傳入 uniform 以走通用的 pow 路徑
                    return pow(x, _PowExponent);
                #elif defined(_FUNC_LOG)
                    return log(x);
                #elif defined(_FUNC_LOG2)
                    return log2(x);
                #elif defined(_FUNC_LOG10)
                    return log10(x);
                #else // _FUNC_NONE:不含超越函數的基準線
                    return x;
                #endif
            }

            Varyings vert(Attributes IN)
            {
                Varyings OUT;
                OUT.positionOS = IN.positionOS;
                OUT.positionHCS = TransformObjectToHClip(IN.positionOS.xyz);
                OUT.uv = IN.uv * 300.0;
                return OUT;
            }

            half4 frag(Varyings IN) : SV_Target
            {
                // 這裡是測量對象(外觀沒有意義)。
                // 以 UNITY_LOOP 抑制迴圈展開,使 _TranscendentalLoopCount 次的成本直接累加。
                // 除了超越函數的內容之外,所有 variant 的形式完全相同,
                // 因此與 _FUNC_NONE 的差值即為該函數的成本。
                float accum = 0.0;

                UNITY_LOOP
                for (int i = 0; i < _TranscendentalLoopCount; i++)
                {
                    // 若成為迴圈不變式會被提升到迴圈外,因此將 i 混入引數
                    float x = IN.uv.x + i * 0.017;

                    accum += Transcendental(x);
                }
                return half4(saturate(accum.xxx) * 0.02, 1);
            }
            ENDHLSL
        }
    }
}
4.7. 測量結果
4.7.1. iPhone15 Pro
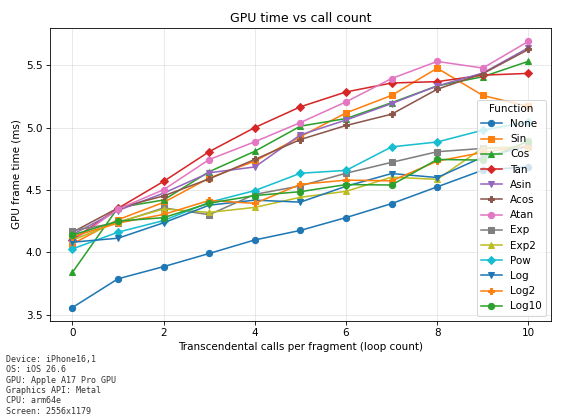
執行次數未滿 7 次時 tan 的負載最高,執行次數 7 次以上時則是 atan 的負載最高。
4.7.2. iPhone14
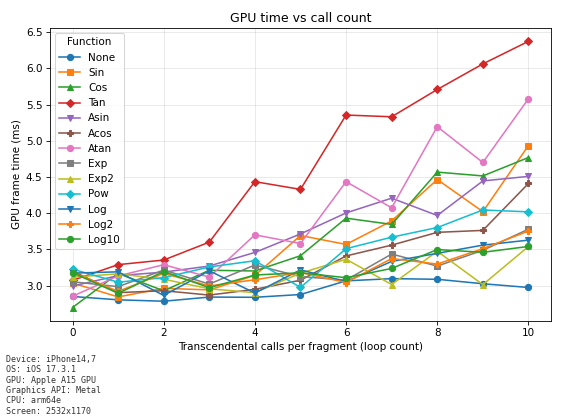
tan 的負載最高,atan 的負載次之。
4.7.3. iPhoneX
4.7.4. Galaxy S9
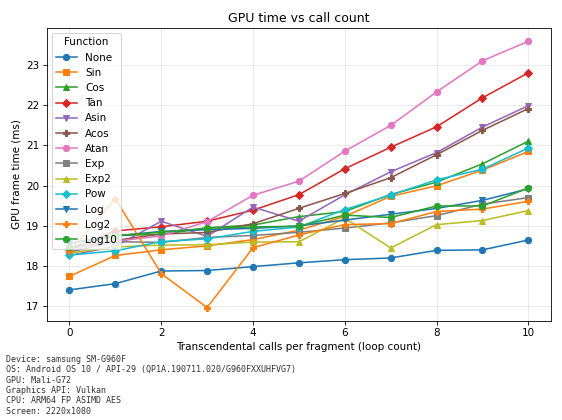
atan 的負載似乎最高。
4.7.5. 總結
| 裝置 | 備註 |
|---|---|
| iPhone 15 Pro | 執行次數未滿 7 次時 tan 的負載最高,7 次以上時 atan 的負載最高 |
| iPhone 14 | tan 的負載最高 |
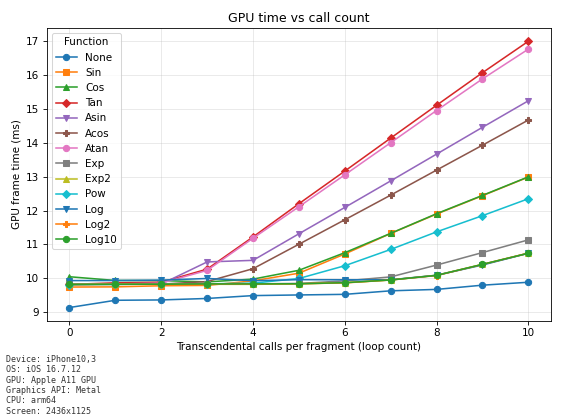
| iPhone X | tan 的負載最高 |
| Galaxy S9 | atan 的負載最高 |
4.8. sin 函數的負載
測量超越函數中最具代表性的 sin 函數的負載。
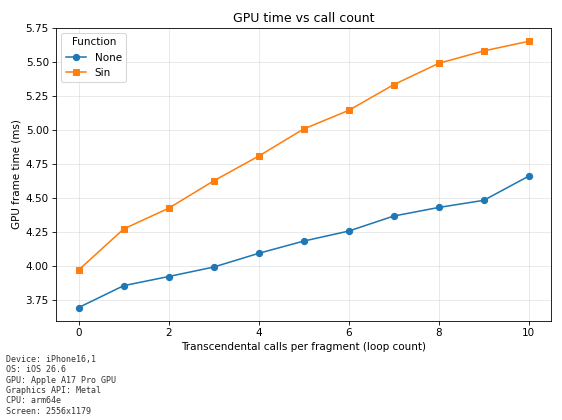
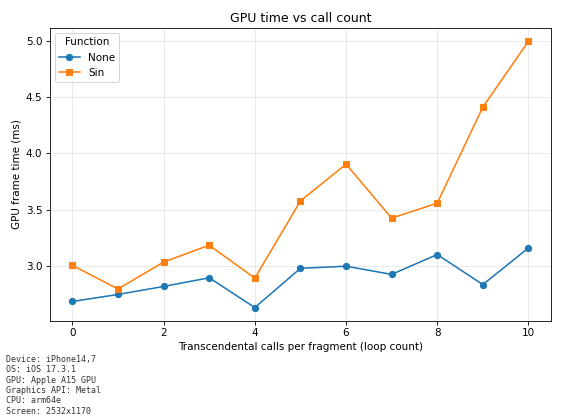
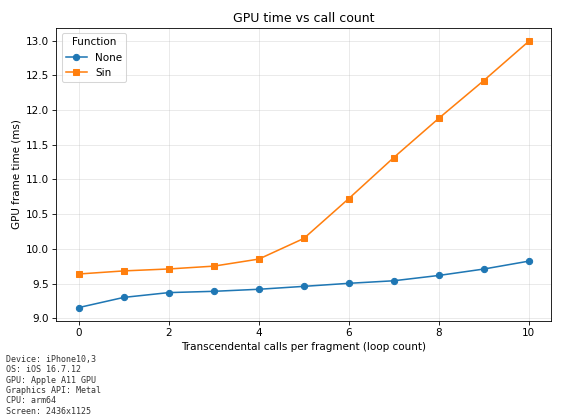
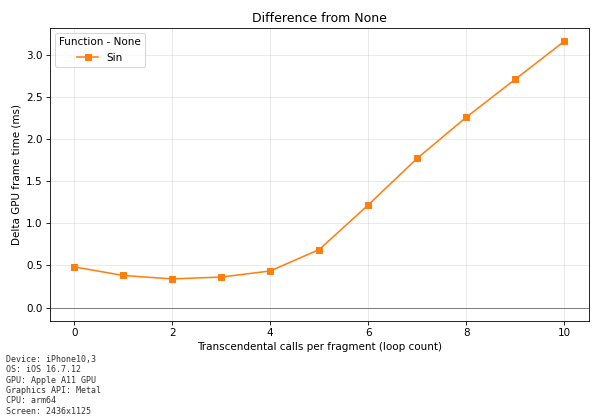
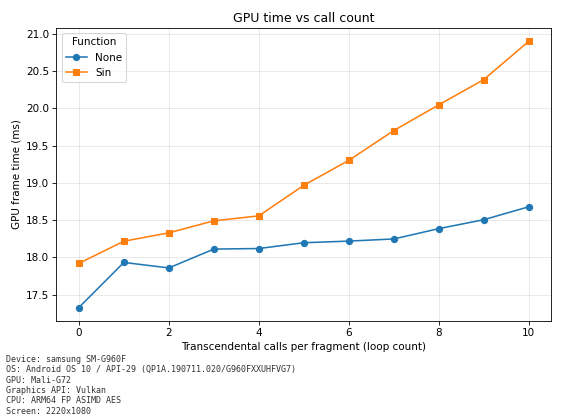
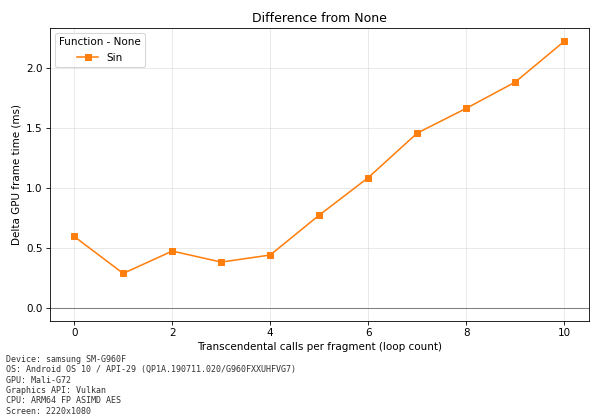
針對迴圈次數 0〜10 的每一種情況,測量影格內處理所需的 GPU 時間。每個測量點各測量 10 秒,並將 GPU 時間整理成圖表。
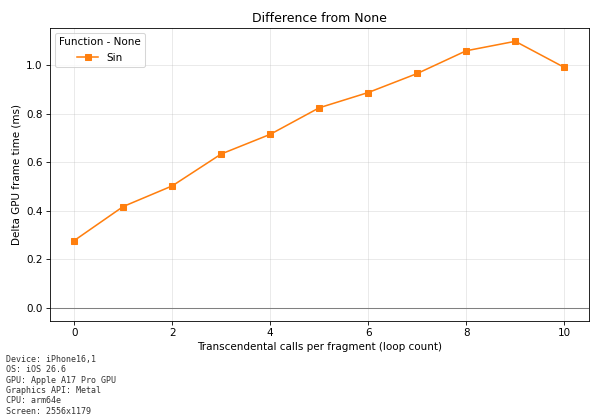
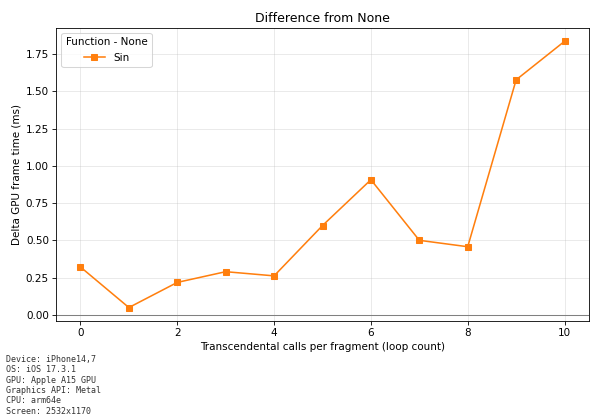
第 1 張圖:對應迴圈次數的 GPU 時間第 2 張圖:對應迴圈次數的 GPU 時間與 None 的差值。
測量使用了 FrameTimingManager。
4.8.1. iPhone15 Pro
只要著色器內存在 sin 指令,就會增加約 0.25ms。sin 的呼叫每增加 1 次,處理負載約增加 0.1ms。
4.8.2. iPhone14
只要著色器內存在 sin 指令,GPU 時間就會增加約 0.25ms。sin 的呼叫每增加 1 次,處理負載約增加 0.1〜0.2ms。
4.8.3. iPhoneX
只要著色器內存在 sin 指令,就會增加約 0.5ms。sin 的呼叫在 4 次以內時,幾乎看不到 GPU 時間的增加,但超過 5 次後,sin 的呼叫每增加 1 次,處理負載約增加 0.6ms。
4.8.4. Galaxy S9
只要著色器內存在 sin 指令,就會增加約 0.5ms。sin 的呼叫在 4 次以內時,幾乎看不到 GPU 時間的增加,超過 5 次後,sin 的呼叫每增加 1 次,處理負載約增加 0.2〜0.3ms。
4.8.5. sin 函數負載總結
| 裝置 | sin 函數造成的 GPU 負載增加 | 備註 |
|---|---|---|
| iPhone 15 Pro | +0.25ms(基準線) | 每次呼叫約增加 0.1ms |
| iPhone 14 | +0.25ms(基準線) | 每次呼叫約增加 0.1〜0.2ms |
| iPhone X | +0.5ms(基準線) | 超過 5 次後每次呼叫約增加 0.6ms |
| Galaxy S9 | +0.5ms(基準線) | 超過 5 次後每次呼叫約增加 0.2〜0.3ms |
※表中的「基準線」是指著色器內存在 sin 函數時的初始負載增加量。
當著色器內的 sin 函數增加時,即使不執行 sin 函數,也能確認到 GPU 時間增加。推測這是暫存器壓力造成的負載增加。
4.9. sin 函數的拋物線近似
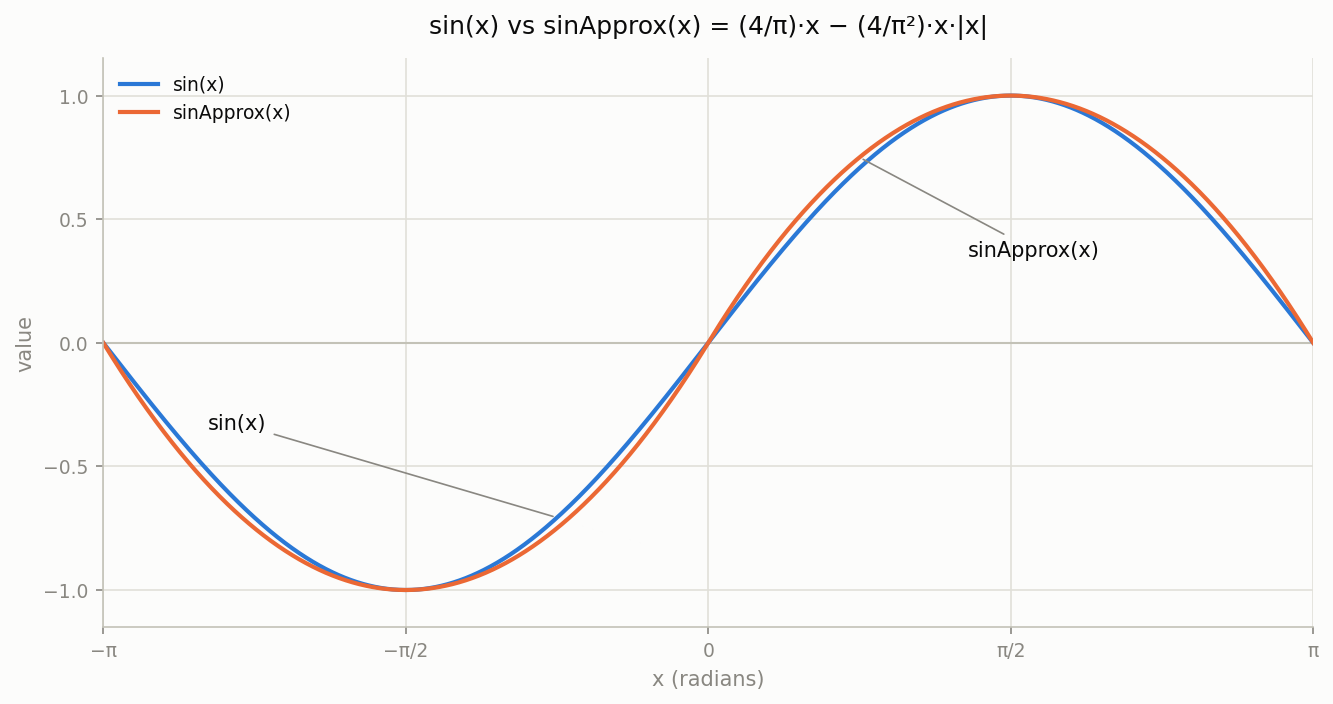
已知可使用如下的多項式來近似 sin。
float sinApprox = (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
由於只需乘法與絕對值 abs() 即可計算,因此非常輕量。
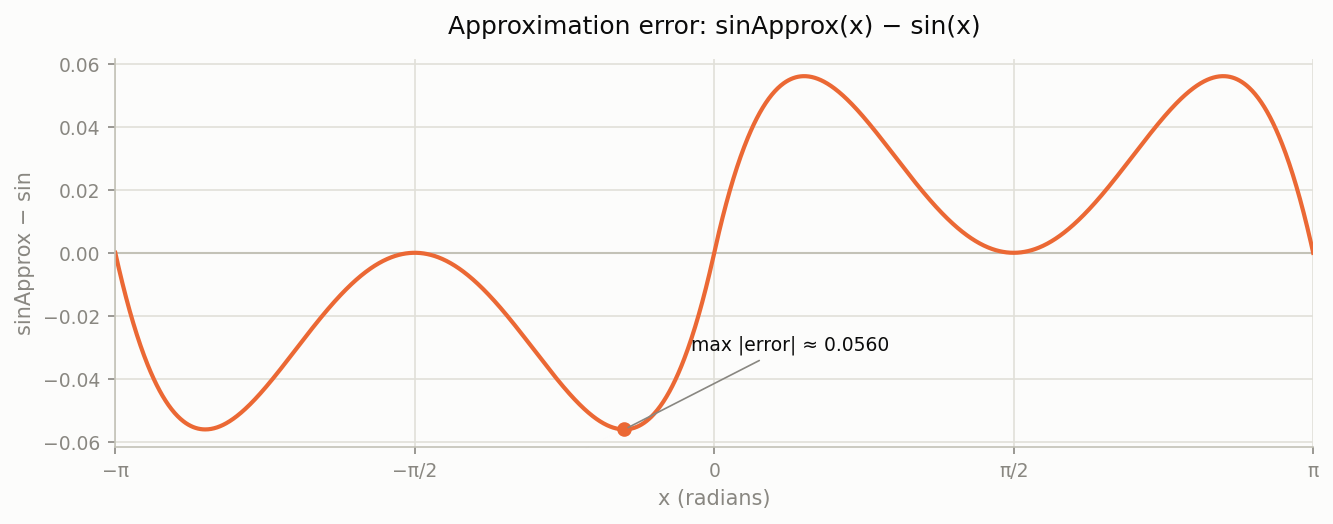
sin 的拋物線近似會輸出與 sin 非常接近的值(-PI<=x<=PI)
最大誤差約為 0.056。
4.10. sin 近似的負載測量
測量 sin 的拋物線近似 sinApprox 的負載,並整理成圖表。
4.10.1. iPhone15 Pro
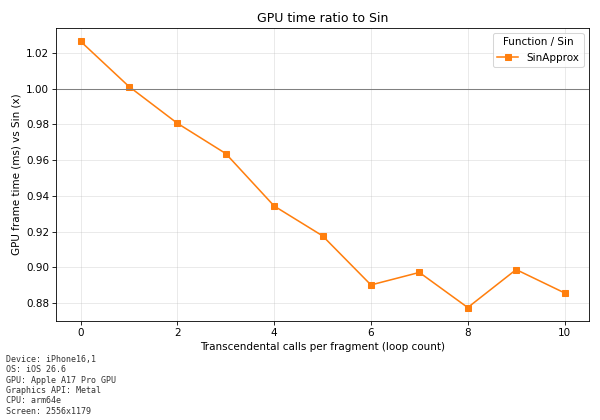
可以確認其負載低於 sin 函數。
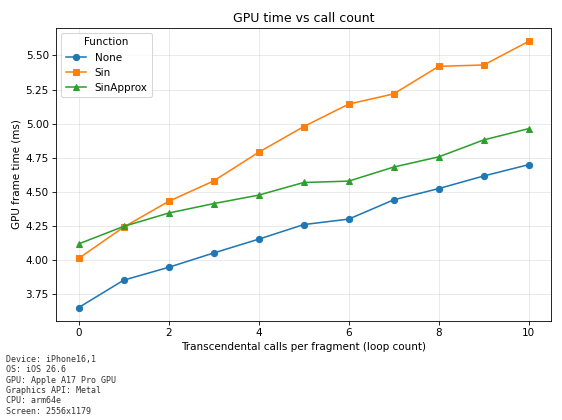
sin 函數與近似計算的比較
執行函數 10 次時,負載約降低 0.6ms。
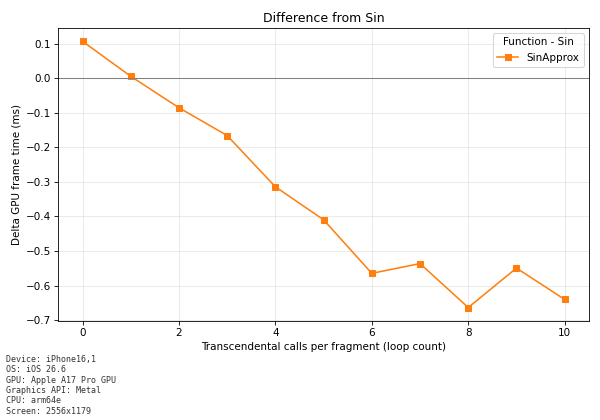
執行函數 10 次時,sinApprox 的負載約為 sin 的 90%。
4.10.2. iPhone14
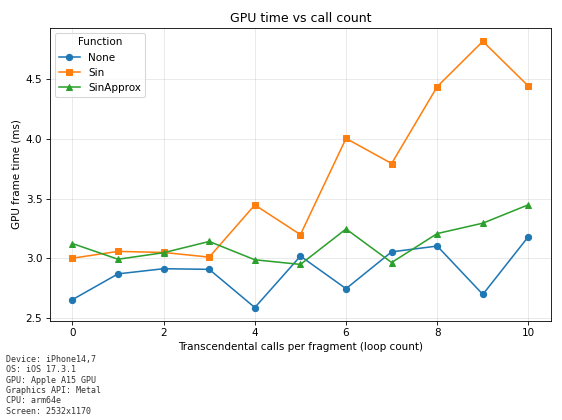
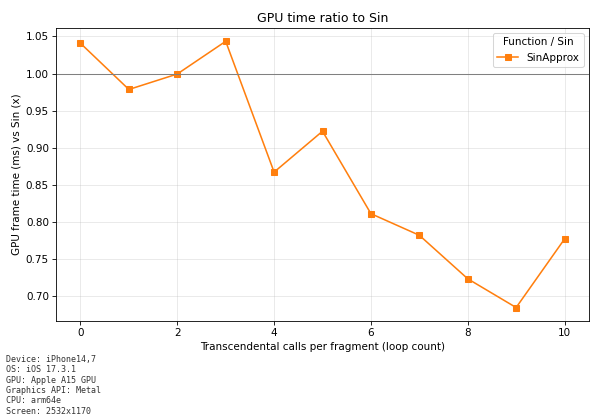
sin 函數與近似計算的比較
執行函數 10 次時,GPU 時間約縮短 1ms。
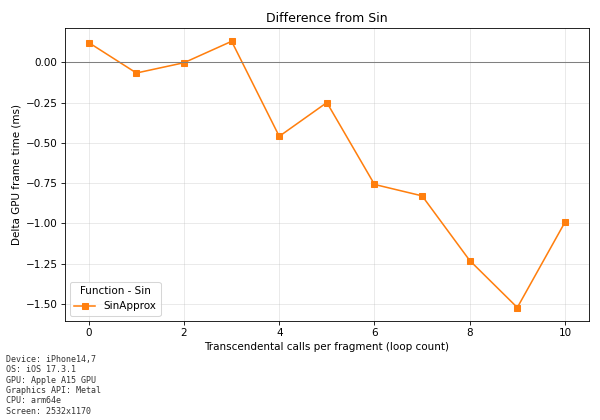
執行 sinApprox 10 次時的負載約為 sin 的 80%。
4.10.3. iPhoneX
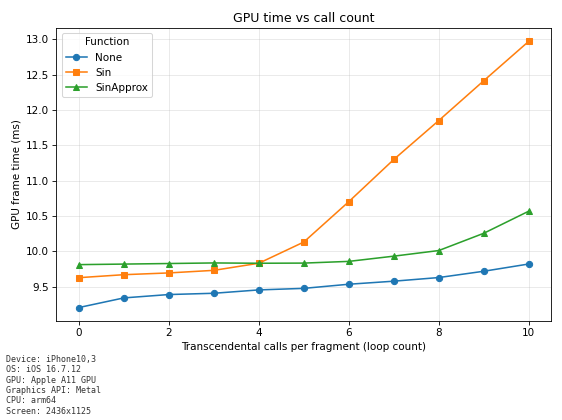
sin 函數與近似計算的比較
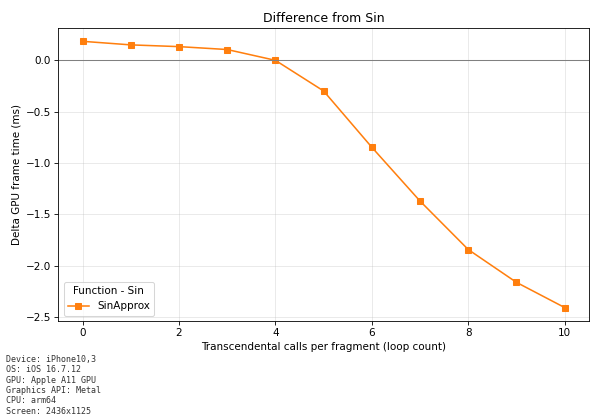
執行 sinApprox 10 次時的負載,相較於執行 sin 時約縮短 2.5ms。
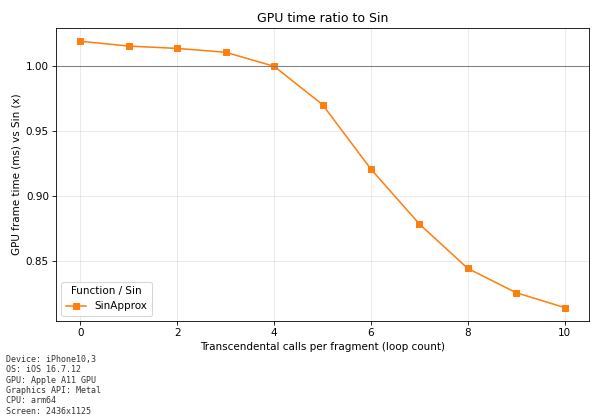
執行 sinApprox 10 次時的 GPU 時間約為 sin 的 80%。
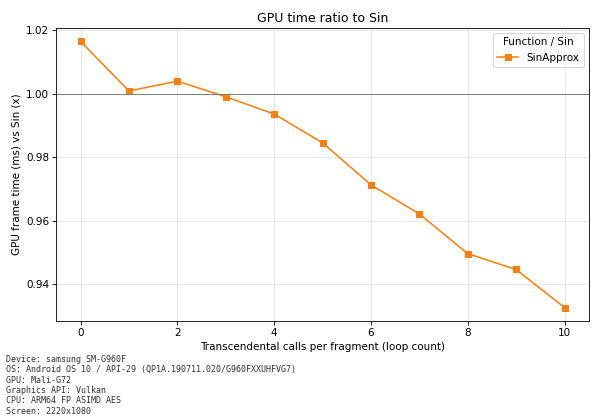
4.10.4. Galaxy S9
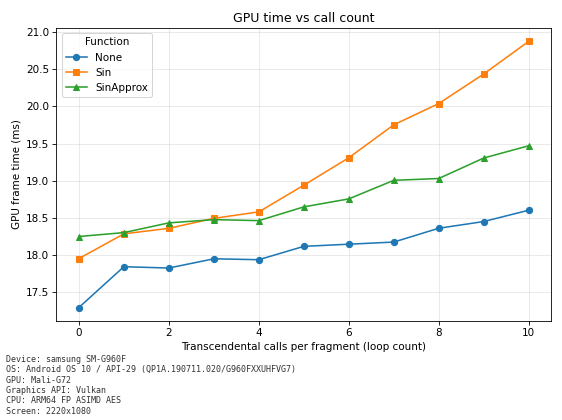
sin 函數與近似計算的比較
執行函數 10 次時,GPU 時間約縮短 1.3ms。
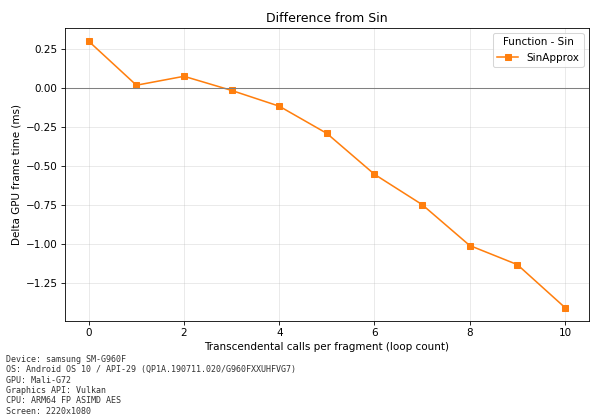
執行 sinApprox 10 次時的負載約為 sin 的 94%。
4.10.5. sin 近似負載總結
將 sinApprox 的 GPU 削減效果整理成表格,結果如下。
| 裝置 | sin 函數的負載 | sinApprox 的削減效果 | 備註 |
|---|---|---|---|
| iPhone 15 Pro | 基準 | 約削減 0.6ms | sinApprox 的負載約為 sin 的 90% |
| iPhone 14 | 基準 | 約削減 1.0ms | sinApprox 的負載約為 sin 的 80% |
| iPhone X | 基準 | 約削減 2.5ms | sinApprox 的負載約為 sin 的 80% |
| Galaxy S9 | 基準 | 約削減 1.3ms | sinApprox 的負載約為 sin 的 94% |
※削減效果為迴圈次數 10 次時的 GPU 時間差值。
4.11. tan 函數的負載
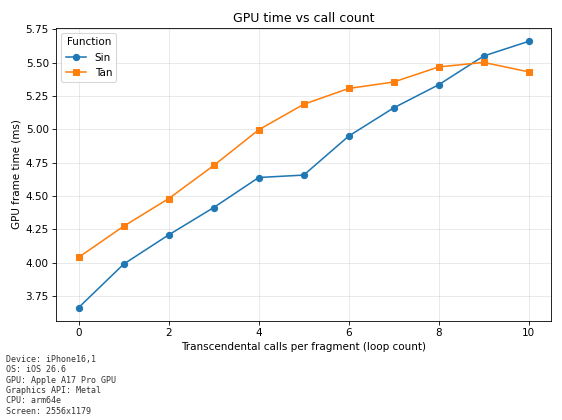
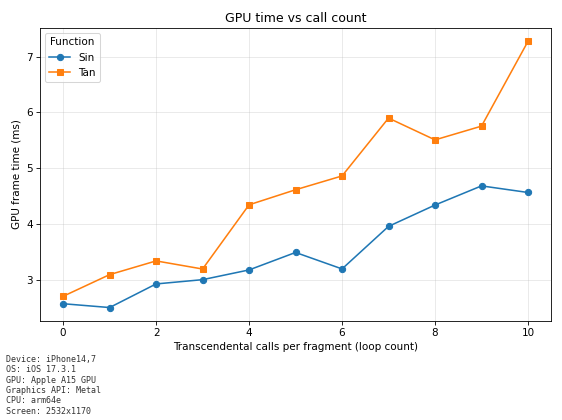
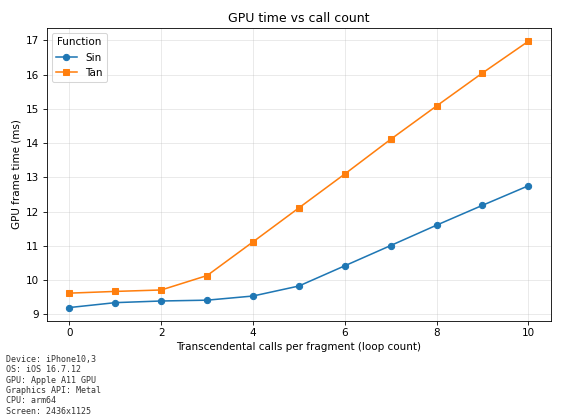
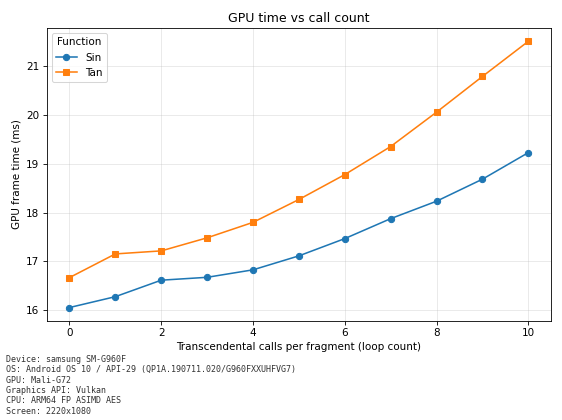
也測量了 tan 函數的負載。由於 tan 函數內部會呼叫除法,其負載高於 sin 函數與 cos 函數。
4.11.1. iPhone15Pro
雖然負載高於 sin 函數,但執行次數超過 9 次後,反而是 sin 函數的負載較高。
4.11.2. iPhone14
tan 函數的負載高於 sin 函數。
4.11.3. iPhoneX
tan 函數的負載高於 sin 函數。
4.11.4. Galaxy S9
tan 函數的負載高於 sin 函數。
4.12. tan 函數的近似
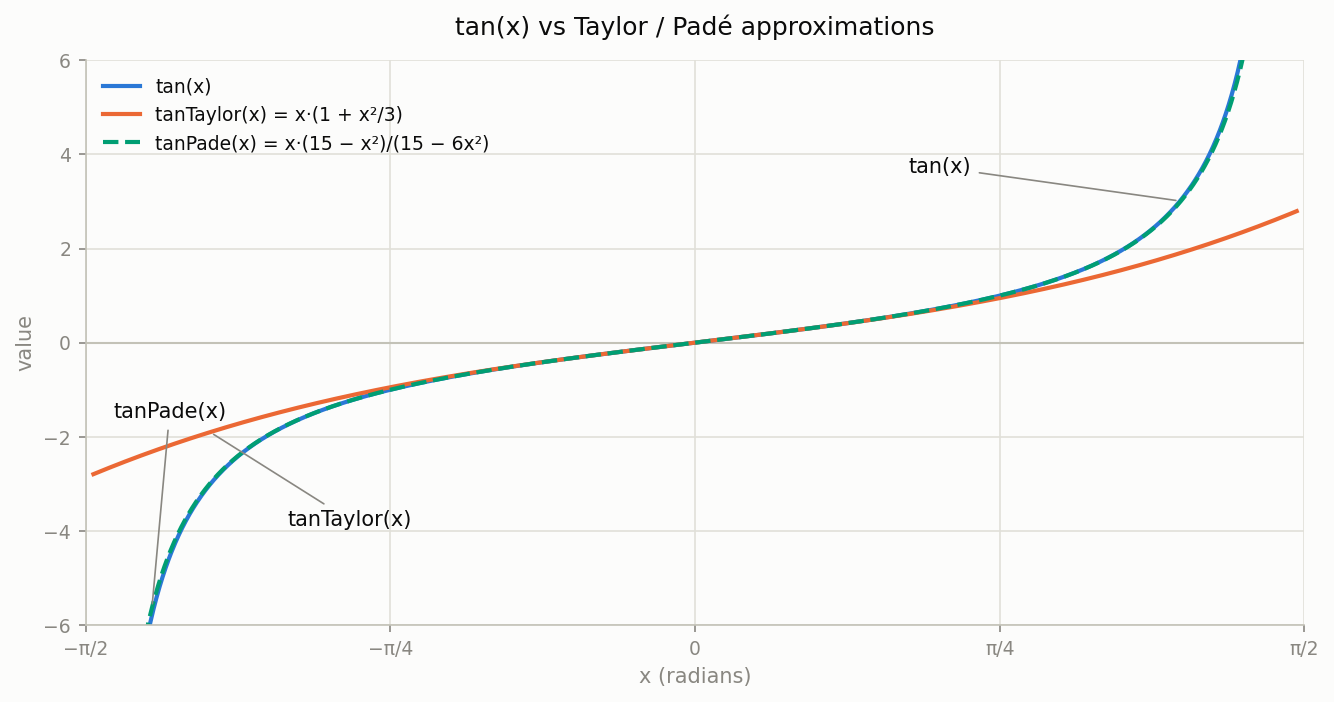
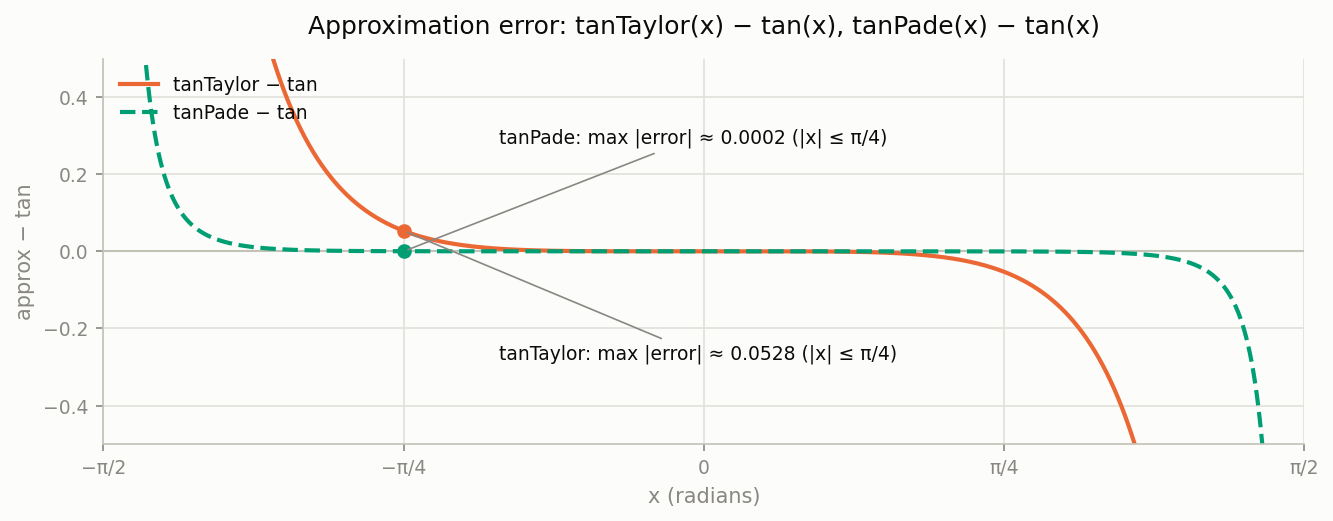
tan 函數的近似手法包括直接利用泰勒展開的方法,以及使用 Padé 近似的方法。泰勒展開的負載較低,但精度也較低。Padé 近似的精度較好,但負載也較高。
4.12.1. 手法 1. 泰勒展開近似
這是利用 tan 的泰勒展開進行的近似計算。
|x| 越接近 PI/2,誤差越大。
float tanTaylor(float x) {
    float x2 = x * x;
    return x * (1.0 + x2 * 0.3333333);
}
4.12.2. 手法 2. Padé 近似
這是利用 tan 的 Padé 近似的手法。在 |x| < PI/4 的範圍內,會輸出與 tan(x) 非常接近的值。
float tanPade(float x) {
    float x2 = x * x;
    return x * (15.0 - x2) / (15.0 - 6.0 * x2);
}
4.13. tan 函數近似的圖表
將前面介紹的 tanTaylor 與 tanPade 繪製成圖表。
與 tan 函數的誤差
4.14. tan 函數近似的負載測量
測量了 tan 函數近似計算的負載。
4.14.1. iPhone15 Pro
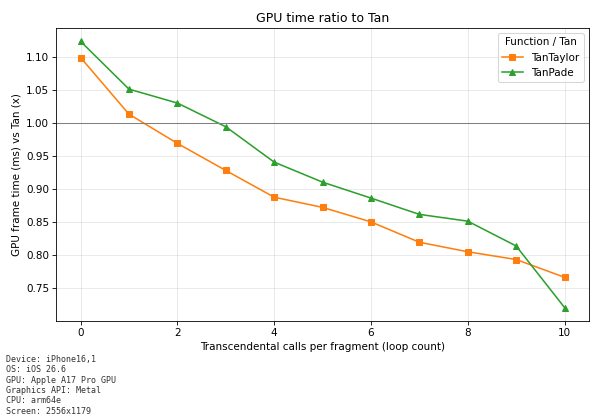
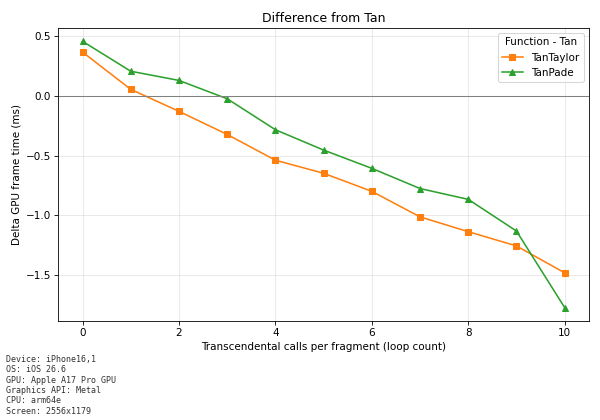
執行次數少時,暫存器壓力造成的額外負擔較為明顯,但隨著執行次數增加,近似計算的負載會被壓得較低。
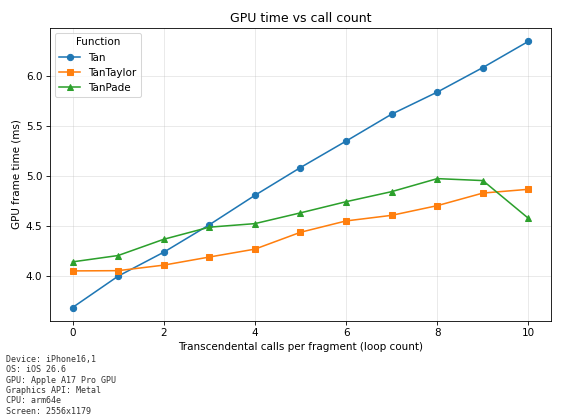
tan 函數與近似計算的比較
執行函數 10 次時,近似計算的 GPU 時間約為 tan 函數的 80%。
執行 10 次時,近似計算的處理時間約少 1ms。
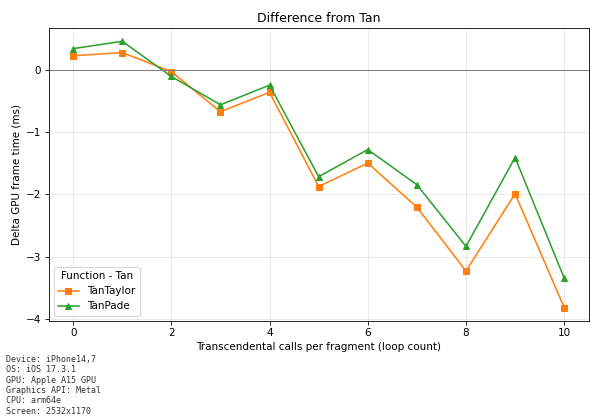
4.14.2. iPhone14
執行次數少時,可觀察到暫存器壓力造成的些微額外負擔。但隨著執行次數增加,近似計算的負載會被壓得較低。
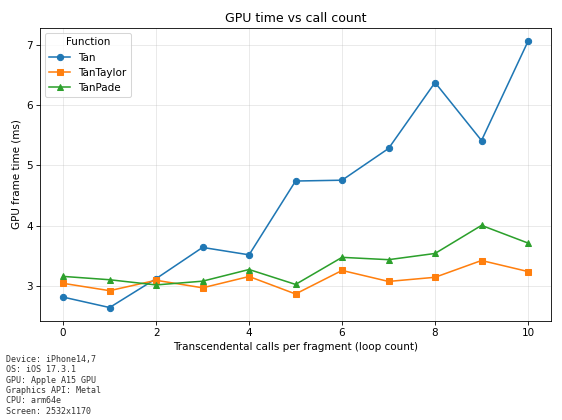
tan 函數與近似計算的比較(iPhone14)
執行函數 10 次時,近似計算的 GPU 時間約為 tan 函數的 50%。
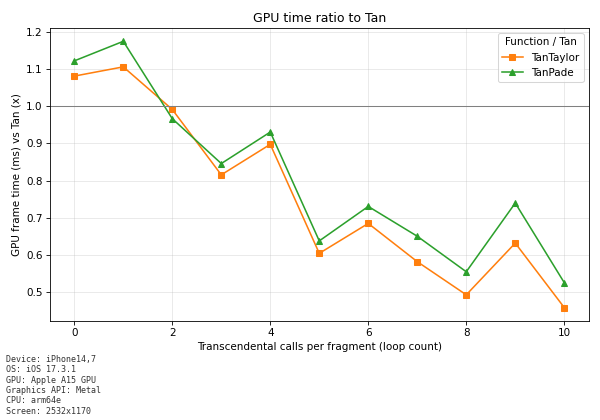
執行 10 次時,近似計算的處理時間約少 3ms
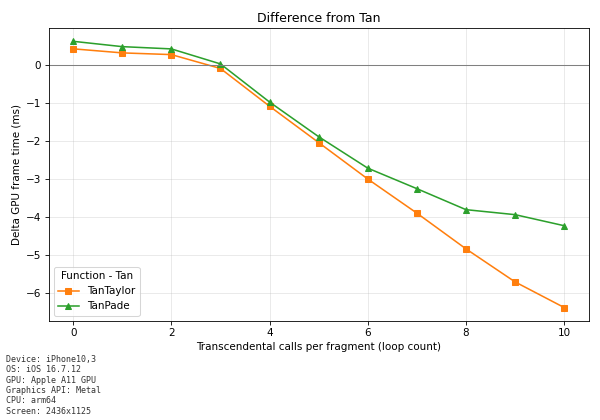
4.14.3. iPhoneX
執行次數少時,可觀察到暫存器壓力造成的些微額外負擔。但隨著執行次數增加,近似計算的負載會被壓得較低。泰勒展開幾乎沒有增加處理負載,而 Padé 近似的處理負載則略有上升。
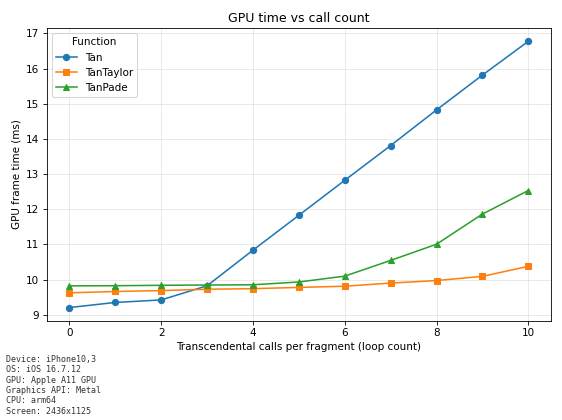
tan 函數與近似計算的比較
執行函數 10 次時,泰勒展開的 GPU 時間約為 tan 函數的 60%。Padé 近似的 GPU 時間約為 75%。
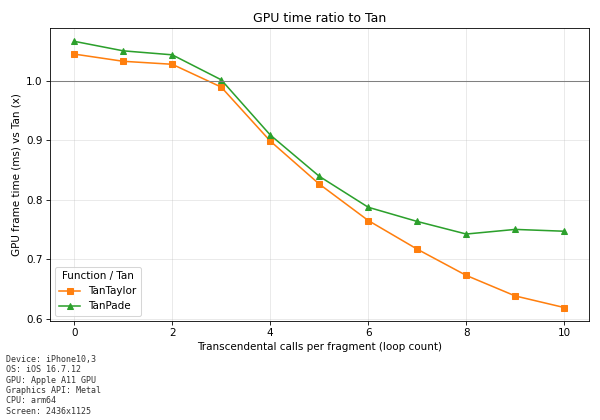
執行函數 10 次時,泰勒展開約縮短 6ms,Padé 近似約縮短 4ms。
4.14.4. Galaxy S9
執行次數少時,可觀察到暫存器壓力造成的些微額外負擔。但隨著執行次數增加,近似計算的負載會被壓得較低。
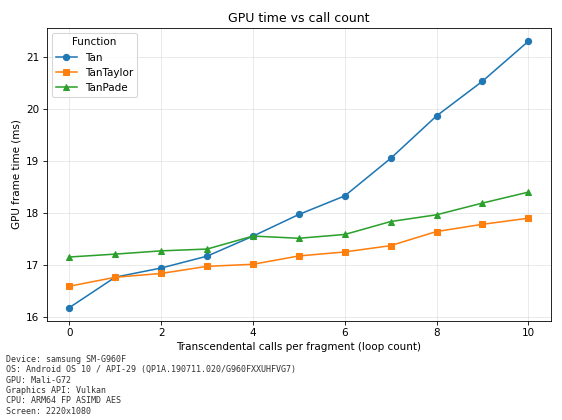
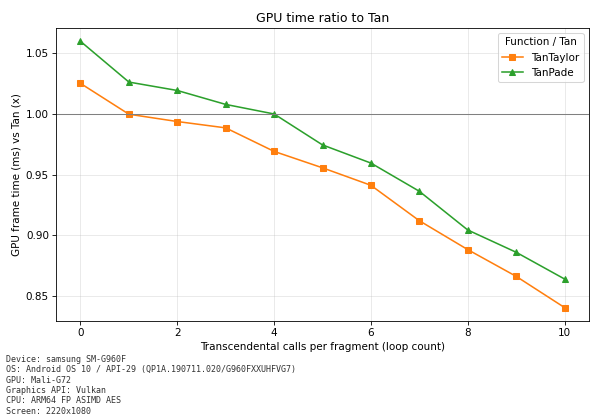
tan 函數與近似計算的比較
執行函數 10 次時,近似計算的 GPU 時間約為 tan 函數的 85%。
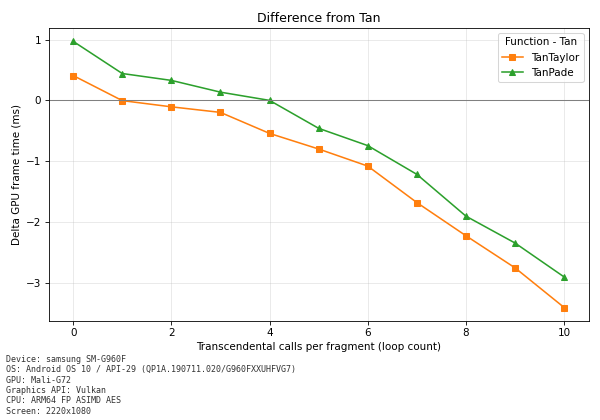
執行函數 10 次時,泰勒展開約縮短 3ms。
4.14.5. tan 函數近似負載總結
| 裝置 | GPU 負載的趨勢 | 備註 |
|---|---|---|
| iPhone 15 Pro | 近似計算約低 20% | 近似計算約削減 1ms 的處理時間 |
| iPhone 14 | 近似計算約低 50% | 近似計算約削減 3ms 的處理時間 |
| iPhone X | 近似計算約低 25〜40% | 泰勒展開約削減 6ms,Padé 近似約削減 4ms |
| Galaxy S9 | 近似計算約低 15% | 近似計算約削減 3ms 的處理時間 |
※「GPU 負載的趨勢」是指與標準 tan 函數相比,執行近似計算(泰勒展開或 Padé 近似)時 GPU 時間的大致削減率。