第1章. Unity 3D 角色動畫的調優
1.1. 前言
本章將從資產設定與實作等多個觀點,介紹「Unity 中 3D 角色動畫功能的最佳化手法」。
1.1.1. 測量環境
本章的實作與測量在以下環境進行。
表 1.1: 測量環境
| 項目 | 值 |
|---|---|
| Unity | 6000.5.7f1 |
| 平台 | macOS Standalone (StandaloneOSX) |
| Scripting Backend | IL2CPP / IL2CPP Compiler Configuration = Release / Code Generation = OptimizeSpeed |
| Graphics API | Metal / GPU Skinning = 啟用 |
| Quality Level | PC / Skin Weights = Four Bones |
1.1.2. 使用的資產及其結構
測量所用的角色以 unity-chan 為基礎,重新匯入為 Generic Rig。 套用後述的 Optimize Game Objects 前後的規格如下。
表 1.2: 測量所用 Prefab 的 Transform 數與頂點數
| Prefab | Transform 數 | 頂點數 |
|---|---|---|
| Base | 166 | 13,391 |
| Optimized(Optimize Game Objects) | 24 | 13,391 |
1.2. 關於 Unity Animation 的基本控制
首先整理在 Unity 中控制動畫的 3 種手法。
1.2.1. 使用 Animator 元件進行控制
這是將 RuntimeAnimatorController 指派給 Animator 的最常見方法。狀態機、轉換、Blend Tree、參數等機制一應俱全,可直接使用 Mecanim 的工作流程。
清單 1.1: 以 Animator 元件進行控制
1 2 3 | var animator = GetComponent<Animator>(); animator.runtimeAnimatorController = controller; // 指派狀態機 animator.SetFloat("Blend", 0.5f); // 以參數控制 |
重要的是,Animator 在內部是組建並執行 Playable Graph 的。狀態機的評估與 Clip 的取樣,在內部都是以圖的節點來處理。接下來的 2 種手法,相當於自行組建這個內部圖的方法。
1.2.2. 以 Playable API 建構 Playable Graph,並以自動更新進行控制
這是自行組建 PlayableGraph 的方法。不經由狀態機即可完全控制混合結構,並且能將後述的 Animation Job(AnimationScriptPlayable)插入圖中的任意位置。
清單 1.2: 以 Playable API 建構圖(自動更新)
1 2 3 4 5 6 7 8 9 10 11 12 13 | var graph = PlayableGraph.Create("MyGraph"); var output = AnimationPlayableOutput.Create(graph, "Animation", animator); var clipA = AnimationClipPlayable.Create(graph, waitClip); var clipB = AnimationClipPlayable.Create(graph, walkClip); var mixer = AnimationMixerPlayable.Create(graph, 2); graph.Connect(clipA, 0, mixer, 0); graph.Connect(clipB, 0, mixer, 1); mixer.SetInputWeight(0, 0.5f); mixer.SetInputWeight(1, 0.5f); output.SetSourcePlayable(mixer); graph.Play(); |
更新模式預設為 DirectorUpdateMode.GameTime。在此模式下,會在 Unity 的生命週期(Update 與 LateUpdate 之間的 Animation 階段)中,以與 Animator 元件相同的時機自動評估。呼叫端不需要每個影格做任何事。
1.2.3. 以 Playable API 建構 Playable Graph,並以手動更新進行控制
對同一張圖設定 DirectorUpdateMode.Manual 後,Unity 就完全不再自動評估,只有在呼叫 Evaluate() 時才會評估圖。
清單 1.3: 手動更新下的圖評估
1 2 3 4 5 6 7 | graph.SetTimeUpdateMode(DirectorUpdateMode.Manual); graph.Play(); void Update() { graph.Evaluate(Time.deltaTime); // 只有呼叫時才會評估 } |
由於可以完全控制評估的時機與頻率,「只停止特定角色(圖)的更新」「每隔數個影格才更新一次」這類控制可以直接實作。
3 種手法的關係整理如下。
表 1.3: 動畫控制 3 種手法的比較
| 手法 | 圖的建構 | 評估時機 |
|---|---|---|
| Animator 元件 | Unity(內部) | Unity 的 Animation 階段 |
| Playable API + 自動更新 | 自行建構 | Unity 的 Animation 階段 |
| Playable API + 手動更新 | 自行建構 | 呼叫 Evaluate() 時 |
1.3. 資產設定
在介紹程式碼端的最佳化之前,先來看資產端設定可套用的最佳化。本節的主題是去除骨骼的 Transform 階層。達成相同結果的手段有 2 種。
1.3.1. Optimize Game Objects(匯入時)
啟用 FBX 匯入設定(Rig 分頁)的 Optimize Game Objects 後,執行階段就不會再整批產生骨骼的 GameObject / Transform,Animator 只持有內部骨架。以本次的角色而言,Transform 從 166 個減少到 24 個(根 + Renderer 23 個)。
※由於骨骼不再以 GameObject 的形式存在,透過走訪階層來存取骨骼的程式碼將無法運作。若只需要武器掛載點等特定骨骼,可透過 Extra Transforms to Expose 個別保留。
1.3.2. Optimize Hierarchy(執行階段)
在執行階段做同樣事情的 API 是 AnimatorUtility.OptimizeTransformHierarchy。
清單 1.4: 執行階段的階層扁平化
1 2 3 4 5 | // go 是持有 Animator(與有效 Avatar)的根物件。第 2 個引數是要公開的骨骼名稱陣列 AnimatorUtility.OptimizeTransformHierarchy(go, null); // 也有反向轉換(在編輯器擴充或除錯時想暫時還原階層的情況) AnimatorUtility.DeoptimizeTransformHierarchy(go); |
即使是無法更動匯入設定的資產,只要在產生時執行,就能得到相同的結構。實際確認後,對 Base Prefab(Transform 166 個)套用後變為 Transform 24 個、hasTransformHierarchy == false,與匯入時套用 Optimize Game Objects 的 Prefab 結構完全相同。
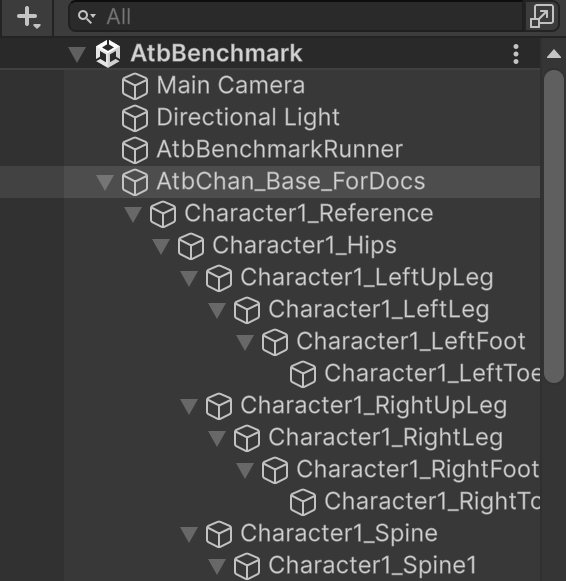
圖 1.1: 最佳化前的 Hierarchy。Character1_Hips 之下接續著 166 個骨骼的 Transform 階層。
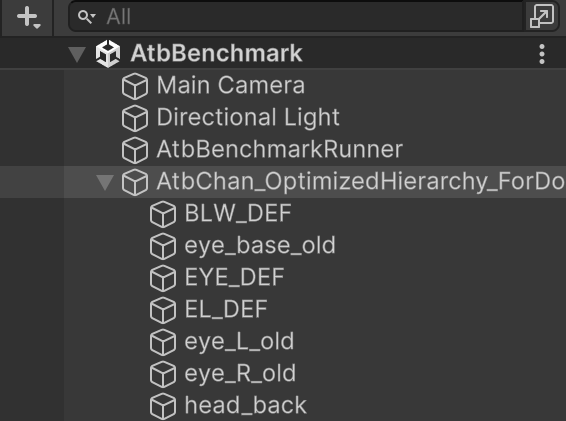
圖 1.2: 套用 AnimatorUtility.OptimizeTransformHierarchy 後。骨骼階層消失,根之下只剩並排的 23 個 SkinnedMeshRenderer(Transform 24 個)。
1.3.3. 實際測量:階層扁平化的效果
我們以 2 種繪製負載進行測量。第 1 種是啟用全部 Renderer 的配置(300 個角色 × 23 Renderer = 6,900 Renderer),第 2 種是每個角色只啟用頂點數最多的 1 個 SkinnedMeshRenderer、以降低繪製負載的配置。影格時間為中位數。
表 1.4: 階層扁平化的效果(300 個角色、全 Renderer 與 600 個角色、1 Renderer)
| 配置 | 變體 | 影格時間 | MeshSkinning.Update (main) | MeshSkinning.CalcMatrices (all) | Semaphore.WaitForSignal |
|---|---|---|---|---|---|
| 300 個角色、全 Renderer | Base | 18.59 ms | 6.23 ms | 36.633 ms | 5.33 ms |
| 300 個角色、全 Renderer | Optimize Game Objects | 18.497 ms (±0) | 1.537 ms (−75.7 %) | 0 ms | 10.255 ms |
| 300 個角色、全 Renderer | Optimize Hierarchy | 18.307 ms (±0) | 1.504 ms (−76.2 %) | 0 ms | 9.977 ms |
| 600 個角色、1 Renderer | Base | 6.797 ms | 0.735 ms | 4.385 ms | 5.741 ms |
| 600 個角色、1 Renderer | Optimize Game Objects | 5.991 ms (−11.9 %) | 0.207 ms | 0 ms | 4.901 ms |
| 600 個角色、1 Renderer | Optimize Hierarchy | 6.009 ms (−11.6 %) | 0.208 ms | 0 ms | 5.010 ms |
CPU 端的處理在兩種配置下都以相同比例減少。主執行緒的蒙皮處理從 6.321 → 約 1.5 ms(全 Renderer)、0.735 → 約 0.21 ms(1 Renderer),皆達成 7 成以上的削減。至於蒙皮矩陣的計算(MeshSkinning.CalcMatrices),全執行緒合計 36.6 ms / 4.4 ms 更是完全消失。
不過在「全 Renderer 配置」下,渲染執行緒的處理是影格時間的關鍵路徑,因此看不到影格時間的削減。
在降低繪製負載的 1 Renderer 配置下,同樣的削減直接表現為約 12 % 的影格時間縮短。300 個角色也呈現相同趨勢,為 3.312 → 2.899 / 2.901 ms(−12.5 % / −12.4 %)。匯入時的 Optimize Game Objects 與執行階段的 Optimize Hierarchy 差異不到 0.1 %,可見既然結構相同,效果也相同。
Profiler 的 Timeline 中也發生了同樣的事。兩者皆為 300 個角色、全 Renderer,且是影格時間中位數附近的影格。
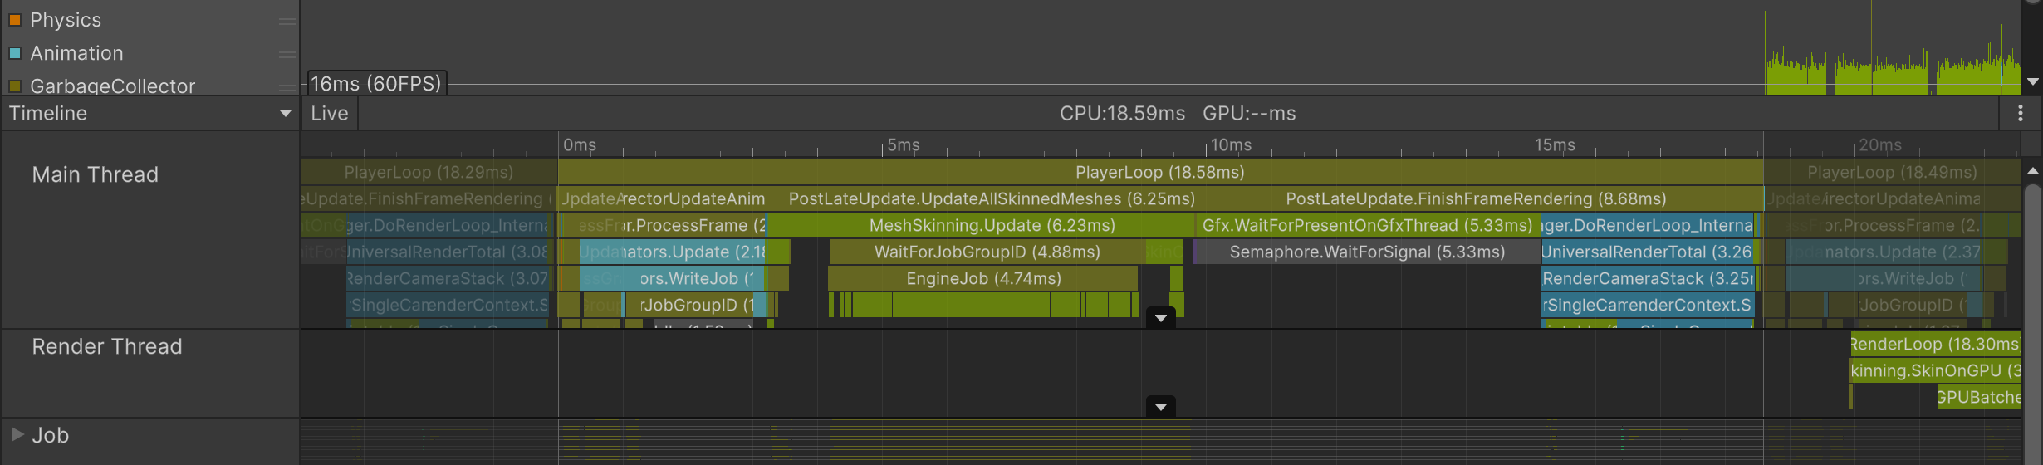
圖 1.3: Base(Transform 166 個)。在 18.59 ms 的影格時間中,主執行緒的 MeshSkinning.Update 占 6.23 ms,Gfx.WaitForPresentOnGfxThread / Semaphore.WaitForSignal 為 5.33 ms。
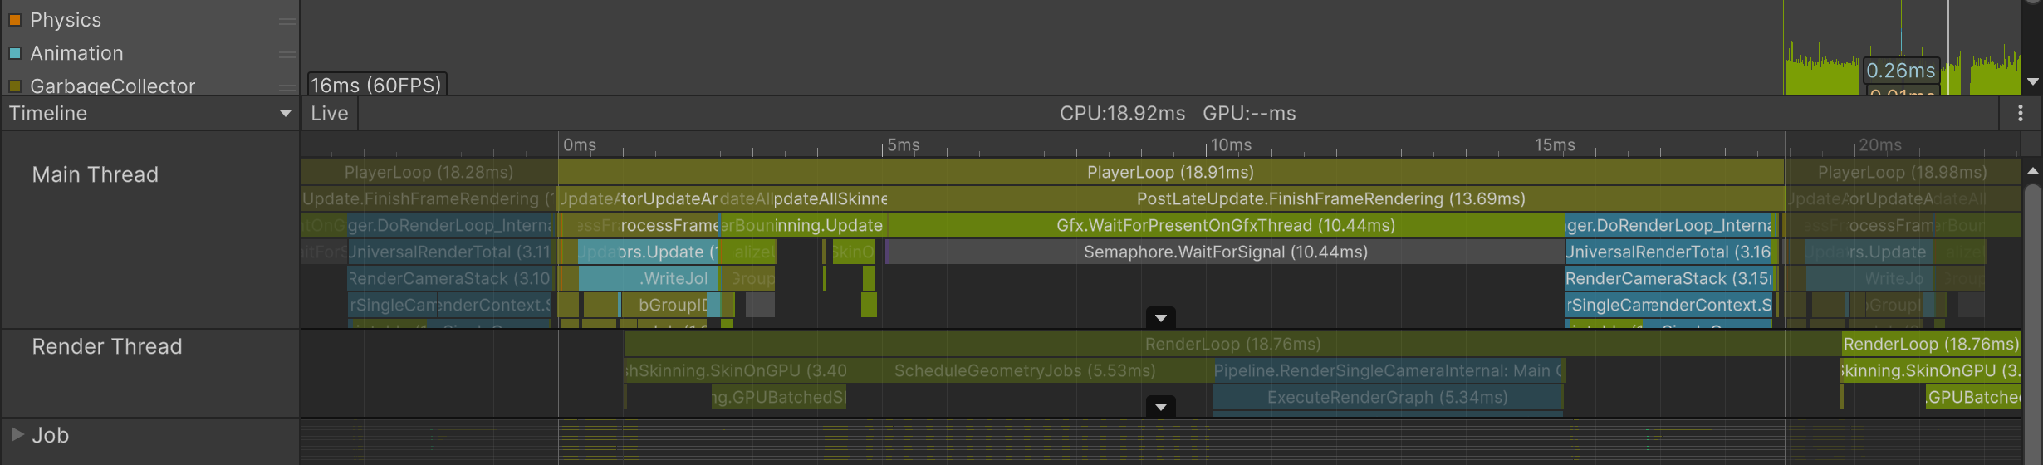
圖 1.4: 套用 AnimatorUtility.OptimizeTransformHierarchy 後。MeshSkinning.Update 的區塊縮到連標籤都看不清的細度,另一方面 Semaphore.WaitForSignal 從 5.33 → 10.44 ms 拉長,PlayerLoop 則為 18.58 → 18.91 ms,幾乎沒有變化。削減掉的 CPU 時間被等待時間取代了。
1.3.4. 實際測量:全部停用 Renderer(僅動畫評估)
完全移除繪製與蒙皮,觀察對動畫評估本身的貢獻。角色數為 300 個。
表 1.5: 全部停用 Renderer 時的影格時間
| 變體 | 影格時間 |
|---|---|
| Base | 2.702 ms |
| Optimize Game Objects | 2.687 ms (−0.6 %) |
| Optimize Hierarchy | 2.496 ms (−7.6 %) |
Clip 的取樣與混合等評估處理,與 Transform 階層的有無無關,一律都會執行,因此可以說對這部分幾乎沒有貢獻。由此可知,這項最佳化的目的主要是針對蒙皮矩陣的計算與寫回 Transform,而非動畫評估本身。
1.3.5. 本章結論
- 階層扁平化有助於削減蒙皮矩陣計算(
MeshSkinning.CalcMatrices) - 匯入時(Optimize Game Objects)與執行階段(
AnimatorUtility.OptimizeTransformHierarchy)的效果相同 - 選擇哪一種是實務上的問題:自家資產就以匯入設定解決,若有無法更動匯入設定的原因則使用執行階段 API
- 最優先的是在製作階段就把模型本身的頂點數與骨骼數調整到適當值
1.4. 活用 Job Thread
1.4.1. Unity 的動畫平行化
對於 Animator 元件以及自動更新的 Playable Graph,Unity 會將所有的圖統一排程,並分散到 Animation Job Thread。
問題在於手動更新。PlayableGraph.Evaluate() 是將該圖內部的評估處理平行化,並不會跨圖平行化。因此若以「1 個角色 = 1 個 Playable Graph」這種直覺的組成來控制 N 個角色,就會呼叫 N 次 Evaluate(),N 張圖被依序串列處理。
這是 Unity Playable Graph 無法避免的機制,但對策很簡單:把 N 個角色彙整到 1 張圖中。
1.4.2. 實際測量 1:控制手法 × 角色數
將 Renderer 全部停用,只擷取動畫評估的成本。影格時間為中位數。
表 1.6: 各控制手法與角色數的影格時間
| 控制方法 | 100 個角色 | 300 個角色 | 600 個角色 |
|---|---|---|---|
| Animator 元件 | 0.899 ms | 2.413 ms | 5.004 ms |
| Playable API + 自動更新 | 0.899 ms | 2.498 ms | 5.093 ms |
| Playable API + 手動更新(1 個角色 1 張圖) | 1.395 ms | 3.925 ms | 8.396 ms |
| Playable API + 手動更新(全體 1 張圖) | 0.800 ms | 2.115 ms | 4.500 ms |
Animator 與 Playable 自動更新的成本幾乎相同。 「Playable API 比較輕量」的說法,至少在「簡單的動畫控制」這個條件下並不成立。Animator 的狀態機評估(AnimatorControllerPlayable.PrepareFrame)即使在 600 個角色下,全執行緒合計也只有 2.624 ms,其中主執行緒僅 0.161 ms,可以說這項處理成為瓶頸的可能性極低。(不過,2 ms 算大還是算小,我認為取決於遊戲。)
手動更新會因圖的結構而相差 1.87 倍。同樣是 600 個角色,依圖的彙整方式不同,可能比自動更新快,也可能比它慢。
1.4.3. 實際測量 2:執行緒的使用方式
600 個角色、停用 Renderer。這是從 Unity Profiler 的擷取結果按執行緒彙總的數據。
表 1.7: 圖的粒度造成的執行緒使用方式差異(600 個角色)
| 1 個角色 1 張圖(600 張圖) | 600 個角色 1 張圖 | |
|---|---|---|
| 影格時間 | 9.490 ms | 4.928 ms |
主執行緒的 Evaluate | 9.028 ms | 4.556 ms |
| 負責動畫處理的工作執行緒數 | 5 | 15 |
Animator.ProcessGraph 全執行緒合計 | 0.920 ms | 19.034 ms |
每條工作執行緒的 Animator.ProcessGraph | 0.32 / 0.15 / 0.03 / 0.02 / 0.002 ms | 各約 1.19 ms(15 條幾乎均等) |
1 個角色 1 張圖時,動畫處理幾乎全部落在主執行緒上。只是 600 次 Evaluate() 依序執行而已,工作執行緒幾乎沒有在工作。
600 個角色 1 張圖時,全部 15 條工作執行緒幾乎均等地執行 Animator.ProcessGraph。
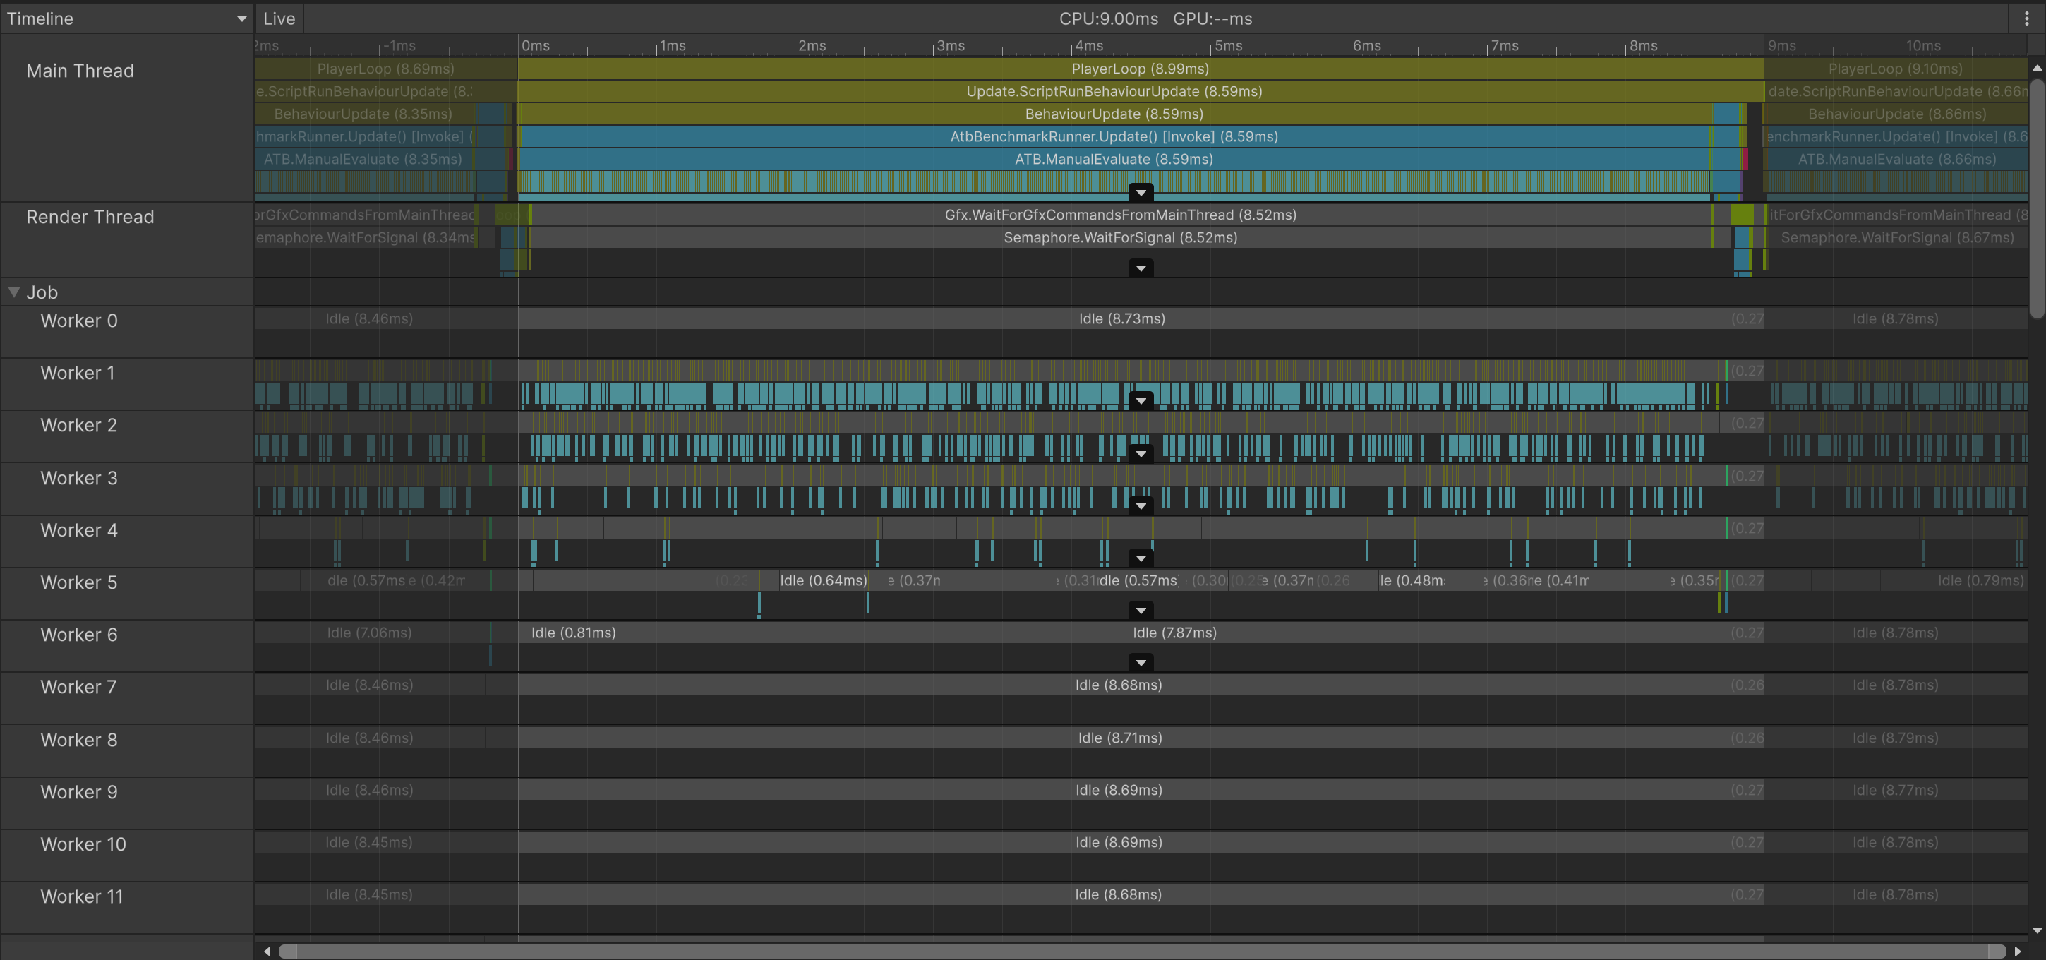
圖 1.5: 1 個角色 1 張圖(600 張圖)的 Timeline。主執行緒的 ATB.ManualEvaluate 占約 8.6 ms,Job 工作執行緒大多維持「Idle」。
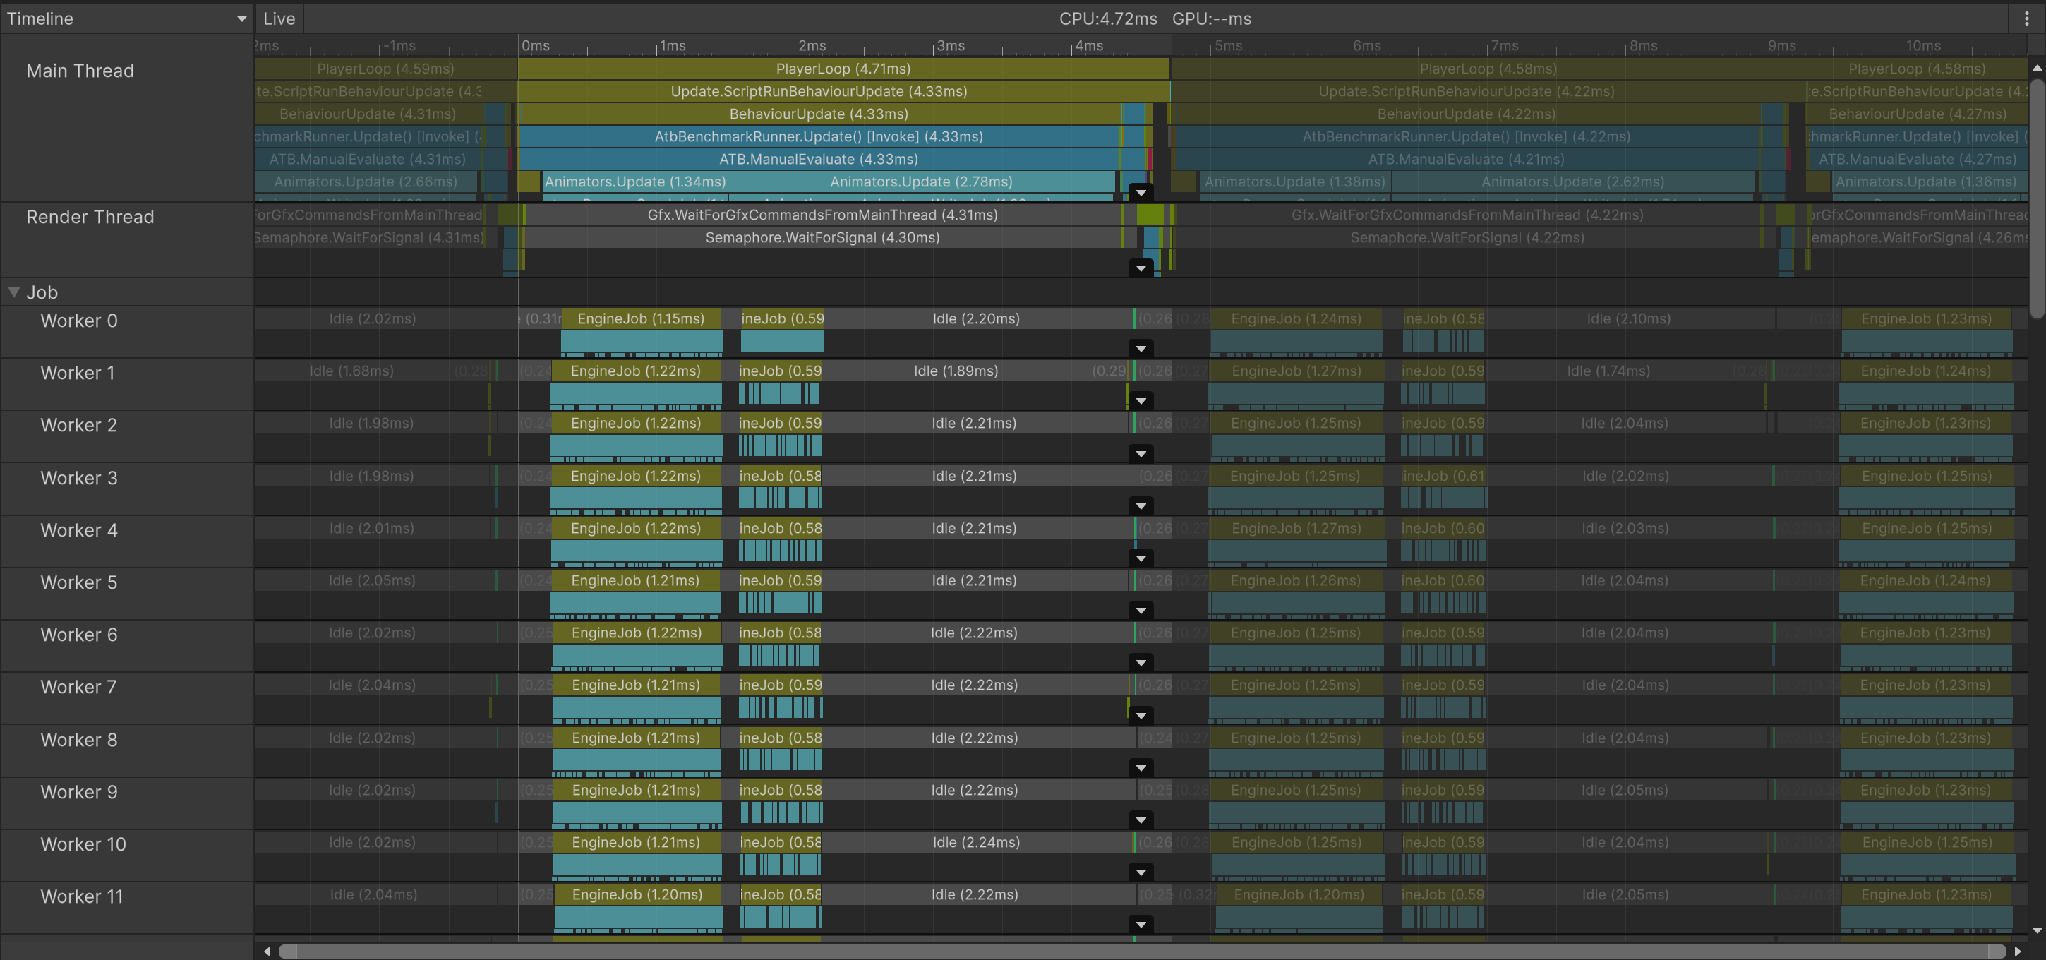
圖 1.6: 600 個角色 1 張圖的 Timeline。主執行緒的 ATB.ManualEvaluate 減半至約 4.3 ms,全部工作執行緒同時各執行約 1.2 ms 的 EngineJob。
關於數值的解讀有 1 點補充。
此表的數值取自連接 Unity Profiler 狀態下的擷取結果,因此比未連接 Profiler 的測量(4.500 ms / 8.396 ms)略重。章末的彙整表使用的是未連接 Profiler 的數值。
1.4.4. 本章結論
表 1.8: 600 個角色的影格時間彙整
| 配置 | 600 個角色的影格時間 |
|---|---|
| 1 個角色 1 張圖 + 手動更新 | 8.396 ms |
| Animator(自動) | 5.004 ms |
| 600 個角色 1 張圖 + 手動更新 | 4.500 ms |
- Animator 與自動更新的 Playable Graph,Unity 會把全部的圖統一分散到 Animation Job Thread
- 手動更新只會以圖為單位平行化
- 選擇手動更新時,務必將圖的粒度納入設計項目
- 改用 Playable API 本身幾乎沒有最佳化效果。使用 Playable API 的真正價值在於「可插入 Animation Job」「可控制圖結構與更新時機」等動畫控制的彈性
1.5. 關於 Animation C# Jobs 的使用與 SIMD 支援
「想以程序化方式控制動畫」的需求在遊戲開發中必定會出現。例如「想讓角色的腳配合地面形狀貼地」等情況。
此時可採取的手段之一是 Two-Bone IK。
實際實作 Two-Bone IK 這類程序化動畫控制時,有 3 個選項。
- 在
LateUpdate中直接改寫 Transform - 在
AnimationScriptPlayable中插入IAnimationJob - 在 2 的基礎上再以 Burst 編譯
本次聚焦於這些手法的效能。
3 種實作皆進行完全相同的運算。解法抽出為 1 個 static 方法,由 LateUpdate 版、Job 版、Burst 版共用,因此差異只在於執行的位置。
1.5.1. 什麼是 Animation C# Jobs
Animation C# Jobs 是透過 AnimationScriptPlayable 與 IAnimationJob,將自己的處理插入動畫評估管線中的機制。Job 會在與 Clip 評估、混合相同的流程中被呼叫,並透過 AnimationStream 與 TransformStreamHandle 存取骨骼。
與 LateUpdate 的差異在於程式碼執行的位置。LateUpdate 在主執行緒上,直接改寫動畫評估結束後的 Transform。處理會依角色數在主執行緒上串列堆疊。Animation Job 則在評估管線內部(Animation Job Thread)被呼叫,因此 Unity 可以像其他動畫評估一樣將其分散到工作執行緒。即使是相同的運算,是否成為主執行緒的負擔也會不同。
必須經由 AnimationStream 存取的限制是其代價。Job 只能看到事先綁定的 Handle,無法存取任意的 Transform 或 GameObject。
1.5.2. 實作
Job 本體只是在 ProcessAnimation 中呼叫解法。
清單 1.6: Two-Bone IK 的 Animation Job(支援 Burst)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 | [BurstCompile] public struct TwoBoneIkJobBurst : IAnimationJob { public TransformStreamHandle Root; public TransformStreamHandle Mid; public TransformStreamHandle Tip; public NativeArray<float3> Target; // 長度 1。每個影格由主執行緒寫入 public float Weight; public int Iterations; public void ProcessRootMotion(AnimationStream stream) { } [BurstCompile] public void ProcessAnimation(AnimationStream stream) { TwoBoneIkCore.SolveStreamIterations( ref stream, Root, Mid, Tip, Target[0], Weight, Iterations); } } |
骨骼的讀寫以 TransformStreamHandle 與 AnimationStream 的組合進行。
清單 1.7: 從 AnimationStream 讀寫骨骼
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 | static void SolveStream( ref AnimationStream stream, TransformStreamHandle root, TransformStreamHandle mid, TransformStreamHandle tip, float3 target, float weight) { var rootPosition = (float3)root.GetPosition(stream); var midPosition = (float3)mid.GetPosition(stream); var tipPosition = (float3)tip.GetPosition(stream); var rootRotation = (quaternion)root.GetRotation(stream); var midRotation = (quaternion)mid.GetRotation(stream); Solve(rootPosition, midPosition, tipPosition, target, rootRotation, midRotation, weight, out var newRootRotation, out var newMidRotation); mid.SetRotation(stream, newMidRotation); root.SetRotation(stream, newRootRotation); } |
Handle 以 Animator.BindStreamTransform 建立,Job 則作為 Clip 的後段插入圖中。
清單 1.8: 將 Animation Job 插入圖中
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | var job = new TwoBoneIkJobBurst { Root = animator.BindStreamTransform(rootTransform), Mid = animator.BindStreamTransform(midTransform), Tip = animator.BindStreamTransform(tipTransform), Target = ikTarget, // NativeArray<float3> Weight = 1f, Iterations = iterations, }; var ikPlayable = AnimationScriptPlayable.Create(graph, job, 1); graph.Connect(clipSource, 0, ikPlayable, 0); // clipSource = Clip 端的 Mixer ikPlayable.SetInputWeight(0, 1f); output.SetSourcePlayable(ikPlayable); |
IK 目標這類每個影格都會變化的輸入放在 NativeArray 中,由主執行緒寫入。
Burst 是透過為類別加上 BurstCompile 屬性來套用。
Burst Compiler 的最佳化是否實際生效,可以使用 Burst Inspector 等工具確認。
1.5.3. 實際測量
300 個角色、停用 Renderer。每個角色的 IK 解法次數分別設為 1 / 16 / 64。
表 1.9: 各 IK 解法次數的影格時間(300 個角色、停用 Renderer)
| 實作 | 1 次 | 16 次 | 64 次 |
|---|---|---|---|
| 無 IK(基準) | 2.501 ms | 2.601 ms | 2.596 ms |
| LateUpdate | 2.699 ms | 4.400 ms | 9.094 ms |
| Animation Job | 2.411 ms | 2.496 ms | 2.795 ms |
| Animation Job + Burst | 2.494 ms | 2.496 ms | 2.792 ms |
CPU 時間的細項(64 次時):
表 1.10: 各 IK 實作的 CPU 時間細項(解法 64 次)
| 實作 | IK 的 CPU 時間(全執行緒) | 其中主執行緒 | 對影格時間的增加量 |
|---|---|---|---|
| LateUpdate | 6.910 ms | 6.910 ms(100 %) | +6.498 ms |
| Animation Job | 7.790 ms | 0.487 ms(6.3 %) | +0.199 ms |
| Animation Job + Burst | 6.932 ms | 0.436 ms(6.3 %) | +0.196 ms |
1.5.4. 從 Profiler Timeline 觀察執行執行緒的差異
相同的運算在哪個執行緒上執行,會顯示在 Unity Editor 的 Profiler 中。以下是將解法 64 次、300 個角色的擷取結果在 Profiler 視窗中開啟,並選取影格時間中位數附近的影格。由於是連接 Profiler 時的擷取結果,與上表的數值並不完全一致。
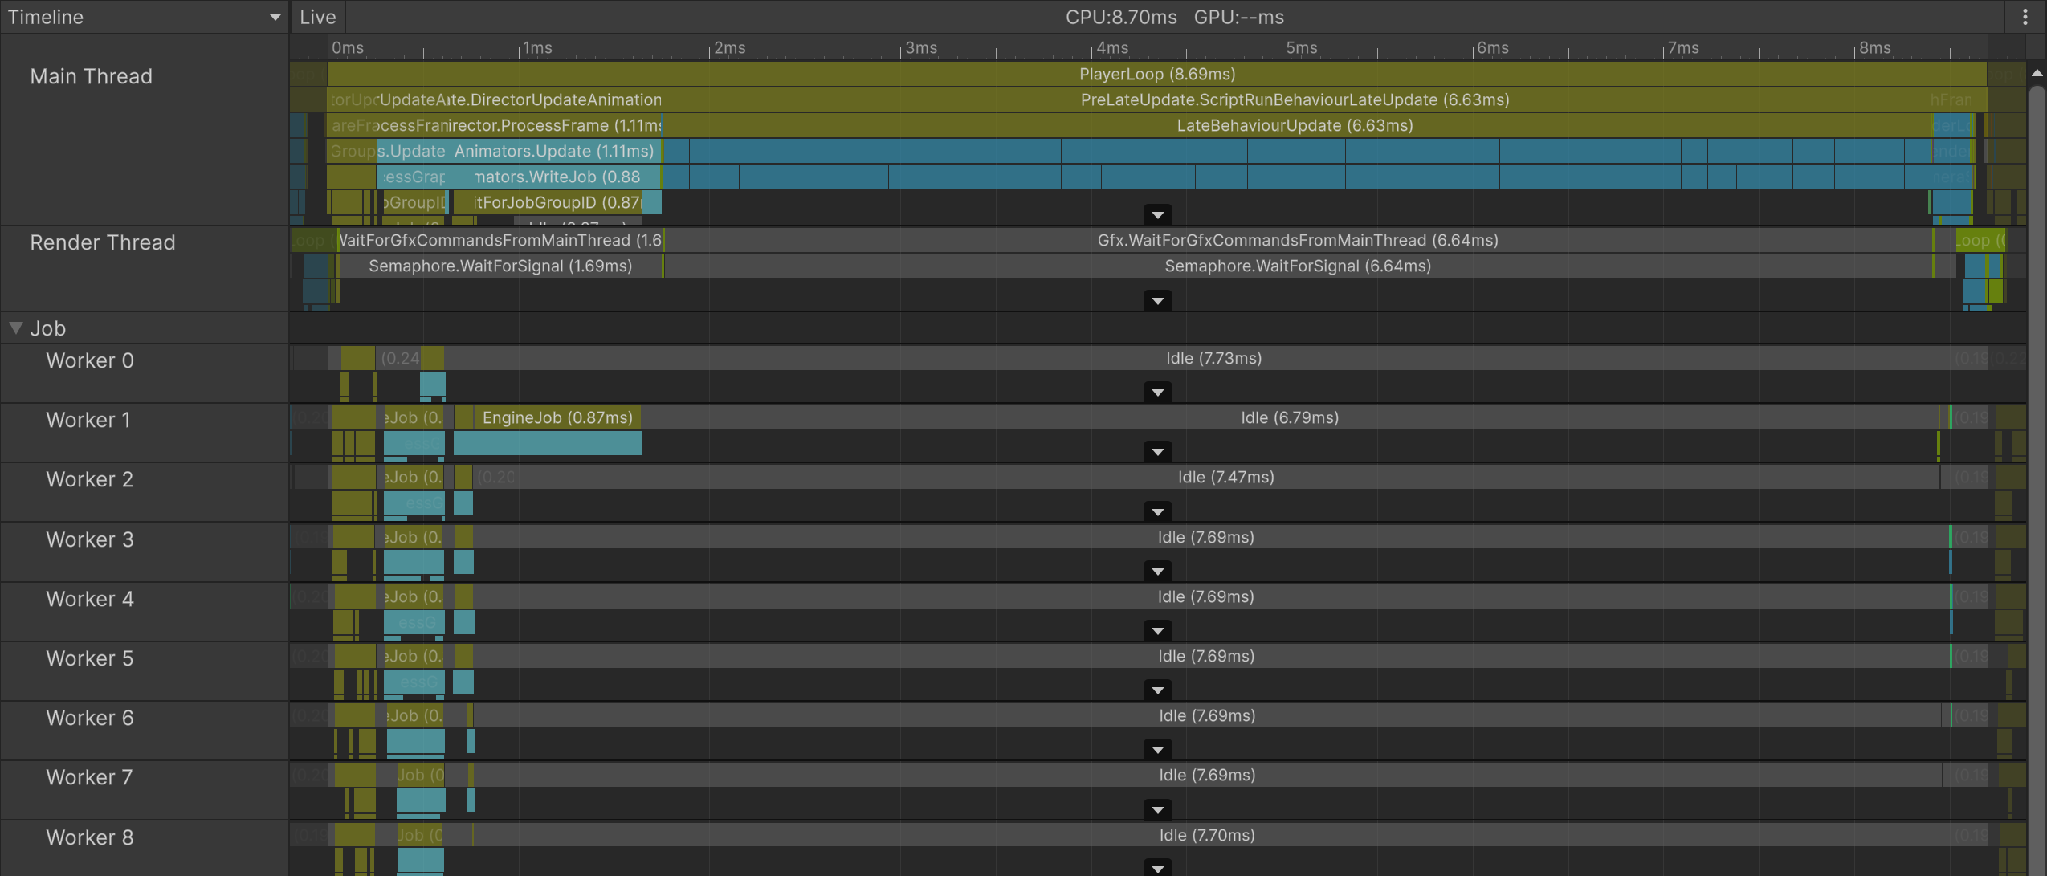
圖 1.7: LateUpdate 實作。在 8.698 ms 的影格時間中 LateBehaviourUpdate 占 6.63 ms。15 條工作執行緒在影格的大半時間(約 6.8〜7.7 ms)都維持 Idle。
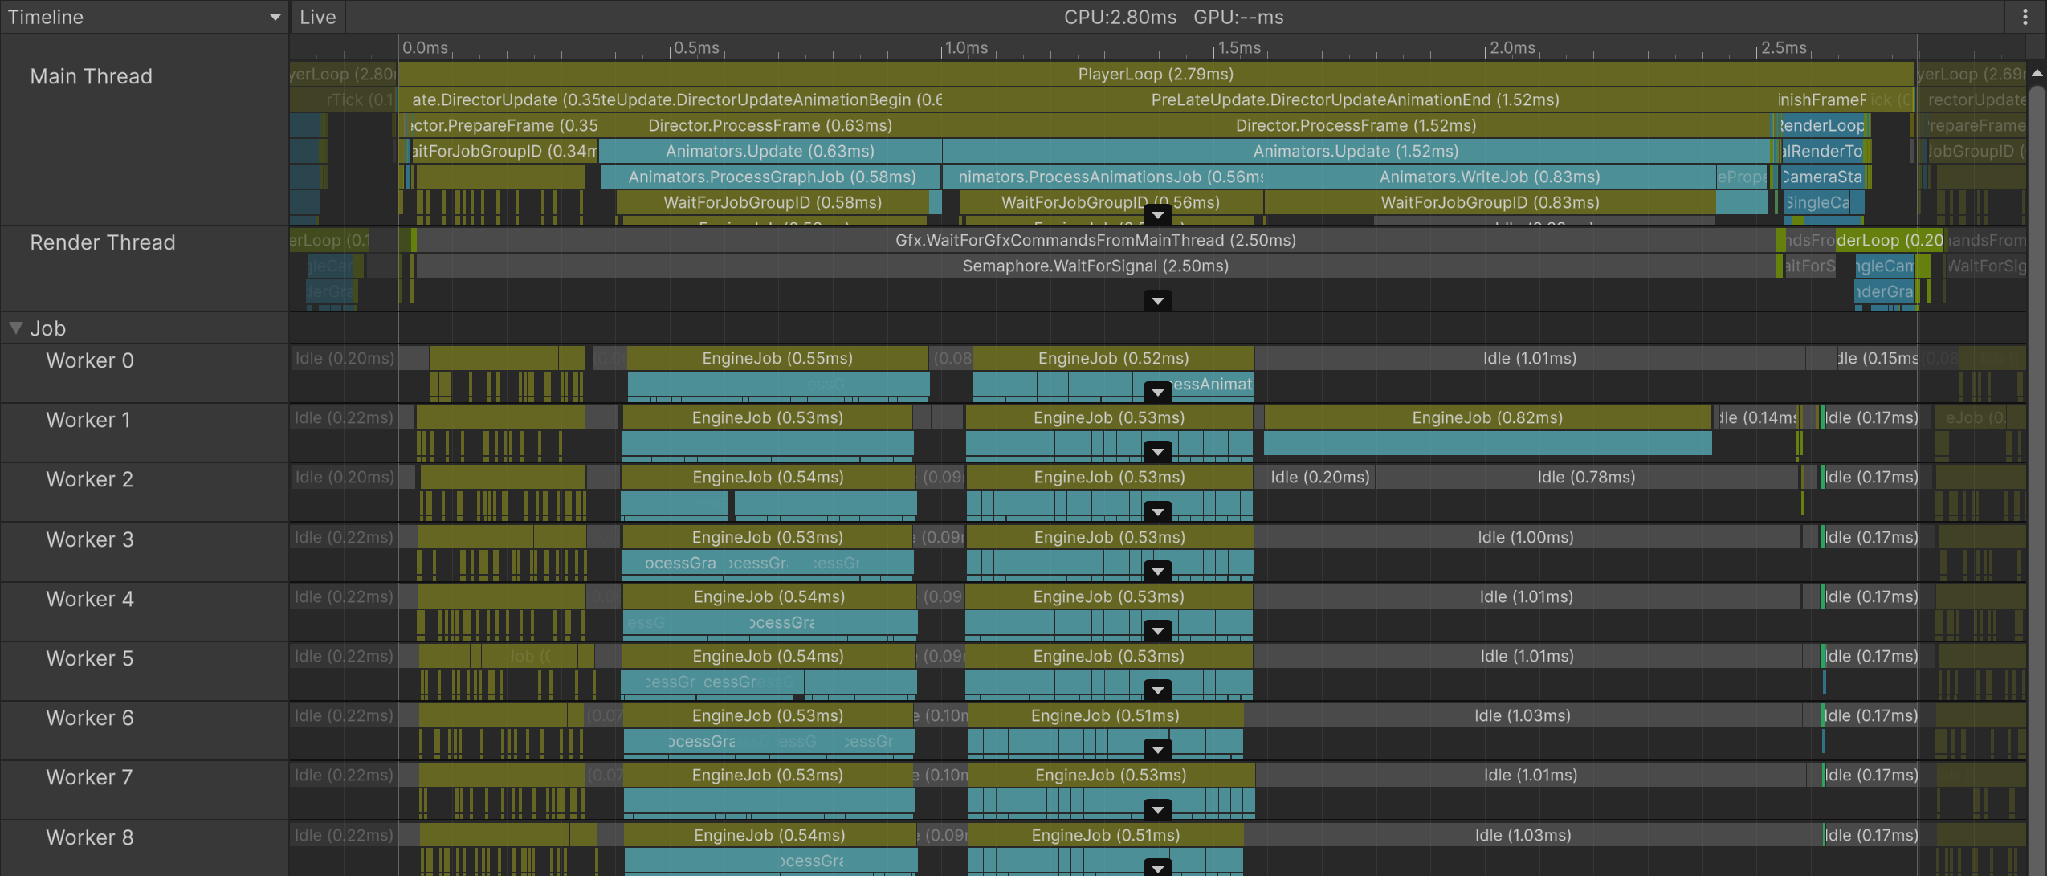
圖 1.8: Animation Job 實作。相同的運算以 AnimationScriptPlayable.ProcessAnimation 的形式分散到 15 條工作執行緒,每條各執行約 0.5 ms。影格時間為 2.796 ms。
在 LateUpdate 實作中,300 個角色的 ATB.TwoBoneIk.LateUpdate(合計 6.577 ms)全部位於主執行緒的 LateBehaviourUpdate 之中。此時工作執行緒負責的只有基礎的動畫評估(Animator.ProcessGraph 每條 0.12〜0.29 ms),沒有任何 IK 計算。
在 Animation Job 實作中,AnimationScriptPlayable.ProcessAnimation 的全執行緒合計為 7.891 ms,其中主執行緒為 0.498 ms。其餘的 7.393 ms 幾乎均等地分散到 15 條工作執行緒(每條 0.47〜0.51 ms)。總 CPU 時間雖然比 LateUpdate 實作多,但因為分攤到 16 條執行緒,影格時間收斂在 8.698 → 2.796 ms。
1.5.5. 可以解讀出的事
就本案例的最佳化而言,最有效的不是 Burst,而是轉移執行執行緒。 LateUpdate 實作把 IK 的 CPU 時間全部由主執行緒負擔,因此在 64 次時影格時間膨脹為 2.596 → 9.094 ms。把相同的運算移到 Animation Job 後,主執行緒的負擔幾乎消失,對影格時間的增加量出現 33 倍的差距。
另一方面,總 CPU 時間則是 LateUpdate 版較少。Animation Job 每個 AnimationScriptPlayable 節點都有固定成本,300 個角色約為 2.16 ms。即便如此,平行化的收益仍遠遠超過。
在接近實際運用的「1 個角色 1 次」條件下,3 種實作的差異幾乎在測量雜訊的範圍內。300 個角色左右的 Two-Bone IK,不論選擇哪種實作都感受不到差異。
1.5.6. Burst 光加上屬性是不會生效的
「加上 [BurstCompile] 就會變成 SIMD、快上數倍」的理解是錯誤的。在本次的實際測量中,Burst 帶來的總 CPU 時間削減為 11.0 %。以扣除節點固定成本後的「每次解法的邊際成本」來看,
- 無 Burst:(7.790 − 2.157) / 63 = 0.0894 ms
- 有 Burst:(6.932 − 2.167) / 63 = 0.0756 ms(−15.4 %)
Burst 所做的是以 LLVM 產生原生程式碼,是否產生 SIMD 指令取決於所寫程式碼的形式。若沒有實作出能適當 SIMD 化的程式碼,就無法獲得大的好處。
Animation C# Jobs 有 2 項讓 SIMD 化變得困難的性質。
AnimationStream 的讀寫頻繁出現在處理之中。每次解法都要以 GetPosition、GetRotation 讀取骨骼,再以 SetRotation 寫回。每次迭代都會改變 Stream 的狀態,迭代之間殘留相依關係,無法將多次解法合併為 1 條向量指令。此外,IAnimationJob 收到的 AnimationStream 只有 1 個角色的量,Job 中原本就沒有「同時計算 4 個角色」所需的資料。
大量使用超越函數。由餘弦定理求彎曲角度的 acos、quaternion.AxisAngle 內部呼叫的三角函數、math.length 的平方根。這些會變成跨 Lane 的計算或純量的函式庫呼叫,阻止向量化。
Burst 的 LLVM 也會對反覆呼叫解法的迴圈明確報告無法向量化(最佳化備註 loop not vectorized: instruction return type cannot be vectorized)。
1.5.7. 充分發揮 Burst 好處的策略
若想充分發揮 Burst 的好處,可以考慮使用 C# Job System、不經由 AnimationStream 直接讀寫 Transform 的組成。Transform 的讀寫可以用 TransformAccessArray 與 IJobParallelForTransform 彙整到 Job 端,也可以只把骨骼的收集與寫回交給 Animation Job,而將繁重的計算抽出為彙整 N 個角色的批次 Job。兩者都不是以角色為單位,而是N 個角色的資料集中在同一個 Job 中,因此 SIMD 化的前提得以成立。
在此之上,批次 Job 的內容需要如下整理。
- 改為 1 個分量 1 個陣列的 SoA(Structure of Arrays),讓角色在記憶體上連續
- 將分支替換為
math.select或math.max,讓迴圈本體成為一條直線 - 把超越函數移出迴圈(以恆等式改寫、製成查表、近似)
- 不使用
float3而是以float4寫成「4 個角色各占 1 個 Lane」,不依賴自動向量化的判斷
代價是設計的複雜度。IAnimationJob 最大的優點是只要在圖中插入 1 個節點,就能在評估管線的正確時機存取骨骼的最新狀態,這個策略等於放棄了這項便利。本文並未對此組成進行實際測量,因此這裡不呈現能快多少。請將它視為一項提議:若期待 Burst 帶來數倍的效果,就必須以這個方向的設計變更為前提。
1.5.8. 本章結論
- Animation Job 的價值在於能活用 Animation Job Thread
- 運算量少時,
AnimationScriptPlayable的節點固定成本反而較大。直接以 LateUpdate 撰寫的總 CPU 時間較少 [BurstCompile]光加上去不會變成 SIMD。必須進行以套用 SIMD 為前提的資料與處理設計
1.6. 動畫 LOD 的實作
1.6.1. 機制與有效的場合
雖然視遊戲規格而定,但基本上遠處的角色不需要每個影格都更新。若每 N 個影格只更新 1 次,該角色的平均負載就是 1/N。這就是「動畫 LOD」。把網格 LOD 依距離分段控制繪製成本的相同思路,套用到動畫的更新頻率上。
在下列場合有效。
- 畫面內有數百個角色,大多是遠景或路人
- 遠處角色相當於 30 fps / 15 fps 的動作在體感上可以接受(攝影機越遠,降頻越不易被察覺)
- 動畫評估在影格時間中占了不可忽視的比例
反之,若套用在近距離、被攝影機大幅特寫的角色上,卡頓會立刻被察覺。實際運用時,預期會依距離或螢幕占比切換降頻等級。
1.6.2. 簡單的實作:自行呼叫 Animator.Update()
設為 animator.enabled = false 以停止 Unity 的自動更新,只在需要的影格明確呼叫 Animator.Update()。跳過的影格的時間會累積後再傳入。
這個實作有一個副作用:會失去前面說明過的 Animation Job Thread 上的平行性。
清單 1.9: 自行呼叫 Animator.Update() 的降頻實作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 | animator.enabled = false; // 初始化時。停止 Unity 的自動更新 void Update() { foreach (var character in _characters) { character.PendingDeltaTime += Time.deltaTime; if (_frameIndex % interval != character.Slot) continue; // Slot = index % interval character.Animator.Update(character.PendingDeltaTime); // 以累積的時間明確更新 character.PendingDeltaTime = 0f; } _frameIndex++; } |
1.6.3. 直接使用 Playable API 的實作範例
若是手動更新(DirectorUpdateMode.Manual)的 Playable Graph,只要對 Evaluate() 的呼叫本身降頻即可。
清單 1.10: 對手動更新圖的 Evaluate() 降頻的實作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | graph.SetTimeUpdateMode(DirectorUpdateMode.Manual); graph.Play(); void Update() { foreach (var character in _characters) { character.PendingDeltaTime += Time.deltaTime; if (_frameIndex % interval != character.Slot) continue; character.Graph.Evaluate(character.PendingDeltaTime); character.PendingDeltaTime = 0f; } _frameIndex++; } |
有 1 點需要注意。在前一章推薦的「將全部角色彙整到 1 張圖」的組成中,整張圖以 1 次 Evaluate() 評估,因此無法表現以角色為單位的降頻。如上方程式碼那樣改為 1 個角色 1 張圖就能降頻,但相對地會失去彙整帶來的平行化。
不論哪種實作,重要的都是 Slot(相位)。若所有角色都在同一個影格更新,負載就會集中在該影格。以 index % interval 錯開相位,就會變成每個影格各更新 1/N 的角色。
1.6.4. 實際測量
600 個角色、停用 Renderer。首先是 Animator 的實作。
平均值代表 12 秒內的總負載,中位數與 p95 的差距代表影格時間的波動程度。
表 1.11: 降頻與錯開相位的影格時間統計(Animator、600 個角色)
| 方式 | 平均 | 中位數 | p95 | p99 | 最大 | 標準差 |
|---|---|---|---|---|---|---|
| 每個影格更新(Animator 自動) | 5.037 ms | 5.000 ms | 5.303 ms | 5.707 ms | 16.901 ms | 0.433 |
| 每 2 個影格 1 次、無相位 | 4.781 ms | 0.648 ms | 9.607 ms | 9.816 ms | 12.194 ms | 4.544 |
| 每 2 個影格 1 次、錯開相位 | 4.831 ms | 4.803 ms | 5.099 ms | 5.212 ms | 8.804 ms | 0.171 |
| 每 4 個影格 1 次、無相位 | 2.613 ms | 0.382 ms | 9.470 ms | 9.658 ms | 11.171 ms | 3.863 |
| 每 4 個影格 1 次、錯開相位 | 2.578 ms | 2.593 ms | 2.707 ms | 2.908 ms | 11.722 ms | 0.185 |
Playable API(1 個角色 1 張圖、手動更新)也呈現相同趨勢。
表 1.12: 降頻與錯開相位的影格時間統計(Playable API、1 個角色 1 張圖)
| 方式 | 平均 | 中位數 | p95 | 標準差 |
|---|---|---|---|---|
| 每個影格更新 | 8.496 ms | 8.493 ms | 9.001 ms | 0.337 |
| 每 4 個影格 1 次、無相位 | 2.438 ms | 0.369 ms | 8.855 ms | 3.570 |
| 每 4 個影格 1 次、錯開相位 | 2.486 ms | 2.495 ms | 2.613 ms | 0.173 |
1.6.5. 錯開相位不是「減少負載」而是「攤平負載」
降頻到 1/4 時的平均值,無論有無相位幾乎沒有差別,總負載幾乎相同。錯開相位並沒有減少工作量。
另一方面,影格時間的分布出現了以下差異。
- 無相位:4 個影格中有 3 個影格什麼都不做,在 1 個影格中集中處理 600 個角色。中位數下降,但 p95 與標準差暴增
- 錯開相位:每個影格各處理 150 個角色。中位數與 p95 幾乎一致,波動小
若只看中位數 0.382 ms 這個數字就為「變成 1/13 了」而高興,實際上做出來的會是每 4 個影格就有 1 次 9.5 ms 尖峰的遊戲。錯開相位是為了體感品質的措施,標準差 0.185 比每個影格更新的 0.433 更穩定。
這種分布差異會直接顯示在 Profiler 的 CPU 圖表上(兩者皆為連接 Profiler 時的擷取結果,因此比上表未連接時的數值略重。另外圖表的縱軸刻度為自動調整,兩張圖並不相同)。
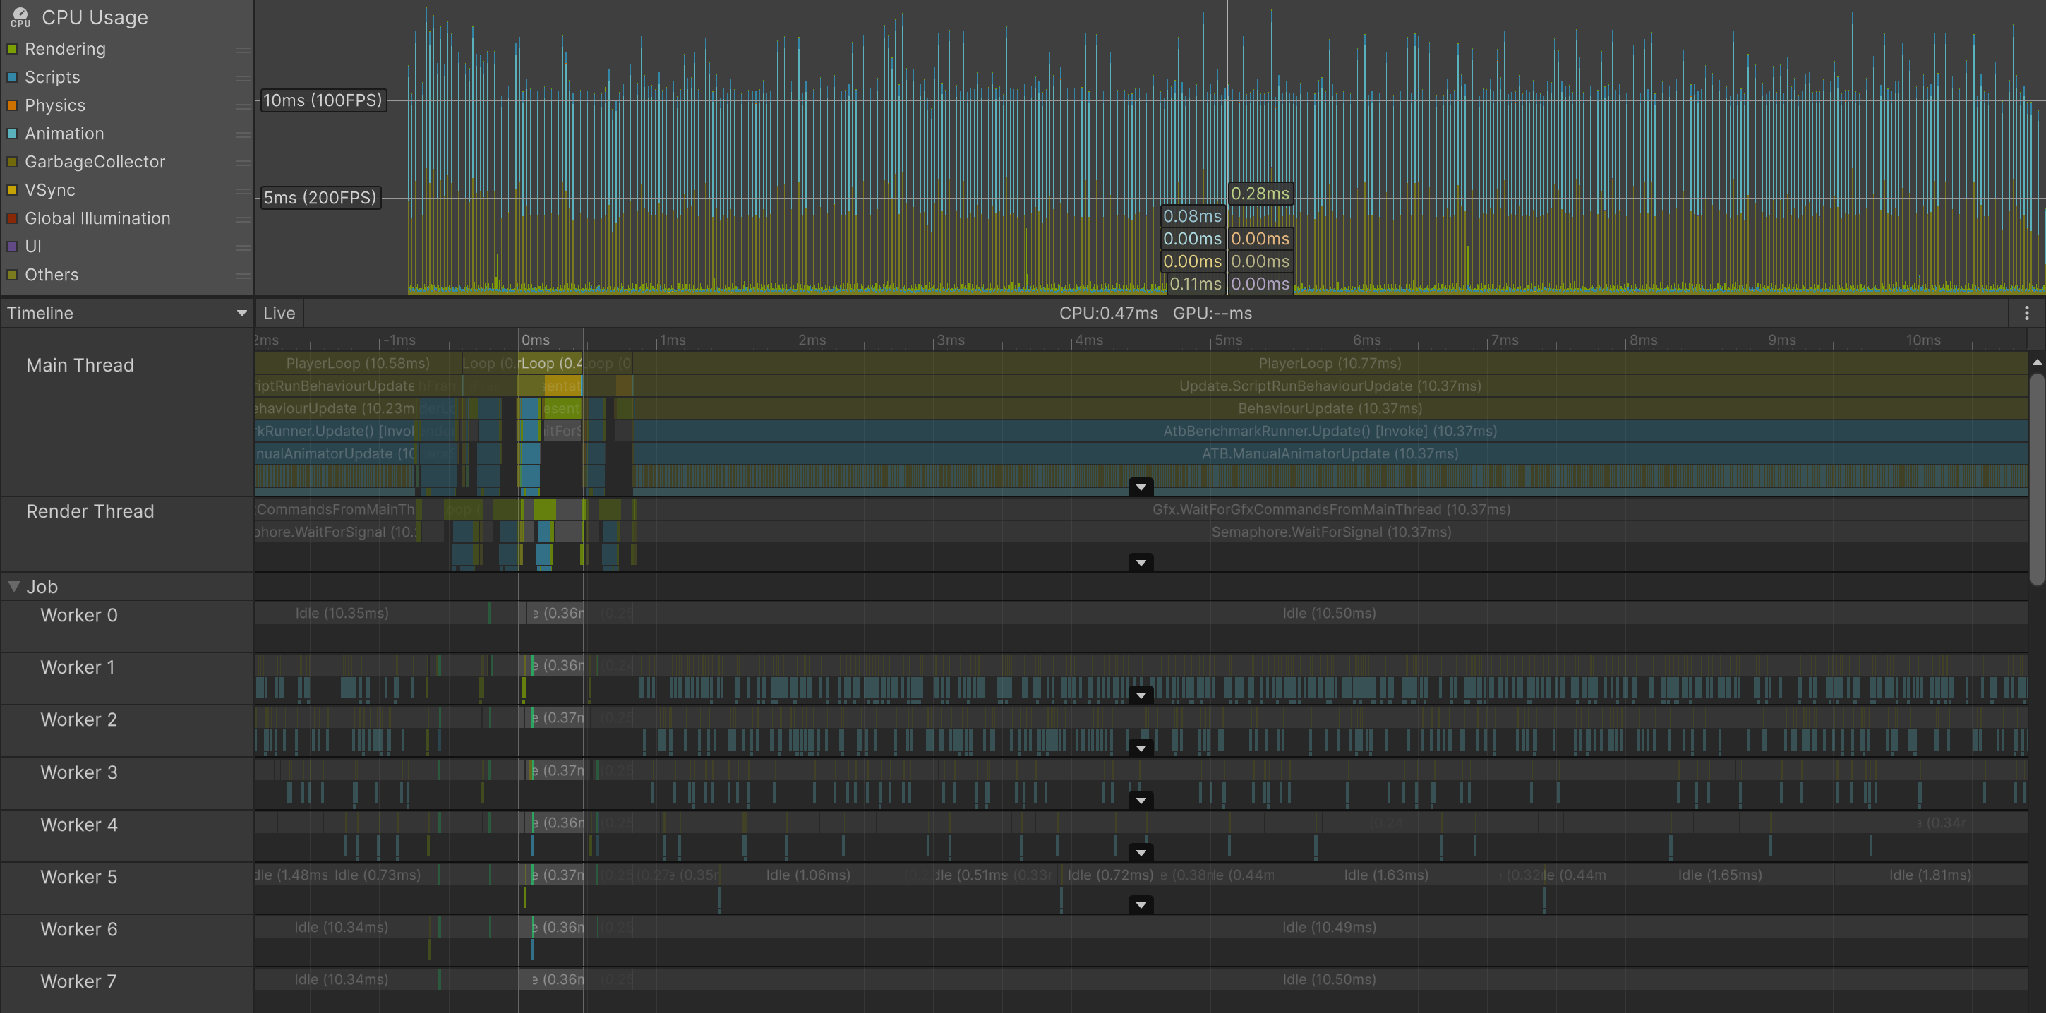
圖 1.9: 每 4 個影格 1 次、無相位。CPU 圖表呈現「幾乎 0 ms 的谷 3 個影格 + 約 10 ms 的尖峰 1 個影格」的梳狀。下方的 Timeline 中,選取中的空影格(0.47 ms)兩側,可見集中處理 600 個角色的 ATB.ManualAnimatorUpdate(10.37 ms)影格。
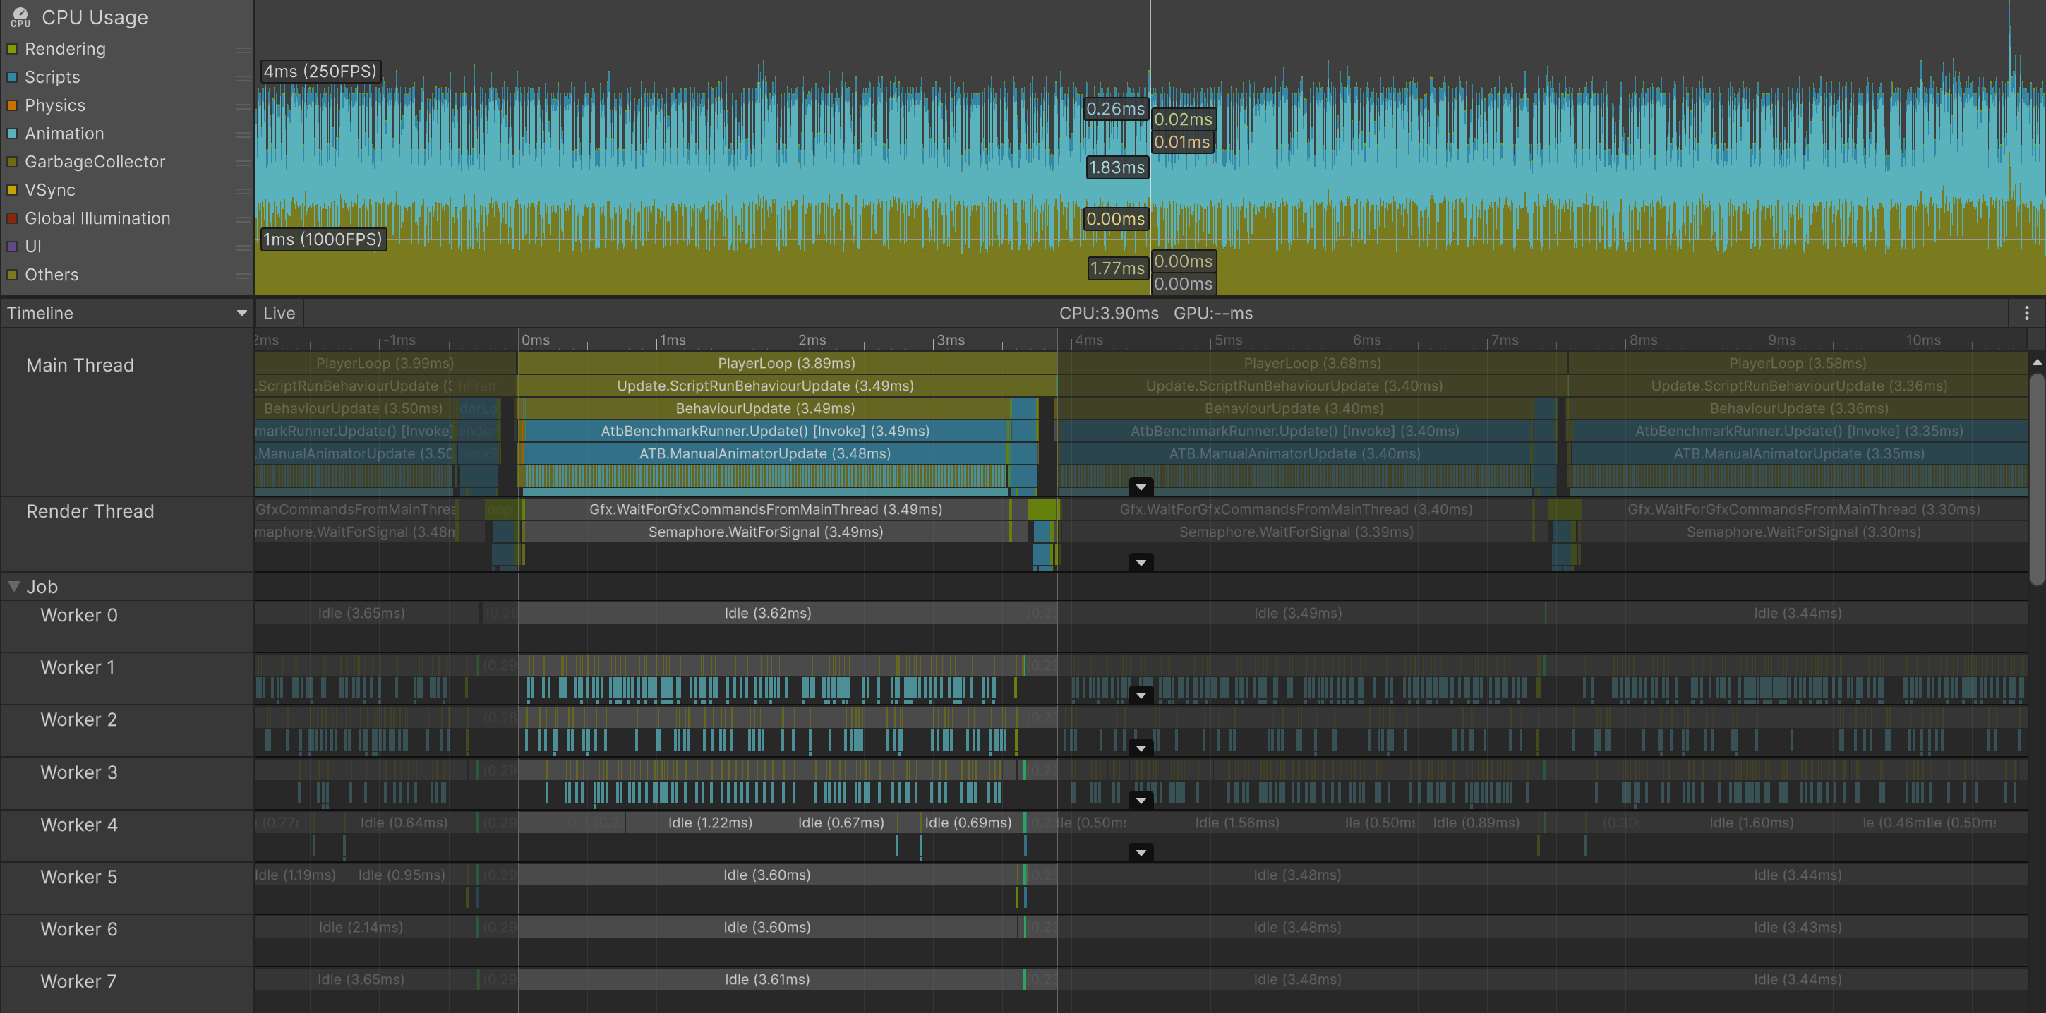
圖 1.10: 每 4 個影格 1 次、錯開相位。每個影格各處理 150 個角色,因此波形平坦(約 3.5 ms),尖峰消失。
1.6.6. 樸素的實作會失去平行化
每 2 個影格 1 次的降頻,幾乎什麼都沒削減。更新次數減半,平均影格時間的削減卻只有 4.1 %。
理由可從 Profiler 標記的細項得知。
表 1.13: 樸素的降頻實作所失去的平行性
| 方式 | 1 個影格更新的角色數 | 主執行緒的動畫更新時間 | Animator.ProcessGraph 全執行緒合計 | 其中主執行緒 |
|---|---|---|---|---|
| 每個影格更新(Unity 的批次更新) | 600 | Animators.Update 4.046 ms | 20.104 ms | 1.257 ms |
| 每 2 個影格 1 次、錯開相位 | 300 | ATB.ManualAnimatorUpdate 4.532 ms | 0.549 ms | 0.317 ms |
| 每 4 個影格 1 次、錯開相位 | 150 | ATB.ManualAnimatorUpdate 2.316 ms | 0.278 ms | 0.180 ms |
每個影格更新時,工作中留在主執行緒的只有 6 %,其餘分散到工作執行緒。另一方面,明確呼叫 Animator.Update() 時會當場同步評估,因此幾乎不會用到工作執行緒。這等於以降頻為代價,放棄了 Unity 批次更新原本具備的平行化。
換算成每個角色的主執行緒成本,
- 每個影格更新:4.046 ms / 600 個角色 = 6.7 µs/角色(平行)
- 每 2 個影格 1 次:4.532 ms / 300 個角色 = 15.1 µs/角色(串列)
- 每 4 個影格 1 次:2.316 ms / 150 個角色 = 15.4 µs/角色(串列)
一旦串列化,每個角色的成本就變為約 2.3 倍,之後則與降頻倍率無關、維持固定。也就是說,2 倍降頻所獲得的 2 倍削減,幾乎被串列化造成的 2.3 倍惡化抵銷。實際測量的 4.1 % 只是其殘差。
維持樸素的實作時,要到 4 倍降頻(−48.8 %)才終於出現實質的效果。不過,這是可以避免的損失。
1.6.7. 在保持平行性的同時降頻
Animator.Update() 是同步的,這點無法避免。但只要改為「每個影格挑選要參與 Unity 批次更新的角色」的形式,就能在降頻的同時保持平行性。有 2 種實作方式,兩者都仍然使用 Animator(及其狀態機)。
方法 1:切換 Animator.enabled
Unity 的動畫更新會收集當下已啟用的 Animator 組成 1 個批次,分散到 Animation Job Thread。因此不必呼叫 Animator.Update(),只要把該影格想更新的角色設為 enabled = true 即可。評估由 Unity 進行,平行化原封不動地保留。
清單 1.11: 切換 Animator.enabled 的降頻實作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 | // 初始化時。跳過的影格以 speed 補回 foreach (var character in _characters) { var animator = character.Animator; animator.keepAnimatorStateOnDisable = true; // 停用時不回捲狀態(必要) animator.speed = interval; // 補正每 interval 個影格只更新 1 次的部分 } void Update() { foreach (var character in _characters) { var scheduled = _frameIndex % interval == character.Slot; if (character.Animator.enabled != scheduled) { character.Animator.enabled = scheduled; // 只挑選參與 Unity 批次更新的角色 } } _frameIndex++; } |
keepAnimatorStateOnDisable = true 不可忘記。在預設值 false 下,每次停用 Animator 時控制器的狀態都會回捲,動畫就不會前進。
限制在於 Animator.speed 是速率。無法像 Animator.Update(pendingDeltaTime) 那樣「精確傳入累積的 Δt」,只會前進更新影格的 Time.deltaTime × interval。在影格時間波動的環境下,前進量也會波動,但平均播放速度得以維持。
方法 2:依相位拆分圖
前一章的結論是「把 N 個角色彙整到 1 張手動圖就能平行化」。將它與降頻結合。建立與相位數相同數量的圖,1 個影格只 Evaluate() 其中 1 張。1 張圖中有 N/interval 個角色,因此在那 1 次 Evaluate() 中平行化會生效。
狀態機只要以 AnimatorControllerPlayable 的形式放進圖中,就會執行與指派給 Animator 元件時相同的評估。
清單 1.12: 依相位拆分圖的降頻實作
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 | // 初始化時:每個相位 Bucket 各 1 張手動圖 for (var bucket = 0; bucket < interval; bucket++) { var graph = PlayableGraph.Create($"Bucket_{bucket}"); graph.SetTimeUpdateMode(DirectorUpdateMode.Manual); _bucketGraphs[bucket] = graph; } foreach (var character in _characters) { var graph = _bucketGraphs[character.Slot]; character.Animator.runtimeAnimatorController = null; // 評估交給圖端處理 var output = AnimationPlayableOutput.Create(graph, "Animation", character.Animator); output.SetSourcePlayable(AnimatorControllerPlayable.Create(graph, controller)); } foreach (var graph in _bucketGraphs) graph.Play(); void Update() { for (var bucket = 0; bucket < interval; bucket++) _pendingDeltaTime[bucket] += Time.deltaTime; var scheduled = _frameIndex % interval; _bucketGraphs[scheduled].Evaluate(_pendingDeltaTime[scheduled]); // 1 個影格只處理 1 個 Bucket _pendingDeltaTime[scheduled] = 0f; _frameIndex++; } |
這種做法可以將累積的 Δt 原樣傳給 Evaluate(),因此前進量精確。相對地,需要持有與降頻等級數相同數量的圖,要動態變更 LOD 等級時必須把角色在圖之間移動(重新建立輸出)。
實際測量:3 種實作的比較
600 個角色、停用 Renderer。為平均影格時間,以及相對於每個影格更新(5.037 ms)的削減率。
表 1.14: 3 種降頻實作的影格時間比較(600 個角色)
| 實作 | 1/2 降頻 | 1/4 降頻 |
|---|---|---|
明確呼叫 Animator.Update()(錯開相位) | 4.831 ms(−4.1 %) | 2.578 ms(−48.8 %) |
切換 Animator.enabled | 3.350 ms(−33.5 %) | 1.835 ms(−63.6 %) |
依相位拆分的手動圖(AnimatorControllerPlayable) | 3.082 ms(−38.8 %) | 1.541 ms(−69.4 %) |
樸素的實作最不划算。尤其是 1/2 降頻時差距很大,−4.1 % 變成了 −33.5 % / −38.8 %。前一節「2 倍降頻會被平行化的損失吃掉」的結論,只要改變實作就不成立。
平行性得以保留這點,可以透過 Profiler 標記確認。
表 1.15: 3 種降頻實作的各執行緒細項
| 方式 | Animator.ProcessGraph 全執行緒合計 | 其中主執行緒 | 主執行緒端的更新時間 |
|---|---|---|---|
| 每個影格更新(600 個角色/影格) | 20.104 ms | 1.257 ms | Animators.Update 4.046 ms |
Animator.Update()、1/4(150 個角色/影格) | 0.278 ms | 0.180 ms | ATB.ManualAnimatorUpdate 2.316 ms |
Animator.enabled、1/4(150 個角色/影格) | 4.424 ms | 0.288 ms | Animators.Update 1.104 ms + 切換 0.125 ms |
| 依相位拆分的手動圖、1/4(150 個角色/影格) | 4.253 ms | 0.279 ms | ATB.BucketEvaluate 1.278 ms |
在新的 2 種實作中,Animator.ProcessGraph 的工作量恰好是每個影格更新的 1/4(1 個影格只評估 150 個角色,理所當然),而且這些工作仍然分散在工作執行緒上。另一方面,Animator.Update() 版幾乎不會計入這個標記,工作的本體位於主執行緒的 ATB.ManualAnimatorUpdate 之中。
以每個角色的主執行緒成本排列,差異就很明顯。
- 每個影格更新:4.046 ms / 600 個角色 = 6.7 µs/角色
- 切換
Animator.enabled、1/4:1.229 ms / 150 個角色 = 8.2 µs/角色 - 依相位拆分的手動圖、1/4:1.278 ms / 150 個角色 = 8.5 µs/角色
Animator.Update()、1/4:2.316 ms / 150 個角色 = 15.4 µs/角色
新的 2 種實作,每個角色的成本幾乎維持與每個影格更新相同(差異為切換或 Evaluate 呼叫的額外負擔)。因此降頻倍率會直接接近削減率。
也確認了播放速度得以維持。測量最後生成的角色(相位槽最大的角色)指尖骨骼每秒移動的距離,相對於每個影格更新的 0.509 m/s,切換 Animator.enabled 為 0.496 m/s,依相位拆分的手動圖為 0.517 m/s。差異在降頻使動作被直線近似所造成的誤差範圍內,兩者的速度都沒有改變。
關於分布有 1 點需要注意。1/2 降頻的手動圖版 p99 為 9.102 ms、標準差 1.086,比切換 enabled 版(p99 4.100 ms、標準差 0.562)的尾部更重。1/4 時則相反,手動圖版較穩定(標準差 0.306 對 0.340)。行為會隨圖的數量與每張圖的角色數之間的平衡而改變,若要採用,請不要只看平均,也要看 p99。
選擇哪一種取決於需求。若想繼續沿用 Animator 的狀態機與 Inspector 的工作流程,切換 Animator.enabled 壓倒性地簡便(數行即可完成,對既有程式碼幾乎沒有影響)。若需要前進量的精確性,或是插入 Animation Job 這類圖端的控制,就選依相位拆分的手動圖。不論哪一種,都沒有理由選擇自行呼叫 Animator.Update() 的實作。
1.6.8. 本章結論
- 動畫 LOD 要以「更新頻率的降頻 + 錯開相位」為一組來設計
- 錯開相位不會減少總負載(平均 2.613 對 2.578 ms)。減少的是影格時間的波動(標準差 3.863 → 0.185),這是為了體感品質的措施
- 不要選擇自行呼叫
Animator.Update()的實作。因為會當場同步評估而失去 Job 平行化,每個角色的主執行緒成本從 6.7 → 15.4 µs,變為約 2.3 倍 - 改為每個影格挑選要參與 Unity 批次更新的角色。做法是切換
Animator.enabled(需要keepAnimatorStateOnDisable = true與以Animator.speed補正),或是依相位拆分手動圖並掛載AnimatorControllerPlayable。每個角色可控制在 8.2〜8.5 µs,平行化也得以保留 - 改變實作後即使 2 倍降頻也有效:−4.1 % 變成了 −33.5 % / −38.8 %。4 倍則為 −63.6 % / −69.4 %
- 以角色為單位的降頻無法在 1 張彙整圖中表現。不過若「依相位數拆分圖」,就能兼顧平行化與更新頻率控制
- 不要只憑中位數判斷。總負載看平均,體感看 p95、p99 與標準差
1.7. 總結
以下是各章的實際測量結果。
表 1.16: 各章實際測量結果彙整
| 章 | 措施 | 條件 | 結果 |
|---|---|---|---|
| 資產設定 | Optimize Game Objects | 600 個角色、Renderer 1 個 | 6.797 → 5.991 ms(−11.9 %) |
| 資產設定 | Optimize Hierarchy(執行階段) | 600 個角色、Renderer 1 個 | 6.797 → 6.009 ms(−11.6 %) |
| 資產設定 | 上述 2 種手法 | 300 個角色、全 Renderer | 18.205 → 18.3〜18.5 ms(無改善、受繪製限制) |
| Job Thread | 將手動更新圖彙整為 1 張 | 600 個角色 | 8.396 → 4.500 ms(−46.4 %) |
| Animation C# Jobs | 將 Two-Bone IK 改為 Animation Job | 300 個角色、解法 64 次 | 9.094 → 2.795 ms(−69.3 %) |
| Animation C# Jobs | 進一步以 Burst 編譯 | 300 個角色、解法 64 次 | 2.795 → 2.792 ms(影格時間無差異) |
| 動畫 LOD | 1/4 降頻、明確呼叫 Animator.Update() | 600 個角色 | 平均 5.037 → 2.578 ms(−48.8 %) |
| 動畫 LOD | 1/4 降頻、依相位拆分的手動圖 | 600 個角色 | 平均 5.037 → 1.541 ms(−69.4 %) |
| 動畫 LOD | 1/2 降頻、明確呼叫 Animator.Update() | 600 個角色 | 平均 5.037 → 4.831 ms(−4.1 %) |
| 動畫 LOD | 1/2 降頻、依相位拆分的手動圖 | 600 個角色 | 平均 5.037 → 3.082 ms(−38.8 %) |
1.7.1. 最終的最佳化方針
以下是根據本文的實際測量,對大量角色動畫進行最佳化的推進方式。
1. 最佳化資產設定
首先,請將模型本身的頂點數與骨骼數規範訂為適當的值。理想的做法是先在作為基準的支援裝置上進行基準測試,訂定適當的模型規範。在此基礎上,再考慮在 Unity 端套用 Optimize Game Objects。在 3D 作品中,位於上游的模型製作很難在量產已推進的專案後期大幅修正,因此最好在專案初期就完成。
2. 提高 Animation Job Thread 上處理的平行性
Animator 與自動更新的 Playable Graph 會由 Unity 自動平行化,但手動更新只會以圖為單位平行化。在設計角色控制的階段,就請把「能否有效活用 Animation Job Thread」放在心上。
3. 進行包含對 Animation Job 套用 Burst 在內的最佳化
IK 等後處理,首先從主執行緒移到 Animation Job。
若需要更高的效能,請套用可進行 SIMD 化的資料與處理設計。
4. 進行動畫 LOD 等應用程式層面的巧思
在資產、引擎設定、程式碼最佳化都做到極致之後,最後是「根本就不處理動畫」這樣的巧思。
雖然要視專案需求而定,但請一邊摸索遊戲體驗上可接受的界線,一邊考慮抑制處理的機制。
1.8. 註腳
1.8.1. Unity 官方文件
- Playable API
https://docs.unity3d.com/Manual/Playables.html — Playable Graph 的建構與DirectorUpdateMode - AnimatorUtility.OptimizeTransformHierarchy
https://docs.unity3d.com/ScriptReference/AnimatorUtility.OptimizeTransformHierarchy.html — 執行階段的階層扁平化 - Model Import Settings: Rig(Optimize Game Objects)
https://docs.unity3d.com/Manual/FBXImporter-Rig.html - IAnimationJob
https://docs.unity3d.com/ScriptReference/Animations.IAnimationJob.html — 插入AnimationScriptPlayable的 Job - AnimationScriptPlayable
https://docs.unity3d.com/ScriptReference/Animations.AnimationScriptPlayable.html - C# Job System
https://docs.unity3d.com/Manual/JobSystem.html — 不經由AnimationStream撰寫平行處理的機制
1.8.2. 使用的資產
- Unity-chan 3D 模型資料(日文)
https://unity-chan.com/ — © Unity Technologies Japan/UCL