按问题分类的反向查询指南
按症状列出了首先应查看的数值,以及涉及该问题的章节。先确认测量的推进方式,之后可按体积、内存、CPU、GPU 的顺序根据问题进行查询。
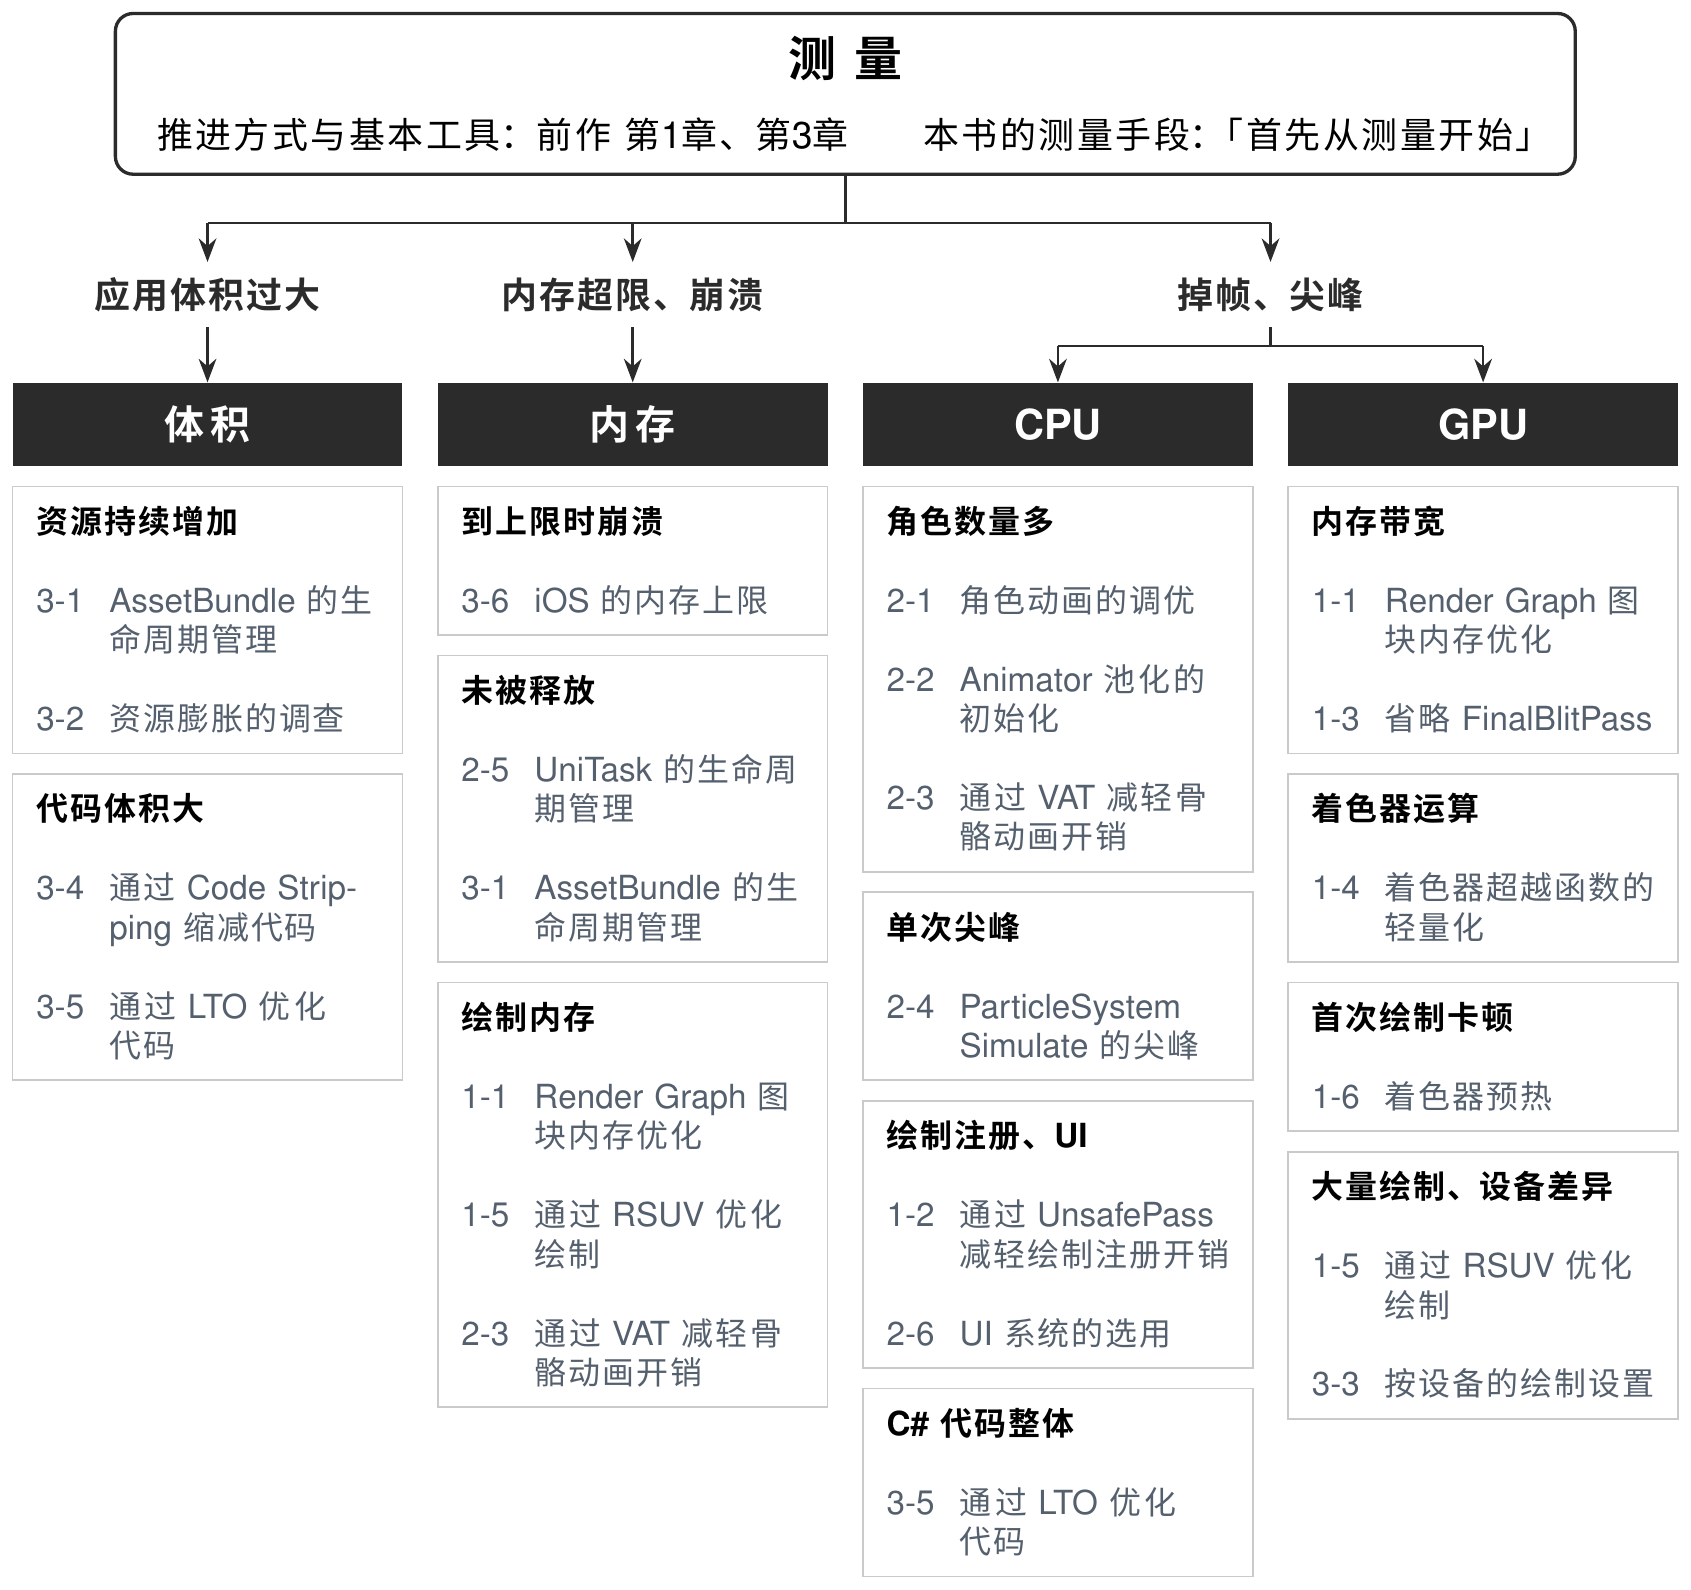
首先从测量开始
先确定哪里慢,再动手。不靠推测而靠测量来确定原因,并在修改前后比较结果,这种推进方式以及内存超限和掉帧的划分方法,已在前作《Unity Performance Tuning Bible》的第 1 章“开始性能调优吧”中讲解。Unity Profiler、Frame Debugger、RenderDoc 等的基本用法也汇总在第 3 章“性能分析工具”中。
这里介绍前作中未涉及的测量手段,以及现有工具中新增可确认的项目。面向 iOS 时,Metal Performance HUD 和 Performance Trace 不依赖 Development Build 标志即可使用,因此即使尚未嵌入测量处理,或在接近发布的配置下,也能大致定位开销。
(第 4 部第 1 章“在 Unity 中活用 iOS 标准的性能测量功能”)
在绘制方面,测量之前先确认管线的状态。Frame Debugger 通过事件名中的 (RP n:m) 标记显示各 Pass 是否已被合并,Render Graph Viewer 除各附件的加载/存储操作和 Memoryless 状态外,还会显示未被合并的原因(Pass Break Reasoning)。想要将 Unity 的显示与传递给驱动的值进行对照时,可用 RenderDoc 捕获 Vulkan,在 API 层面确认 loadOp / storeOp。
(第 1 部第 1 章“Unity 6 Render Graph 图块内存优化”)
如果要每天进行测量,有一种架构是:通过应用内的远程操作让设备农场借出的真机切换画面,并在每次构建时发送内存快照和经过筛选的 Profiler 捕获。其中还涉及在设备上筛选帧的机制、阈值的确定方法,以及让长时间巡回数据适应设备容量的做法。
(第 4 部第 2 章“自动化每日构建的真机性能分析”)
如果希望在评审阶段而非测量阶段发挥作用,可以将本书的经验本身转换为 AI 编程智能体的评估规则。书中介绍了将前作的 77 条规则与本书的 86 条规则整合为 163 条规则并技能化的案例。
(第 4 部第 3 章“将调优宝典做成 AI 编程智能体的技能”)
体积
对于应用体积,在逐个精简资源之前,先对增长的原因分类,能更快地止住增长。压缩设置错误、分辨率过高、多余的附带数据、格式选择失误这 4 种可以在 Import 时判定,而打包方式不一致和 Bundle 之间的重复取决于与其他资源的关系,因此需要在构建前检查。尤其是重复,肉眼看不到。未注册到 Addressables 的共享资源会按引用它的 Bundle 分别复制,因此仅仅是 2 个 Prefab 引用一张 4MB 的纹理,合计就会变成 10MB,而注册到专用 Group 后可降到 6MB。
(第 3 部第 2 章“运营阶段的资源膨胀与使用 Project Auditor 进行调查”)
代码侧也有可削减的空间。将 Managed Stripping Level 从 Minimal 提高到 High 后,即使是只放置了一个结束处理脚本的简单场景,托管程序集也减少了约 6.7%。
(第 3 部第 4 章“Unity Managed Code Stripping 实践指南”)
在此基础上,将哪些资源需要保留到何时作为设计留存下来。将加载和释放的入口集中到基础层,并结合 AssetBundle 的粒度来确定生命周期的分类,就能避免寿命不同的资源混在同一个 Bundle 中。
(第 3 部第 1 章“AssetBundle 的生命周期管理”)
内存
在 iOS 上,有时只需启用 Xcode 的一项设置,就能提高应用所适用的内存上限。在提供的真机观测中,Increased Memory Limit 使 4GB 设备增加了约 240MB 的余量,6GB 设备增加了约 1GB 的余量。不过 3GB 设备上启用与禁用没有差异。如果 footprint 尚有余量却分配失败,可以考虑扩展虚拟地址空间一侧的 Extended Virtual Addressing。
(第 3 部第 6 章“iOS 的内存上限与虚拟地址空间”)
在减少常驻量本身方面,首先怀疑已加载资源的释放遗漏。
(第 3 部第 1 章“AssetBundle 的生命周期管理”)
在异步处理中,CancellationTokenSource 的 Dispose 遗漏会保留来自链接源的引用,表现为不需要的对象无法被释放。
(第 2 部第 5 章“UniTask 与取消处理的生命周期管理”)
绘制侧的内存由结构决定。显示 16 个动画对象时,GPU 内存的增量在 FBX 方式下为 +411.8MB,Skin 方式下为 +38.2MB,而 VAT 方式几乎没有增加。
(第 2 部第 3 章“通过 VAT 减轻骨骼动画开销”)
材质的复制也会推高内存。让 10000 个 Renderer 各自持有材质会增加 15.79MB,而通过 RSUV 传递值,增量只有 1.66KB。
(第 1 部第 5 章“利用 Renderer Shader User Value 优化图形”)
对既不加载也不存储的附件使用无内存(memoryless),就不需要在主内存上持有其实体。
(第 1 部第 1 章“Unity 6 Render Graph 图块内存优化”)
在构建设置方面,通过 Managed Code Stripping,可以让未使用的代码根本不进入内存。
(第 3 部第 4 章“Unity Managed Code Stripping 实践指南”)
CPU
在大量角色出场的场景中,Transform 层级的处理很关键。通过 Optimize Game Objects 将层级扁平化后,在 300 个角色的配置下,主线程的 MeshSkinning.Update 从 6.23ms 降到约 1.5ms,蒙皮矩阵的计算在所有线程合计 36.6ms 的开销则完全消失。Playable Graph 的手动更新只能以图为单位并行化,因此将 600 个角色合并到 1 个图中,8.396ms 变为 4.500ms。IK 如果不在主线程求解而移到 Animation Job 中,在 300 个角色各求解 64 次的配置下,9.094ms 变为 2.795ms。起作用的不是 Burst,而是执行线程的迁移。
对于远景的角色,每 N 帧只更新 1 次。与单独调用 Animator.Update() 相比,通过切换 Animator.enabled 或按相位手动更新图,回到 Unity 的批量更新会更省,600 个角色改为每 2 帧更新 1 次后,5.037ms 变为 3.082ms。如果逐帧错开要更新的角色,即使每 4 帧更新 1 次,p95 也能从 9.470ms 降到 2.707ms,不会形成尖峰。
(第 2 部第 1 章“Unity 3D 角色动画的调优”)
在将骨骼更新本身替换为预计算的 VAT 中,显示 16 个角色时 CPU 主线程从 154.3ms 降到 12.6ms。起作用的是通过实例化,每帧绘制命令从约 21 万降到 99,SRPBatcher.Flush 的 76.17ms 几乎消失。
(第 2 部第 3 章“通过 VAT 减轻骨骼动画开销”)
从池中取回的 Animator 的初始化,也应纳入这一设计中考虑。
(第 2 部第 2 章“用 ResetControllerState 安全地进行 Animator 池化”)
对于单次的大尖峰,需要用另一种方式查找。对启用了 Noise 模块的 ParticleSystem 传入 ParticleSystem.Simulate(20f, false, false) 这样较大的秒数,NoiseJob 会被调用约 2000 次,产生约 50ms 的尖峰。
(第 2 部第 4 章“长时间调用 ParticleSystem 的 Simulate 会产生巨大尖峰”)
绘制的注册开销也是 CPU 开销。将无法合并的 Pass 链合并到 1 个 UnsafePass 中,每个 RasterRenderPass 可以削减约 1.8µs 的固定开销。在 100 个 Pass 的乒乓 Blur 中,1080.7µs 变为 898.5µs。
(第 1 部第 2 章“应使用 RenderGraph UnsafePass 的场景”)
在大量绘制中,无需复制材质就能传递各对象值的 RSUV 很有效。在 iPhone 12 上对 10000 个 Sphere 每帧更改参数的测量中,每个 Renderer 一个材质时为 8.1FPS,而同时使用 RSUV 和 GPU Resident Drawer 时保持了 60.0FPS。
(第 1 部第 5 章“利用 Renderer Shader User Value 优化图形”)
在 UI 方面,uGUI 在更改一个元素时会重建整个 Canvas 的网格,而 UI Toolkit 只更新发生变化的部分。
(第 2 部第 6 章“UI 系统的选用 — IMGUI / uGUI / UI Toolkit”)
对 C# 代码整体有效的手段是 LTO。在 Android 上,仅向 Release 构建添加 -flto=thin,基准测试的直接调用就缩短了 21.8%,大幅超过切换到 Master(-O2)时的 5.9%。在实际游戏的稳定画面中,UnityMain 缩短了 3.21%。
(第 3 部第 5 章“Unity 的 LTO 设置及 Android 与 iOS 上的性能对比”)
GPU
在移动端,内存带宽先于 GPU 的运算性能成为瓶颈。仅仅将 1080p 的 RGBA8 存储 1 次再在下一个 Pass 中加载,往返就约 16MB,60FPS 下会消耗约 950MB/s。削减这部分的手段有 4 种:明确加载/存储操作、Pass 合并、帧缓冲读取(framebuffer fetch)和无内存(memoryless),而且都需要将资源的使用方式正确告知 Render Graph。
例如,对于必定覆盖所有像素的 Pass,只需用 AccessFlags.WriteAll 声明,在 1080p 下就能消除约 8MB/帧的加载。如果用帧缓冲读取来读取延迟渲染的 G-Buffer,仅 3 张的存储就可削减约 24MB/帧,在 60FPS 下削减约 1.4GB/s 的带宽。将 MSAA 设为 Resolve 而非 Store,会在图块内存上完成解析,4 个采样的缓冲区可以做成无内存。
(第 1 部第 1 章“Unity 6 Render Graph 图块内存优化”)
最后只运行 1 次的全屏 Blit,在高分辨率下也是不可忽视的开销。在 AfterRenderingPostProcessing 之后注入自定义 Pass,几乎必然会添加 URP 的 FinalBlitPass,但从 Unity 6.3 起,在最后一个相机的最终 Pass 中调用 SwitchActiveTexturesToBackbuffer(),就可以直接输出到 BackBuffer 并省略它。在自定义 FXAA 的示例中,Unity 6.0 中需要 2 次的 Blit 变为 1 次,中间纹理也不再需要。
(第 1 部第 3 章“省略 URP 的 FinalBlitPass 的方法”)
着色器内部最突出的是超越函数。sin 可以替换为只用乘法和 abs() 的抛物线近似,执行 10 次时在 iPhone X 上削减约 2.5ms、在 Galaxy S9 上削减约 1.3ms 的 GPU 时间。tan 的近似在执行 10 次时,GPU 时间为原来的 80%(iPhone 15 Pro)或 50%(iPhone 14)。不过在执行次数较少时,寄存器压力造成的开销会比较明显。
(第 1 部第 4 章“移动端着色器优化:超越函数的测量与轻量化”)
首次绘制时的卡顿,原因在于 GPU 侧的编译。在 Metal 和 Vulkan 上,一次 PSO 创建有时需要数十毫秒,可以用 GraphicsStateCollection 在任意时机完成。通过 WarmUpProgressively() 指定每帧的数量,还可以避免预热本身造成的尖峰。引入后仍有卡顿时,应怀疑 Shader Stripping 造成的变体缺失或元数据不一致。在 iOS 上,需要把着色器集中到 1 个 Bundle 中以避免重复加载,对于使用 SubPass 的着色器,则在加载画面中先绘制一次以创建 PSO。
(第 1 部第 6 章“使用 GraphicsStateCollection 进行着色器预热”)
如果仍然无法解决,就按设备切换绘制设置本身。通过 deviceModel、graphicsDeviceName、systemMemorySize 判定设备,切换 Quality Level,或直接操作 RenderPipelineAsset 的 renderScale 和阴影级联数。如果也为自制的 RendererFeature 预留切换入口,例如降低临时纹理的格式或分辨率、减少 Blit 的数量、替换为简易着色器,就可以用同样的机制调节开销。
(第 3 部第 3 章“按设备切换绘制设置”)