第3章. 利用 VAT 降低骨骼动画开销
3.1. 前言
在 Unity 中,一般的骨骼动画需要由 CPU 每帧执行骨骼更新等播放用计算。因此,播放动画的对象越多,CPU 开销就越高,从而导致帧率下降。本章介绍 VAT,这是一种将这些运行时计算整体替换为预计算,从而降低开销的方法。
3.2. 什么是 VAT
VAT 是 Vertex Animation Texture 的缩写,是一种将动画产生的顶点变形信息预先烘焙到纹理中,再由顶点着色器读取并播放的方法。纹理的每个像素都对应“某个顶点在某一帧的位置”,随着播放时间推移逐步移动读取位置,网格看起来便会动起来(图 3.1)。此外,为了保证精度,位置以归一化到 0 到 1 的值存储,再由顶点着色器还原为实际坐标。
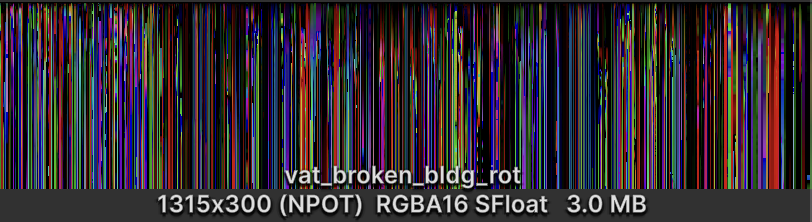
图 3.1: VAT 纹理的原理。横轴对应顶点,纵轴对应帧
使用 VAT,可以将骨骼更新等运行时播放计算整体替换为预计算。这是连 GPU Skinning 也无法实现的效率提升。
另一方面,它也有以下缺点。
- 需要准备 VAT 专用的资源
- 纹理尺寸会随顶点数和帧数增大
- 由于需要精确的值,与纹理压缩不兼容,实际上只能以未压缩方式使用
- 烘焙到纹理后动作即被固定,虽然通过一些技巧可以实现一定程度的控制,但不适合精细控制
基于这些特性,VAT 尤其适用于让大量对象播放固定动画的情况。例如建筑物的破坏效果、人群、背景装饰物等不需要单独控制的表现效果(图 3.2)。
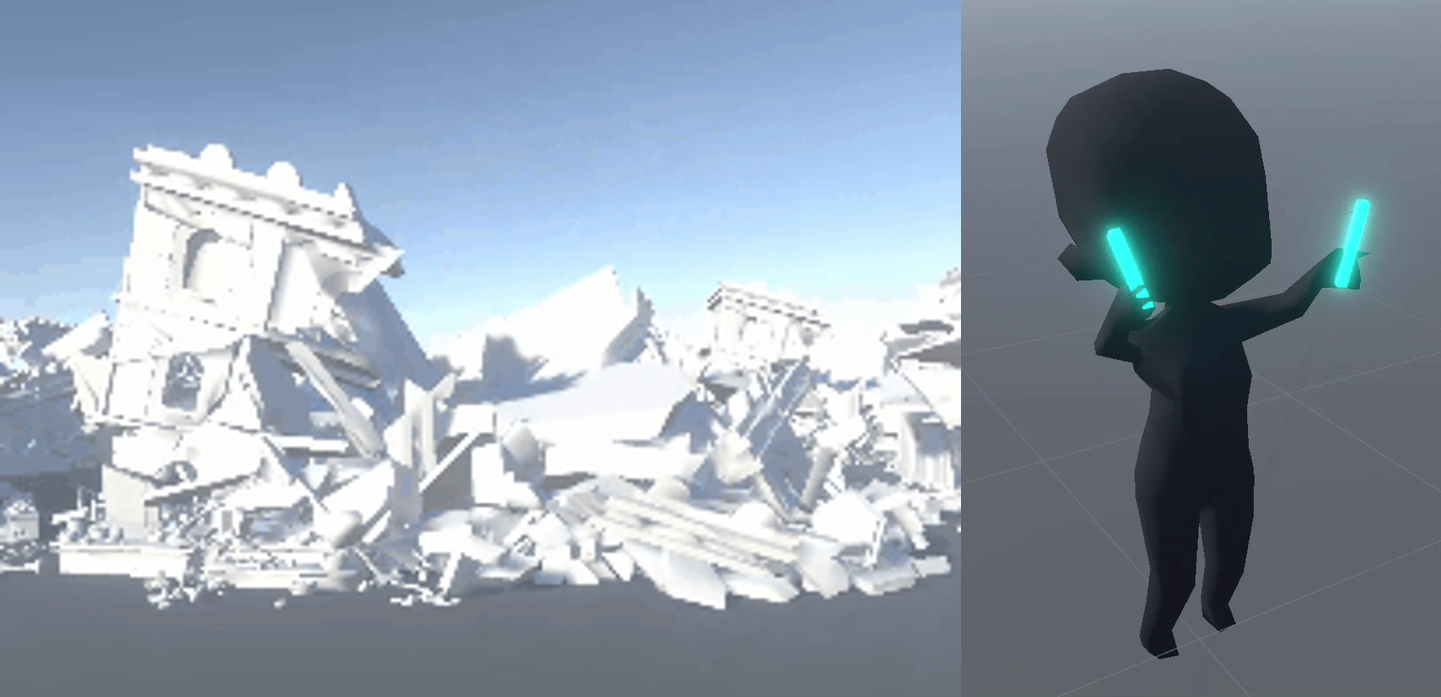
图 3.2: VAT 动画(左:刚体,右:软体)
3.3. 性能验证
下面介绍在真机上将 VAT 与其他动画方式进行性能比较的结果。
3.3.1. 测量环境与比较条件
测量环境如 表 3.1 所示。
表 3.1: 测量环境
| 项目 | 内容 |
|---|---|
| 真机 | Pixel 8a(GPU: Mali-G715) |
| 图形 API | Vulkan |
| Unity 版本 | 6000.3.2f1 |
| 测量 API | FrameTimingManager、ProfilerRecorder |
| 模型 | 建筑物倒塌动画(85,209 个顶点、1,315 个碎片) |
| 动画 | 300 帧 |
| 测量方法 | 对象数从 0 到 16 个变化,每个条件取 300 帧 ×3 次的中位数 |
比较的 3 种方式如 表 3.2 所示。
表 3.2: 比较条件
| 方式 | 组成 | 启用的优化 |
|---|---|---|
| FBX 方式 | 将每个碎片作为独立的 Mesh Renderer 放置,由 Animator 播放 | SRP Batcher |
| Skin 方式 | 每个碎片对应一根骨骼,合并为一个 SkinnedMeshRenderer,由 Animator 播放 | SRP Batcher |
| VAT 方式 | 将全部碎片的运动烘焙到纹理中,作为一个网格绘制(Rigid-Body Dynamics 模式) | GPU Instancing |
FBX 方式将每个碎片作为独立的 Mesh Renderer 持有,由 Animator 播放(碎片是通过 Transform 运动的刚体,不使用蒙皮)。Skin 方式为每个碎片分配一根骨骼,将整体合并为一个 Skinned Mesh。1,315 个碎片直接对应 1,315 根骨骼,Renderer 只有一个。动画播放由 CPU 端的 Animator 负责,顶点变形由 GPU Skinning 完成。VAT 方式将全部碎片的运动烘焙到纹理中,作为一个网格绘制。3 种方式的外观完全相同。
比较时,分别启用了对各方式有利的绘制效率优化设置。由于 SkinnedMeshRenderer 不支持 GPU Instancing,Skin 方式可用的最佳选项是 SRP Batcher。此外,Skin 方式的骨骼化同样需要专用的转换流水线,这一点与 VAT 条件相同。
3.3.2. CPU 处理时间
CPU 处理时间(主线程)的测量结果如 图 3.3 所示。显示 16 个对象时,FBX 方式增长到 154.3ms,而 Skin 方式为 16.5ms,VAT 方式为 12.6ms,基本没有随对象数增长。
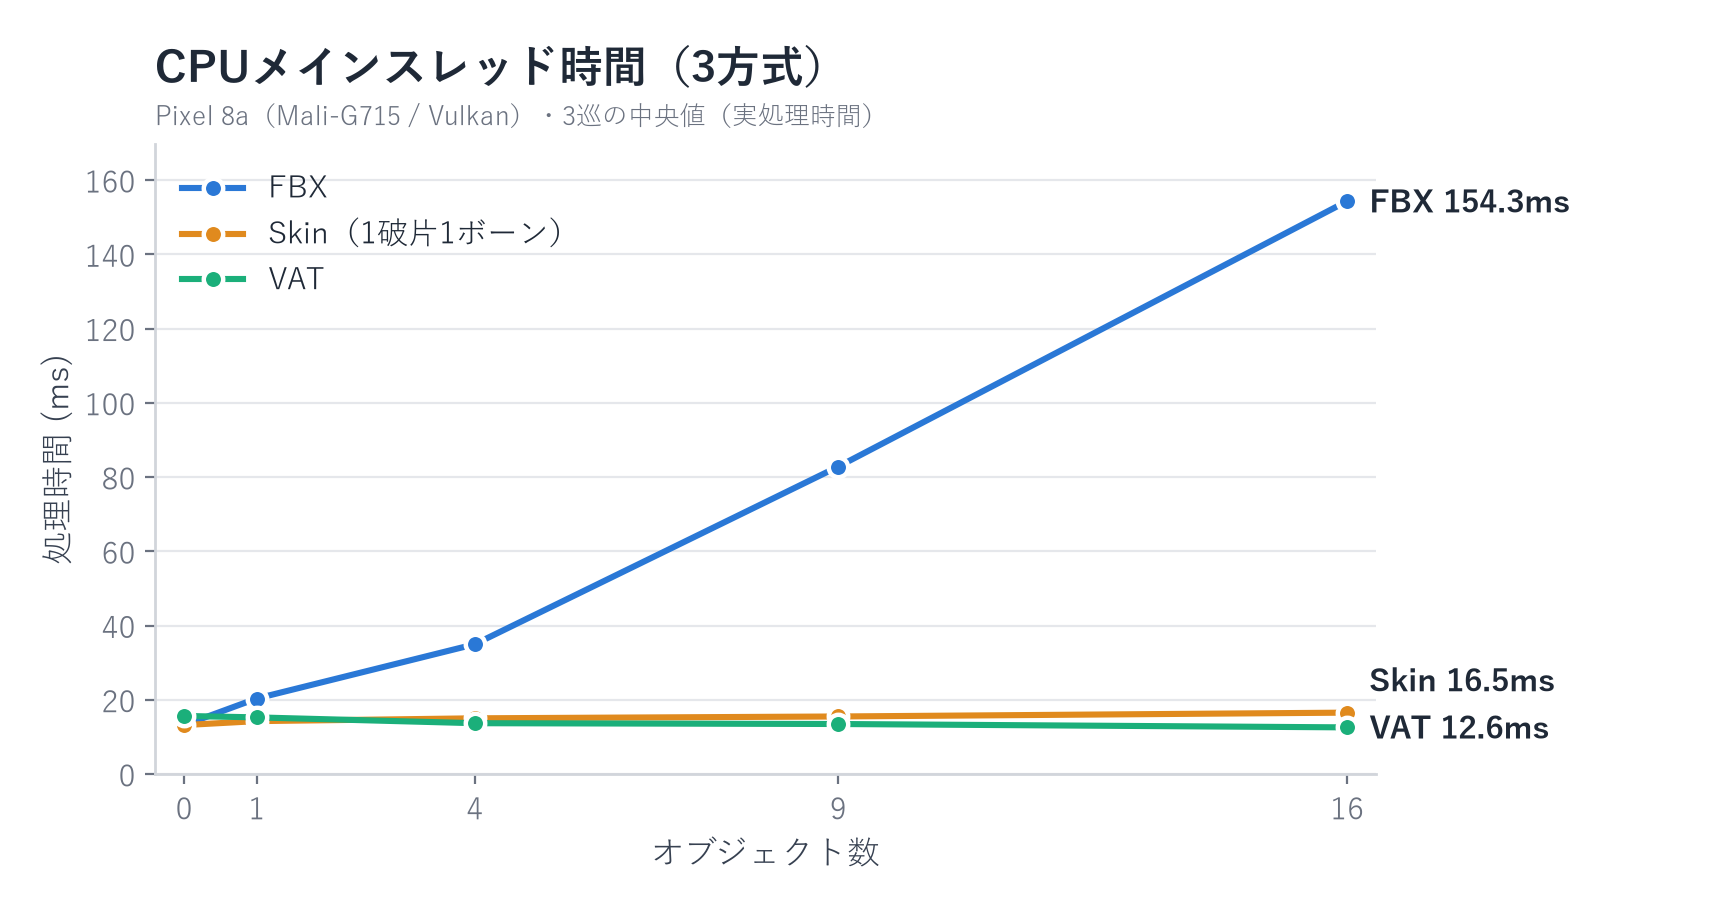
图 3.3: 各对象数下的 CPU 主线程处理时间
明细如 表 3.3 所示。FBX 方式与其他 2 种方式之间差异的最大因素是 Draw Call 的提交处理。FBX 方式中每个模型都需要绘制 1,315 个碎片,而合并为一个网格的 2 种方式中,这部分处理几乎消失。逐碎片的包围盒计算和剔除也是如此。另一方面,Skin 方式与 VAT 方式的差异在于 Animator 的更新。Skin 方式由 CPU 负责播放,16 个对象时仍残留 4.5ms,而 VAT 方式将播放本身转移到 GPU,这部分完全消失。这一差距会随对象数增加而扩大。
表 3.3: 显示 16 个对象时的 CPU 处理时间明细(ms)
| 处理 | FBX 方式 | Skin 方式 | VAT 方式 |
|---|---|---|---|
| 主线程合计 | 154.30 | 16.53 | 12.56 |
| 其中 Draw Call 提交(SRPBatcher.Flush) | 76.17 | 0.03 | 0.02 |
| 其中 Animator 更新 | 5.30 | 4.54 | 0.02 |
3.3.3. GPU 处理时间
GPU 处理时间的测量结果如 图 3.4 所示。16 个对象时,FBX 方式为 77.1ms,Skin 方式为 22.2ms 最快,VAT 方式为 32.5ms。
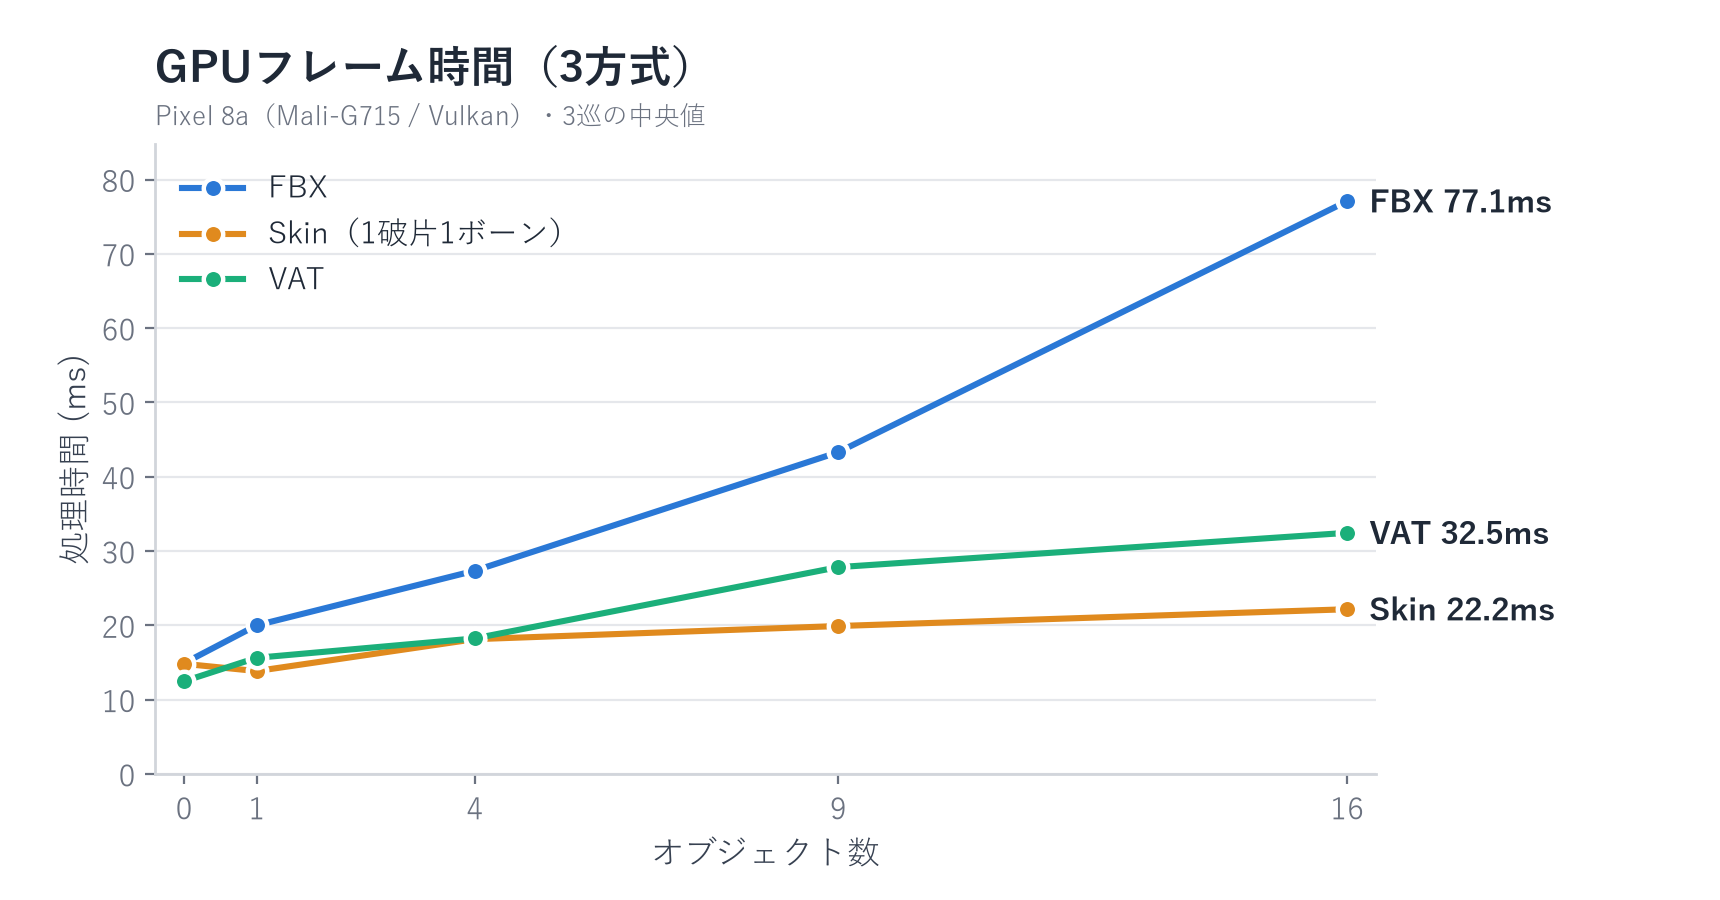
图 3.4: 各对象数下的 GPU 处理时间
FBX 方式与其他 2 种方式差异的主因是绘制命令的拆分数量。FBX 方式中碎片在每个绘制通道中单独发出绘制命令,每帧达到约 21 万次,而 VAT 方式合并为实例化绘制,仅 99 次。Skin 方式每个对象只有一个 Renderer,因此也处于同一水平。每次绘制命令都有固定成本,拆分数量的差异直接体现为处理时间的差异。
Skin 方式与 VAT 方式的差异来自变形计算的次数。GPU Skinning 每帧只计算一次变形,其结果由阴影、深度等所有绘制通道复用。而 VAT 则在每个通道中都由顶点着色器从纹理重新计算变形。本次环境的阴影级联为 4 级,属于通道数较多的场景配置,因此与 Skin 方式的差距相应扩大(阴影贴图绘制:FBX 方式 44.3ms、Skin 方式 7.4ms、VAT 方式 16.0ms)。在执行顶点计算的通道数较少的配置中,这一差距会缩小。
3.3.4. GPU 内存分配量
GPU 内存的测量结果如 图 3.5 所示。数值为 OS 统计的图形驱动实测值(GL mtrack)。从 0 个增加到 16 个对象的增量,FBX 方式为 +411.8MB(每个约 26MB),Skin 方式为 +38.2MB(每个约 2.4MB),VAT 方式几乎为 ±0。
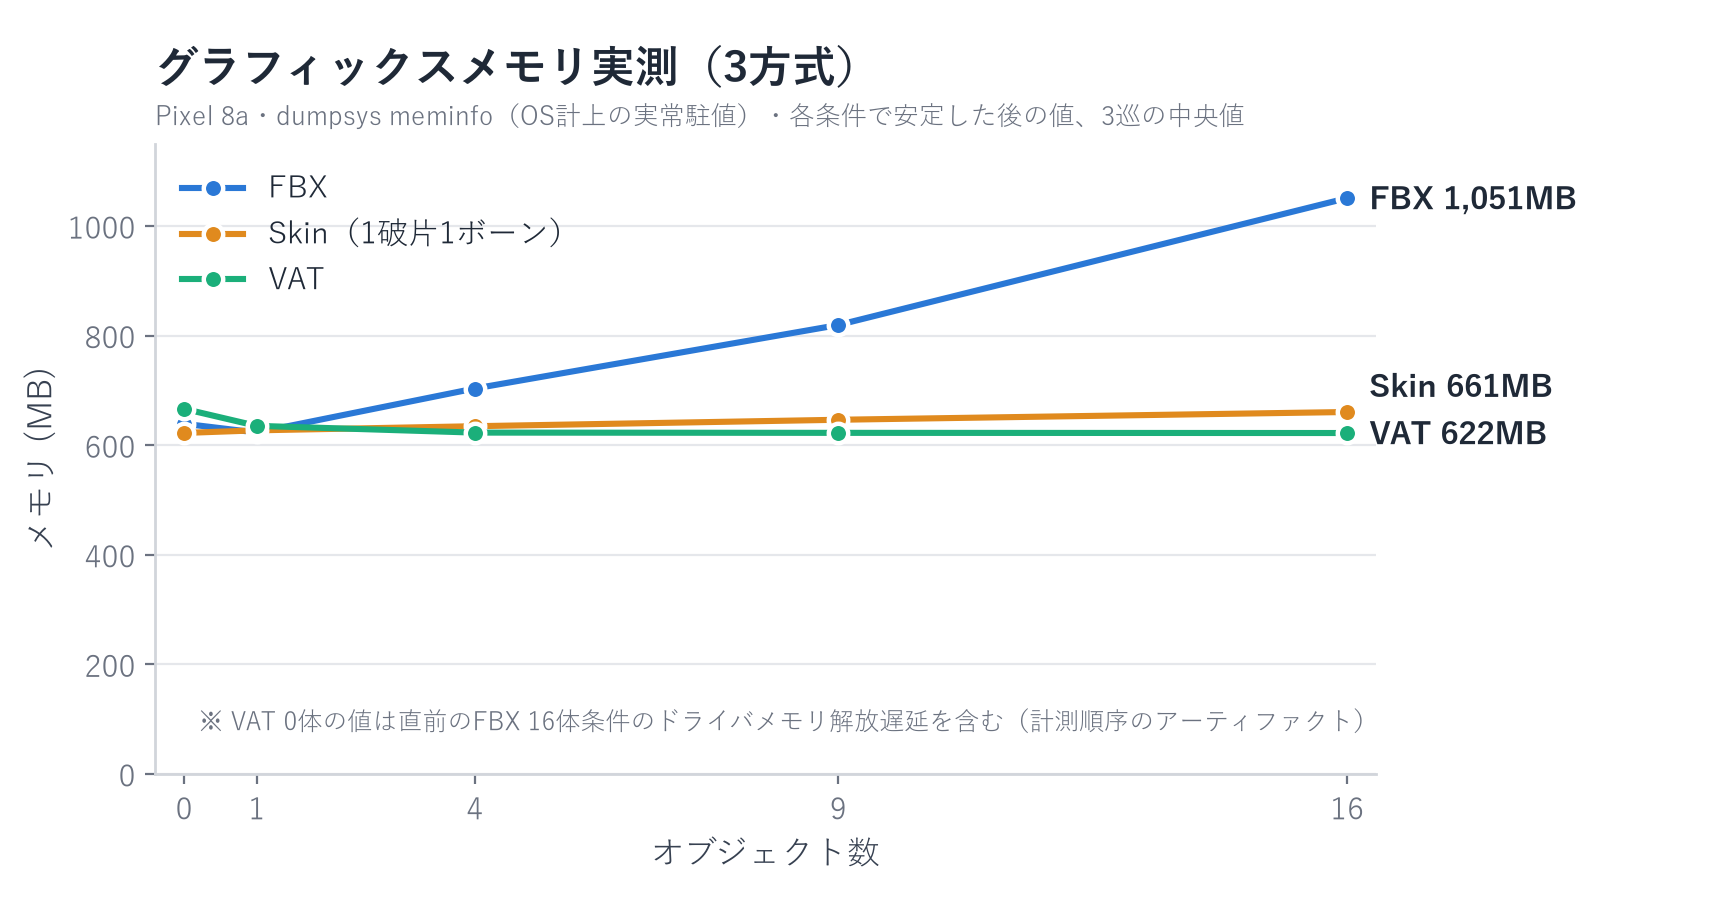
图 3.5: 各对象数下的 GPU 内存分配量
这一差异源于结构上的不同,即每增加 1 个对象时会增加什么。FBX 方式中,矩阵等绘制用数据会按碎片数量在 GPU 内存中分配。Skin 方式中增加的只是每个对象 1 个用于写出蒙皮变形结果的顶点缓冲区。VAT 方式只是即时计算变形,不持有新的缓冲区,因此不会增加。此外,VAT 的纹理未压缩约为 6.6MB,但相对于增量差异来说足够小。
3.3.5. 验证结果总结
显示 16 个对象时的实测值汇总于 表 3.4。
表 3.4: 显示 16 个对象时的实测值汇总
| 指标 | FBX 方式 | Skin 方式 | VAT 方式 |
|---|---|---|---|
| CPU 主线程(ms) | 154.3 | 16.5 | 12.6 |
| GPU 帧(ms) | 77.1 | 22.2 | 32.5 |
| 绘制命令数(次/帧) | 约 210,000 | 与 VAT 方式同一水平 | 99 |
| GPU 内存增量(0→16 个,MB) | +411.8 | +38.2 | 几乎 ±0 |
相对于 FBX 方式,Skin 方式和 VAT 方式在所有指标上都有明显优势。原因可归结为“能够作为一个网格处理”。
Skin 方式与 VAT 方式的比较各有优劣:GPU 处理时间上 Skin 方式占优,CPU 主线程和内存上 VAT 方式占优。VAT 方式的 GPU 处理时间很大程度上取决于通道配置中顶点变形处理的多少。因此,在执行顶点计算的通道数较少的配置中,或以削减 CPU 开销为目的时,VAT 是首选。
此外,本次比较的题材是刚体破坏,这类题材易于用骨骼表现。对于布料或人体这类骨骼数会变多或只能近似处理的模型,以及对象数较多的情况,CPU 开销会更加明显,因此可以认为 VAT 的优势会更大。
3.4. 创建 VAT 资源
创建 VAT 资源,较为便捷的方法是使用 Houdini 附带的 Labs Vertex Animation Textures ROP(以下简称 VAT ROP)*1。Houdini 是 SideFX 公司的 DCC 工具,擅长程序化生成。VAT ROP 提供了 Unity 用的预设和对应的着色器,不仅可以输入 Houdini 内的模拟结果,也可以输入由其他 DCC 工具制作的 FBX 动画。
VAT ROP 有 表 3.5 所示的 4 种模式。
表 3.5: VAT ROP 的模式
| 模式 | 用途 |
|---|---|
| Soft-Body Deformation | 基本的顶点变形。要求拓扑不发生变化 |
| Rigid-Body Dynamics | 针对刚体破坏优化。以碎片为单位记录运动,因此可将纹理尺寸控制得较小 |
| Dynamic Remeshing | 支持液体、撕裂的布料等拓扑会变化的对象 |
| Particle Sprites | 用于粒子模拟 |
操作步骤只需在 Input Geometry 中指定要转换为 VAT 的动画节点,在 Mode 中指定要使用的模式,在 Target Engine 中指定 Unity,然后点击 Render All 按钮即可。表 3.6 所示的资源会一并输出。
表 3.6: 播放 VAT 所需的资源
| 资源 | 作用 |
|---|---|
| 位置纹理 | 各顶点在各帧的位置(归一化到 0~1) |
| 旋转纹理 | 变形后的面朝向。重建法线、切线以保持明暗 |
| 顶点颜色纹理 | Houdini 端属性的烘焙目标。可用于提升插值质量等的自由槽位 |
| FBX | 在 UV 中嵌入了表示纹理读取位置的索引编号的网格 |
| 材质 | 已设置帧数、FPS、包围盒等辅助数据 |
| 着色器 | 对应各模式的播放计算主体(需另行安装) |
着色器不包含在输出文件中,因为计算处理不依赖于动画而是固定的。需要从 Unity 的 Package Manager 另行安装 SideFX Vertex Animation Textures 包(存放位置可在 VAT ROP 的 Real-Time Shaders 选项卡中确认)。包中除了支持 4 种模式的 Shader Graph 外,还附带文档和用于导入设置的 Preset。
3.5. 引入时的注意事项
VAT 在精度不足时动画会损坏,因此必须为纹理指定合适的格式。同样,FBX 端也有推荐的导入设置。请按照包中附带的“VAT Import Settings Guide”,应用禁用纹理压缩等专用导入设置。
另外,官方的 Shader Graph 定位仅为模板,实际使用时需要自定义。不应直接使用模板,而应复制到项目中再使用。不过要注意,复制后的 Shader Graph 仍会引用包内的 Sub Shader Graph,需要将引用改为指向复制后的版本。
此外,输出文件的导入设置,以及为材质分配纹理、着色器等引用设置需要手动完成,这是容易因设置遗漏而引发问题的部分。在需要批量制作的项目中,可以考虑使用 Scripted Importer 等将导入设置与引用解析自动化。关于这方面的改进,请参阅上传至 CEDiL 的资料*2。
3.6. 总结
VAT 是将动画烘焙到纹理中并由 GPU 播放的方法。其特点是能大幅削减 Draw Call,相对于每个碎片持有一个 Renderer 的配置,它与 Skin 方式同样效率大幅提升。两者各有优劣:GPU 处理时间上 Skin 方式占优,CPU 处理时间和内存上 VAT 方式占优。在执行顶点计算的通道数较少的配置中,或以削减 CPU 开销为目的时,VAT 是首选。虽然存在需要准备专用资源、动作被固定等限制,但在让大量对象播放固定动画的场合,它是一个强有力的选择。
[*1] 这是 SideFX Labs 包中包含的工具。本章的验证使用的是 3.0 版本。