第4章. 面向移动端的着色器优化:超越函数的测量与轻量化
4.1. 姓名、所属
Nagatome Ryouhei / 株式会社 Colorful Palette
GitHub 账号
X 账号
4.2. 前言
在着色器中使用 sin、exp 等超越函数时,GPU 的处理开销往往会升高。本文结合 Profiler 的测量值,讲解这些函数对实际性能究竟有多大影响。此外,还将介绍把超越函数替换为近似计算的优化手法,并结合实测值说明实际能够获得多大程度的开销削减效果。
4.3. 环境
本文使用的 Unity 版本、渲染管线及设备如下。
| Unity 版本 | Unity6000.3.20f1 |
|---|---|
| 渲染管线 | Universal Render Pipeline 17.3.0 |
| iOS 设备 | iPhoneX iPhone14 iPhone15 Pro |
| Android 设备 | Galaxy S9 |
4.4. 超越函数
超越函数是指无法用有限次的四则运算和开方运算表示的函数。典型的例子有三角函数、指数函数和对数函数。
- sin、cos 等三角函数
- pow、pow2 等指数函数
- log、log10 等对数函数
由于超越函数开销较高,通常建议避免大量使用。
4.4.1. 超越函数开销高的理由
超越函数开销高的理由有以下 3 点。
- 时钟周期数多
- 执行超越函数运算的单元(SFU)数量少
- 寄存器压力带来的额外开销
4.4.2. 理由 1:时钟周期数多
智能手机等设备搭载的 GPU 拥有大量用于算术运算的运算单元(ALU)。ALU 的设计目标是在 1 个时钟周期内完成加法和乘法。
然而,超越函数并不是用 1 条指令就能算出的简单运算。GPU 内部计算超越函数时,会使用泰勒展开、极小极大法等多项式近似算法,将其分解为大量加法与乘法的组合来计算。
简单的四则运算只需「1 条指令」即可完成,而超越函数会被编译器展开为「数十条四则运算指令」,因此处理时间更长。
4.4.3. 理由 2:SFU 数量少
许多 GPU 搭载了名为 SFU(Special Function Unit)的专用硬件,用于高速处理超越函数等运算,超越函数有时会在 SFU 上执行。
由于 SFU 的数量远少于 ALU,即使使用 SFU 执行超越函数,处理仍然需要较长时间。
4.4.4. 理由 3:寄存器压力带来的额外开销
sin() 这类超越函数的计算比简单的加法和乘法更复杂,GPU 内部进行计算时需要更多的临时寄存器。
GPU 各运算单元(SM:Streaming Multiprocessor)拥有的寄存器总量在物理上是固定的,每个线程消耗的寄存器数增加(寄存器压力升高),因此单个 SM 能容纳的线程数会减少。
由于可同时执行的线程数减少,处理会耗费更长时间。
4.5. 各种函数的开销
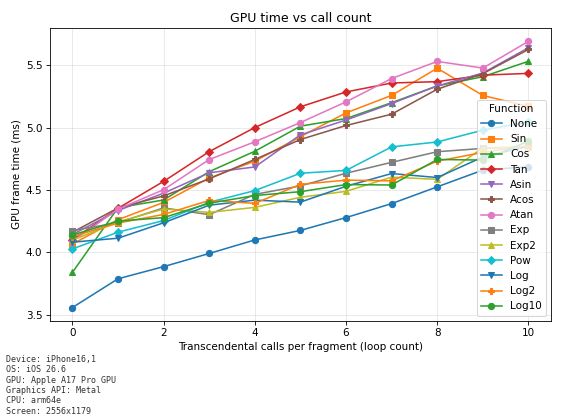
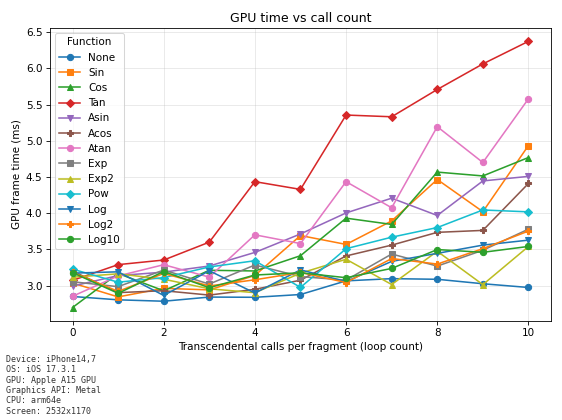
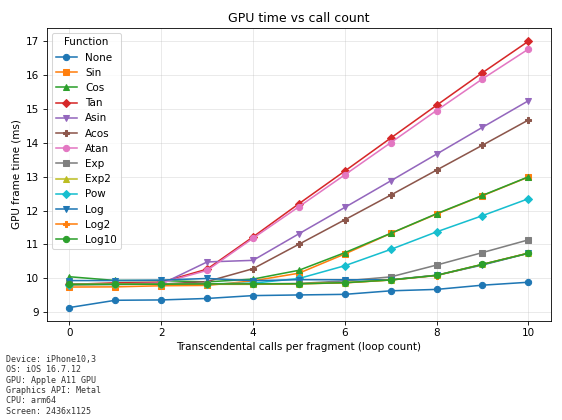
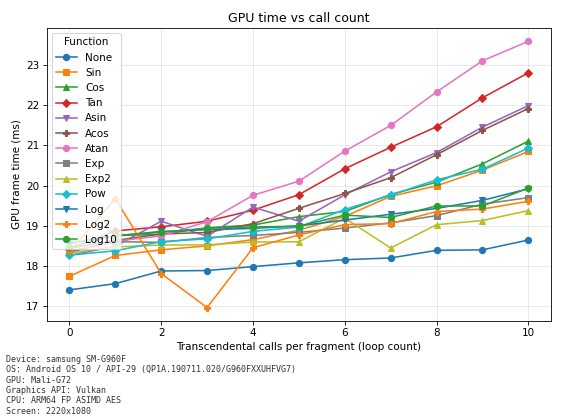
针对循环次数 0 到 10 的每种情况,分别测量执行各种超越函数时的 GPU 时间,考察哪种超越函数的开销最高。GPU 时间的测量使用 FrameTimingManager。
4.6. 用于开销测量的着色器
测量使用了如下着色器。可以通过着色器关键字选择要执行的超越函数,并使用变量 _LoopCount 更改循环次数。
Shader "Benchmark/Transcendental"
{
    Properties
    {
        // uGUI(CanvasRenderer)会把纹理绑定到 "_MainTex",因此名称固定
        [PerRendererData][MainTexture] _MainTex("Sprite Texture", 2D) = "white" {}
        [MainColor] _BaseColor("Tint", Color) = (1, 1, 1, 1)

        // 用于 Mask(UI/Mask)的模板设置。Mask 组件会替换 Material 并写入
        _StencilComp("Stencil Comparison", Float) = 8
        _Stencil("Stencil ID", Float) = 0
        _StencilOp("Stencil Operation", Float) = 0
        _StencilWriteMask("Stencil Write Mask", Float) = 255
        _StencilReadMask("Stencil Read Mask", Float) = 255

        _ColorMask("Color Mask", Float) = 15

        [Toggle(UNITY_UI_ALPHACLIP)] _UseUIAlphaClip("Use Alpha Clip", Float) = 0
    }

    SubShader
    {
        Tags
        {
            "Queue" = "Transparent"
            "RenderType" = "Transparent"
            "RenderPipeline" = "UniversalPipeline"
            "IgnoreProjector" = "True"
            "PreviewType" = "Plane"
            "CanUseSpriteAtlas" = "True"
        }

        Stencil
        {
            Ref [_Stencil]
            Comp [_StencilComp]
            Pass [_StencilOp]
            ReadMask [_StencilReadMask]
            WriteMask [_StencilWriteMask]
        }

        Cull Off
        ZWrite Off
        ZTest [unity_GUIZTestMode]
        Blend SrcAlpha OneMinusSrcAlpha
        ColorMask [_ColorMask]

        Pass
        {
            HLSLPROGRAM

            #pragma vertex vert
            #pragma fragment frag
            // 循环次数是 uniform(动态循环),因此需要 3.0 而不是 2.0
            #pragma target 3.0

            // 支持 RectMask2D / Mask 的 Alpha Clip
            #pragma multi_compile_local _ UNITY_UI_CLIP_RECT
            #pragma multi_compile_local _ UNITY_UI_ALPHACLIP

            // 切换要测量的超越函数。由于希望在运行时通过 Shader.EnableKeyword 切换,
            // 这里使用 multi_compile 而不是 shader_feature(未使用的 variant 会被剥离)。
            // 每个关键字对应一个独立的 variant,因此生成的代码中只会出现所选的函数(没有分支开销)。
            // 由于是全局关键字,可以从 TranscendentalBenchmark 一侧统一控制。
            // 如果没有启用任何关键字,则使用开头的 _FUNC_NONE variant。
            #pragma multi_compile_fragment _FUNC_NONE _FUNC_SIN _FUNC_SIN_APPROX _FUNC_COS _FUNC_TAN _FUNC_TAN_TAYLOR _FUNC_TAN_PADE _FUNC_ASIN _FUNC_ACOS _FUNC_ATAN _FUNC_EXP _FUNC_EXP2 _FUNC_POW _FUNC_LOG _FUNC_LOG2 _FUNC_LOG10

            #include "Packages/com.unity.render-pipelines.universal/ShaderLibrary/Core.hlsl"

            struct Attributes
            {
                float4 positionOS : POSITION;
                float4 color : COLOR;
                float2 uv : TEXCOORD0;
                UNITY_VERTEX_INPUT_INSTANCE_ID
            };

            struct Varyings
            {
                float4 positionHCS : SV_POSITION;
                float2 uv : TEXCOORD0;
                float4 positionOS : TEXCOORD1; // 以与 _ClipRect 相同的空间(Canvas 本地空间)保存
            };

            TEXTURE2D(_MainTex);
            SAMPLER(sampler_MainTex);

            CBUFFER_START(UnityPerMaterial)
                half4 _BaseColor;
            CBUFFER_END

            // 由 TranscendentalBenchmark 设置的全局值。
            // 不是按材质的值,因此不要放进 UnityPerMaterial(放进去会破坏 SRP Batcher)
            int _TranscendentalLoopCount;
            float _PowExponent;

            // 相当于 UnityUI.cginc 的 UnityGet2DClipping(用 HLSL 自行定义)
            float Get2DClipping(float2 position, float4 clipRect)
            {
                float2 inside = step(clipRect.xy, position.xy) * step(position.xy, clipRect.zw);
                return inside.x * inside.y;
            }

            // 将传给超越函数的值限制在 (0.05, 0.95) 范围内。
            // 一并规避 asin/acos 的定义域 |x| <= 1、log 系的定义域 x > 0,以及 exp 系的溢出。
            // 由于这是所有 variant 共用的前处理,其成本会在求差值时被抵消。
            float PrepareInput(float seed)
            {
                return seed;
                // return frac(seed) * 0.9 + 0.05;
            }

            float sinApprox(float x)
            {
                // sin 的抛物线近似。只需乘法和 abs,用来观察与真正的 sin 指令之间的成本差异。
                // 定义域为 |x| <= PI(PrepareInput 的输出落在此范围内)。
                // 系数会被常量折叠,因此运行时没有除法开销。
                return (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
            }

            float tanTaylor(float x)
            {
                // tan 的泰勒展开取到 3 次项(仅乘法)。用来观察与真正的 tan 指令之间的成本差异。
                // 定义域为 |x| < PI/2,超过 π/4 后精度会迅速下降。
                float x2 = x * x;
                return x * (1.0 + x2 * 0.3333333); // 1.0/3.0
            }

            float tanPade(float x)
            {
                // tan 的帕德近似(乘法 + 1 次除法)。定义域为 |x| < PI/2。
                // 分母的零点 x ≈ ±1.581 靠近 tan 的极点 ±PI/2,因此在极点附近也能跟随。
                float x2 = x * x;
                return x * (15.0 - x2) / (15.0 - 6.0 * x2);
            }

            // 被测量的超越函数。每个关键字只保留一个,
            // 因此生成的代码中只会出现所选函数的展开结果。
            float Transcendental(float x)
            {
                #if defined(_FUNC_SIN)
                    return sin(x);
                #elif defined(_FUNC_SIN_APPROX)
                    return sinApprox(x);
                #elif defined(_FUNC_COS)
                    return cos(x);
                #elif defined(_FUNC_TAN)
                    return tan(x);
                #elif defined(_FUNC_TAN_TAYLOR)
                    return tanTaylor(x);
                #elif defined(_FUNC_TAN_PADE)
                    return tanPade(x);
                #elif defined(_FUNC_ASIN)
                    return asin(x);
                #elif defined(_FUNC_ACOS)
                    return acos(x);
                #elif defined(_FUNC_ATAN)
                    return atan(x);
                #elif defined(_FUNC_EXP)
                    return exp(x);
                #elif defined(_FUNC_EXP2)
                    return exp2(x);
                #elif defined(_FUNC_POW)
                    // 如果把指数设为常量,会被折叠成 pow(x, 2) -> x * x 的形式,
                    // 因此传入 uniform,让其走通用的 pow 路径
                    return pow(x, _PowExponent);
                #elif defined(_FUNC_LOG)
                    return log(x);
                #elif defined(_FUNC_LOG2)
                    return log2(x);
                #elif defined(_FUNC_LOG10)
                    return log10(x);
                #else // _FUNC_NONE:不含超越函数的基线
                    return x;
                #endif
            }

            Varyings vert(Attributes IN)
            {
                Varyings OUT;
                OUT.positionOS = IN.positionOS;
                OUT.positionHCS = TransformObjectToHClip(IN.positionOS.xyz);
                OUT.uv = IN.uv * 300.0;
                return OUT;
            }

            half4 frag(Varyings IN) : SV_Target
            {
                // 这里是测量对象(显示效果没有意义)。
                // 用 UNITY_LOOP 抑制循环展开,使 _TranscendentalLoopCount 次的成本原样累加。
                // 除超越函数的内容之外,所有 variant 的形式完全相同,
                // 因此与 _FUNC_NONE 的差值就是该函数的成本。
                float accum = 0.0;

                UNITY_LOOP
                for (int i = 0; i < _TranscendentalLoopCount; i++)
                {
                    // 如果写成循环不变的表达式,会被外提到循环外,因此把 i 混入参数
                    float x = IN.uv.x + i * 0.017;

                    accum += Transcendental(x);
                }
                return half4(saturate(accum.xxx) * 0.02, 1);
            }
            ENDHLSL
        }
    }
}
4.7. 测量结果
4.7.1. iPhone15 Pro
执行次数少于 7 次时 tan 的开销最高,执行次数达到 7 次以上时 atan 的开销最高。
4.7.2. iPhone14
tan 的开销最高,atan 的开销位居第二。
4.7.3. iPhoneX
4.7.4. Galaxy S9
atan 的开销似乎最高。
4.7.5. 总结
| 设备 | 备注 |
|---|---|
| iPhone 15 Pro | 执行次数少于 7 次时 tan 开销最高,执行次数达到 7 次以上时 atan 开销最高 |
| iPhone 14 | tan 开销最高 |
| iPhone X | tan 开销最高 |
| Galaxy S9 | atan 开销最高 |
4.8. sin 函数的开销
测量超越函数中最具代表性的 sin 函数的开销。
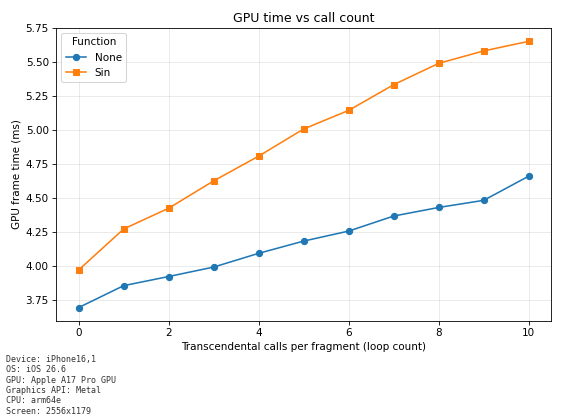
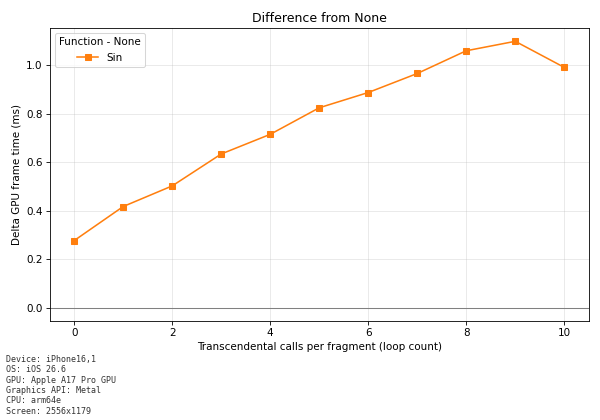
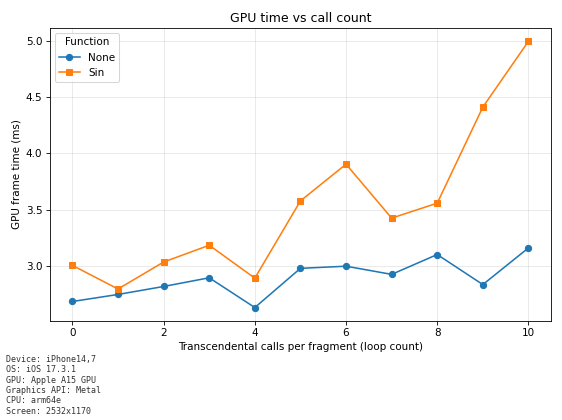
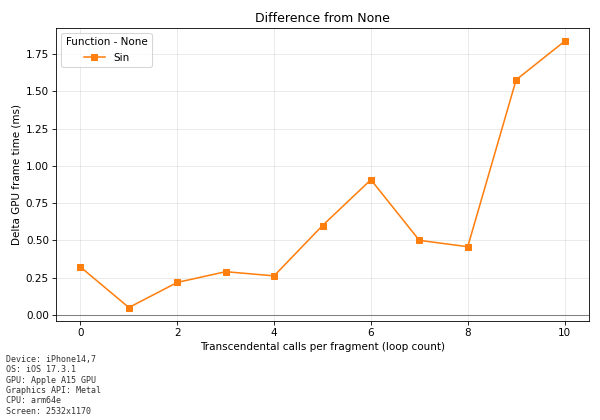
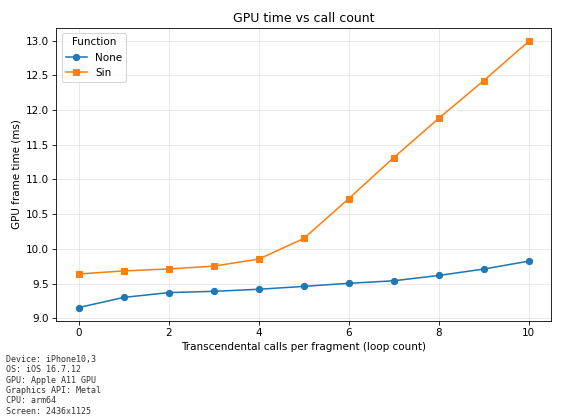
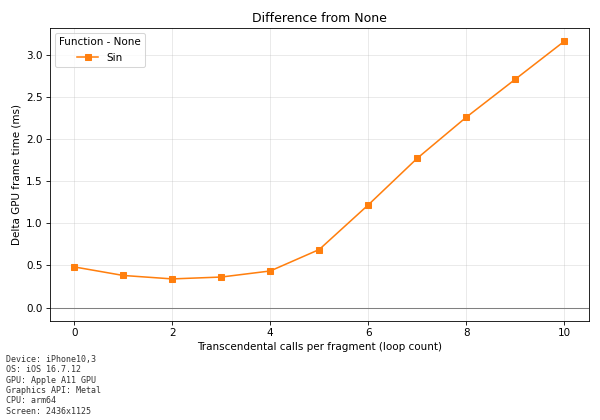
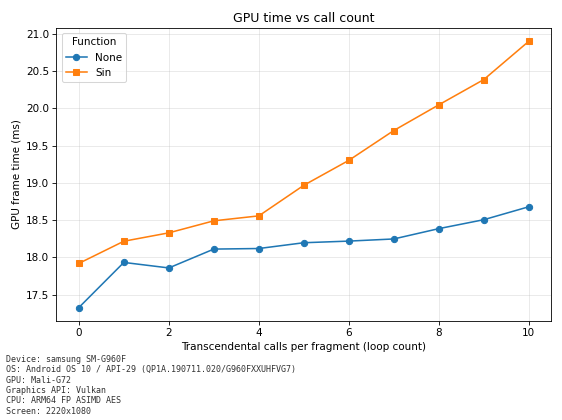
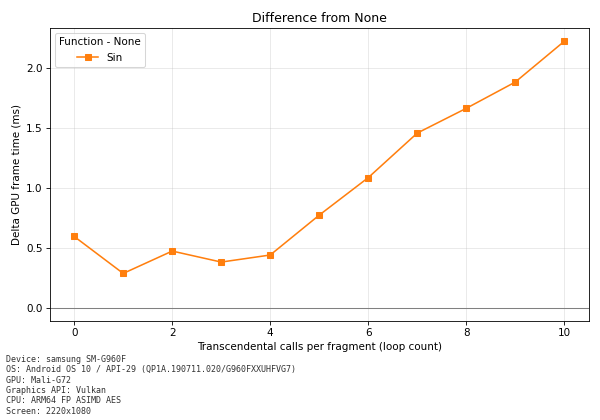
针对循环次数 0 到 10 的每种情况,测量帧内处理所需的 GPU 时间。每个测量点测量 10 秒,并将 GPU 时间整理成图表。
第 1 张图:循环次数对应的 GPU 时间第 2 张图:循环次数对应的 GPU 时间与 None 的差值。
测量使用了 FrameTimingManager。
4.8.1. iPhone15 Pro
着色器中只要存在 sin 指令,就会增加约 0.25ms。sin 调用每增加 1 次,处理开销增加约 0.1ms。
4.8.2. iPhone14
着色器中只要存在 sin 指令,GPU 时间就会增加约 0.25ms。sin 调用每增加 1 次,处理开销增加约 0.1 到 0.2ms。
4.8.3. iPhoneX
着色器中只要存在 sin 指令,就会增加约 0.5ms。sin 调用在 4 次以内时,几乎看不到 GPU 时间的增加,但超过 5 次后,sin 调用每增加 1 次,处理开销增加约 0.6ms。
4.8.4. Galaxy S9
着色器中只要存在 sin 指令,就会增加约 0.5ms。sin 调用在 4 次以内时,几乎看不到 GPU 时间的增加,超过 5 次后,sin 调用每增加 1 次,处理开销增加约 0.2 到 0.3ms。
4.8.5. sin 函数开销总结
| 设备 | sin 函数导致的 GPU 开销增加 | 备注 |
|---|---|---|
| iPhone 15 Pro | +0.25ms(基线) | 每次调用增加约 0.1ms |
| iPhone 14 | +0.25ms(基线) | 每次调用增加约 0.1 到 0.2ms |
| iPhone X | +0.5ms(基线) | 超过 5 次后每次调用增加约 0.6ms |
| Galaxy S9 | +0.5ms(基线) | 超过 5 次后每次调用增加约 0.2 到 0.3ms |
※表中的「基线」指着色器内存在 sin 函数时的初始开销增加。
当着色器内加入 sin 函数时,即使不执行 sin 函数,也能确认到 GPU 时间的增加。这可以认为是寄存器压力导致的开销增加。
4.9. sin 函数的抛物线近似
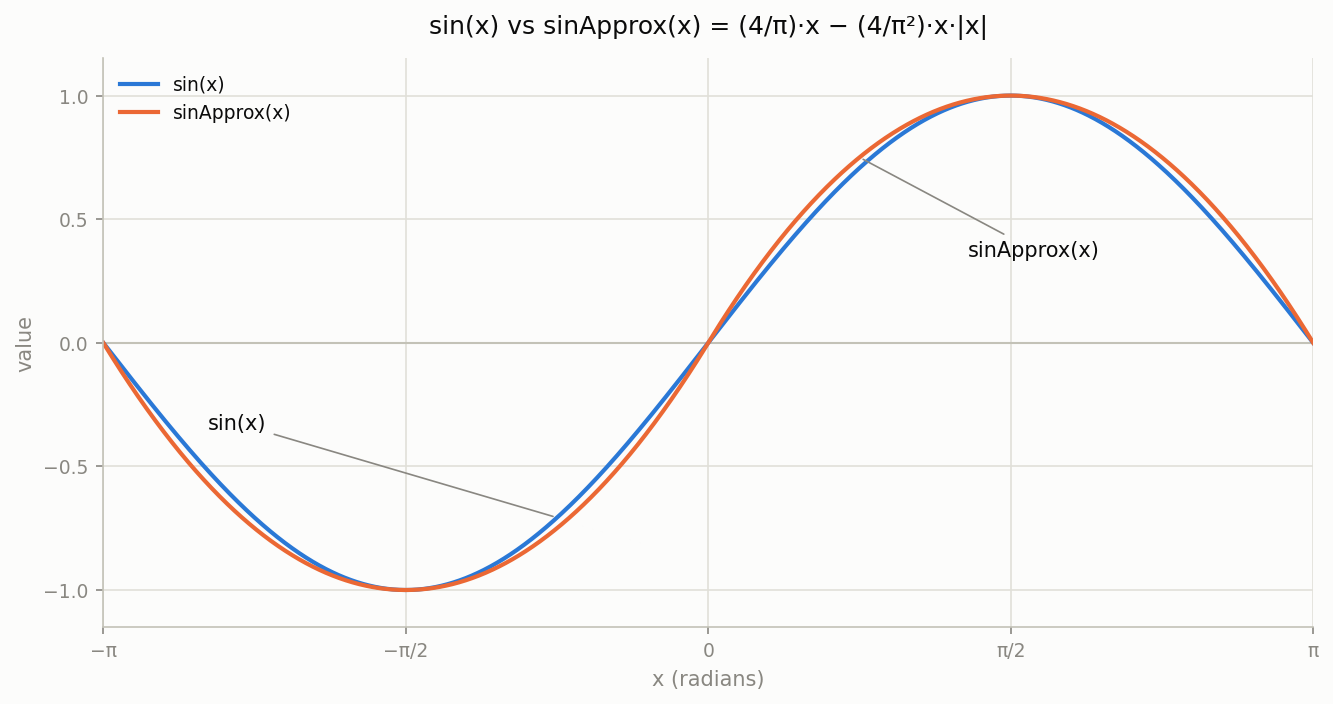
已知可以用如下多项式来近似 sin。
float sinApprox = (4.0 / PI) * x - (4.0 / (PI * PI)) * x * abs(x);
由于只需乘法和绝对值 abs() 即可计算,因此非常轻量。
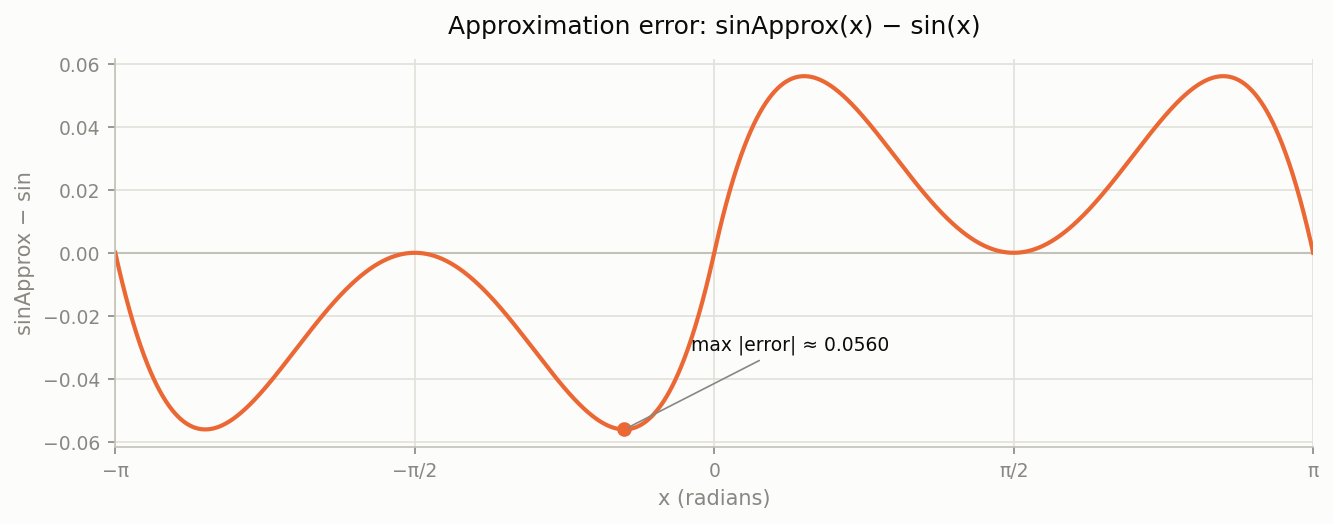
sin 的抛物线近似输出的值与 sin 非常接近(-PI<=x<=PI)
误差的最大值约为 0.056。
4.10. sin 近似的开销测量
测量了 sin 的抛物线近似 sinApprox 的开销,并整理成图表。
4.10.1. iPhone15 Pro
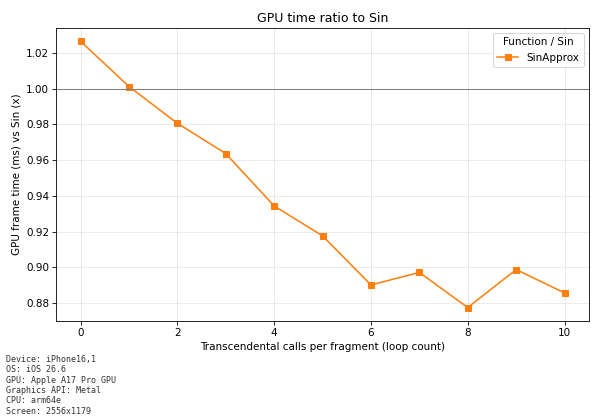
可以确认其开销低于 sin 函数。
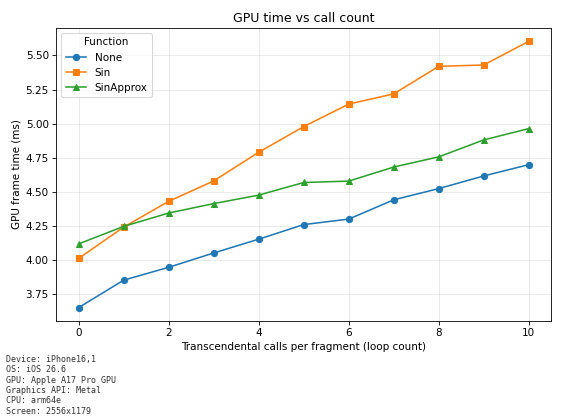
sin 函数与近似计算的比较
函数执行 10 次时,开销降低了约 0.6ms。
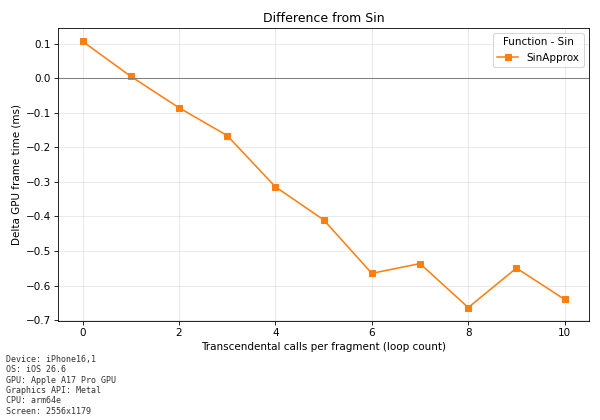
函数执行 10 次时,sinApprox 的开销约为 sin 的 90%。
4.10.2. iPhone14
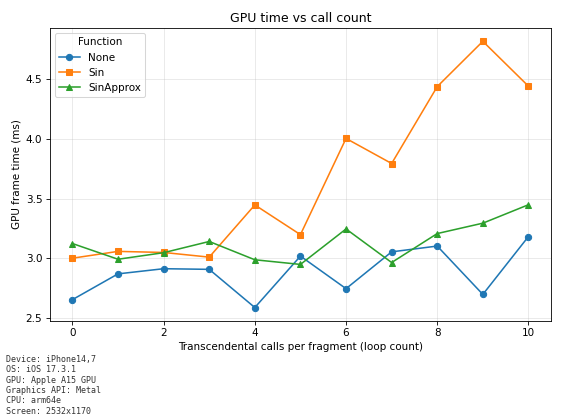
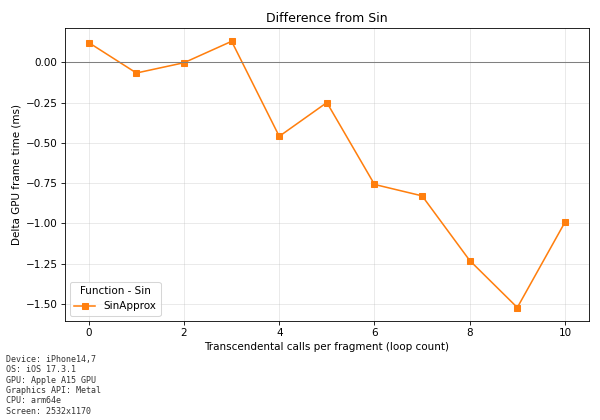
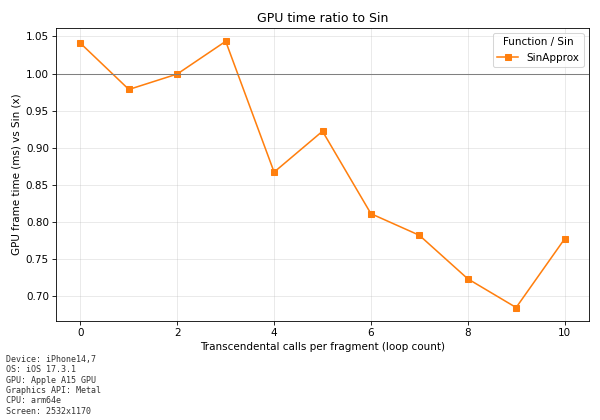
sin 函数与近似计算的比较
函数执行 10 次时,GPU 时间缩短了约 1ms。
sinApprox 执行 10 次时的开销约为 sin 的 80%。
4.10.3. iPhoneX
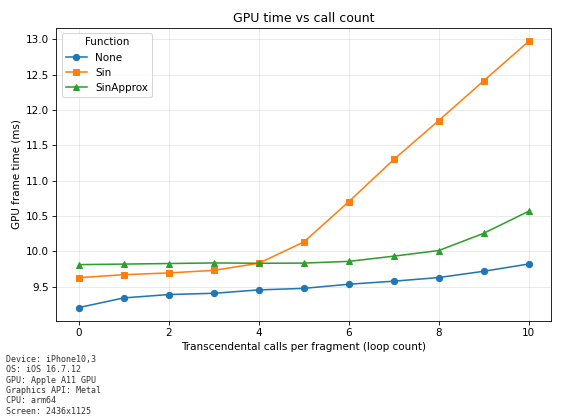
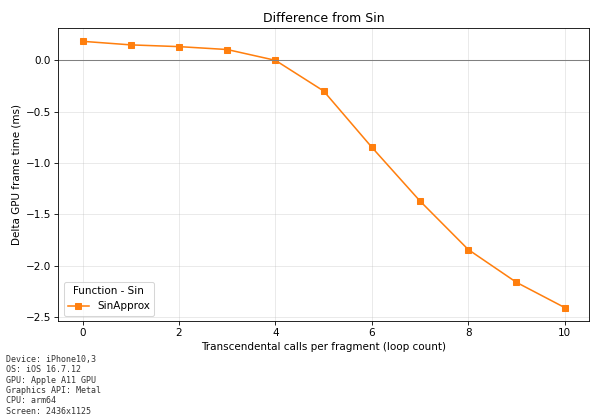
sin 函数与近似计算的比较
sinApprox 执行 10 次时的开销,与执行 sin 时相比缩短了约 2.5ms。
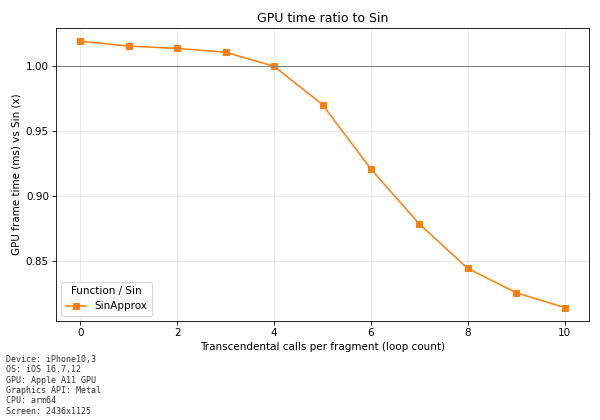
sinApprox 执行 10 次时的 GPU 时间约为 sin 的 80%。
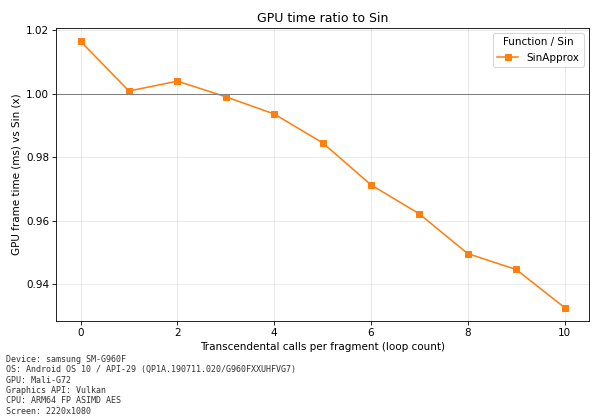
4.10.4. Galaxy S9
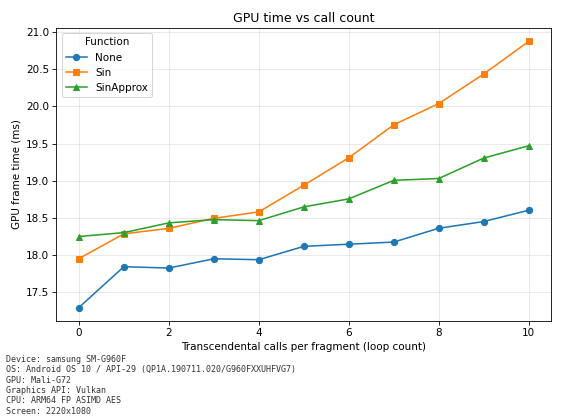
sin 函数与近似计算的比较
函数执行 10 次时,GPU 时间缩短了约 1.3ms。
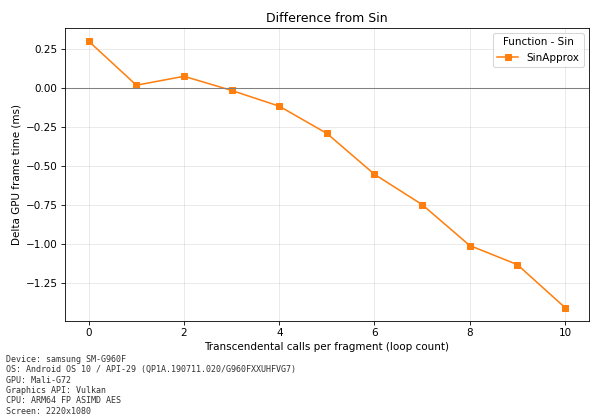
sinApprox 执行 10 次时的开销约为 sin 的 94%。
4.10.5. sin 近似开销总结
将 sinApprox 带来的 GPU 削减效果整理成表,结果如下。
| 设备 | sin 函数的开销 | sinApprox 的削减效果 | 备注 |
|---|---|---|---|
| iPhone 15 Pro | 基准 | 削减约 0.6ms | sinApprox 的开销约为 sin 的 90% |
| iPhone 14 | 基准 | 削减约 1.0ms | sinApprox 的开销约为 sin 的 80% |
| iPhone X | 基准 | 削减约 2.5ms | sinApprox 的开销约为 sin 的 80% |
| Galaxy S9 | 基准 | 削减约 1.3ms | sinApprox 的开销约为 sin 的 94% |
※削减效果为循环次数 10 次时的 GPU 时间差值。
4.11. tan 函数的开销
也测量了 tan 函数的开销。由于 tan 函数内部会调用除法,其开销高于 sin 函数和 cos 函数。
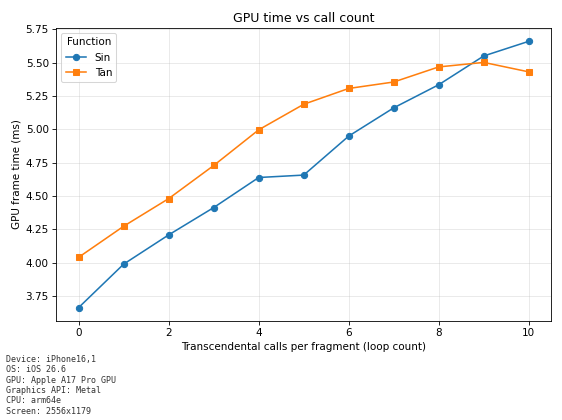
4.11.1. iPhone15Pro
虽然开销高于 sin 函数,但执行次数超过 9 次后,sin 函数的开销反而更高。
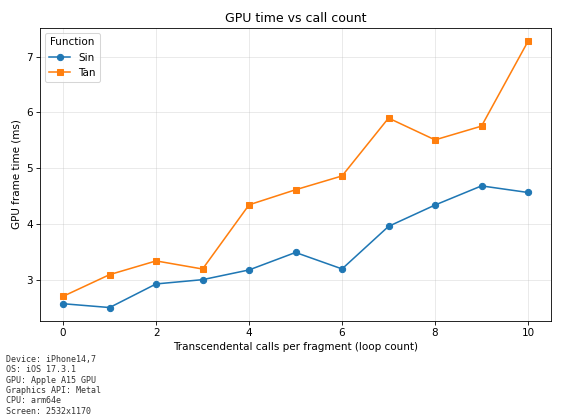
4.11.2. iPhone14
tan 函数的开销高于 sin 函数。
4.11.3. iPhoneX
tan 函数的开销高于 sin 函数。
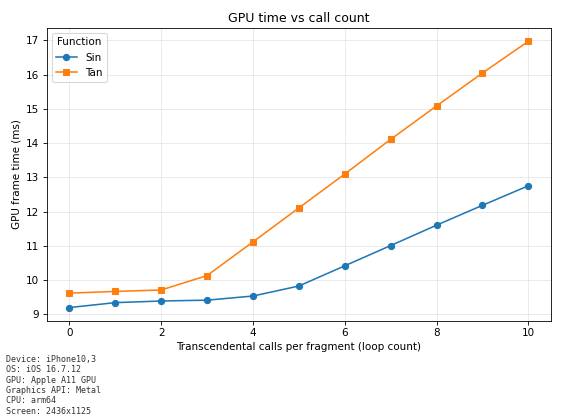
4.11.4. Galaxy S9
tan 函数的开销高于 sin 函数。
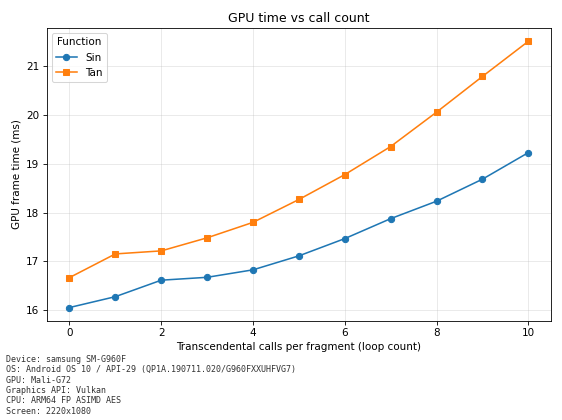
4.12. tan 函数的近似
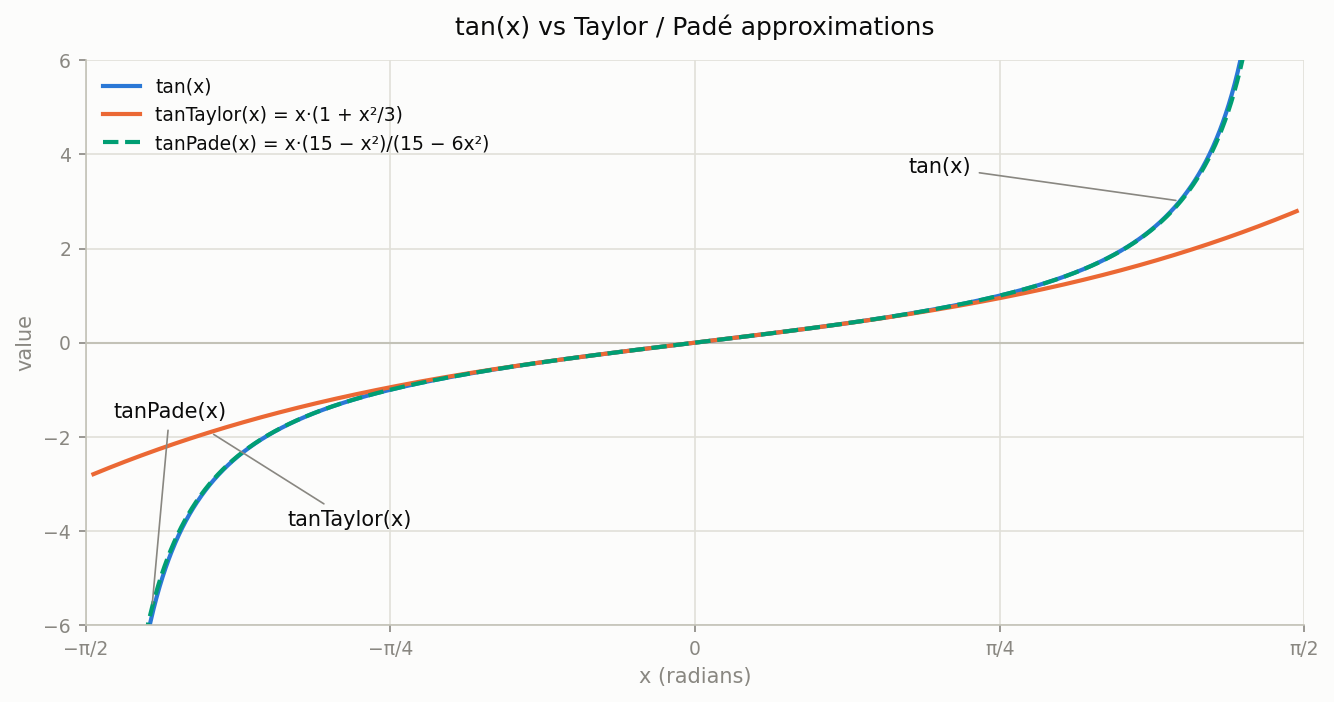
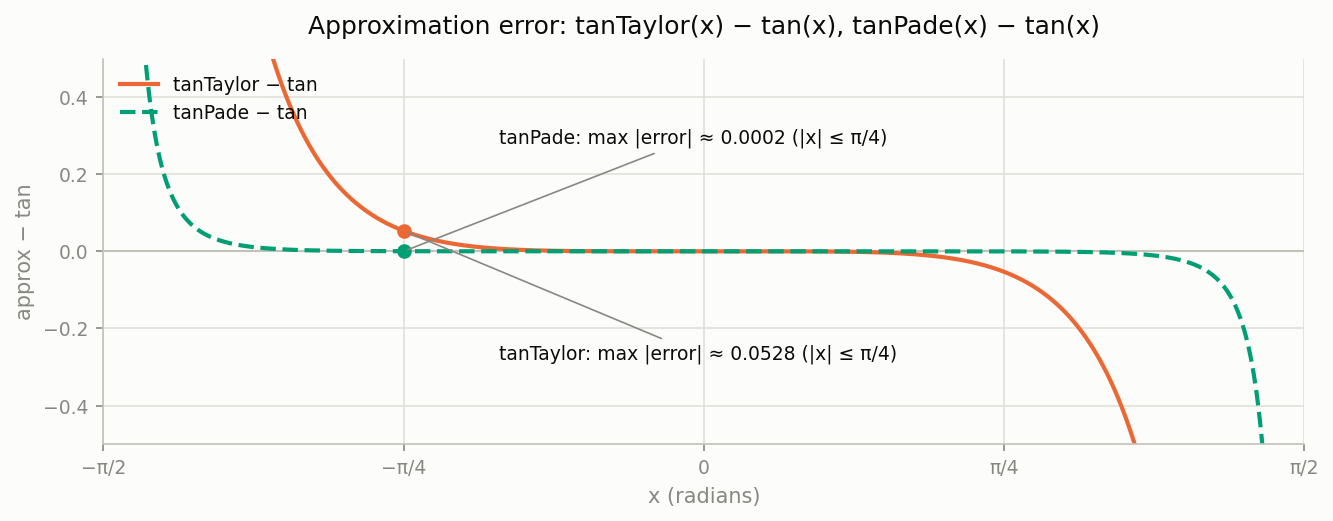
tan 函数的近似手法有直接利用泰勒展开的方法,以及利用帕德近似的方法。泰勒展开的开销更低,但精度也更低。帕德近似的精度更好,但开销也更高。
4.12.1. 手法 1. 基于泰勒展开的近似
这是利用 tan 的泰勒展开进行的近似计算。
|x| 越接近 PI/2,误差越大。
float tanTaylor(float x) {
    float x2 = x * x;
    return x * (1.0 + x2 * 0.3333333);
}
4.12.2. 手法 2. 帕德近似
这是利用 tan 的帕德近似的手法。在 |x| < PI/4 的范围内,输出的值与 tan(x) 非常接近。
float tanPade(float x) {
    float x2 = x * x;
    return x * (15.0 - x2) / (15.0 - 6.0 * x2);
}
4.13. tan 函数近似的图表
将前面介绍的 tanTaylor 和 tanPade 绘制成了图表。
与 tan 函数的误差
4.14. tan 函数近似的开销测量
测量了 tan 函数近似计算的开销。
4.14.1. iPhone15 Pro
执行次数较少时,寄存器压力带来的额外开销较为明显,但随着执行次数增加,近似计算的开销被控制得更低。
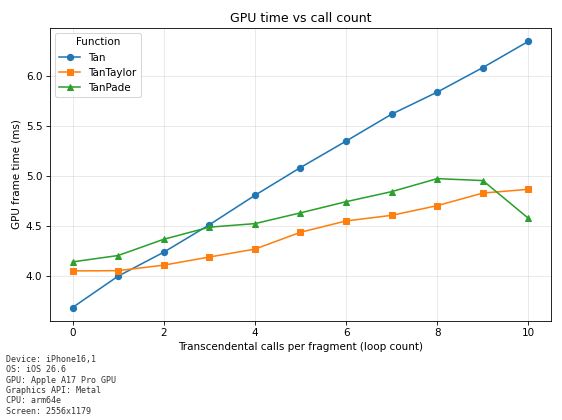
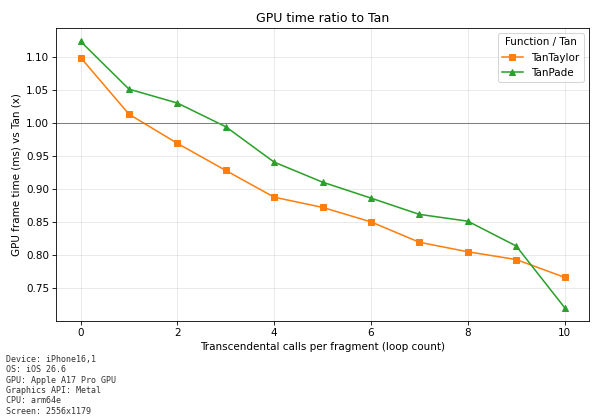
tan 函数与近似计算的比较
函数执行 10 次时,近似计算的 GPU 时间约为 tan 函数的 80%。
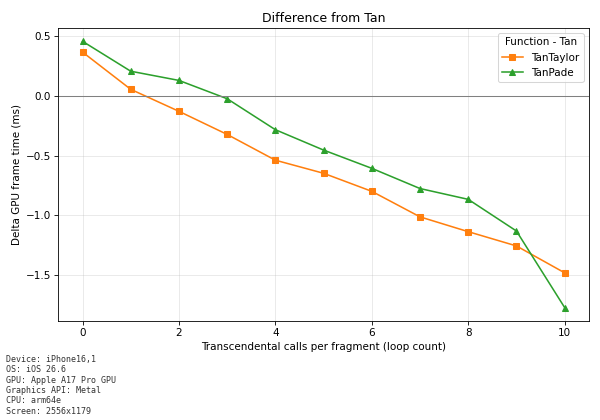
执行 10 次时,近似计算的处理时间少了约 1ms。
4.14.2. iPhone14
执行次数较少时,可以看到少许寄存器压力带来的额外开销。但随着执行次数增加,近似计算的开销被控制得更低。
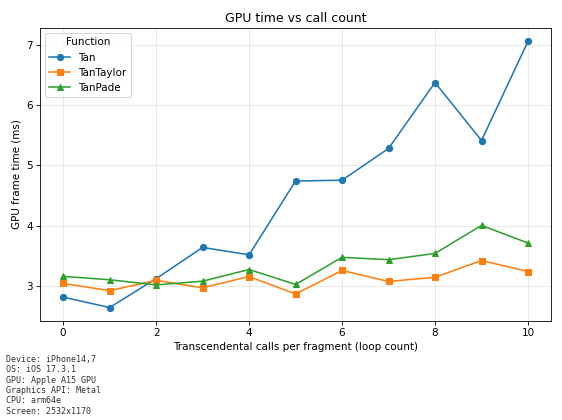
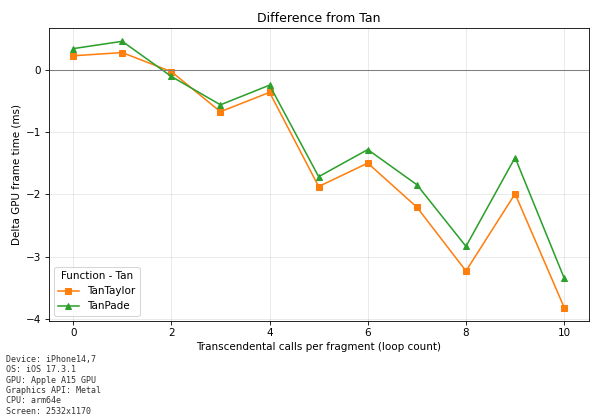
tan 函数与近似计算的比较(iPhone14)
函数执行 10 次时,近似计算的 GPU 时间约为 tan 函数的 50%。
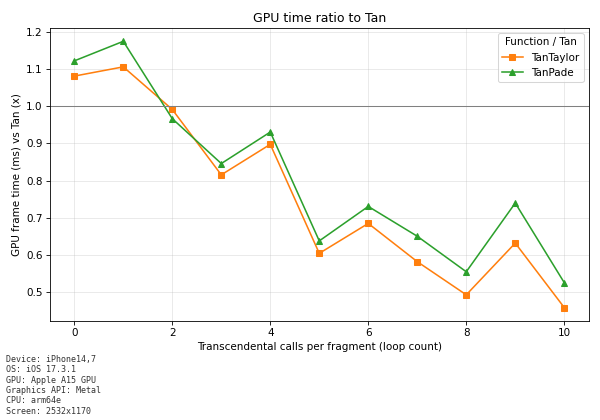
执行 10 次时,近似计算的处理时间少了约 3ms
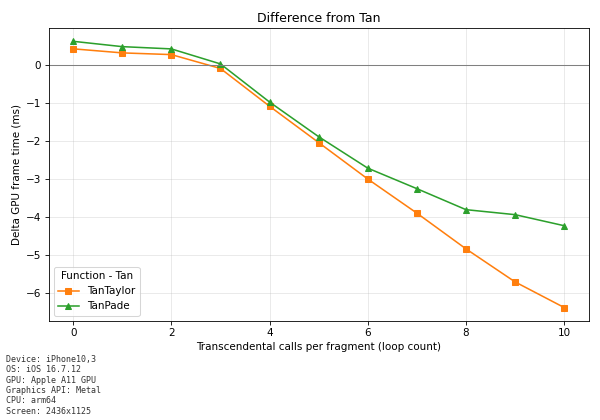
4.14.3. iPhoneX
执行次数较少时,可以看到少许寄存器压力带来的额外开销。但随着执行次数增加,近似计算的开销被控制得更低。泰勒展开的情况下,处理开销几乎没有增加,而帕德近似的处理开销略有上升。
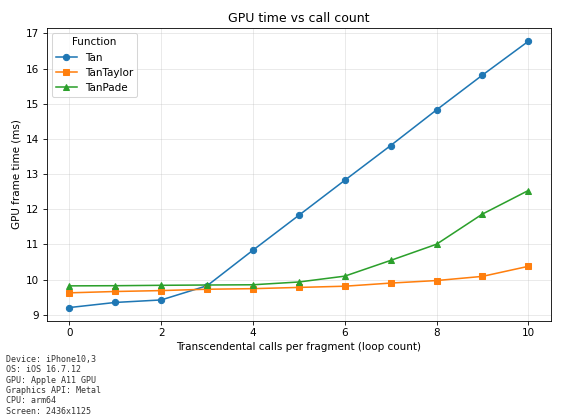
tan 函数与近似计算的比较
函数执行 10 次时,泰勒展开的 GPU 时间约为 tan 函数的 60%。帕德近似的 GPU 时间约为 75%。
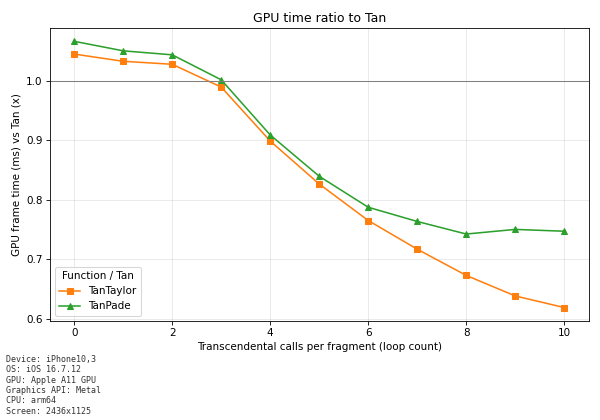
函数执行 10 次时,泰勒展开缩短了约 6ms,帕德近似缩短了约 4ms。
4.14.4. Galaxy S9
执行次数较少时,可以看到少许寄存器压力带来的额外开销。但随着执行次数增加,近似计算的开销被控制得更低。
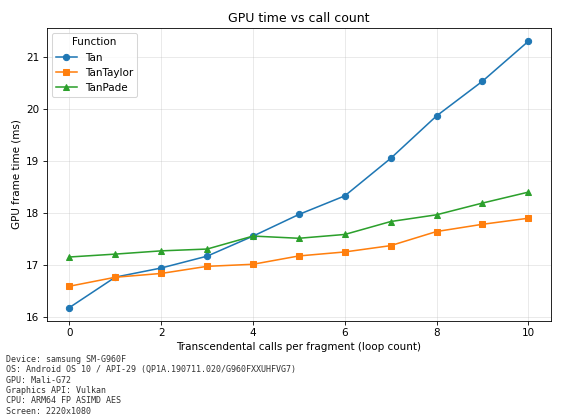
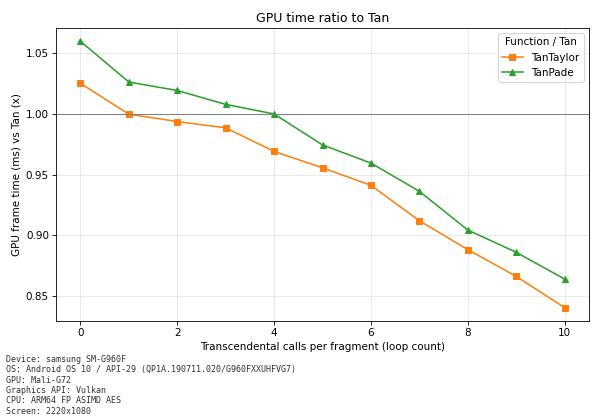
tan 函数与近似计算的比较
函数执行 10 次时,近似计算的 GPU 时间约为 tan 函数的 85%。
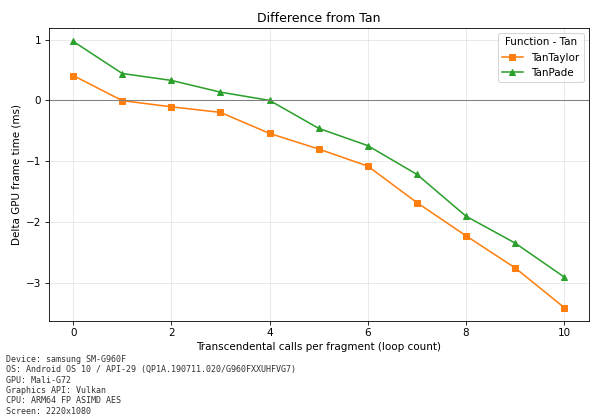
函数执行 10 次时,泰勒展开缩短了约 3ms。
4.14.5. tan 函数近似开销总结
| 设备 | GPU 开销的趋势 | 备注 |
|---|---|---|
| iPhone 15 Pro | 近似计算低约 20% | 近似计算削减约 1ms 处理时间 |
| iPhone 14 | 近似计算低约 50% | 近似计算削减约 3ms 处理时间 |
| iPhone X | 近似计算低约 25 到 40% | 泰勒展开削减约 6ms,帕德近似削减约 4ms |
| Galaxy S9 | 近似计算低约 15% | 近似计算削减约 3ms 处理时间 |
※「GPU 开销的趋势」是指与标准 tan 函数相比,执行近似计算(泰勒展开或帕德近似)时 GPU 时间的大致削减率。