第5章. Unity 的 LTO 设置与 Android、iOS 上的性能对比
Unity 6000.5 新增的面向 Android 的链接时优化(LTO)设置仅适用于引擎代码。若要对自己编写的 C# 生成的代码也应用 LTO,需要另外的设置。本章尝试了这两种设置,并在基准测试和实际项目中测量了性能、二进制大小和构建时间。
5.1. IL2CPP 的编译与翻译单元
在 Unity 的 Android 构建(IL2CPP)中,C# 按 清单 5.1 的流程转换为机器码。
清单 5.1: IL2CPP 构建的处理流程
1 2 3 4 5 6 7 8 | C# 源代码 ↓ C# 编译 IL 程序集 (.dll) ↓ IL2CPP 转换 大量的 C++ (.cpp) ← “IL2CPP 生成代码” ↓ clang 编译(按 .cpp 逐个单独优化) ↓ 链接 libil2cpp.so ← C# 由代码生成的最终原生二进制文件 |
clang 以翻译单元(通称 TU)为单位编译 cpp,并生成目标文件。TU 指编译器单独读取并优化的单位。
在常规的 C++ 构建中,无法引用位于其他 TU 的函数体,因此即使是短函数也不会被内联,可能残留 call 指令。IL2CPP 生成代码中有大量小函数和安全检查,是容易受此限制影响的结构。例如 buf[idx] 这一行 C#,大致会变成 清单 5.2 这样的 C++。
清单 5.2: IL2CPP 生成的数组访问代码示例
1 2 3 | if (buf == NULL) ThrowNullReferenceException(); // null 检查 if ((uint32_t)idx >= buf->max_length) ThrowIndexOutOfRange(); // 边界检查 val = buf->m_Items[idx]; |
生成代码的规模越大,跨 TU 的调用也越多,调用所花费的总时间也随之增加。
5.2. 什么是 LTO / ThinLTO
LTO(Link Time Optimization)是 clang/LLVM 的机制,在链接时进行跨 TU 的内联、常量传播和无用代码删除。编译时将目标文件输出为 LLVM bitcode(优化前的中间表示),链接时将它们合并在一起优化并生成机器码。
full LTO 将所有中间表示合并为一个进行优化。虽然可优化的范围最广,但中间表示的合并和优化集中在单一进程中,大规模构建会占用大量内存。本次在构建实际项目时,内存使用量也达到了 20GB,进程被 OS 强制终止。
ThinLTO 在编译时为每个 TU 生成摘要。链接时从其他 TU 导入(import)所需的函数并并行优化。与 full LTO 相比,更容易控制内存使用量和处理时间,在大规模构建中被广泛使用。
5.3. 引擎代码的 ThinLTO 设置
Unity 6000.5 新增了 Link Time Optimization 开关。
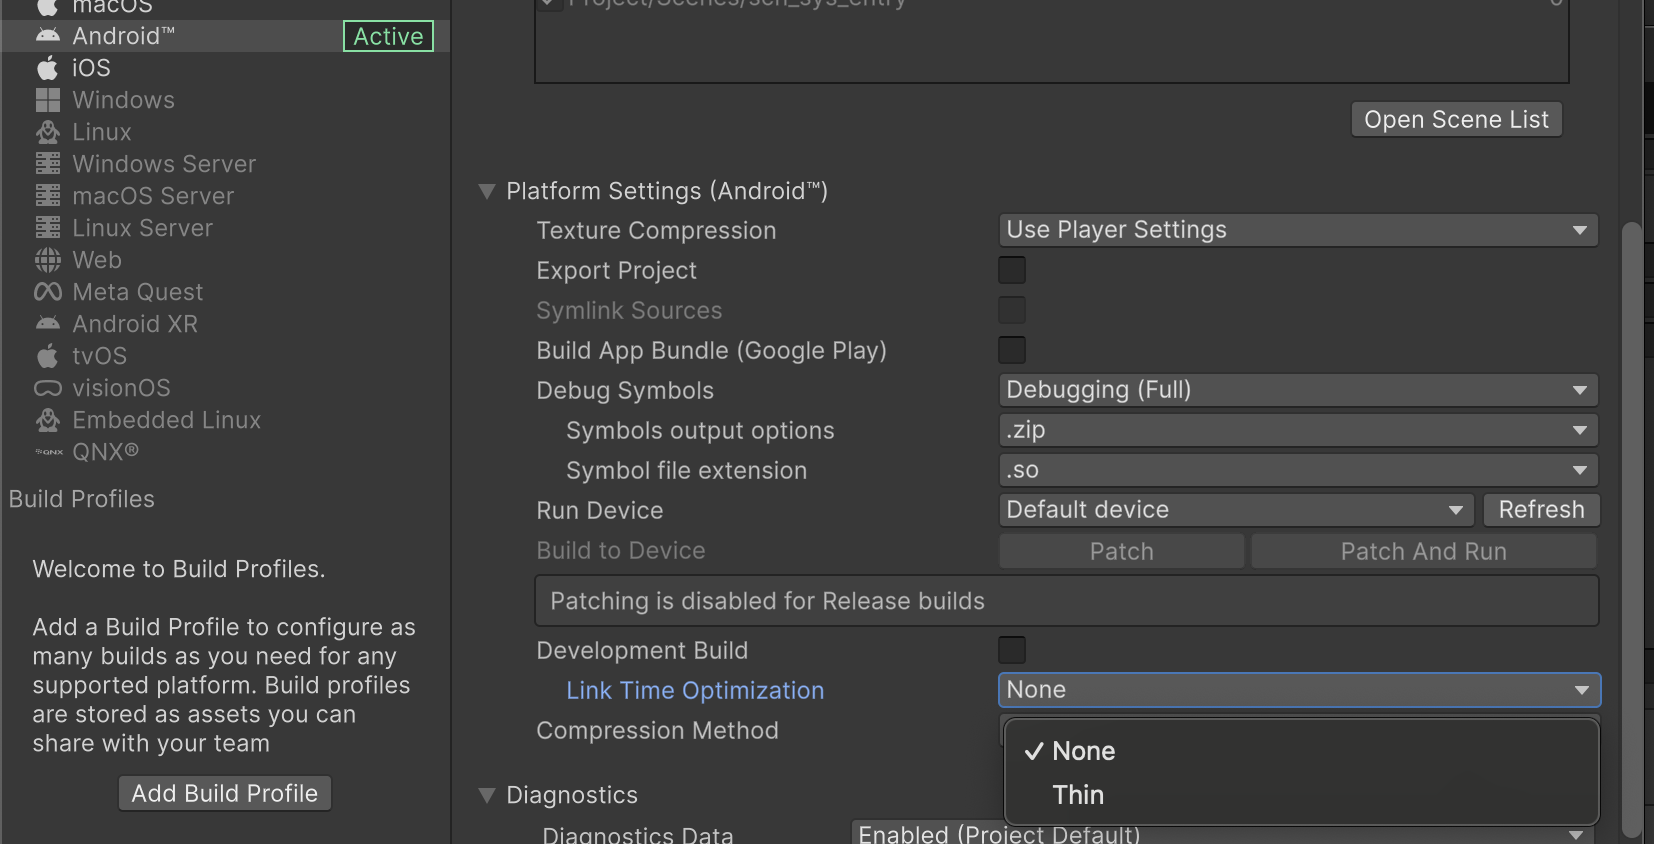
图 5.1: Build Profiles > Player Settings > Android
启用该开关后,会选用 Unity 提供的已应用 ThinLTO 的引擎二进制文件。其范围是 Unity 引擎代码,不包含 IL2CPP 生成代码(源自 C# 的代码)。编辑器的安装文件夹中同时附带了普通版和 ThinLTO 版的预构建 so 文件。
清单 5.3: Android Player 附带的 libunity.so 变体
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Libs/arm64-v8a/libunity.so 29,032,960 bytes └── Release_ThinLTO/Libs/arm64-v8a/libunity.so 30,042,536 bytes (+3.5%) |
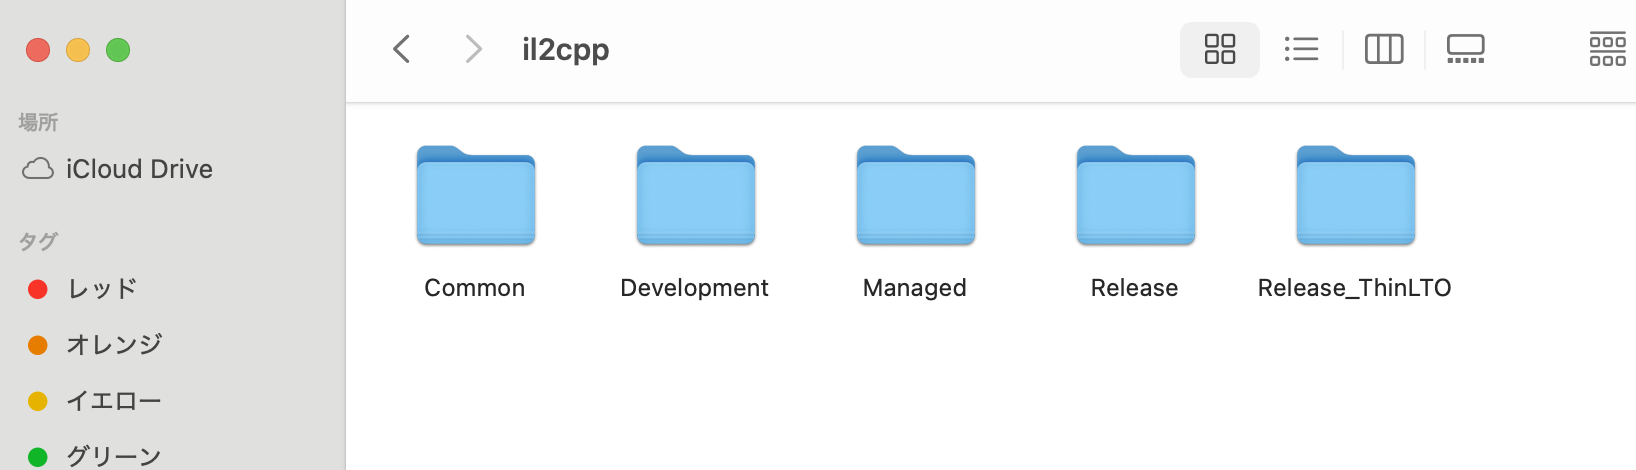
图 5.2: 编辑器的安装文件夹。Release 和 Release_ThinLTO 两者都已附带,构建时会选用其中之一
5.3.1. 生效条件及不满足时的行为
开关生效的条件有以下 3 个。若有任一条件不满足,不会出现错误或警告,LinkTimeOptimization 会以 None 的形式构建。
- IL2CPP 脚本后端
- Strip Engine Code 已禁用(因为会直接使用未剥离的 prebuilt)
- 非 Development 构建
启用 Development Build 时,开关本身不会显示。是否已应用,可通过 清单 5.4 的 2 点确认。
清单 5.4: 引擎代码 LTO 开关的应用确认命令
1 2 3 4 | # ① 构建输入中是否指定了 ThinLTO grep -o 'LinkTimeOptimization"[: ]*"[A-Za-z]*"' Library/Bee/Player*-inputdata.json # ② APK 内的 libunity.so 是否与 Release_ThinLTO 版一致 unzip -p out.apk lib/arm64-v8a/libunity.so | md5 |
5.4. 引擎代码 LTO 开关的效果
对比了附带的普通版和 ThinLTO 版二进制文件,并以变更较多的子系统为中心在真机上测量了性能。
5.4.1. 对比附带二进制文件的函数大小
Unity 在编辑器的安装文件夹中附带了两个变体的带符号 .so。
清单 5.5: Android Player 附带的带符号 libunity.so
1 2 3 | PlaybackEngines/AndroidPlayer/Variations/il2cpp/ ├── Release/Symbols/arm64-v8a/libunity.sym.so └── Release_ThinLTO/Symbols/arm64-v8a/libunity.sym.so |
对照 llvm-nm --defined-only --print-size --demangle 得到的函数名,并根据命名空间和类名按子系统进行了汇总(表 5.1)。
表 5.1: 引擎代码 LTO 开关导致的各子系统函数差异
| 子系统 | 函数数 (Release → ThinLTO) | 大小发生变化的函数数 | 大小变化率 | .text 差异 |
|---|---|---|---|---|
| Particle | 1,419 → 1,290 | 1,043 | 80.9% | +49.66% |
| Serialization/Asset | 2,890 → 1,387 | 1,040 | 75.0% | -16.61% |
| Mesh/Geometry | 1,055 → 765 | 483 | 63.1% | +6.79% |
| Scripting | 8,924 → 7,680 | 4,302 | 56.1% | +10.27% |
| Gfx/Shader/Texture | 5,062 → 3,935 | 2,044 | 52.1% | +24.21% |
| Physics | 2,680 → 2,439 | 1,229 | 51.1% | +15.92% |
| NavMesh | 739 → 582 | 296 | 51.1% | +11.87% |
| XR/VFX/Video/其他 | 3,828 → 2,483 | 1,230 | 49.6% | +13.94% |
| Transform/Scene/Obj | 2,027 → 1,630 | 781 | 47.9% | +10.95% |
| Animation/Mecanim | 3,226 → 2,428 | 1,134 | 46.8% | +13.18% |
| Box2D | 2,169 → 1,562 | 712 | 46.4% | -0.43% |
| JobSystem/Threading | 244 → 181 | 78 | 43.6% | +3.16% |
| UI/UIToolkit | 883 → 701 | 293 | 42.0% | +1.38% |
| TextCore/Font/ICU | 3,500 → 2,101 | 861 | 41.9% | -5.73% |
| (未分类) | 29,193 → 21,077 | 7,511 | 37.6% | +3.37% |
| Renderer/Culling | 2,789 → 2,199 | 785 | 35.7% | +27.58% |
| C++ 标准库/压缩/基础设施 | 13,158 → 9,484 | 3,071 | 32.6% | -13.31% |
| curl/TLS/HTTP | 1,809 → 1,558 | 318 | 21.0% | +1.17% |
| Audio/FMOD | 2,996 → 2,680 | 496 | 18.5% | +2.77% |
| Android/JNI | 1,445 → 1,186 | 193 | 16.3% | -5.52% |
| PhysX | 6,000 → 5,997 | 0 | 0.0% | -0.05% |
| 合计 | 96,036 → 73,345 | 27,900 | 38.8% | +4.41% |
※ “大小发生变化的函数数”是函数的个数。“大小变化率”表示在 Release 和 ThinLTO 中都存在的函数里,大小发生变化的函数所占的比例。
函数总数从 96,036 减少到 73,345,但 .text 的大小增加了 4.41%。
5.4.2. 使用 13 个工作负载的基准测试
基于 表 5.1,制作了在 1 个 APK 中包含 13 个工作负载的基准测试场景。
表 5.2: 引擎代码 LTO 开关的基准测试工作负载
| 工作负载 | 目标子系统 | 内容 |
|---|---|---|
particle | Particle | 20,000 个粒子 + noise/size/color 模块,Simulate |
gfx | Gfx/Shader | 向 MaterialPropertyBlock 写入 16 个属性 × float/vector + matrix 后 Clear |
cull | Renderer/Culling | CalculateFrustumPlanes + 4,096 个 AABB 的 TestPlanesAABB |
physbind | Physics 绑定 | Rigidbody / Collider 属性往返 |
anim | Animation | 对 legacy Animation 的 48 个 Rig × 8 根骨骼 × 10 条曲线执行 Sample() |
json | Serialization | JsonUtility 的往返 |
instantiate | Serialization | Instantiate → DestroyImmediate(原生的 clone/transfer 路径) |
xform | Transform/Scene | 改写带层级的 Transform |
bind | Scripting 绑定 | 大量调用极小的绑定函数 |
mesh | Mesh/Geometry | 重建 96×96 的程序化网格 |
phys2d | Box2D | 2D 刚体的 Simulate |
text | TextCore/Font | TextGenerator.Populate |
physics | PhysX | 3D 刚体的 Simulate |
※ 在 表 5.1 的子系统中,难以从 C# 构造出每个样本约 100ms 的稳定合成负载的子系统,已从测量范围中排除。对于这些子系统,未评估其对性能的影响。
5.4.3. 各工作负载的测量结果
在 Pixel 8a(Tensor G3)上,使用仅 libunity.so 不同的 APK 测量了前面介绍的工作负载。按 Release / ThinLTO / ThinLTO / Release 的 ABBA 顺序重复 3 次,共执行 12 个会话。每个会话都重新安装应用,会话之间留有 90 秒的冷却时间。
数值为单次操作所需的时间(ns/op)。操作的单位因工作负载而异,因此绝对值请在同一行内比较。
表 5.3: 引擎代码 LTO 开关的各工作负载基准测试结果
| 工作负载 | Release (ns/op) | ThinLTO (ns/op) | 差异 |
|---|---|---|---|
gfx | 990.46 | 852.49 | -13.93% |
cull | 96,520 | 87,499 | -9.35% |
text | 275,043 | 265,123 | -3.61% |
instantiate | 14,620 | 14,206 | -2.83% |
xform | 6,071.8 | 6,008.1 | -1.05% |
phys2d | 222,269 | 220,327 | -0.87% |
mesh | 2,340,210 | 2,334,143 | -0.26% |
json | 15,864.8 | 15,934.4 | +0.44% |
bind | 140.80 | 141.47 | +0.47% |
physbind | 607.28 | 610.74 | +0.57% |
particle | 265,635 | 267,335 | +0.64% |
anim | 28,100 | 28,563 | +1.65% |
physics | 484,641 | 482,796 | -0.38% |
| [合成: 几何平均] | 21,918 | 21,380 | -2.46% |
※ 由于各行单位不同,合成值仅作为比率才有意义。
改善较大的 gfx 和 cull,是从 C# 每个样本调用小函数数百万次的处理。text 的 TextGenerator.Populate 也在内部按字形逐个循环。在单次处理很小、调用次数很多的路径上,跨 TU 内联的效果表现得最为明显。
5.4.4. 采用时的性能、大小、内存对比
本次测量中,在绑定调用较多的部分路径上有缩短 CPU 时间的效果。不过,实际项目中的改善幅度取决于这类调用在帧内所占的比例。
采用时必须付出的成本汇总在 表 5.4 中。
表 5.4: 采用引擎代码 LTO 开关时的成本
| 类别 | 实测差异 |
|---|---|
| Strip Engine Code OFF 导致的大小增加 | APK +5.67MB / 安装 +20.3MB |
| Strip Engine Code OFF 导致的内存增加 | RSS +18.0MB / 其中不易回收的区域 +8.0MB |
| engine ThinLTO 本身 | APK 大小 +398KB(30,621,595 → 31,019,967)/ 内存未测量 |
※ 安装大小的增量是 APK 的增量与设备上解压后的 .so 的增量(arm64 的 .so 合计 +14.65MB)之和。
Unity 公开了对同一开关在 5 个项目中各测量 10 次冷启动的结果。据报告,CPU 时间从 13.88ms 缩短到 13.36ms(-3.7%),到首次显示的时间从 247.96ms 缩短到 229.90ms(-7.3%),APK 大小 +3.3%,对构建时间的影响轻微*1。
CPU 的改善幅度与本次测量处于相近水平。不过,公开值的 APK 大小 +3.3% 是在都禁用了 Strip Engine Code 的配置之间的比较,因此不包含禁用所带来的安装大小 +20.3MB、内存 +8.0MB 的增加。
5.5. 对 libil2cpp.so 应用 LTO 的方法
要对包含由 C# 转换而来的代码的 libil2cpp.so 应用 LTO,有使用 Unity 的 Master 配置和直接传递 clang 标志两种方法。
5.5.1. Master 配置与 IL2CPP LTO Mode 的设置
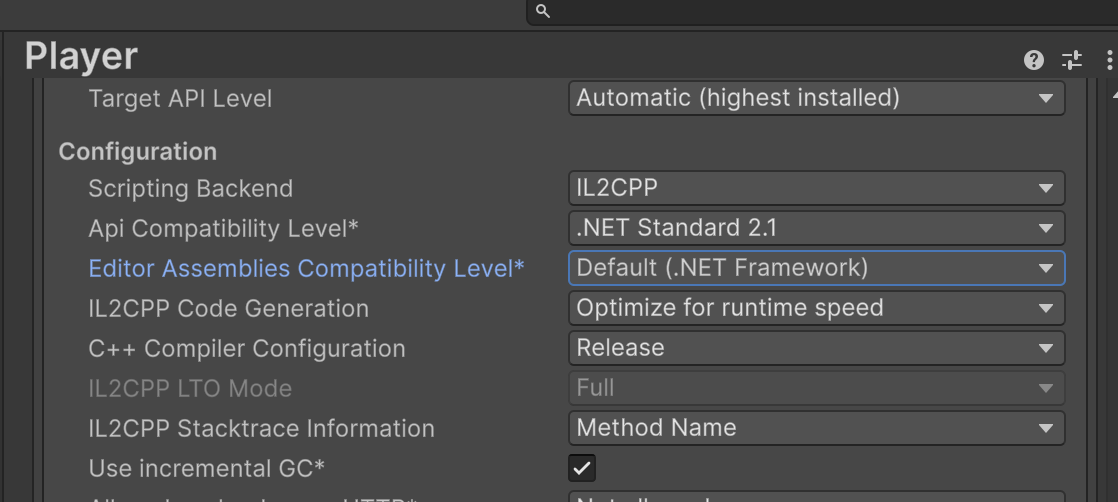
图 5.3: IL2CPP LTO Mode 与 C++ Compiler Configuration 的设置界面
将 Player Settings > Configuration 中的 C++ Compiler Configuration 设为 Master 后,对 libil2cpp.so 的 LTO 即被启用。IL2CPP LTO Mode 是选择此时使用 Thin / Full 哪种模式的选项。
根据 Unity 的官方文章,IL2CPP LTO Mode 自 6000.5 起新增。在 6000.5 之前的 Android 上,Release 和 Master 在是否启用 LTO 方面没有区别。不过在 6000.5 中,Android 平台无法选择该开关,固定为 Thin;自 6000.6 起可在 Master 配置中选择 Thin / Full。截至 6000.7,仍没有在保持 Release 配置的同时仅启用 LTO 的选项。
与 Player Settings 的 C++ Compiler Configuration 对应的标志,可在 Bee 构建图的 Il2CppCompilerConfiguration 中确认。
表 5.5: Unity 各 C++ Compiler Configuration 的编译器标志
| 版本 | Release | Master |
|---|---|---|
| Android 6000.3 (arm64) | -Os(大小优先),无 LTO | -Os,无 LTO(相同) |
| Android 6000.5 (arm64) | -Os | -O2(在速度和代码大小之间取得平衡的优化) + ThinLTO |
| iOS 6000.3 / 6000.5 | -O3(以可能增加代码大小为代价、更积极追求速度的优化),LTO OFF | -O3,LTO OFF(相同) |
5.5.2. 在 Release 配置中添加 -flto=thin
如前所述,切换到 Master 配置是最快获得 LTO 效果的途径,但在启用 LTO 的同时优化级别也会从 -Os 变为 -O2(表 5.5),缺点是大小和构建时间会增加。若在保持 Release 配置的同时仅应用 ThinLTO,既能单独测量 LTO 的效果,也能抑制大小和构建时间的增加。要对自己编写的 C# 生成的 libil2cpp.so 应用 ThinLTO,可以考虑像 清单 5.6 那样直接传递 clang 标志的方法。
清单 5.6: 在 Release 配置中启用 ThinLTO 的构建前处理
1 2 3 4 5 6 7 8 9 10 11 12 13 | // 备份现有的附加参数 → 追加 → 务必恢复原状 var saved = PlayerSettings.GetAdditionalIl2CppArgs(); try { var extra = "--compiler-flags=-flto=thin --linker-flags=-flto=thin"; PlayerSettings.SetAdditionalIl2CppArgs( string.IsNullOrEmpty(saved) ? extra : saved + " " + extra); BuildPipeline.BuildPlayer(options); } finally { PlayerSettings.SetAdditionalIl2CppArgs(saved); } |
是否应用成功,分 2 个阶段确认(清单 5.7)。
第一是标志是否已传递给构建命令。Unity 的构建系统(Bee)会将执行过的编译和链接命令记录到 Library/Bee/Player*.dag.json 中。用 -flto=thin 搜索该文件,查看 IL2CPP 生成代码的编译和 libil2cpp.so 的链接两者是否都包含该标志。
第二是生成的目标文件是否为 LLVM bitcode。启用 LTO 后,编译结果的 .o 不是机器码而是 bitcode。从第一步找到的编译命令中选一个输出文件,显示其开头 4 个字节。
清单 5.7: IL2CPP ThinLTO 的应用确认命令
1 2 3 4 | # 1. 编译和链接命令中是否包含 -flto=thin rg -n -- '-flto=thin' Library/Bee/Player*.dag.json # 2. 生成目标文件的开头 4 个字节(指定 1. 中找到的 .o) xxd -l 4 Library/Bee/artifacts/Android/.../GeneratedCode.o |
若为 bitcode 则显示 4243 c0de(BC..),若为普通机器码目标文件则显示 7f45 4c46(.ELF)。若随意选择文件夹内的 .o,可能会选到不在 LTO 范围内的第三方库的目标文件。第二条命令请务必指定第一条搜索结果中出现的文件。
5.5.3. 基准测试的设计
合成代码的生成
该基准测试以常规编译无法优化的跨 TU 调用为主要测量目标。由于 asmdef 的边界与 C++ 的 TU 边界并非同一概念,我们在 IL2CPP 转换后生成的 C++ 和Bee 的编译图中也确认了调用方和被调用方位于不同的 TU。代码生成器生成的内容如下。
- 16 个 asmdef 程序集 × 24 个类 × 8 个方法 = 3,072 个方法
- 调用链一轮经过 16 个程序集边界,所有方法还会额外调用共享程序集中的辅助函数(
Core.Mix/Core.Idx/ 结构体运算) - 基准测试会遍历所有类,因此不会被 managed 剥离删除
- 每个方法使用不同的常量,以防止被 ICF 折叠
生成的 3,072 个方法的示例见 清单 5.8。
清单 5.8: 合成基准测试生成的方法示例
1 2 3 4 5 6 | public static int M2(int sel, int x, int[] buf) { x = Core.Mix(x, 655663086); // 跨边界调用共享程序集 x += buf[Core.Idx(x, 7)]; // 带边界检查的数组访问(Idx 用 & 1023 掩码) return M3(sel, x, buf); // 小函数链 } |
两个工作负载
表 5.6: IL2CPP ThinLTO 的合成基准测试工作负载
| 工作负载 | 测量内容 |
|---|---|
| direct | 跨程序集静态调用链(LTO 应最有效的形式) |
| iface | 通过接口分派执行同类运算(LTO 难以将被调用方去虚拟化的形式) |
两者都仅在 libil2cpp.so 内部完成。各配置生成的二进制文件,每次都通过从 APK 中提取的 libil2cpp.so 的 md5 进行确认。运行时调整迭代次数,使每个样本约为 100ms。由于每次运行的次数不同,归一化为每 pass 的时间后再比较。
在 iface 中,每个程序集生成 4 个实现了 IGenOp 的类(共 64 个),基准测试通过接口依次调用(清单 5.9)。方法体中调用与 direct 相同的 Core.Mix / Core.Idx,但调用哪个类的 Apply 在运行时决定。
清单 5.9: iface 工作负载生成的类与调用循环
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 | sealed class Op0 : IGenOp { int m_State = 20612; public int Apply(int x, int[] buf) { x = Core.Mix(x, 347275849); // 跨边界调用共享程序集 x += buf[Core.Idx(x ^ m_State, 7)]; // 与 direct 同类的数组访问 m_State = (m_State + x) | 1; return x; } } // 基准测试侧:通过接口遍历 64 个实现 for (int i = 0; i < ops.Count; i++) a += ops[i].Apply(a ^ p, buf); // 被调用方在运行时决定 |
5.5.4. CPU 实测(Pixel 8a)
表 5.7: Pixel 8a 上 IL2CPP ThinLTO 的 CPU 实测结果
| 配置 | direct (us/pass) | iface (us/pass) |
|---|---|---|
| off(Release, -Os) | 19.88 | 0.404 |
| thin(手动 ThinLTO) | 15.54 (-21.8%) | 0.375 (-7.3%) |
通过手动 ThinLTO,direct 缩短了 21.8%,iface 缩短了 7.3%。
direct 的函数调用与指令数
针对与 §5.3.1 相同的调用结构,比较了有无 LTO 时的反汇编结果。
表 5.8: direct 工作负载的反汇编对比
C000_M2 | 无 LTO | ThinLTO |
|---|---|---|
| 指令数 | 15 | 11 |
函数调用(bl) | 2 | 0 |
| 栈帧 | 有 | 无 |
| callee-saved 寄存器的保存 | x19、x20、x29、x30 | 无 |
| 内存访问 | 5 次 | 1 次 |
Core.Mix 和 Core.Idx 的函数体被展开到调用方,不再需要 2 条 bl 指令以及栈和寄存器的保存处理。跨越两个函数的表达式也被一并优化。direct 缩短 21.8%,是这一变化在 3,072 个方法上累积的结果。
iface 改善较小的原因
IL2CPP 生成的 interface 调用,概括起来是 清单 5.10 的形式。
清单 5.10: IL2CPP 生成的 interface 调用代码概要
1 2 3 | const VirtualInvokeData& invokeData = il2cpp_codegen_get_interface_invoke_data(slot, obj, declaringInterface); return ((Func)invokeData.methodPtr)(obj, p1, p2, invokeData.method); |
由于被调用方是运行时获取的 invokeData.methodPtr,无法像常规的 C++ vtable 调用那样去虚拟化。不过,方法体中调用其他 TU 辅助函数的部分可以内联,因此 iface 也缩短了 7.3%。
如果 interface / virtual 调用耗时较多,也可以考虑 sealed、以具体类型接收、以及通过泛型实现静态分派。ThinLTO 容易改善的是静态调用其他 TU 中小函数的部分。
5.5.5. 大小与构建时间
表 5.9: IL2CPP ThinLTO 的大小与构建时间
| 配置 | libil2cpp.so (MB) | 其 .text | 冷构建 |
|---|---|---|---|
| off | 37.36 | 基准 | 62s |
| thin | 38.16 (+2.2%) | +2.3% | 71s (+15%) |
在该配置下,受内联展开的影响,libil2cpp.so 增加了 2.2%。由于 LTO 有时也会删除无用代码,大小变化的方向取决于代码库和优化内容。冷构建从 62s 增加到 71s,增加了 15%。ThinLTO 在链接时进行跨 TU 优化和机器码生成,链接时间会相应延长。
5.6. Master 配置中启用的优化
在 Master 配置中,启用 LTO 的同时优化级别也会改变(表 5.5)。为了查明 CPU 时间的缩短是由哪项设置带来的,分别对二者进行了测量。为了分别考察优化级别(-Os → -O2)和 LTO 的影响,实测了 {-Os, -O2} × {无 LTO, ThinLTO} 的 2×2 组合(Android 6000.5 / arm64)。
表 5.10: 优化级别与 ThinLTO 的 CPU 实测对比
| direct (us/pass) | 无 LTO | ThinLTO |
|---|---|---|
| -Os(Release) | 19.64(基准) | 15.54 (-20.9%) |
| -O2(Master) | 18.47 (-5.9%) | 15.54 (-20.9%) |
表 5.11: 优化级别与 ThinLTO 的 libil2cpp.so 大小对比
| libil2cpp.so | 无 LTO | ThinLTO |
|---|---|---|
| -Os | 37.36MB | 38.16MB (+2.2%) |
| -O2 | 39.14MB | 44.14MB (+12.8%) |
CPU 时间的缩短率,仅 -O2 时为 5.9%,包含 ThinLTO 的配置为 20.9%。在该基准测试中,Master 配置的改善大部分来自 ThinLTO。Release + 手动 ThinLTO 与 Master 的 CPU 时间同为 15.54us,但最终 libil2cpp.so 的大小分别为 38.16MB 和 44.14MB,Release + 手动 ThinLTO 小约 13.5%。
表 5.12: Release + ThinLTO 与 Master 的冷构建时间
| 配置 | 冷构建 |
|---|---|
Release (-Os,无 LTO) | 62s |
| Release + ThinLTO | 71s (+15%) |
Master (-O2 + ThinLTO) | 86s (+39%) |
冷构建分别为 71s 和 86s,仅在 Release 中添加 ThinLTO 的配置短 15 秒。在 Unity 的公开测量中,Master 配置(libil2cpp.so 侧)也是 CPU -2.3%、到首次显示的时间 -5.7%,而 libil2cpp.so 大小 +18.7%、构建时间 +30〜35%。CPU 的改善幅度,Unity 为 -2.3%,本章的基准测试为 -20.9%。不过,Unity 测量的是实际项目的整个主线程,本章只测量反复调用小函数的路径,因此无法直接比较这些数字。另一方面,大小和构建时间在本章的 Master 中也分别为 +18.2%、+38.7%,与 Unity 的公开值接近。
5.7. 在实际项目中的验证
在规模比基准测试更大的 2 个实际项目中也尝试了 ThinLTO。Unity 版本、程序集数、源代码量和二进制大小见 表 5.13。
表 5.13: 实际项目的 Unity 版本与代码规模
| 条目 | 项目 A | 项目 B |
|---|---|---|
| Unity 版本 | 6000.5.3f1 | 6000.3.15f1 |
| 进入 Player 的程序集数 | 158 | 285 |
被编译的 .cs | 6,969 个文件 | 16,700 个文件 |
| 其行数 | 约 138 万行 | 约 319 万行 |
| 其中自有代码 | 1,943 个文件 / 约 35 万行 | 8,606 个文件 / 约 154 万行 |
libil2cpp.so(未压缩) | 189.0MB | 294.3MB |
5.7.1. Release + ThinLTO 的大小与应用确认
表 5.14: 项目 A 的大小与构建时间
| 条目 | baseline | ThinLTO | 差异 |
|---|---|---|---|
| libil2cpp.so(未压缩) | 189.01MB | 194.70MB | +5.69MB (+3.0%) |
其 .text | 8.54MB | 8.98MB | +0.44MB (+5.1%) |
| APK | 165.85MB | 166.94MB | +1.08MB (+0.65%) |
| Player 构建部分 | 约 396s | 约 433s | 约 +9% |
.text +5.1% 大于基准测试(+2.3%),符合“asmdef 划分得越细,跨模块内联越多”的预期。即使是 189MB 的 libil2cpp.so,也能在本地机器上完成 ThinLTO 的链接。
在项目 B 中,使用 llvm-readelf -S 按节比较了 libil2cpp.so 的大小(表 5.15)。
表 5.15: 项目 B 的 libil2cpp.so 各节差异
| 条目 | baseline | ThinLTO | 差异 |
|---|---|---|---|
| libil2cpp.so(整个文件) | 294.30MB | 304.12MB | +3.34% |
il2cpp | 145.85MB | 162.22MB | +11.23% |
.text | 10.69MB | 11.14MB | +4.18% |
.rela.dyn | 50.28MB | 45.01MB | -10.48% |
.got | 1.76MB | 1.4KB | -99.92% |
.gcc_except_table | 3.70MB | 3.62MB | -2.32% |
.text 的增长率 4.18% 介于项目 A(5.1%)和基准测试(2.3%)之间。.got 从 1.76MB 减少到 1.4KB。这一结果表明,LTO 解析了跨模块引用,经由 GOT 的间接引用被转换为直接引用。包含动态重定位条目的 .rela.dyn 削减 10.5%,也与这一变化相对应。
5.7.2. 实际项目中的 Master 与 full LTO (项目 A)
以实际项目的规模尝试了 §6 中 Master 配置与 full LTO 的比较。
表 5.16: 项目 A 的构建配置对比
| 项目 A | baseline | Release + thin | Master | full LTO |
|---|---|---|---|---|
| libil2cpp.so | 189.0MB | 194.7MB (+3.0%) | 222.2MB (+17.6%) | — |
| 构建 | 453s | 465s | 537s(9 分钟) | 2,903s(48 分钟)后失败 |
| 链接器路径的峰值 RSS | — | — | 12.9GB | 20GB → Killed: 9(OOM) |
full LTO 在构建 48 分钟后,链接期间的内存使用量达到 20GB,被 OS 强制终止。在 §5.3 的基准测试中,full LTO 的 CPU 时间与 ThinLTO 相当,但冷构建从 71s 增加到 247s,约 3.5 倍。在该项目中无法完成构建,ThinLTO 更为实用。
Master 的 libil2cpp.so 大小比 baseline 增加了约 33MB,但 CPU 性能与 Release + thin 相当。Release + thin 的大小增加控制在约 5.7MB 以内,因此在该项目中也能以更小的二进制文件获得与 Master 同等的性能。
5.7.3. 实际项目中的 CPU 周期 (项目 B)
在局外的稳态界面中,合计测量了 Pixel 8a 所有线程的 CPU 周期。ThinLTO 和 baseline 交替各测量 3 个会话,每个会话的值是 6 次 20 秒测量的平均值。
表 5.17: 项目 B 各会话的 CPU 周期
| 会话 | 总周期 (Gcyc) | UnityMain (Gcyc) |
|---|---|---|
| ThinLTO #1 | 44.88 | 27.48 |
| ThinLTO #2 | 45.18 | 27.36 |
| ThinLTO #3 | 45.54 | 27.60 |
| baseline #1 | 46.06 | 29.05 |
| baseline #2 | 45.71 | 27.89 |
| baseline #3 | 46.15 | 28.23 |
| 平均(ThinLTO vs baseline) | 45.20 vs 45.97 → -1.68% | 27.48 vs 28.39 → -3.21% |
5.7.4. 与 Unity 公开值的比较
将 Unity 公开的 Master 配置(libil2cpp.so 侧)测量值与项目 B 的结果进行比较。同时也列出了 §6 的基准测试结果。
表 5.18: Unity 公开值与本章实测结果的比较
| 指标 | Unity 公开(6 个项目、Master) | 基准测试 | 项目 B |
|---|---|---|---|
| CPU | 主线程 -2.3% | direct -21.8% | UnityMain -3.21% / 总周期 -1.68% |
libil2cpp.so | +18.7% | +2.2%(Release+thin)/ +18.2%(Master) | +3.0% |
| 构建时间 | +30〜35% | +15%(Release+thin)/ +38.7%(Master) | +9〜15% |
Unity 的 CPU 时间缩短率 -2.3% 与项目 B 的 UnityMain -3.21%,都是百分之几的改善。与基准测试 -21.8% 的差距,可以用实际项目的测量中包含不在 LTO 范围内的处理来解释。Unity 测量的 6 个项目也呈现同样的趋势。
大小和构建时间因配置而有差异。Unity 的公开值在 Master 配置下分别为 +18.7% / +30〜35%。与本章测得的 Master 配置的 +18.2%(44.14MB / 37.36MB)/ +38.7%(86s / 62s)也相近。作为基准的 libil2cpp.so 大小也相近,分别为 37.26MB / 37.36MB。
仅在 Release 中添加 ThinLTO 时,以大小 +2〜3%、构建时间 +9〜15% 的代价获得了同等的 CPU 性能。从 §6 的 2×2 比较来看,Master 配置中大小和构建时间的增加,主要是由改为 -O2 所致。
5.7.5. 优化的覆盖范围与实际项目中的改善幅度
项目 B 的改善集中在主线程。UnityMain 为 -3.21%,而非 UnityMain 整体为 +0.8%,处于会话间 4% 漂移的范围内。
在二进制文件方面,libil2cpp.so 以外的 .so 几乎没有变化。2 个原生插件的 md5 完全一致,其余 1 个的 .text 差异为 +0.008%,处于构建非确定性的范围内。本次通过 --compiler-flags 进行的优化没有波及这些插件。
UnityMain 的 -3.2% 小于基准测试的 -22%。在该界面中,表情、眨眼、头发和服装的摆动、IK 等作为 Job 执行。它们包含在 libil2cpp.so 之外的原生二进制文件中,不在本次标志优化的范围内。
排除范围外的处理后,仅 IL2CPP 生成代码的改善幅度应大于 UnityMain 整体的 -3.21%。但要求得准确的值,需要用 Profiler 分离范围内外的处理时间。由于 Job 也会根据调度在主线程上执行,UnityMain 的测量值中也包含范围外的处理。
5.8. 在 iOS 上应用 ThinLTO
在项目 B 的 iOS 版上也应用了 ThinLTO。在验证用基准测试中确认了效果,但在实际项目中没有获得与构建时间增加相称的改善。
5.8.1. iOS 上 LTO 的结构
表 5.19: Android 与 iOS 上 LTO 结构的比较
| 角度 | Android | iOS |
|---|---|---|
| il2cpp 的输出 | libil2cpp.so | libGameAssembly.a |
| 最终链接 | il2cpp 调用的 LLD | Xcode 生成 UnityFramework 时的 ld64 |
| 传递的参数 | --compiler-flags=-flto=thin --linker-flags=-flto=thin | 仅 --compiler-flags=-flto=thin |
| 构建时间增加的位置 | Unity 的构建步骤 | Build ipa(xcodebuild)步骤 |
在 iOS 上,il2cpp 只创建归档文件,因此不传递 --linker-flags。LTO 的代码生成在 Xcode 侧读取包含该 bitcode 的归档文件进行链接时进行。
由于生成代码的编译由 il2cpp 负责,标志必须指定到 AdditionalIl2CppArgs。即使修改 Xcode 的 LLVM_LTO = YES_THIN,也不会应用到生成代码。
引擎代码以预构建的 libiPhone-lib.a 形式提供,不含 bitcode,因此不在 LTO 的范围内。也没有像 Android 的引擎代码 LTO 开关(§3)那样替换为已应用 LTO 的引擎的设置。
5.8.2. iPhone 13 的验证用基准测试
首先,将与 §5.3 相同的验证用基准测试移植到 iOS,确认对生成代码的 ThinLTO 在 iOS 上是否同样有效。direct 跨越分布在 16 个 asmdef 中的 3,072 个小方法进行调用,是 ThinLTO 最容易发挥效果的配置。因此,这里的改善率不是一般项目可以直接获得的值,而应视为条件吻合时接近上限的值。
设备为 iPhone 13(iPhone14,5 / iOS 18.7.8)。使用了 Unity 6000.5.3f1、IL2CPP Release、OptimizeSpeed。baseline 与 ThinLTO 的区别仅在于有无 --compiler-flags=-flto=thin。Xcode 为 ReleaseForRunning,开发签名为 get-task-allow=true,Unity 的 Development Build 已禁用。
每个会话都执行卸载、重新安装、启动,在 5 次预热后记录 30 个样本。测量顺序为 baseline / ThinLTO / ThinLTO / baseline,共 3 个区块、12 个会话。所有会话的热状态均为 Nominal。由于处理次数按会话自动调整,direct 和 iface 归一化为每 pass、Physics 归一化为每 step。
表 5.20: iPhone 13 的验证用基准测试结果
| 工作负载 | baseline | ThinLTO | 差异 |
|---|---|---|---|
direct | 21,231.31ns/pass | 16,184.31ns/pass | -23.77% |
iface | 366.96ns/pass | 370.39ns/pass | +0.93% |
| Physics(范围外的对照) | 147.82us/step | 147.36us/step | -0.31%(分布重叠) |
direct 在全部 3 个区块中均为 -23.6〜-23.9%,baseline 与 ThinLTO 的所有会话完全分离。与 Android 的 -21.8%(§5.4)也相近,可以确认对生成代码的 ThinLTO 在 iOS 上同样切实有效。另一方面,iface 略有恶化,范围外的 Physics没有出现差异。ThinLTO 的效果偏向于静态小函数调用跨越 TU 的路径。同一基准测试的二进制大小见 表 5.21。
表 5.21: iPhone 13 验证用基准测试的二进制大小
| 条目 | baseline | ThinLTO | 差异 |
|---|---|---|---|
| UnityFramework | 98.76MB | 107.52MB | +8.76MB(+8.87%) |
__text | 20.09MB | 20.46MB | +0.37MB(+1.83%) |
il2cpp | 22.49MB | 30.78MB | +8.30MB(+36.89%) |
5.8.3. 项目 B 的结果与在 iOS 上放弃采用的理由
接着,在项目 B 的 iOS 版上应用了 ThinLTO。UnityFramework 的大小见 表 5.22,构建时间见 表 5.23。
表 5.22: iOS UnityFramework 的各节差异
| 节 | baseline | ThinLTO | 差异 |
|---|---|---|---|
| UnityFramework(整个文件) | 316.53MB | 393.47MB | +24.31% |
__TEXT(段) | 261.83MB | 338.53MB | +29.29% |
il2cpp | 167.02MB | 240.26MB | +43.85% |
__text | 57.99MB | 61.70MB | +6.41% |
__gcc_except_tab | 6.85MB | 6.63MB | -3.16% |
__unwind_info | 3.44MB | 3.38MB | -1.75% |
__got | 18.8KB | 18.8KB | ±0 |
| ipa(整个归档) | 233.83MB | 246.93MB | +5.60% |
表 5.23: iOS 的构建时间
| 步骤 | baseline | ThinLTO |
|---|---|---|
Build ipa(xcodebuild) | 357s(5m57s) | 3,094s(51m34s) |
UnityFramework 增加了 +24.31%,ipa 增加了 +5.60%。构建时间约为 9 倍,增加了 46 分钟。增加的大部分来自 Xcode 侧的链接和 dsymutil,与 Android 的 +9〜15% 相比大幅延长。将 GCC_OPTIMIZATION_LEVEL 降为 -Os 的配置(-Os + thin)也耗时 53m51s,未能缩短。
在项目 B 的稳态界面中,cpu/wall 的简单平均值 ThinLTO 为 +1.08%,略有恶化;即使在热状态一致的组合中也仅有 -1.45% 的改善。baseline 与 ThinLTO 的分布重叠,无法分离出明显的 CPU 改善。内存差异 +0.40% 也低于会话内的波动。验证用基准测试的 -23.77% 是集中了对 ThinLTO 有利的调用时的值,不适用于整个实际项目。
由于在实际项目中无法确认明确的改善,且冷构建和 CI 每次都需要约 46 分钟的额外时间,本次验证中决定不在 iOS 上采用手动 ThinLTO。
5.9. 如何在自己的项目中引入
在 Android 上,建议首先采用在 Release 配置中添加 -flto=thin 的方法。在本次基准测试中,以更小的二进制文件和更短的构建时间获得了与 Master 同等的 CPU 性能。在实际项目的稳态界面中,总周期也减少了 1.68%,UnityMain 减少了 3.21%(§7.3)。
引擎代码 LTO 开关(§3)因禁用 Strip Engine Code 导致的大小和内存增加较大,在本次配置下不推荐。
iOS 上的手动 ThinLTO 没有与构建时间增加相称的改善,因此放弃采用。
采用前,请通过 Release 构建的 Profiler 捕获查看 PlayerLoop 内的脚本执行时间。手动标志的作用范围在 libil2cpp.so 内,渲染线程、GPU、引擎内部和 GC 不在范围内。以其他 AOT 管线编译的 Job 也不包含在内(§7.5)。大量使用 DOTS/Job 的项目,还需确认这部分的处理时间。
例如,在 33ms 的帧中脚本执行占 8ms,即使将这部分缩短约 20%,整帧也只缩短约 1.6ms。建议仅在脚本执行在整帧中占比较大、有改善余地,或必须维持高帧率的情况下考虑引入。
如果构建时间的增加影响开发中的工作,也可以不在日常开发构建中应用,仅在 staging 及之后阶段的构建中应用。由于标志在构建前处理中添加(清单 5.6),可按构建类型切换。
设置后,按 §3.1 和 §5.2 的步骤确认是否已应用。确认点是 inputdata、二进制文件的 md5、编译命令中的 -flto,以及目标文件的 bitcode。即使不满足 LTO 的条件构建也可能成功,因此仅凭构建结果无法判断是否已应用。
[*1] Unity Android 平台团队《Boosting Android performance with LTO optimizations in Unity 6.5》https://discussions.unity.com/t/boosting-android-performance-with-lto-optimizations-in-unity-6-5/1720008。此后,本章中所写的“Unity 的公开值”均指该文章中的数字。