第2章. 自动化每日构建的真机性能分析
真机的性能分析,大多只在有人觉得需要时才会去做。发布前的冲刺阶段有人连上 Profiler,发现尖峰或内存增长,再去查找导致问题的提交。在这种流程下,排查“从何时开始恶化”的范围往往是几周的变更。本章介绍一种配置,用于在每次每日构建后自动在真机上执行测量。
该配置由三个部件组成:出借真机的设备农场、集成到应用中并接受外部操作的远程操作服务器,以及把测量数据发送到服务器的测量 SDK。从设备农场远程借用真机,通过远程操作依次遍历游戏的各个界面,同时用测量 SDK 发送内存快照和 Profiler 捕获。把它作为每日构建的后续任务接入 CI 后,每次产出构建都会积累以提交为单位的测量数据。积累的数据可以通过命令行取出,因此也成为让 AI 智能体读取变更并推进到修复方案的入口。
本章讲解在公司内部项目中运行的每日巡检工作流,以及为此所做的各项改进。截至撰写时仅支持 Android 设备,iOS 支持计划在今后实现。
2.1. 在构建之后接入测量任务
流水线按 图 2.1 的顺序进行。设备的获取、应用的操作、测量数据的发送分别由不同的工具负责。即使把其中任何一个替换为其他工具,这种分工也可以照常使用。
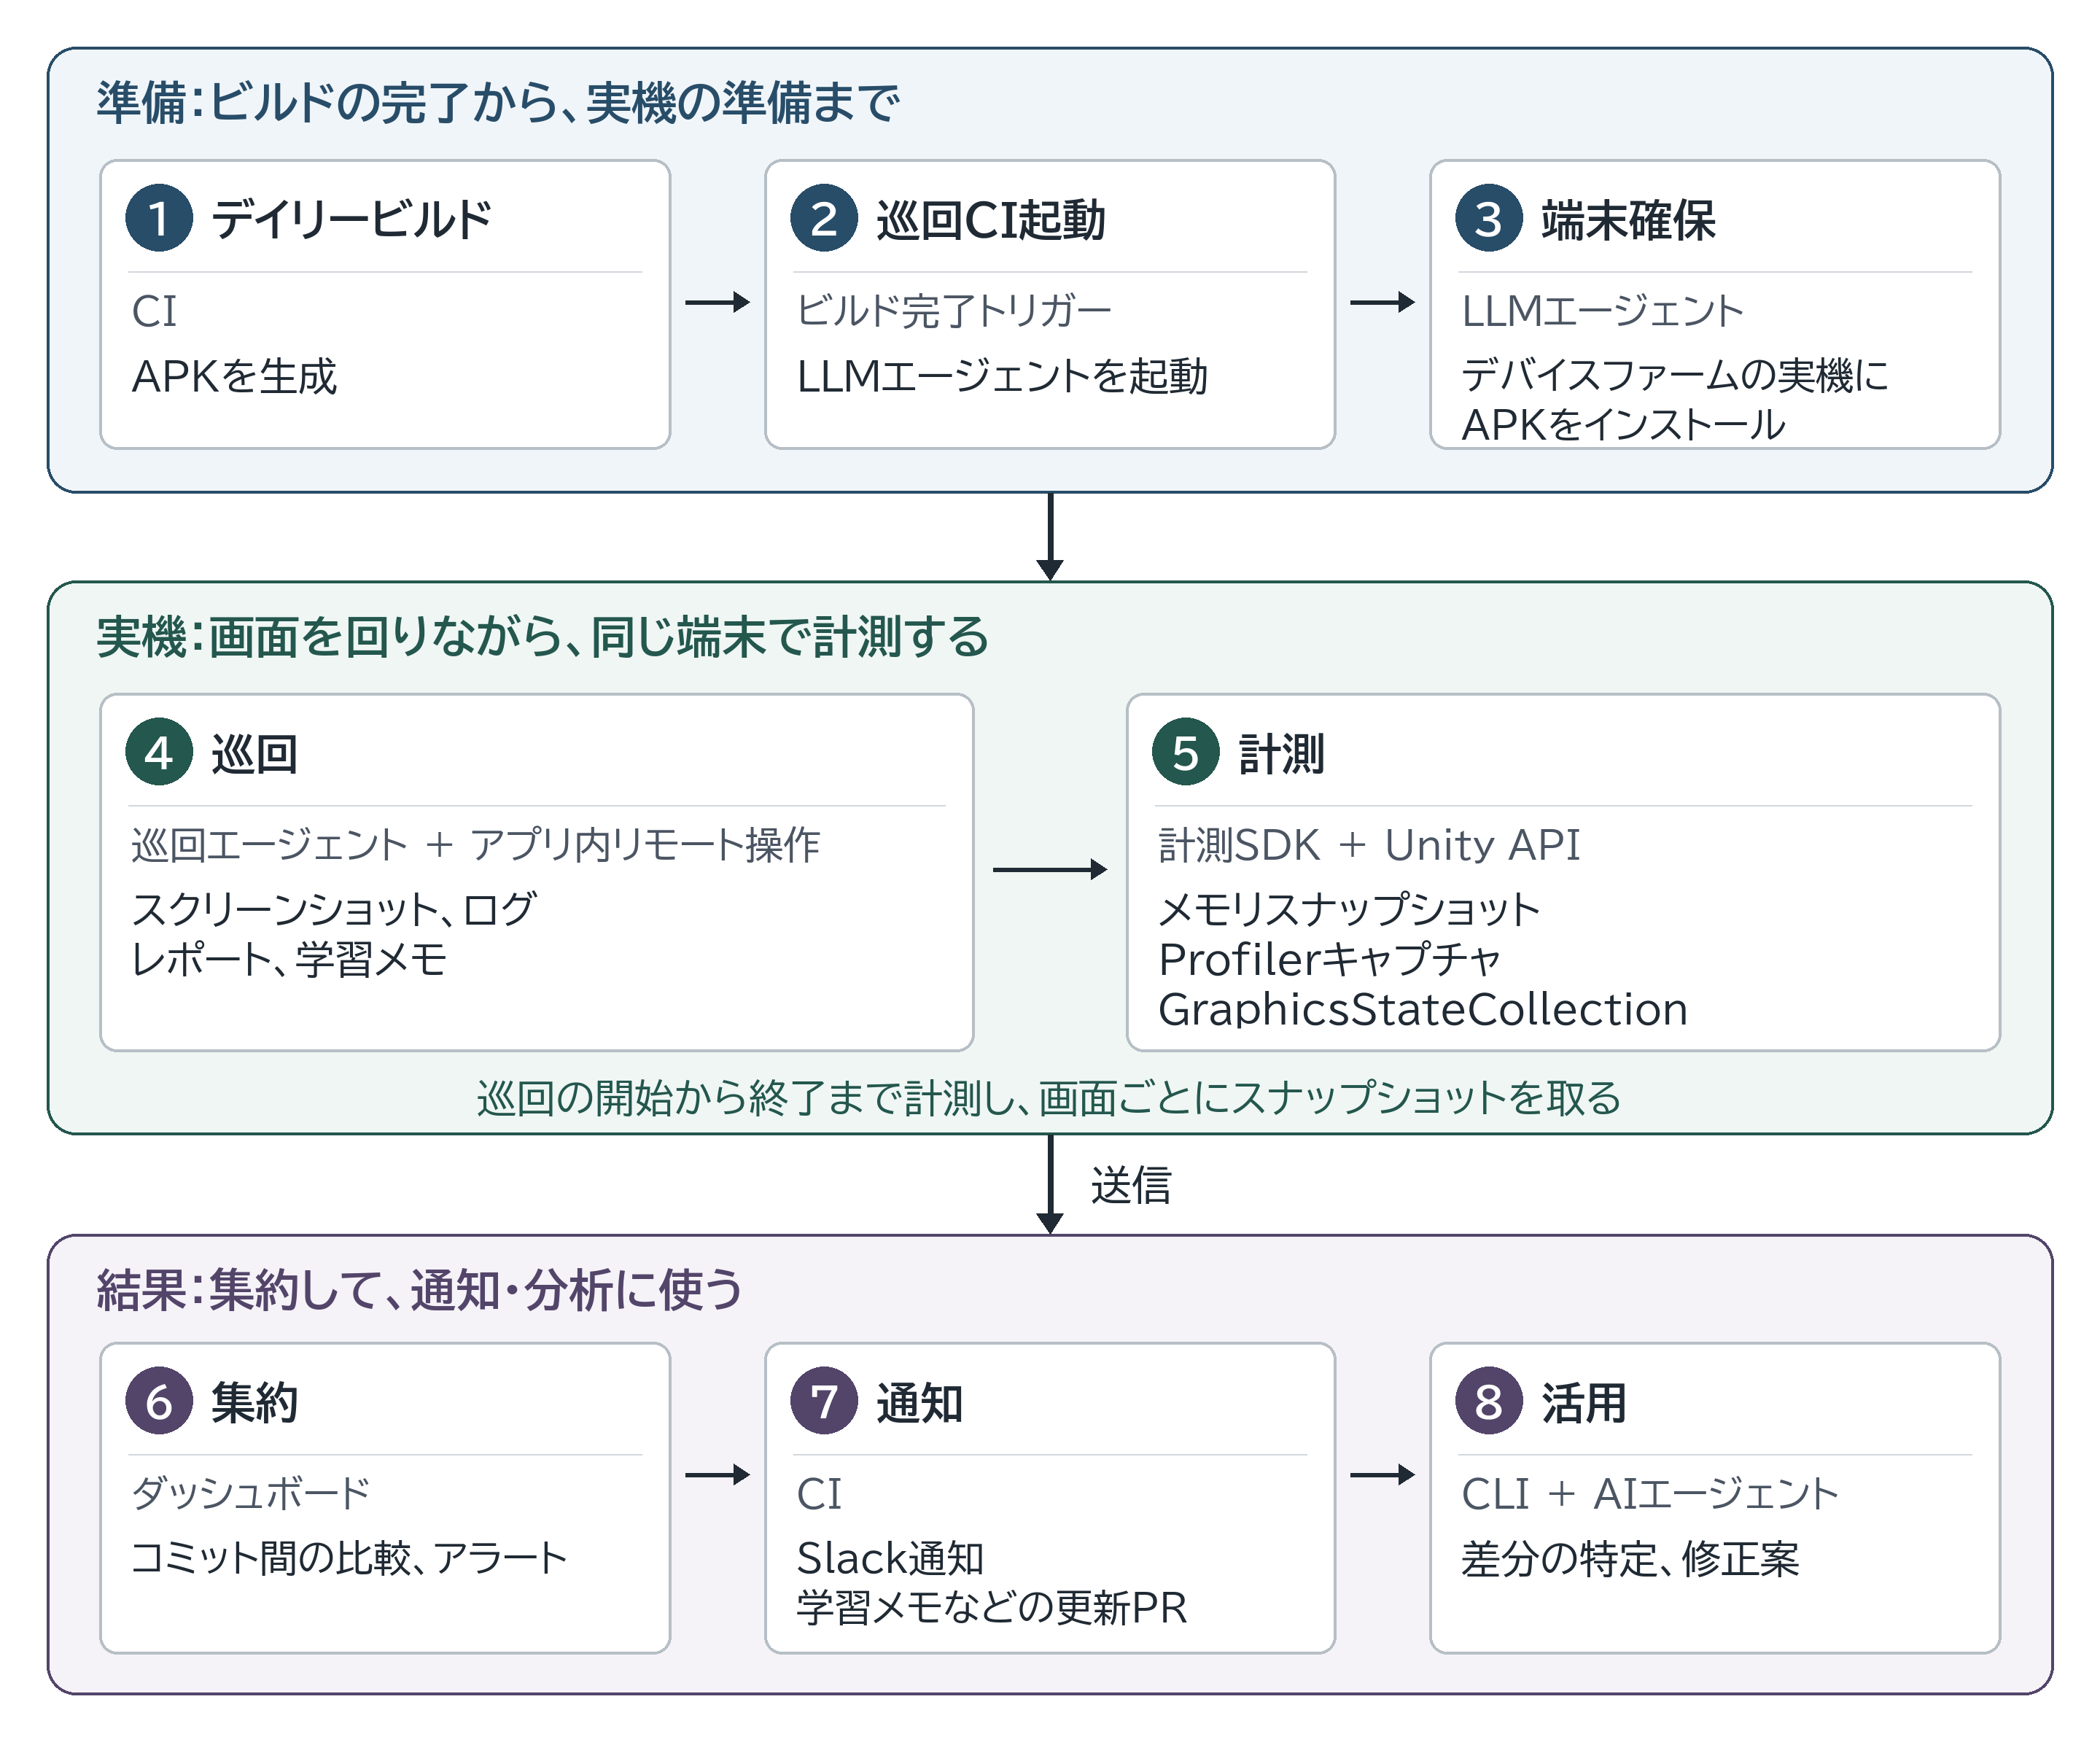
图 2.1: 每日测量流水线的各阶段
不对每日构建本身做改动。每日构建中无需另外嵌入巡检用的流程,也无需预先设置测量代码;正因为不放置这类以测量为前提的代码,即使在内部结构剧烈变化的开发阶段,巡检也不会被破坏,从而保持了稳定性和灵活性。具体方法将在下文详细说明。
2.2. 由 CI 接收构建完成事件并启动巡检
每日构建完成后,另一个工作流会订阅构建完成的触发器,仅在构建成功时启动巡检。此时传递给后续工作流的是构建 APK 的 run ID。
启动的工作流根据 run ID 确定构建产物并下载。之后启动负责巡检的 LLM 智能体。截至撰写时,模型使用 Claude Opus 5.5,决定推理深度的 effort 设为 medium。
2.3. Unity 的测量在应用内部进行
本章要自动化的是 Unity 侧的测量。目的是每天以相同的形式获取并比较 Unity 内部的明细,例如哪些资源占用了内存、哪些 Profiler 标记开销较大。
可从设备外部使用的测量手段中当然也有很多有用的工具。iOS 上可以用 Instruments 的 Time Profiler 以调用栈为单位追踪瓶颈。Android 上也可以用 simpleperf 或基于它的 Android Studio CPU Profiler,采样到 IL2CPP 生成的原生函数的粒度。把这些工具用于自动化也完全可行,但不在本次范围之内。
Unity 内部的明细,平时是用 Unity 编辑器的 Profiler 或 Memory Profiler 连接真机来获取的。但一旦在 CI 巡检中引入编辑器,需要考虑的事情就会骤然增多。runner 每次打开项目都要等待 Library 文件夹的导入,每个 runner 还需要 Unity 许可证。此外,除了编辑器与真机的连接,还必须准备让智能体操作编辑器的通路(如 Unity MCP),配置会变得复杂。
因此,我们决定在 CI 上不使用编辑器,仅使用运行时 API,在应用程序内部完成测量。
2.4. 从设备农场借用设备
设备农场使用的是可以从浏览器操作真机的 STF 平台*1。不过本章使用的并非通过浏览器界面操作设备农场,而只是通过 API 获取设备:预约设备后会返回远程 adb 端点,在 CI 的 runner 上可以像 USB 连接一样使用。从预约到安装 APK 整合为一个脚本,CI 只需一步调用。
如果只是为了巡检,有一台空闲的 Android 10 以上设备就足够;但若要按天比较测量结果,设备每天都变就无法比较。测量用途应固定机型,没有空闲时当天就跳过,这样可以避免积累无法比较的数据。
2.5. 通过应用内远程操作遍历界面
应用的操作使用集成到应用中的远程操作服务器。应用启动后仅在设备内部等待命令,CI 的 runner 通过 adb 连接并发送命令。除了确认应用是否在运行、获取场景中的对象结构、截图、获取日志等固定命令之外,还可以在应用内执行用 JavaScript 编写的任意处理。
这些 JavaScript 由 Jint*2 解释执行,可以直接访问 C# 类型。按名称查找并点击 UI 按钮、读取导航的当前节点、启动测量 SDK,都可以通过同一通路完成。这接近于可以在真机上即时编写并试运行 C# 代码的环境,测量 SDK 的 API 也可以在不重新构建的情况下从外部调用。每次修改阈值或目标界面时,无需重新生成 APK。
要每天比较测量结果,就必须每天以相同的顺序经过相同的界面。固定坐标的点击会在设备分辨率或布局变化时偏移,因此改为按名称获取运行时的 UI 对象,直接触发 UI 框架的事件。当前处于哪个界面,则通过读取导航状态来判断。如果项目侧已有界面跳转图的定义,可以直接用作巡检计划的输入。
2.6. 上传快照和捕获两种数据
测量数据的发送使用笔者所属组织开发的测量平台。集成到应用中的 SDK 把测量数据发送到服务器,服务器端进行积累,并在仪表盘上提供按天比较和恶化时的告警。
SDK 能发送的不只是 Unity 的内存快照和 Profiler 捕获。CPU 时间明细、Draw Call 数等渲染开销、代码中任意区间的处理时间、应用启动时间、按固定间隔采集的内存使用量变化等也都可以发送,只要纳入巡检,就同样可以纳入持续跟踪观测的范围。本章仅针对其中的 表 2.1 两种进行说明。
表 2.1: 每日巡检发送的测量数据
| 种类 | 采集时机 | 前提 | 发送量的考虑方式 |
|---|---|---|---|
| 内存快照 | 到达各界面并稳定之后 | Development Build | 每个界面 1 份,全部发送 |
| Profiler 捕获 | 从巡检开始到结束采集 1 份 | 启用了 Profiler 的构建 | 仅发送超过阈值的帧 |
2.6.1. 快照按界面采集
内存快照与 Unity 的 Memory Profiler 格式相同,根据 Unity 的规范只能在 Development Build 中获取*3。每日构建的巡检用 APK 必须是 Development Build,不能把发布配置的构建挪用于测量。
快照在巡检到达某个界面且加载趋于稳定后采集 1 份。名称中包含界面名和提交哈希,以便之后把同一界面在不同日期的数据并列比较。
2.6.2. 捕获每次巡检采集 1 份,并在设备上筛选
Profiler 捕获是由 SDK 在设备上逐步读取 Unity 写出的原始 Profiler 日志,只把符合条件的帧写入另一个文件并上传。之所以不原样保留全部帧,是因为 Profiler 不适合长时间记录。编辑器的 Profiler 窗口最多只能保留 2,000 帧,在 60fps 下约为 30 秒出头。由于会从旧帧开始丢弃,即使连接编辑器记录几十分钟的巡检,留下的也只有最后 30 秒左右。如果每次都写出为文件,帧数就没有上限,但这次文件会膨胀到一次巡检几十 GB。无论作为 CI 的构建产物保留,还是每天积累,都太大了。
捕获在巡检开始时启动,在最后统一执行停止和上传。启动时要决定的是保留哪些帧的阈值,用帧时间和 GC 分配量两个值指定。停止操作会在消化完原始日志中尚未读取的部分后才完成。由于筛选在测量期间也在并行进行,即使像 Deep Profiling 那样写出速度很快,未读取的积压也几乎不会堆积。即便如此,为了避免在停止完成前归还设备,停止操作会在巡检截止时间之前留出余量提前开始。
2.6.3. 只读取帧边界,GC 按时间戳匹配
原始日志是把各线程的缓冲区以块为单位依次追加而成的。要知道哪个块属于哪一帧,需要找到帧边界。线索在于 Profiler 的写出方式。Profiler 在写入帧边界的前后都会切换线程缓冲区,因此帧边界会以仅十几字节的独立块的形式到达。于是筛选线程只打开不超过这个长度的块,确认它是否为帧边界。更长的块不读取内容,直接视为属于该线程的当前帧。当主线程收到下一帧的边界时,帧长度就确定了,此时判断是否保留,并只把要保留的帧的块按原顺序写出。像采样器名称、线程名称这类不属于任何帧的定义块会全部写出,因此输出可以直接在 Unity 的 Profiler 窗口中打开。
GC 分配量无法从原始日志中获取。原始日志的帧统计中虽然也有 GC 一栏,但从 Unity 2022.3 到 6000.5,在确认过的所有捕获中都为 0。因此在测量期间,主线程每帧用 ProfilerRecorder 读取 GC Allocated In Frame 计数器。ProfilerRecorder 的值不带时间戳,所以在同一帧内读取 ProfilerUnsafeUtility.Timestamp 并附加到值上。这个时间戳与原始日志帧边界中记录的时间戳使用同一时钟。筛选线程把某一帧开始到下一帧开始之间打上的值,作为该帧的 GC 分配量进行匹配。某一帧的值要到下一帧内才能得到,因此在值到达之前会等待数帧再做判断。
在设备上进行筛选,可能会让人担心这本身是否会加重测量负担。筛选在专用线程中进行,主线程只做数据增长情况的确认和 GC 计数器的读取。如前所述,大多数块不读取内容,因此筛选所需的处理仅限于极少部分数据。筛选线程和写出 Profiler 数据的 Dispatcher 线程通过线程名识别并从输出中排除。另外,筛选处理也排除在 Deep Profiling 的范围之外。如果包含在内,筛选线程的每一次方法调用都会成为采样,并被写入正在读取的原始日志中。不过,GC 计数器是整个进程的值,因此也包含筛选线程每帧分配的数 KB。与后述的阈值相比这个量足够小,但加上启用 Profiler 本身的开销,不能说测量完全没有带来额外负担。
2.6.4. 阈值根据想观察的问题和数据量来决定
笔者的巡检目前以 300ms、2MB 作为阈值。对于 30fps 的游戏,这大约是正常帧时间的 10 倍,目的不是观察游玩中的细微卡顿,而是检查界面跳转或加载时发生的大幅停顿是否比昨天更多。在这个设置下,整个巡检中只有极少部分帧被保留,数据量可以承受每天持续发送。降低阈值可以捕捉到细微的卡顿,但保留的帧会增多,文件会变大,也会更快触及后述的输出上限。请根据目标游戏的帧率和测量要解决的问题,一边观察数据量一边调整阈值来运行。
2.6.5. 让长时间巡检适配设备的存储容量
巡检时间变长后,原始日志的存放位置也会成为问题。SDK 每达到一定大小就切换原始日志的写出目标,分成连续编号的文件,筛选线程则依次删除已读完的文件。这样设备的存储使用量就会在几个文件的大小上封顶。当筛选滞后、未处理文件堆积过多时,停止记录。切换文件时,Unity 会在新文件开头把此前出现过的采样器名称和对象名称的定义全部重写一遍。由于输出合并为一个文件,第 2 个文件之后的定义几乎都是重复的。因此,与前一次写出内容在字节级完全相同的定义会从输出中省略。输出文件设有 1.5GB 的上限,在下一个要保留的帧将超过上限时停止记录。可上传的大小最多为 2GB,所以在此之前停止,确保上限之内保留的帧一定能发送出去。
捕获中还嵌入了每一帧的截图。因为仅凭 Profiler 的数值,很难知道尖峰发生时处于哪个界面、显示了什么。画面通过异步 GPU 回读获取,图像要在数帧后才能得到。因此在每帧结束时重新嵌入最后得到的图像,使无论保留哪一帧都附带图像。从 Unity 6.6 开始,Profiler 的标准功能也能连续记录截图,并且截图功能默认启用。但拍摄固定为每 15 帧 1 次,在笔者的 Android 设备上记录的图像只有 256×112 像素,无法辨认 UI 文字。此外,在 AsyncGPUReadback 不可用的设备上没有其他选项,截图会被静默禁用。在某一天以 300ms、2MB 筛选的捕获中,保留的 71 帧里附带标准截图的只有 6 帧;由于与保留帧不连续的筛选方式不兼容,我们继续使用 SDK 侧的截图。
2.6.6. 为所有数据附加元数据
除了上传捕获时附带的元数据之外,SDK 还具备为所有测量数据附加公共信息的机制。只要在初始化后立即注册构建时嵌入的提交哈希、构建的 run ID、设备型号,快照和捕获就会附带相同的信息,操作侧也无需每次传递。测量结果能够按提交顺序排列,正是因为有这项注册。
2.7. 通过巡检收集着色器预热数据
巡检每天都会把游戏的主要界面走一遍,因此也是收集着色器预热数据的场合。GraphicsStateCollection (GSC) 是一种资源,用于记录运行时使用过的着色器变体与渲染状态的组合,以便下次起可以预先预热。
收集时不使用测量 SDK,而是通过远程操作直接调用 Unity 的 API。巡检开始时开始记录,照常遍历界面,结束时停止记录并写出为设备上应用保存区域中的文件。写出的文件通过 adb 取回到 CI 的 runner。不使用编辑器或 Player 连接,因此与测量一样只在 CI 内部完成。不过,在 IL2CPP 构建中,代码剥离会删除未使用的类型成员,可能导致无法从远程操作调用。巡检用构建需要在 link.xml 中保留 GraphicsStateCollection 的类型。
取回的文件不会直接放入项目。只有在巡检未因错误中断、顺利完成并保存了文件的日子,才把它合并到相同平台和品质设置的现有资源中,移除预热时被警告找不到的变体,然后自动创建资源更新的 PR 并自动合并。每日巡检经过的界面的记录,就这样一点点积累起来。
不过,仅靠这种方法并不能覆盖所有需要的变体。记录的只有巡检实际经过的界面以及当时绘制的内容。巡检未经过的界面、只在特定条件下出现的特效等都会遗漏。关于这类遗漏,以及预热之后仍残留卡顿等陷阱,请参阅第 1 部第 6 章。从头按顺序读到这里的读者,也许已经看过了。
2.8. 从检测恶化到修复 PR 都交给智能体
即使每天积累数据,如果没有人每天早上打开仪表盘,也只是积累而已。这个测量平台还提供从命令行获取数据的 CLI,本章的流水线把从确认恶化到创建修复 PR 的工作交给使用该 CLI 的智能体。不是每次由人来写请求,而是作为测量之后的后续工序每天运行。
巡检的测量结束后,会启动一个与巡检不同的比较用智能体。该智能体通过 CLI 获取今天和前一天的测量数据,比较同一界面的快照以及捕获中保留的尖峰,确认是否有恶化的地方。发现恶化时,把哪个界面的哪个值变化了多少、比较所用的数据、期间包含的提交范围整理起来,作为 issue 登记到 backlog。没有恶化则不登记任何内容。
登记的 issue 由另一个负责修复的智能体接手。它确认 issue 内容,从提交历史中缩小原因范围后进行修复并创建 PR。人从该 PR 的评审开始参与。
2.8.1. 修复的确认也用同一机制在真机上进行
修复的确认与每日巡检分开进行。因为每日巡检是按固定顺序遍历固定界面,不适合针对每个 issue 想确认的界面和条件。于是,以 backlog 上的 issue 变为修复完成(待确认)状态为契机,修复确认用的智能体开始运行。该智能体使用与每日巡检相同的机制,即设备农场的设备、应用内远程操作、测量 SDK,在真机上运行包含修复的构建,并与 issue 中保留的比较基准数据进行比对。只有在真机上确认恶化已消除,才把工单交给 QA。为了确认修复是否生效,开发者无需亲自操作真机。
这套确认机制不仅限于性能恶化,也可用于日常的缺陷修复。如前所述,远程操作实质上与反射相同,能直接访问的处理都可以即时执行,因此智能体几乎可以操作和读取游戏中发生的一切。只要 issue 中写明了复现步骤和期望结果,就可以在真机上按步骤执行,连同游戏内部状态一起确认是否已修复。
2.9. 为了每天持续运行的运维方式
2.9.1. 巡检智能体与测量步骤的分工
本章的巡检是把界面跳转图和远程操作的用法交给编程智能体,由它执行巡检。它具有绕开无法到达的界面、新增界面时重新编排计划的灵活性,但另一方面,一次巡检需要约 90 轮,费用约 5 美元。像测量的启动和停止这类每次都必须相同的部分,不交给智能体判断,而是固定为可复用的步骤,智能体只需在规定时机执行。巡检中学到的内容也以 PR 的形式保留在仓库中,作为下次的输入。
2.9.2. 结果的传递
巡检结果以报告、截图、日志和机器可读的结果文件的形式保留,CI 读取结果文件并通知到 Slack。测量本身的结果在仪表盘上,通知中只要有上传成功与否和仪表盘链接就足够了。比较发现恶化的日子,会附上已登记 issue 的链接通知到同一频道。反之,没有上传的日子,也会在通知中说明未进行测量。因为测量在不知不觉中停止的状态是最难发现的。
2.10. 今后的课题
由于快照和捕获是在同一次巡检中采集的,两种数据会相互干扰。采集快照期间帧会停止数秒,因此在同时运行的捕获中会被记录为尖峰。反之,捕获期间 Profiler 缓冲区的内存会包含在快照中,读取数据时需要注意。如果想准确地查看数据,把快照用和捕获用的巡检分开也是一个选项,但借用设备的时间会大约翻倍,需要在降低频率等方面做出权衡。
Profiler 捕获的粒度也存在课题。每日测量关闭了 Deep Profiling,因此游戏侧的脚本只能看到 MonoBehaviour 的 Update 这样的粒度。想更细致地查看的地方,需要手动添加 ProfilerMarker 或启用 Deep Profiling。因此我们正在探索在构建时的后处理中,为指定程序集的方法自动插入 ProfilerMarker 等方法。它可以作为限定范围的轻量 Deep Profiling 使用,我们认为这样可以在控制数据量和开销的同时更细致地获取明细。
2.11. 总结
我们在每日构建之后接入了这样一个任务:从设备农场借用设备,通过应用内远程操作运行游戏,向测量 SDK 发送内存快照和筛选后的 Profiler 捕获。通过在元数据中附加提交哈希,测量结果成为以提交为单位的历史记录;用 CLI 取出后,从检测恶化、登记 issue 到创建修复 PR,都可以交给 AI 智能体。
本章的配置看起来可能规模很大,但不必一次备齐所有部分。如果您正计划测量自动化,不妨先把一台真机用 USB 连接到构建机,通过 adb 用基于反射运行的解释器采集内存快照,仅此一项或许就已经是像样的内存持续跟踪观测了。希望本章能对各位迈出测量自动化的第一步有所帮助。
[*1] DeviceFarmer/stf(OpenSTF 的后继仓库) https://github.com/DeviceFarmer/stf
[*2] sebastienros/jint, JavaScript Interpreter for .NET https://github.com/sebastienros/jint
[*3] Unity Manual, Memory Profiler package https://docs.unity3d.com/Packages/com.unity.memoryprofiler@1.1/manual/index.html