第1章. Unity 6 Render Graph 图块内存优化
1.0.1. 前言
本章介绍如何利用 Unity 6 的 Render Graph,活用移动端 GPU(基于图块的渲染架构)的图块内存,以削减 GPU 时间、内存带宽与内存占用。在移动端游戏开发中,内存带宽往往比 GPU 的运算性能更早成为瓶颈。此外,内存带宽的消耗直接关系到功耗与发热,因此不仅影响帧率,还会影响设备的发热与电池消耗。本章围绕以下 4 个主题展开讲解,并为每个主题设置了同名的小节。
- 图块内存的加载/存储
- Render Pass/Subpass
- Frame Buffer Fetch
- 无内存(memoryless)
1.1. 基于图块的渲染基础
本节介绍移动端 GPU 为什么会配备图块内存。
1.1.1. 移动端 GPU 与内存带宽
在现代 GPU 中,运算速度与内存读写速度之间的差距越来越大,内存访问已成为主要瓶颈。GPU 核心的运算性能(FLOPS)每一代都大幅提升,而内存带宽的增长却没有跟上。PC 的独立 GPU 通过搭载 GDDR 这类图形专用的高带宽内存来缓解这一问题。但移动端 SoC 做不到这一点。
| 项目 | PC(独立 GPU) | 移动端 SoC |
|---|---|---|
| 图形内存 | 专用(GDDR6 等,数百 GB/s) | 无(LPDDR 由 CPU/GPU/ISP 等共享) |
| 带宽规模 | 数百 GB/s~1TB/s | 数十 GB/s(且为共享) |
| 功耗限制 | 数百 W 级的供电与散热 | 数 W,仅有被动散热 |
移动端 GPU 没有专用的图形内存,而是与 CPU 共享同一块 LPDDR 内存。而且共享方不只是 CPU,还包括相机的 ISP、机器学习加速器等 SoC 上的所有模块。带宽本身就窄,还要相互争抢。此外,访问主内存(DRAM)是 SoC 中功耗尤其高的操作。带宽用得越多,功耗越高,随之发热,热节流又会拉低 CPU/GPU 的时钟频率,导致帧率下降。也就是说,在移动端会出现
内存带宽消耗 → 功耗增加 → 发热 → 热节流 → 性能下降
这样的连锁反应。如果游戏最初几分钟能跑 60FPS,玩一段时间后帧率却逐渐下降,原因往往就是带宽与发热。为了在这种限制下完成画面绘制,基于图块的渲染(TBR: Tile-Based Rendering)架构的 GPU 应运而生。
1.1.2. IMR 与 TBR
为了理解 TBR,我们先将它与 PC GPU 上主流的立即模式渲染(IMR: Immediate Mode Rendering)进行比较。IMR 对绘制调用提交的图元就地进行光栅化,执行片元着色器,并将结果写入内存中的渲染目标。每次深度测试和混合都会对渲染目标进行读写,但 PC GPU 依靠高带宽的图形内存和大容量缓存承受了这些开销。而 TBR 则将屏幕划分为小图块,逐个图块完成渲染。每个着色器核心都配备一小块称为图块内存的片上内存,图块内的绘制(颜色、深度、模板的读写以及混合)全部在这块图块内存上进行。原则上,对主内存的访问只有图块绘制开始时(加载)和结束时(存储)两次。
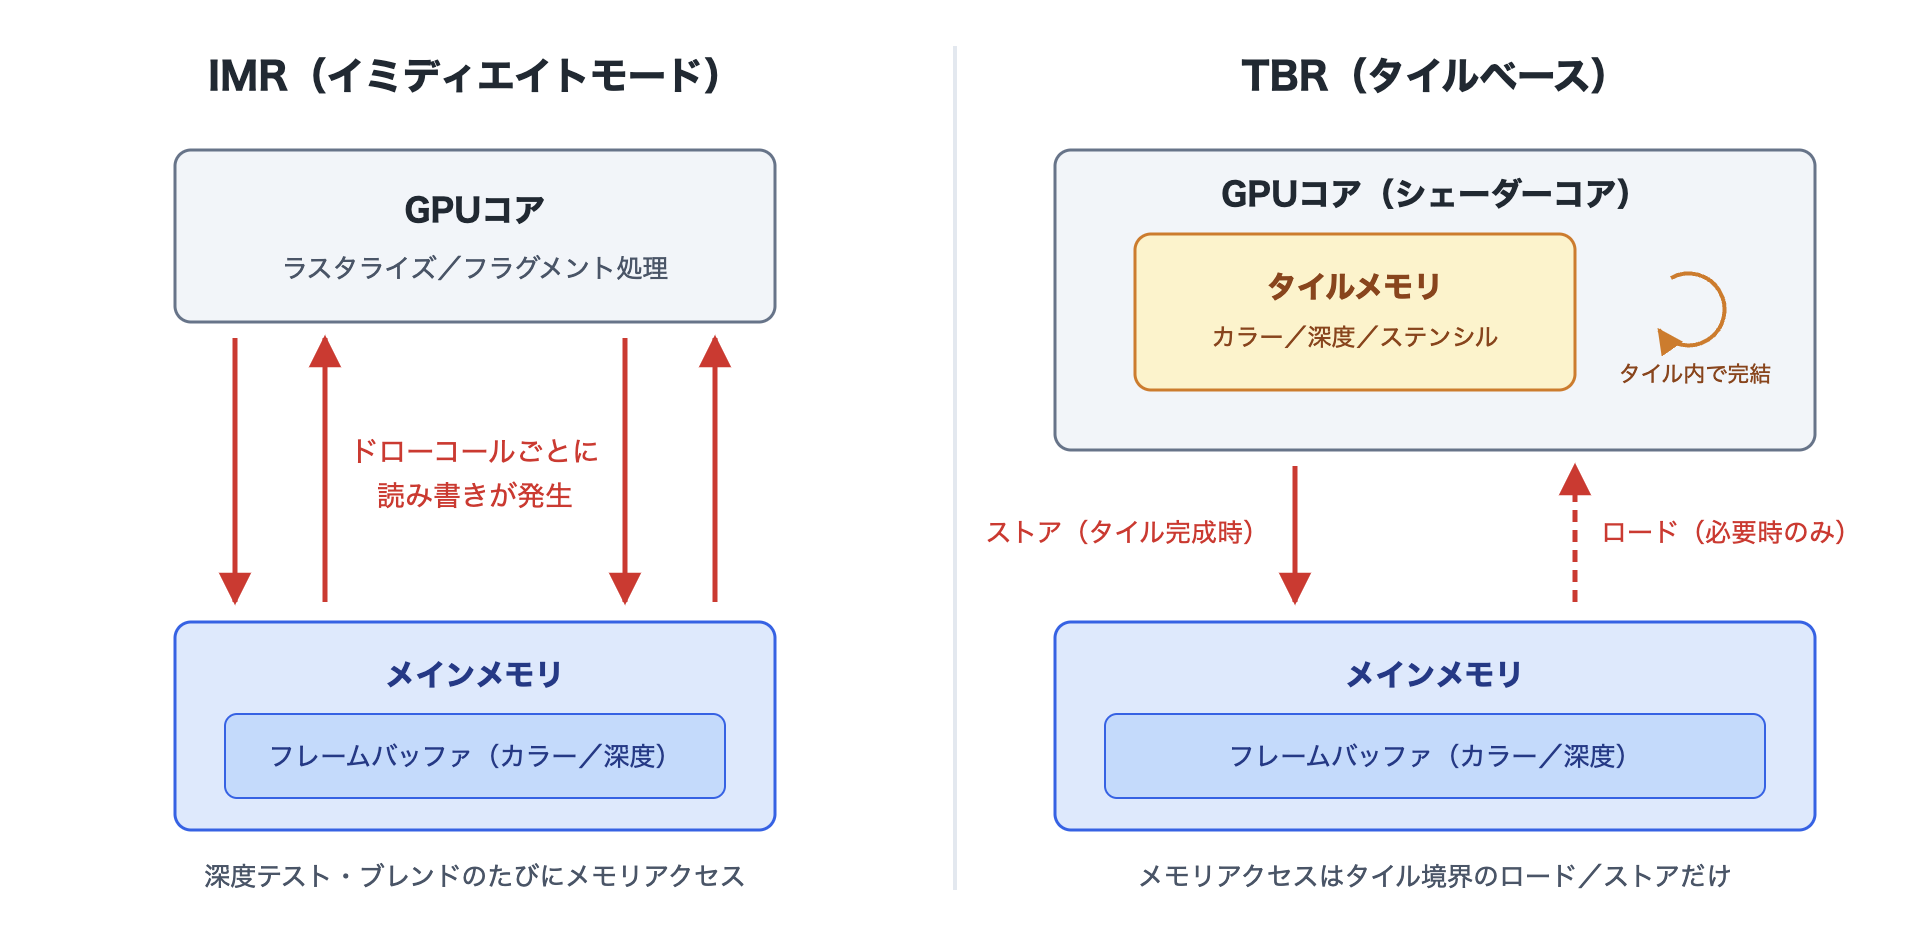
图 1.1: IMR 与 TBR 的比较
下图是 TBR GPU 中着色器核心的概念图。图块内存直接连接着色器核心。由于位于片上且物理距离近,访问图块内存比访问主内存快出一个数量级以上,功耗也低得多。在实际的 GPU 中也能确认这一结构,例如 ARM Mali-G71 官方资料中的着色器核心设计图就展示了图块内存直接连接着色器核心的样子。
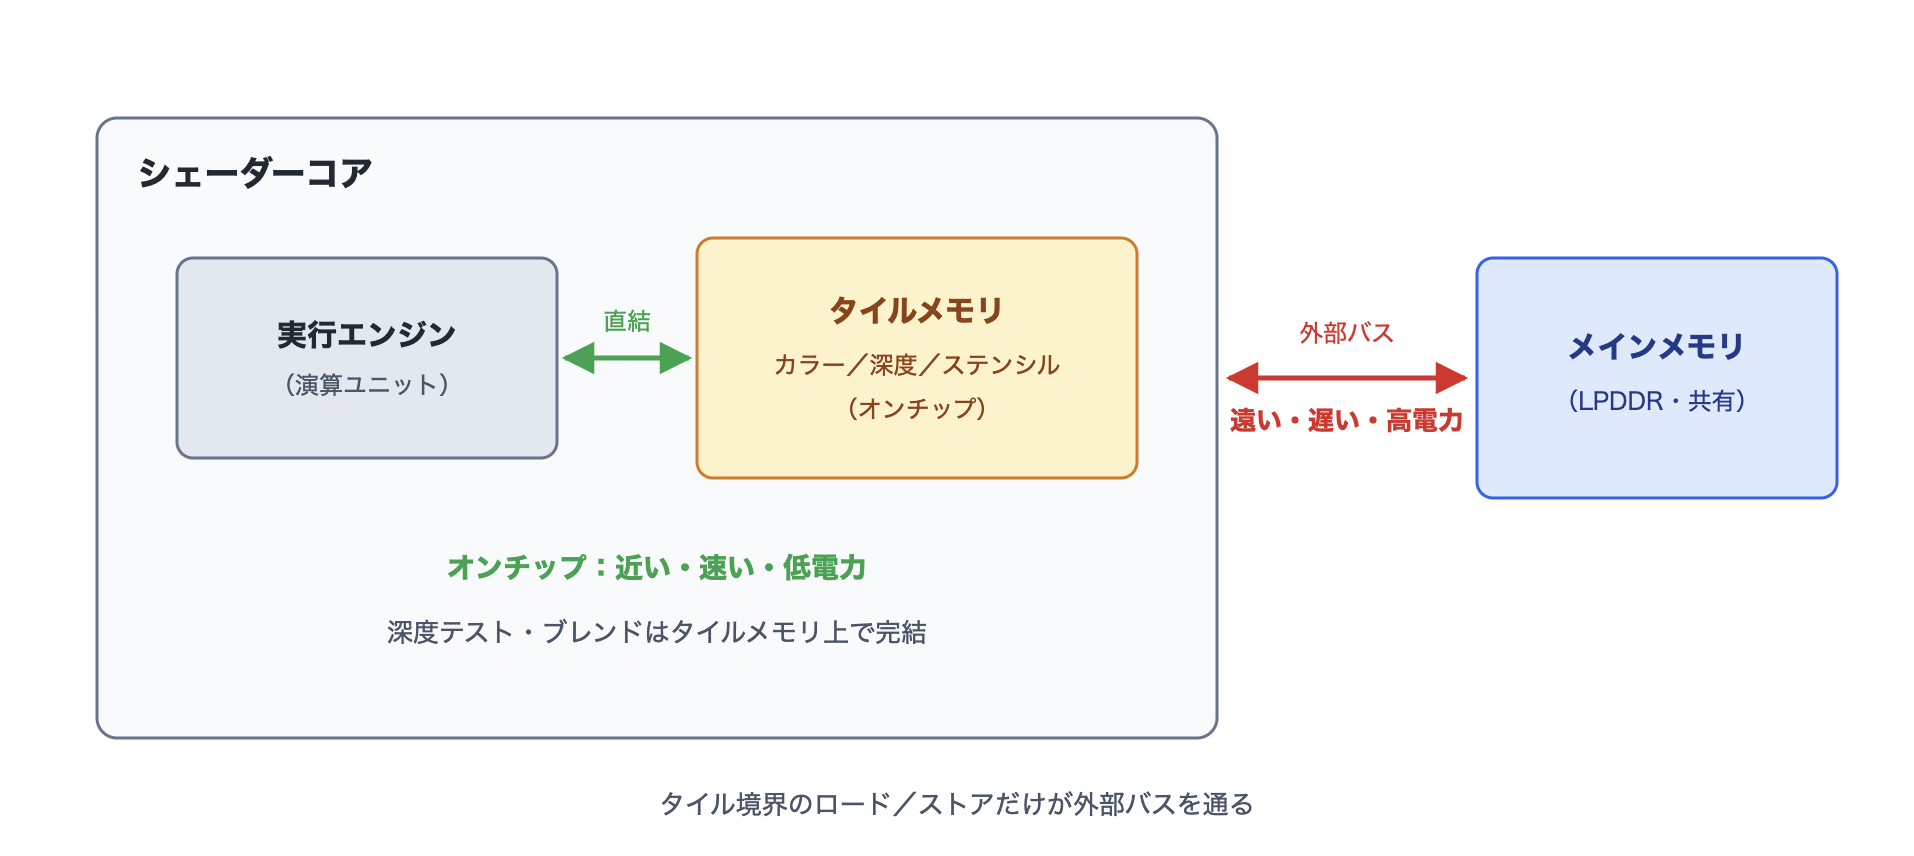
图 1.2: 着色器核心与图块内存(概念图)
这样一来,在 IMR 中内存访问最为频繁的深度测试和混合,在 TBR 中就都在图块内存内完成了。
1.1.3. TBR 的两个阶段
TBR GPU 将一帧的绘制大致分为两个阶段执行。
分箱阶段(几何阶段)
首先,执行帧内所有绘制调用的顶点着色器(其中的位置计算部分),将各图元按所覆盖的图块进行分类(分箱,Binning)。分类结果以“每个图块的图元列表”的形式写入主内存。这里需要注意的是,分箱阶段本身也会消耗主内存带宽。顶点数据越多,图元列表的读写就越多。TBR GPU 在高多边形场景下容易处于劣势,原因就在于此。
光栅化阶段(渲染阶段)
接下来逐个处理图块。对每个图块,
- 如有需要,将渲染目标的现有内容加载到图块内存
- 对覆盖该图块的图元进行光栅化并执行片元着色器(读写全部在图块内存上进行)
- 将完成的图块内容存储到主内存
绘制按上述步骤进行。其中步骤 1 和 3 就是本章的主题——加载/存储。详细内容将在下一节“图块内存的加载/存储”中讨论,但 TBR 的开销结构是:相比图块绘制本身,图块边界处与主内存的数据交换代价更高。
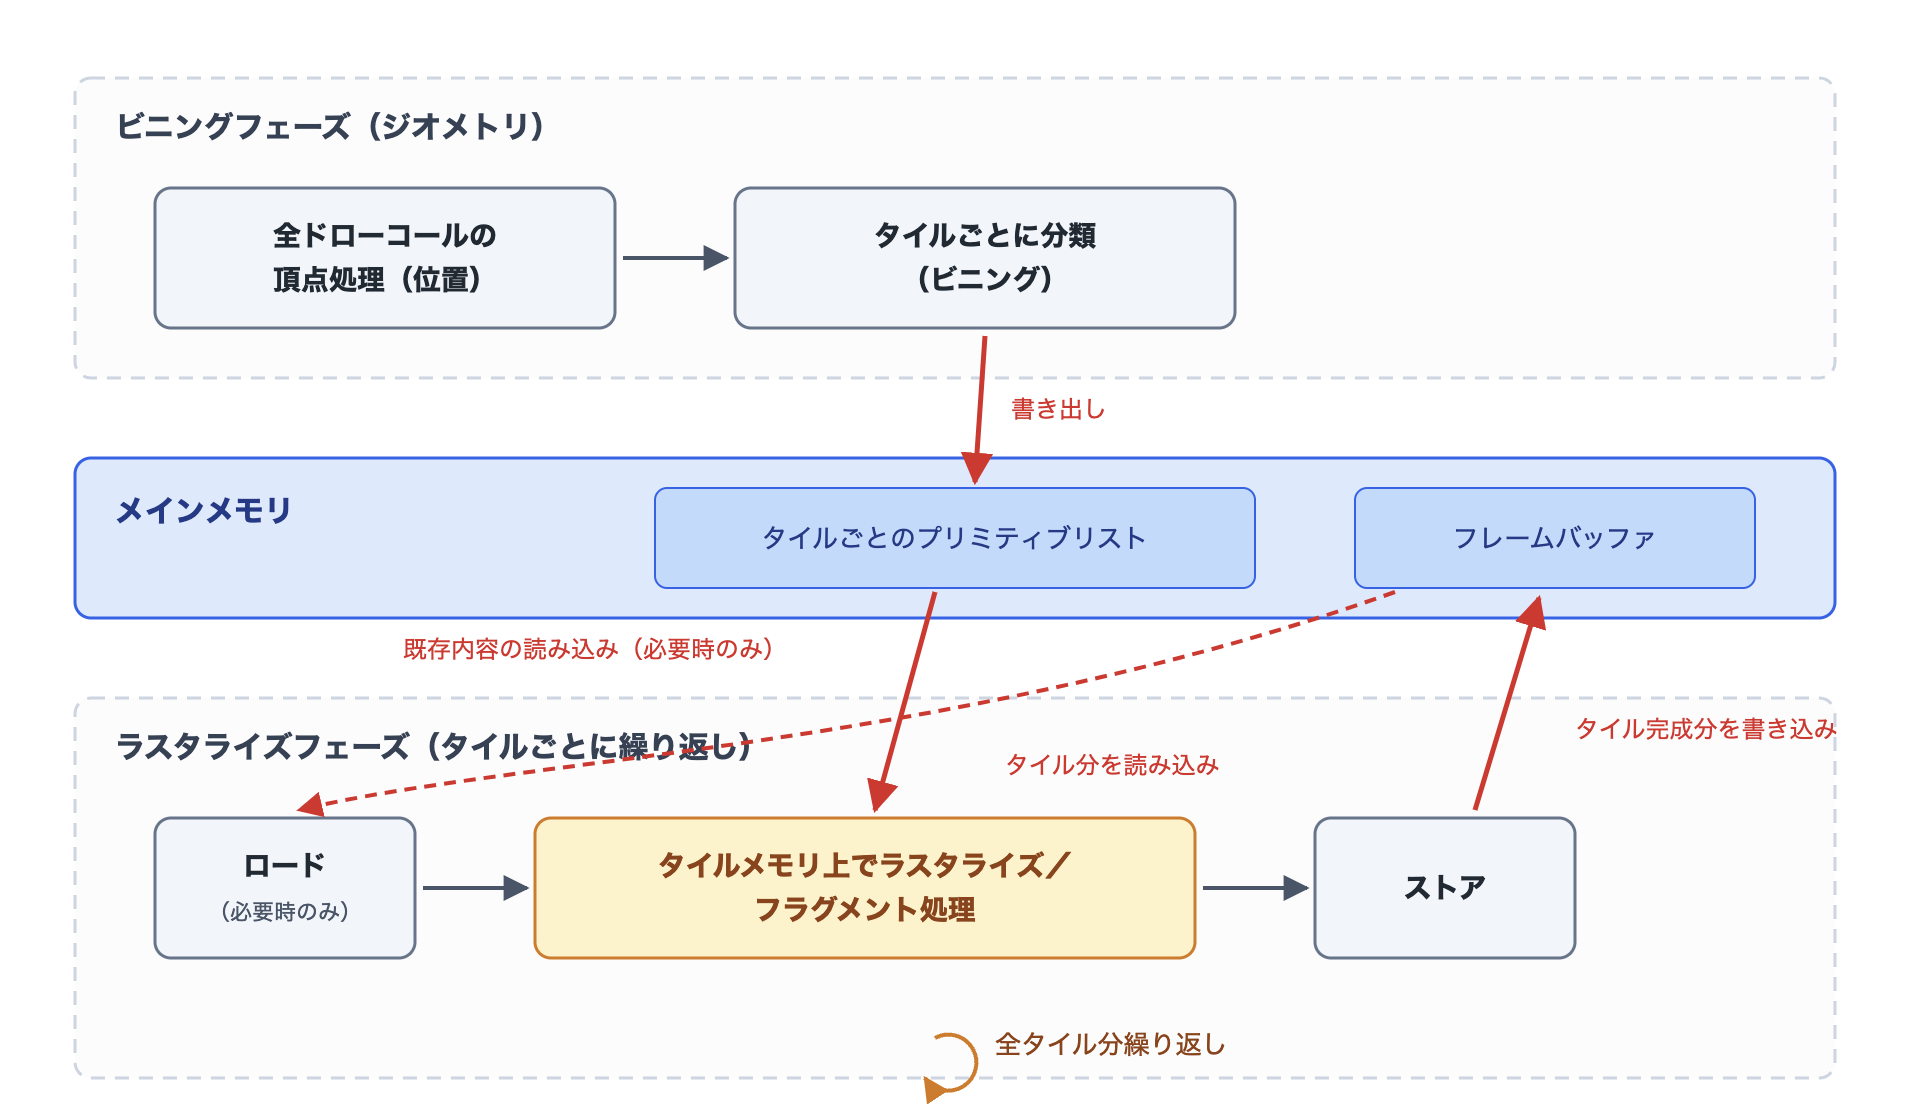
图 1.3: 分箱阶段与光栅化阶段
各厂商的称呼与特性
TBR 的基本结构是共通的,但各 GPU 厂商的称呼和实现细节有所不同。本章后续统一使用图块内存/分箱作为总称。
| 厂商(GPU) | 阶段/机制的称呼 | 备注 |
|---|---|---|
| Qualcomm Adreno | Binning / GMEM | 将称为 GMEM 的片上内存分割使用。具有根据绘制内容切换到类 IMR 行为的模式 |
| ARM Mali | Tiler / Tile Memory | 图块基本为 16×16 像素 |
| Imagination(PowerVR/IMG) | TBDR | 以硬件执行隐面消除(HSR)的 TBDR。Pixel 10 的 IMG DXT 也属于这一系谱 |
| Apple GPU | Tile Memory | PowerVR 系谱的 TBDR。可通过 Metal 显式操作图块内存 |
1.1.4. 本章讨论的 4 个主题
到此为止,我们已经了解图块边界处的加载/存储会产生开销。那么,该如何削减这一开销呢?本章讨论的 4 个主题都是针对这一问题的手段。
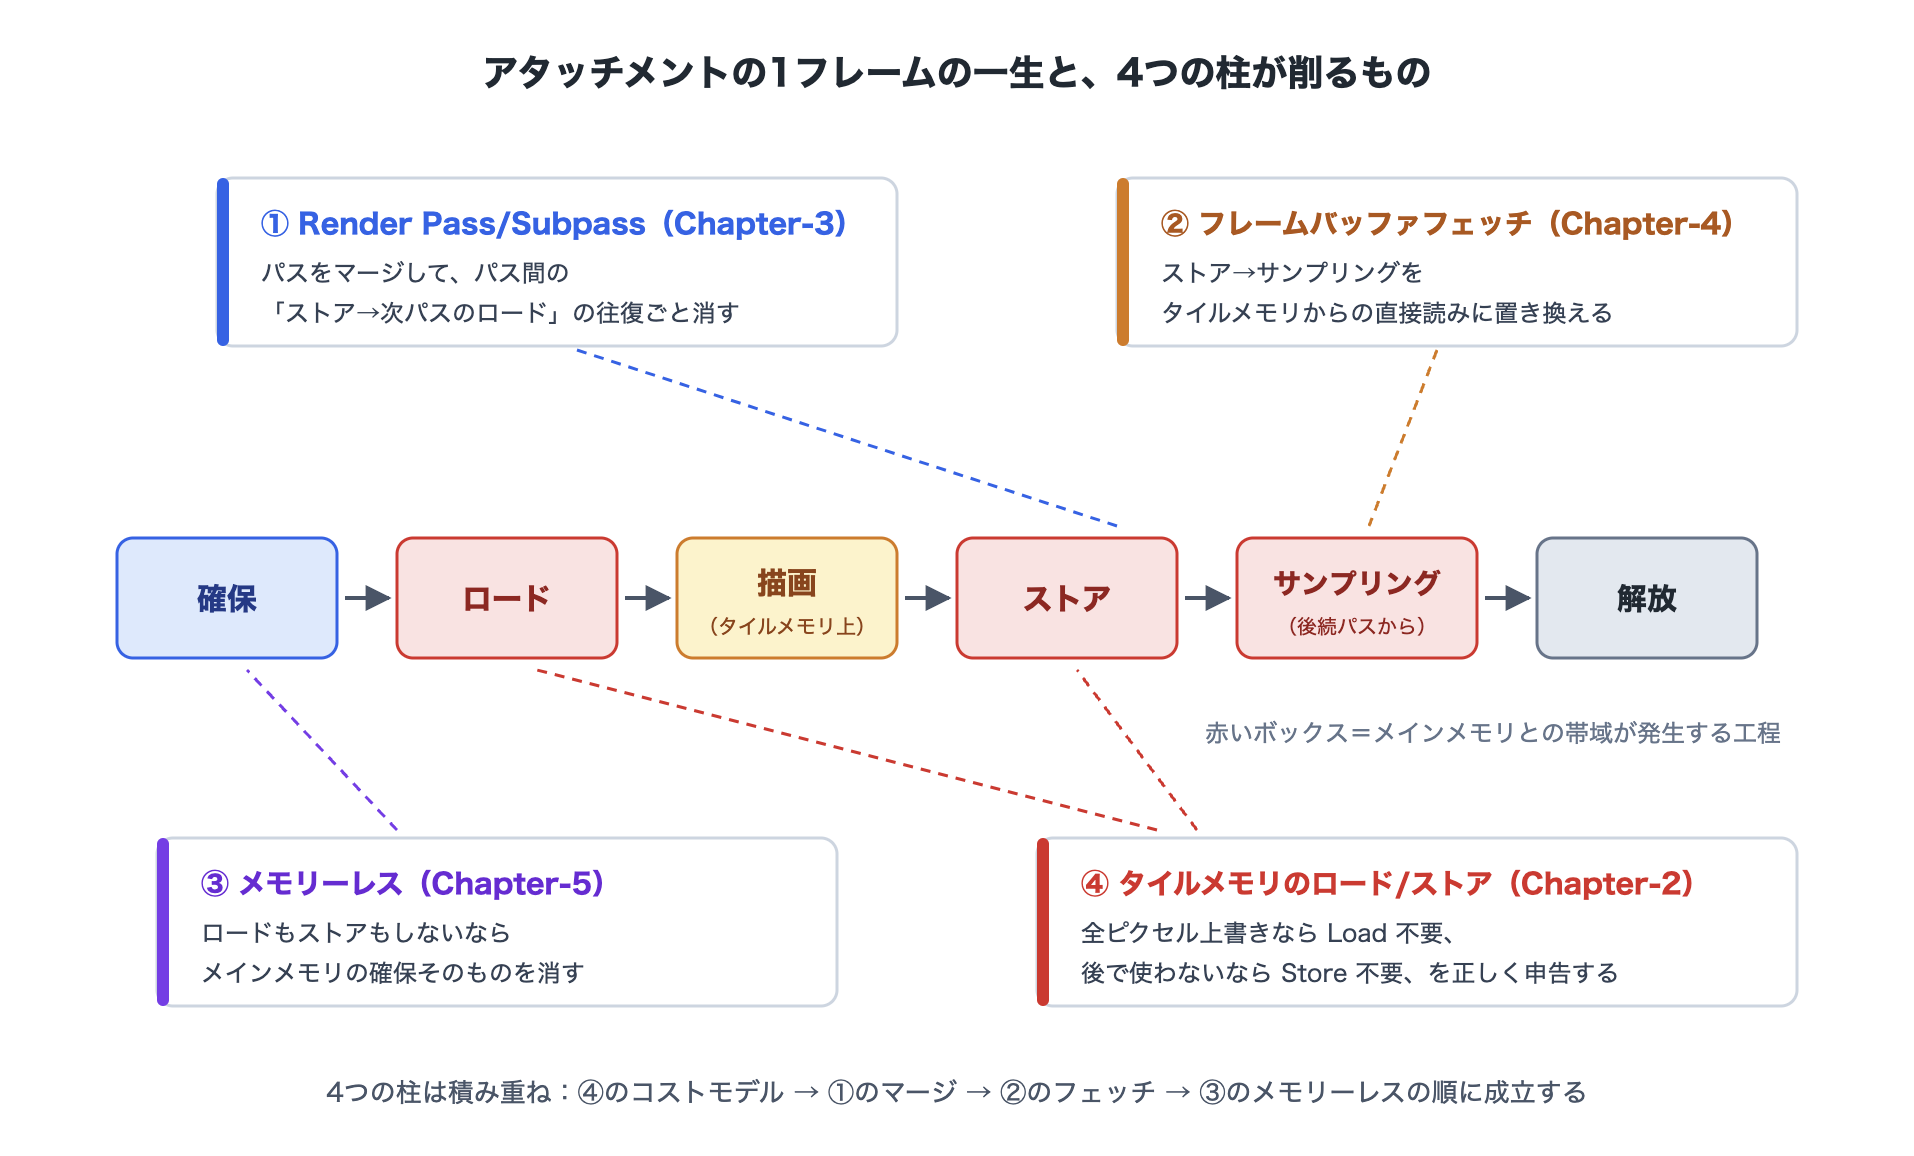
图 1.4: 附件的生命周期与 4 个主题的关系
我们来考虑某个渲染目标(附件)在一帧内的生命周期。
分配 → 加载 → 绘制 → 存储 → (在后续通道中作为纹理)采样 → 释放
根据削减的是这一生命周期中的哪个环节,4 个主题可以整理如下。
| 主题 | 削减的内容 | 思路 | 小节 |
|---|---|---|---|
| 加载/存储 | 不必要的加载与不必要的存储 | 显式声明“若覆盖全部像素则无需加载”“若之后不再使用则无需存储” | “图块内存的加载/存储” |
| Render Pass/Subpass | 通道之间的存储→加载往返 | 将多个通道合并(merge)为一个 Render Pass,使中间结果留在图块内存中 | “Render Pass / Subpass” |
| Frame Buffer Fetch | 存储→采样的往返 | 直接从图块内存读取前一个子通道的结果 | “Frame Buffer Fetch” |
| 无内存(memoryless) | 主内存的分配本身 | 既不加载也不存储的话,主内存上的实体就没有必要 | “无内存(memoryless)” |
这 4 个并非相互独立的技术。通道合并之后才能使用 Frame Buffer Fetch,加载与存储都消除之后无内存(memoryless)才能成立。本章的小节结构也遵循这一依赖关系:开销模型(加载/存储)→ 机制(Subpass)→ 应用(Fetch)→ 收尾(无内存(memoryless))。此外,Render Graph 是先收集各通道的资源使用信息(读什么、写什么),再制定渲染执行计划的系统。因此它能够自动执行通道合并、加载/存储操作的决定、无内存(memoryless)化等优化。可以说,本章讲解的正是如何向 Render Graph 正确传达资源的使用方式,以使这些优化生效。
1.1.5. 验证工具的使用方法
本章会反复进行“先用工具确认管线状态,再进行测量”的流程。主要使用以下 3 个工具。
1.1.6. Frame Debugger
Unity 的 Frame Debugger(Window > Analysis > Frame Debugger)是确认通道结构的基本工具。本章特别关注事件名中的(RP n:m)标记。如果像RP 4:0、RP 4:1那样,同一个 Render Pass 编号(n)下子通道编号(m)连续排列,就说明这些通道已被合并到同一个 Native Render Pass 中。另外,通道合并(Native Render Pass)只在 Vulkan/Metal 等环境下生效。若编辑器的图形 API 为 D3D 等,则无法观察到合并,因此在编辑器中确认时,请将 Graphics API 改为 Vulkan,或将 Frame Debugger 附加到真机构建上。
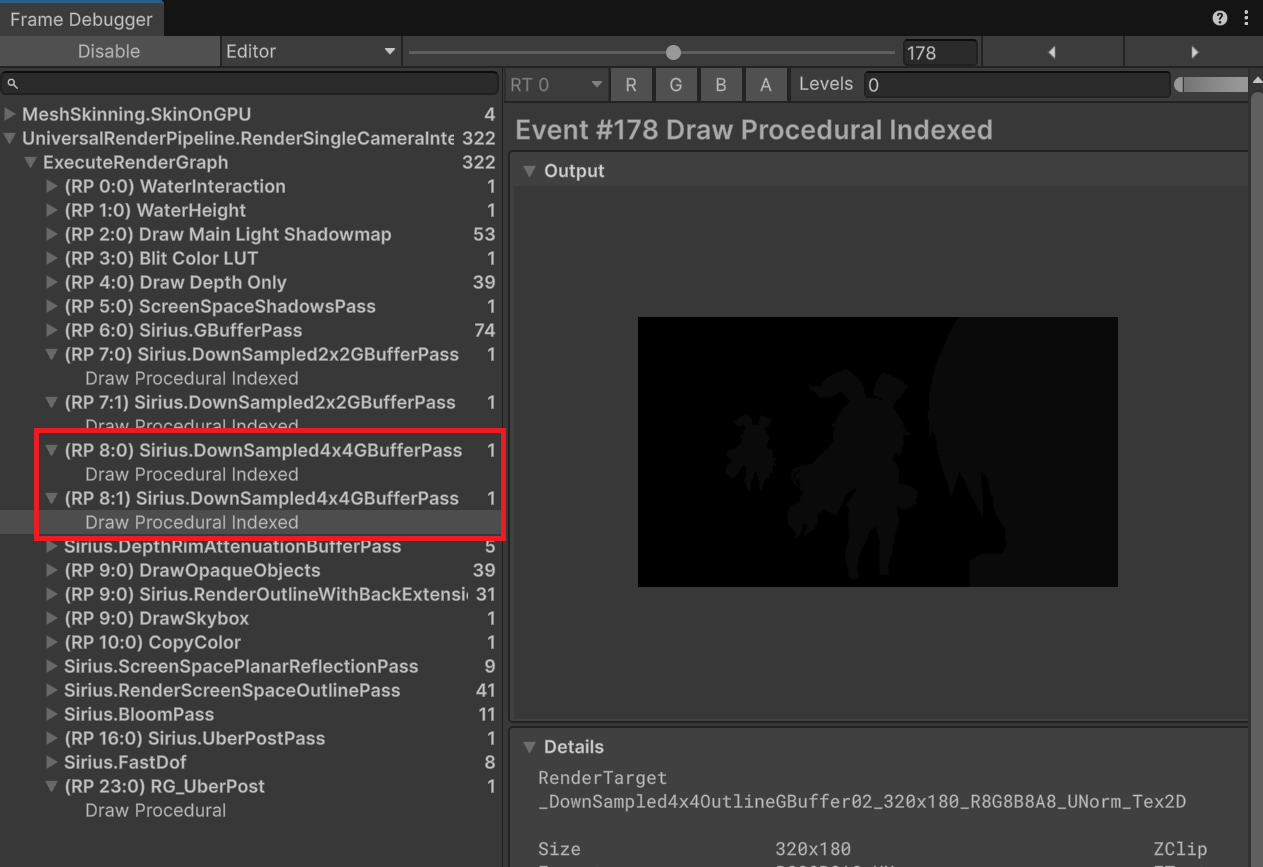
图 1.5: Frame Debugger 中的合并状态
1.1.7. Render Graph Viewer
Render Graph Viewer(Window > Analysis > Render Graph Viewer)是将 Render Graph 构建的执行计划本身可视化的工具。
- 通道列表,以及各通道访问的资源的时间线(哪个资源何时创建、何时销毁)
- 各附件的 Load Action / Store Action 以及 Memoryless 状态的显示。本章将用这一显示来确认优化的结果
- 通道是否已被合并的显示
- 未被合并的理由(Pass Break Reasoning)的显示
第 4 项 Pass Break Reasoning 是“本应合并的通道没有被合并”时首先要确认的信息。从“Render Pass / Subpass”一节起会反复用到。
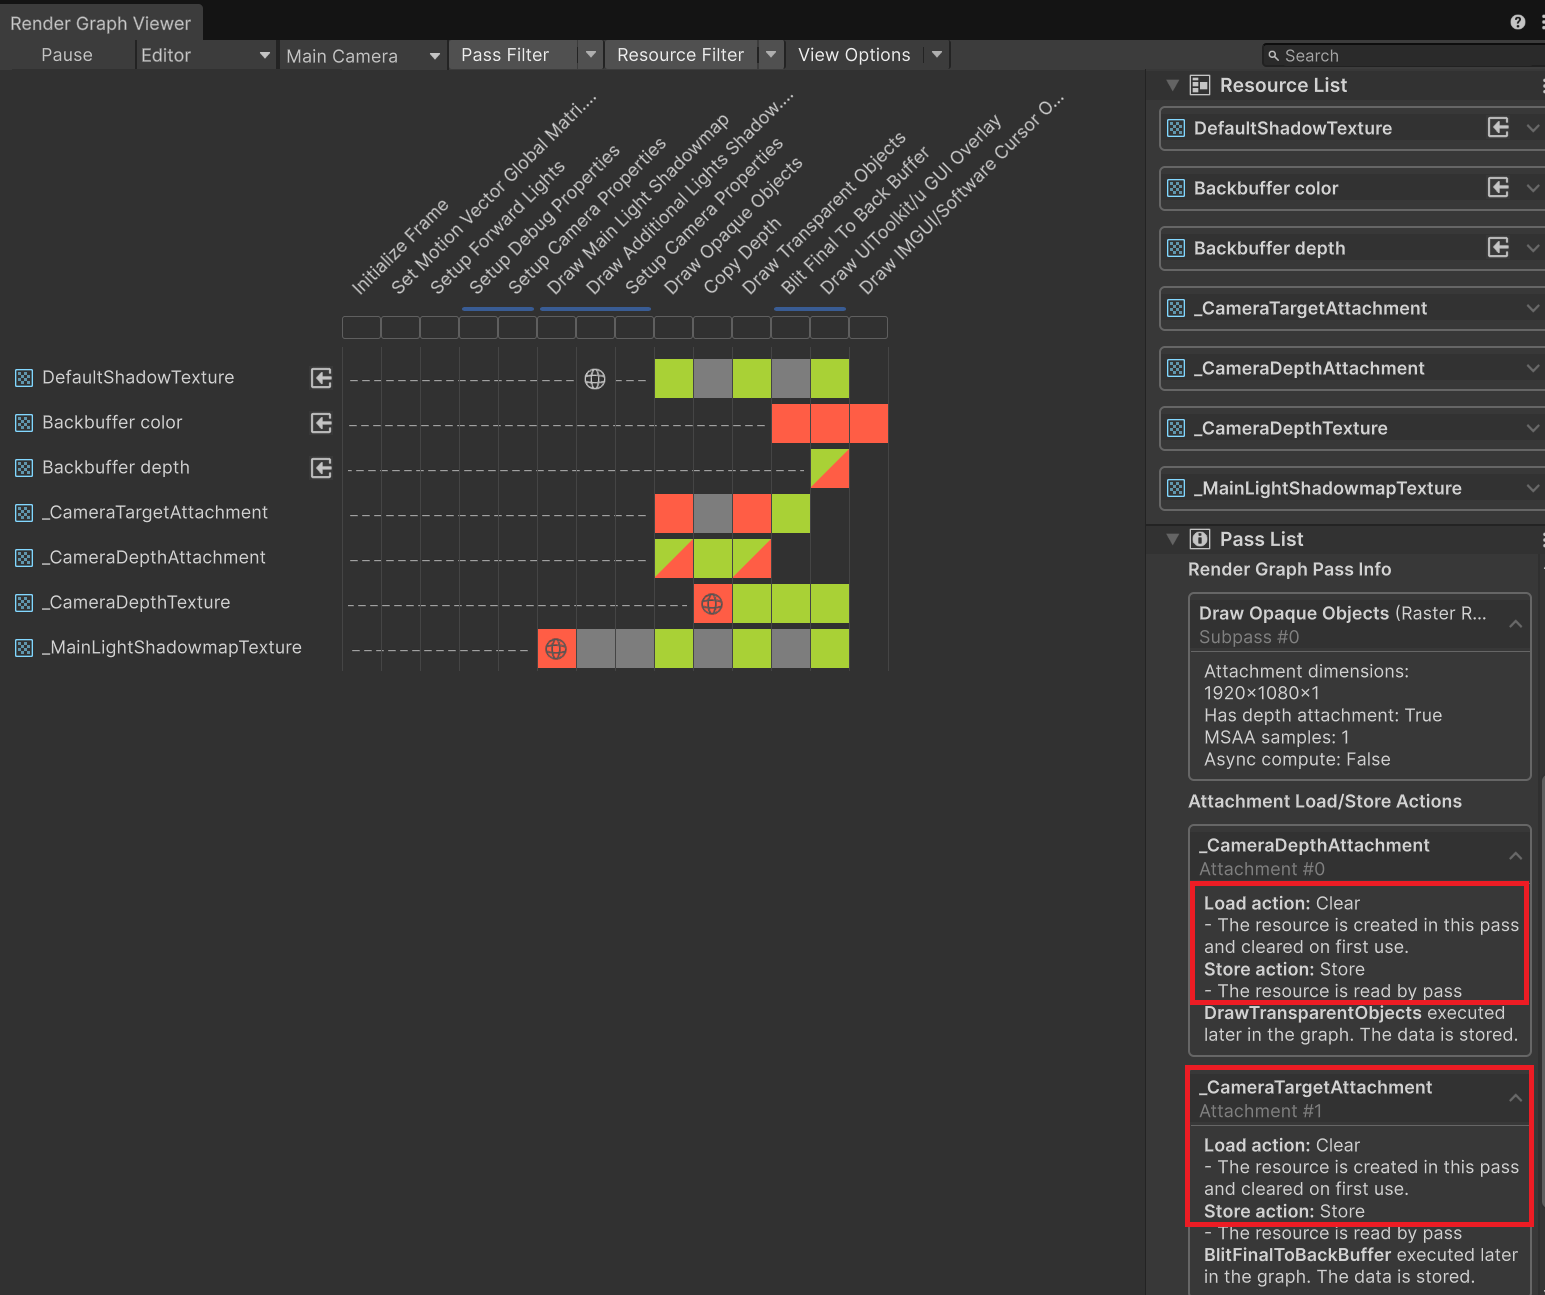
图 1.6: 在 Render Graph Viewer 中确认合并状态与加载/存储操作
1.1.8. RenderDoc
用 RenderDoc 捕获 Vulkan 帧,可以在 API 层面确认各 Render Pass 的附件所指定的loadOp/storeOp。当需要比 Render Graph Viewer 的显示更深入一层,或想将 Unity 的显示与传递给驱动的值进行比对时使用。
1.2. 图块内存的加载/存储
本节讲解作为本章整体基础的加载/存储操作。
1.2.1. 什么是加载/存储操作
TBR GPU 在图块绘制开始时将渲染目标的现有内容读入图块内存(加载),在绘制结束时将图块内存的内容写出到主内存(存储)。不过,加载和存储并非总是必要的。图形 API 提供了按附件指定“开始时怎么做”“结束时怎么做”的操作。
加载操作
| 操作 | 行为 | 带宽开销 |
|---|---|---|
| Load | 将主内存的现有内容读入图块内存 | 高(读取量为分辨率×格式) |
| Clear | 用指定颜色清除图块内存 | 几乎为零(仅为图块内存内的操作) |
| DontCare | 什么都不做(图块内存的初始值不确定) | 零 |
存储操作
| 操作 | 行为 | 带宽开销 |
|---|---|---|
| Store | 将图块内存的内容写出到主内存 | 高(写入量为分辨率×格式) |
| Resolve | 仅写出 MSAA 采样解析后的结果 | 中(仅为解析后的 1 个采样) |
| DontCare | 不写出任何内容(内容被丢弃) | 零 |
也就是说,消耗带宽的只有 Load 和 Store(以及 Resolve)。反过来说,能以 Clear/DontCare 开始、以 DontCare 结束的附件,完全不与主内存交换数据。这一状态是后面讨论的无内存(memoryless)的前提条件。要优化加载/存储,就需要对每个附件确认以下 2 点。
- 开始时,是否需要之前的内容? 若是覆盖全部像素的通道则不需要(DontCare)。若从清除开始则为 Clear,只有在之前的绘制结果上叠加绘制时才是 Load。
- 结束时,这些内容之后是否会用到? 若后续通道或下一帧会使用则为 Store,若在本 Render Pass 内就已使用完毕则为 DontCare。
1.2.2. 带宽开销的估算
一次加载/存储的开销可以通过简单的乘法估算。
一次加载(或存储)的数据量 = 横向分辨率 × 纵向分辨率 × 每像素字节数
下面列出 1080p(1920×1080)下代表性格式的数值。
| 格式 | 每像素 | 一次加载/存储 | 60FPS 时的带宽 |
|---|---|---|---|
| R8G8B8A8 (RGBA8) | 4 字节 | 约 7.9MB | 约 475MB/s |
| B10G11R11_Float | 4 字节 | 约 7.9MB | 约 475MB/s |
| R16G16B16A16_Float | 8 字节 | 约 15.9MB | 约 950MB/s |
| D24S8 / D32(深度) | 4 字节 | 约 7.9MB | 约 475MB/s |
例如,仅“存储相机颜色(RGBA8),并在下一个通道中加载”这一个往返就约 16MB,60FPS 下会消耗约 950MB/s 的带宽。考虑到移动端 SoC 的有效带宽仅有数十 GB/s,而且还要与 CPU 争抢,这并不是可以忽略的量。另外还请注意以下几点。
- MSAA 会带来倍率。若不对 4xMSAA 的颜色缓冲进行 Resolve 而直接 Store,数据量会变为 4 倍(MSAA 与存储的关系将在“无内存(memoryless)”一节讨论)。
- 加载和存储都要计算在内。每跨越一次通道,就会成对产生“前一通道的 Store+后一通道的 Load”。
- 如果在后续通道中对存储的结果进行采样,(未命中缓存的部分)还会产生进一步的读取。
建议对开发中的游戏的渲染管线调查一次:每帧有多少 MB 在图块内存与主内存之间往返。只需在 Render Graph Viewer 中确认各通道的附件与操作,再按上表做乘法,就能看出应该优先从哪个通道削减。
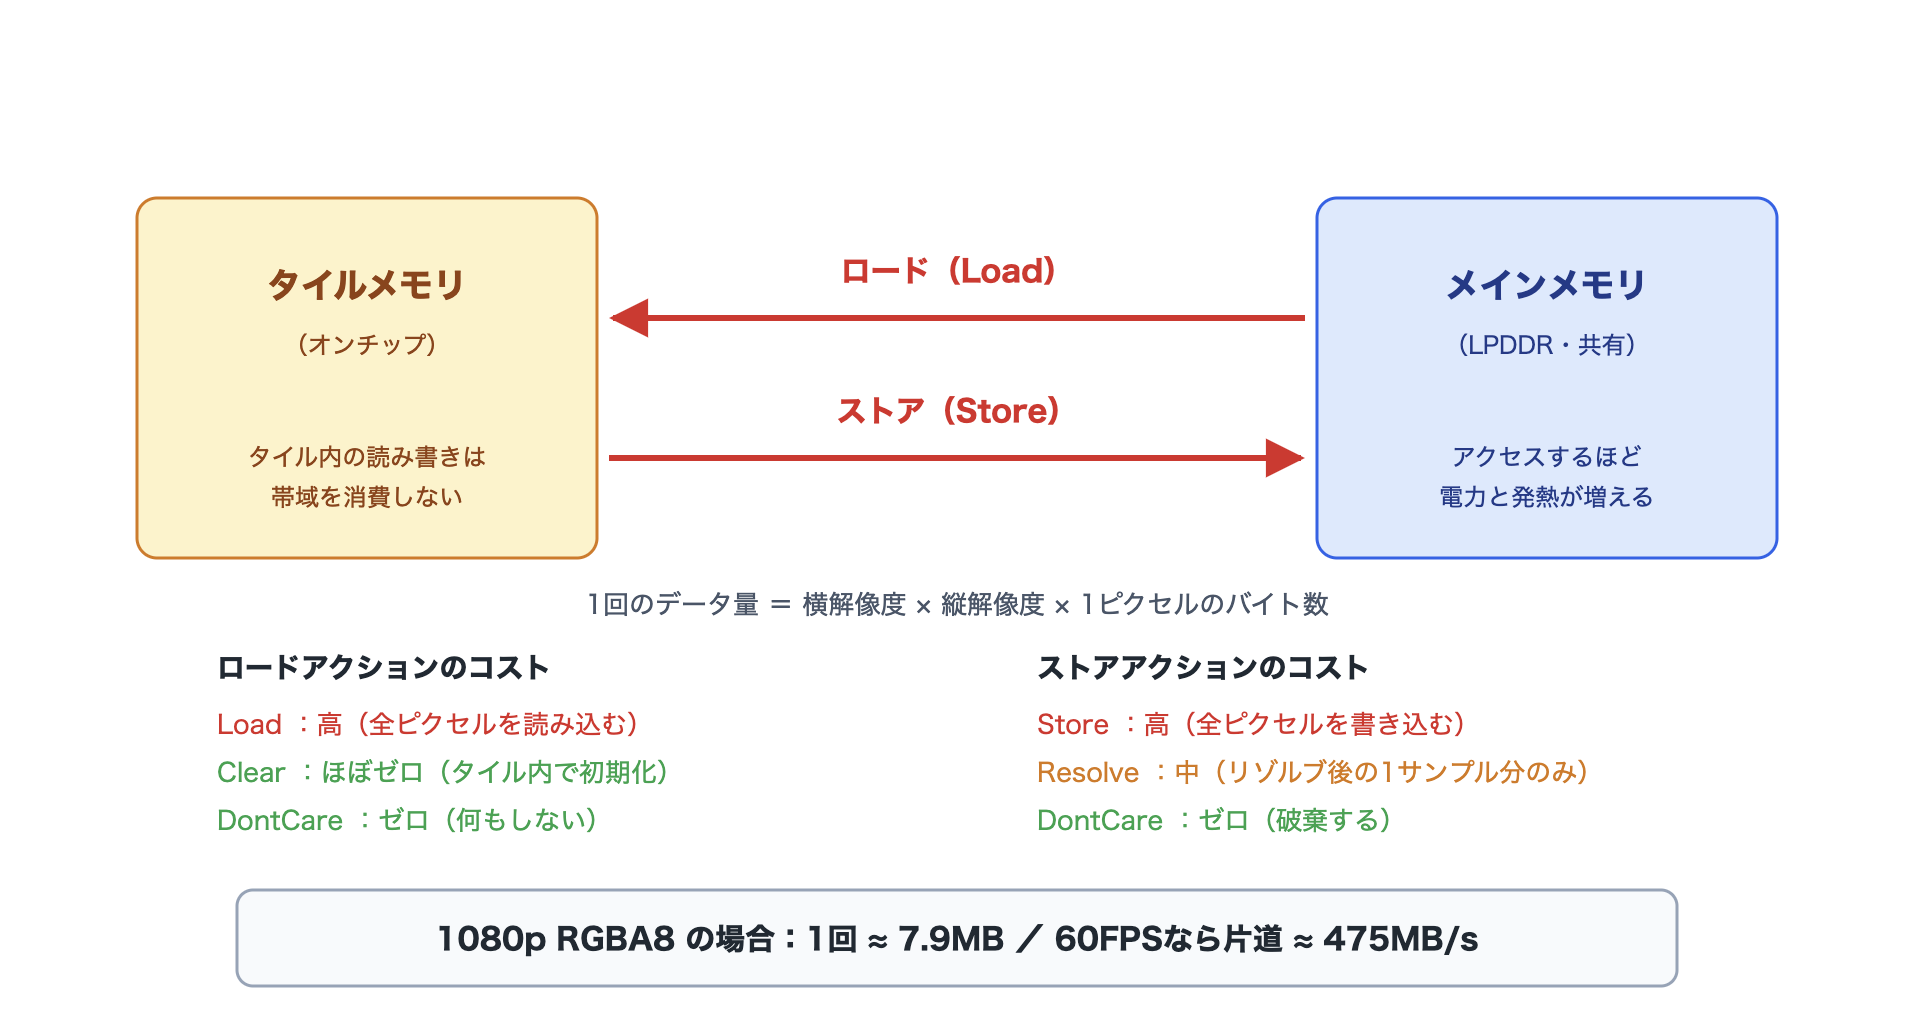
图 1.7: 图块内存⇔主内存的加载/存储与带宽开销
1.2.3. 通过 AccessFlags 声明资源使用方式
那么,在 Render Graph 中如何指定这些加载/存储操作呢?实际上,在 Render Graph 中并不直接指定加载/存储操作。而是在添加通道时向 builder 声明资源的使用方式,由 Render Graph 根据这些信息决定操作。此时用于声明的就是AccessFlags。
清单 1.1: 通过 AccessFlags 声明资源
1 2 3 4 5 6 7 8 9 10 | public override void RecordRenderGraph(RenderGraph renderGraph, ContextContainer frameData) { using (var builder = renderGraph.AddRasterRenderPass<PassData>("Example", out var passData)) { // 声明输出附件。 // AccessFlags.WriteAll = 该通道写入全部像素(不需要之前的内容) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); ... } } |
AccessFlags的主要取值及含义如下。
| AccessFlags | 含义 | 对操作的影响 |
|---|---|---|
| Read | 读取之前的内容 | 加载操作变为 Load |
| Write | 写入(可能只写部分像素) | 需要保留之前的内容,加载操作可能变为 Load |
| ReadWrite | 读写两者 | 加载操作变为 Load |
| Discard | 之前的内容可以丢弃 | 加载操作可设为 DontCare |
| WriteAll | 写入全部像素(Write + Discard) | 加载操作可设为 DontCare |
这里需要特别注意 Write 与 WriteAll 的区别。单纯的Write表示“可能只写入部分像素”,因此 Render Graph 为了保留未被写入的像素内容,只能将加载操作设为 Load。对于全屏 Blit 这类必定覆盖全部像素的通道,请指定WriteAll。以 1080p 的 RGBA8 为例,仅这一指定的差异就决定了每帧是否会产生约 8MB 的加载。另一方面,决定存储操作的是该资源是否会被后续通道使用。这不是由开发者指定,而是由 Render Graph 纵观整个图来判断。下一小节我们来看其中的规则。
1.2.4. Render Graph 决定操作的规则
Render Graph 在根据已记录的所有通道的资源使用信息构建 Native Render Pass 时,决定各附件的加载/存储操作。判断规则整理如下。
加载操作的决定
| 条件 | 决定的操作 |
|---|---|
| 以 AccessFlags.WriteAll(或 Discard)声明 | DontCare |
| 资源的首次使用,且要求清除 | Clear |
| 存在对之前内容的读取/部分写入 | Load |
存储操作的决定
| 条件 | 决定的操作 |
|---|---|
| 后续任何通道都不使用 | DontCare |
| 被后续通道以 UseTexture(作为纹理)使用 | Store |
| 仅被后续通道以 SetInputAttachment(输入附件)使用,且已合并到同一 Native Render Pass 中 | DontCare(在图块内存内传递) |
| 被设置为全局纹理 | Store(后续的使用对 Render Graph 不可见,因此保守地存储) |
| MSAA 且存在解析目标 | Resolve |
从这些规则可以得出 2 条实践指导。
- 将纹理设为全局应作为最后的手段。通过
SetGlobalTextureAfterPass等设为全局的纹理,Render Graph 无法再跟踪其使用情况,因此总是会被存储,也不在无内存(memoryless)化的范围内。如果采用“先设为全局再说”的写法,优化就会失效。 UseTexture与SetInputAttachment在带宽方面是完全不同的东西。同样是“读取前一通道的结果”,前者会产生存储→采样的往返,后者则可以在图块内存内完成(将在“Frame Buffer Fetch”一节详细讨论)。
导入纹理的处理
对于RTHandle等由应用程序侧管理的纹理,通过renderGraph.ImportTexture导入后,Render Graph 并不知道该纹理在图之外是如何使用的。因此默认会保守处理(首次使用时也会加载,最后一次使用后也会存储)。在导入时传入ImportResourceParams可以缓和这一保守行为。
清单 1.2: 导入时的参数设置
1 2 3 4 5 6 | var importParams = new ImportResourceParams { clearOnFirstUse = true, // 首次使用时清除(可将加载设为 Clear) discardOnLastUse = true, // 最后一次使用后可以丢弃(可将存储设为 DontCare) }; var handle = renderGraph.ImportTexture(_rtHandle, importParams); |
如果导入的纹理“每帧都会重新生成,不需要之前的内容”,请设置clearOnFirstUse/discardOnLastUse。另外,对于由 Render Graph 管理的纹理(通过renderGraph.CreateTexture创建的纹理),这些都会被自动判断。除了确实需要自行管理生命周期的纹理之外,基本原则是交给 Render Graph 管理。
解读加载/存储操作
了解规则之后,我们来解读实际的帧。在 Render Graph Viewer 中查看 URP 标准前向渲染的帧,可以观察到例如下面这样的结构。
| 通道 | 附件 | Load | Store |
|---|---|---|---|
| MainLightShadow | 阴影贴图(深度) | Clear | Store |
| DrawOpaqueObjects | 相机颜色 | Clear | (取决于后续) |
| 相机深度 | Clear | (取决于后续) | |
| DrawTransparentObjects | 相机颜色 | (合并时延续) | Store |
| FinalBlit | 后备缓冲 | DontCare | Store |
解读的要点如下。
- 阴影贴图是“先绘制、之后再采样”的资源,因此只能是 Store。这是无法削减的存储。
- 如果不透明→半透明被合并到同一个 Native Render Pass 中,两者之间就不会发生相机颜色的存储/加载。反之,如果中间插入了其他东西导致合并中断,那里就会产生往返。
- 也请注意相机深度的存储操作。开启 Depth Texture 后,相机深度就会被 Store。着色器和后处理并没有要求
_CameraDepthTexture,设置却开着——这是实际项目中常见的浪费。
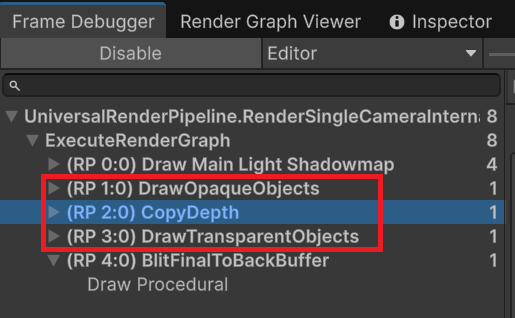
图 1.8: Copy Depth 将 Draw Opaque Objects 与 Draw Transparent Objects 分隔开
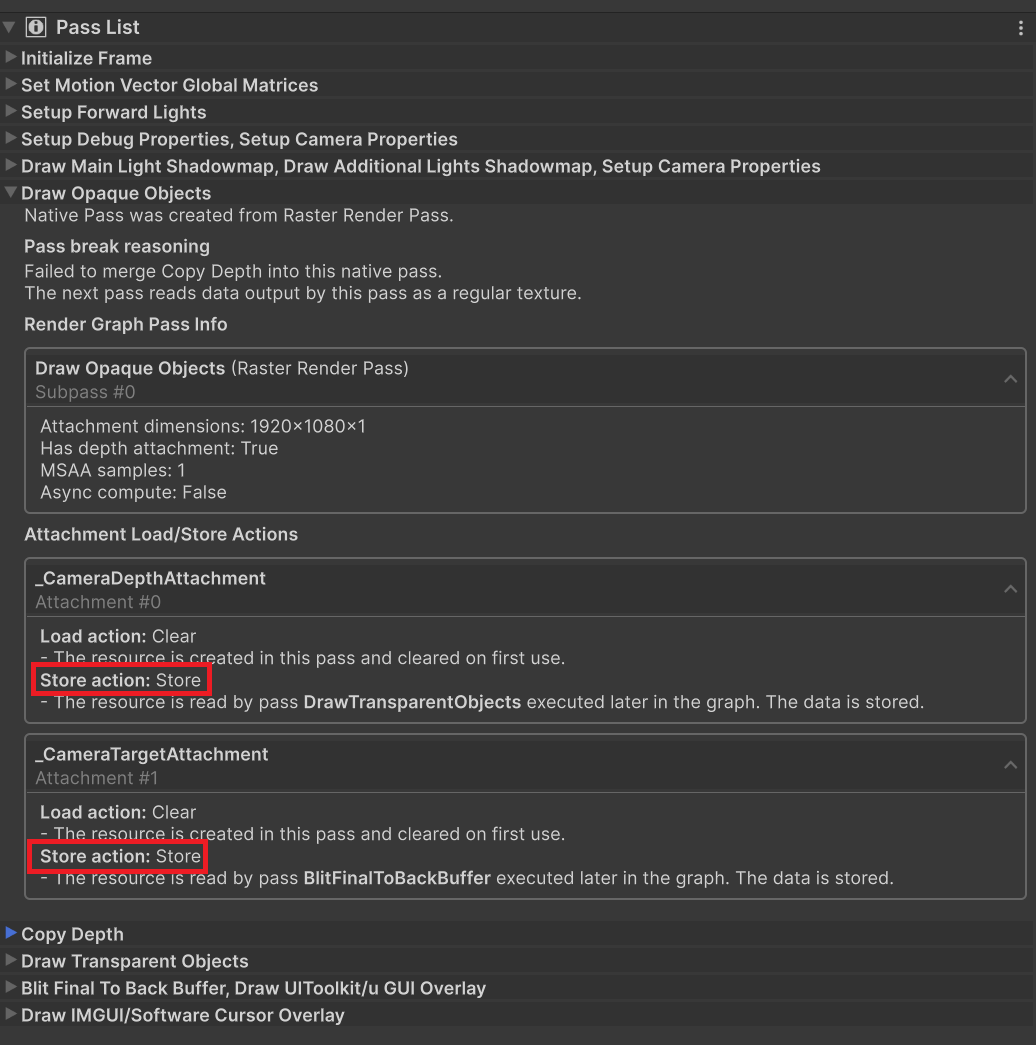
图 1.9: 由于被分隔,Draw Opaque Objects 结束时执行 Store
像这样逐一确认各附件的 Store 是否有正当理由(后续的使用),就是图块内存优化的基本流程。
1.2.5. 通过 AccessFlags 削减的示例
最后,通过实际案例确认仅凭AccessFlags的指定就能改变操作。在执行全屏 Blit 的通道中,比较将输出附件声明为Write与声明为WriteAll的两种情况。
清单 1.3: AccessFlags 的 Write 与 WriteAll 的比较
1 2 3 4 5 | // 模式 A:Write(不声明写入全部像素) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.Write); // 模式 B:WriteAll(声明写入全部像素) builder.SetRenderAttachment(_targetHandle, 0, AccessFlags.WriteAll); |
两者的绘制结果相同。但在 Render Graph Viewer 中确认会发现,模式 A 的加载操作为Load,模式 B 为DontCare。由于是全屏 Blit,加载的内容会被全部像素覆盖而丢弃。也就是说,模式 A 的加载是浪费的。
1.3. Render Pass / Subpass
到此为止,我们已经了解通道之间的存储→加载往返会产生开销。本节讲解用于消除这一开销的机制——Render Pass/Subpass,以及 Render Graph 的通道合并。
1.3.1. 资源依赖关系与 DAG
完成游戏画面的一帧流程称为渲染管线,构成它的每一个处理称为渲染通道。各通道都具有“读取哪些资源、写入哪些资源”的资源依赖关系。例如,包含延迟渲染的典型几何体绘制具有如下依赖关系。
- 在深度预通道中创建深度缓冲
- 将不透明物体绘制到 G-Buffer(使用深度缓冲)
- 对不透明缓冲进行延迟光照(使用 G-Buffer 与深度缓冲)
- 将半透明物体绘制到半透明缓冲(使用深度缓冲)
- 合成不透明缓冲与半透明缓冲并绘制到帧缓冲
以通道为节点、资源依赖关系为边来绘制,这条管线就构成一个有向无环图(DAG: Directed Acyclic Graph)。第 4 个通道没有使用第 2、3 个通道的输出,因此只要将依赖关系传达给 GPU,就可以并行执行。
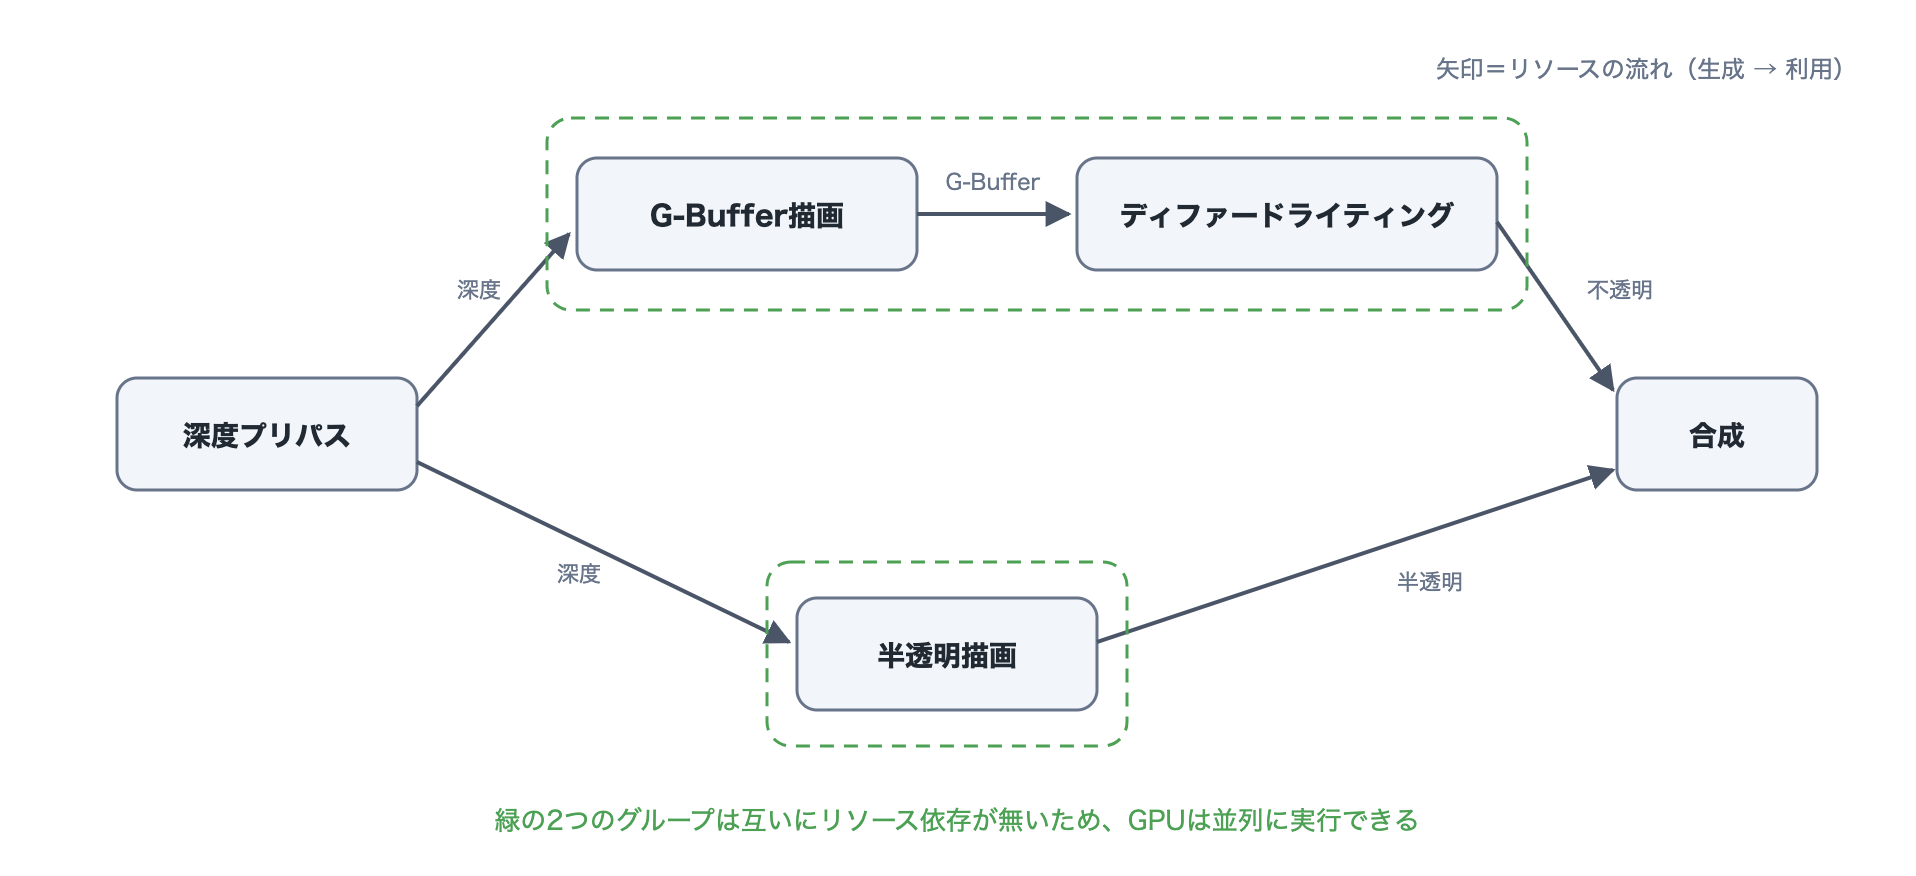
图 1.10: 渲染通道的 DAG 与并行化
Render Graph 名称中的“Graph”指的就是这个 DAG。Render Graph 是收集通道的资源依赖关系构建 DAG,并据此制定执行计划的系统。
1.3.2. Vulkan 的 RenderPass/Subpass
作为向 GPU 传达资源依赖关系的机制,Vulkan 有 RenderPass/Subpass 的概念。Render Graph 最终构建的就是这个 Vulkan RenderPass,因此这里稍微谈一点 API 层面的内容。Vulkan 的 RenderPass 由以下要素组成。
- 附件:RenderPass 中使用的渲染目标的声明。每个附件都要指定
loadOp(加载操作)和storeOp(存储操作)。上一节“图块内存的加载/存储”中看到的操作,其真身就是这个。 - 子通道:RenderPass 内的绘制单位。每个子通道声明输出附件(颜色/深度)和输入附件。
- 子通道依赖关系:子通道之间执行顺序和内存依赖关系的声明。
这里有 2 个需要掌握的性质。
- 加载/存储只在 RenderPass 的边界发生,子通道之间不会发生。也就是说,若能将多个处理组织为同一个 RenderPass 的子通道,它们之间的中间结果就会留在图块内存中。
- 使用输入附件可以读取前一个子通道的结果,但仅限于同一像素位置。这就是下一节讨论的 Frame Buffer Fetch 在 API 上的形态。
用 RenderPass/Subpass 来表达前面的几何体绘制,结果如下。
- 几何体绘制(RenderPass)
- 深度预通道(Subpass) ― 输出:深度
- G-Buffer 绘制(Subpass) ― 输入:深度 / 输出:G-Buffer
- 延迟光照(Subpass) ― 输入:G-Buffer / 输出:不透明缓冲
- 半透明绘制(Subpass) ― 输入:深度 / 输出:半透明缓冲
- 合成(Subpass) ― 输入:不透明缓冲、半透明缓冲 / 输出:帧缓冲
在这一配置下,深度、G-Buffer、不透明缓冲、半透明缓冲全部是子通道之间的传递,跨越 RenderPass 边界的只有最终输出的帧缓冲。原本可能发生 5 次存储的配置,变成了只存储 1 次。顺带一提,Metal 也有同等的机制。Metal 的 Render Pass 具有加载/存储操作,可以从片元函数直接读取图块内存上的颜色附件(以及图块着色器)。虽然没有 Vulkan 那样显式的 Subpass 声明,但Render Graph 执行的优化在 Metal 上同样有效。
1.3.3. Unity 的 Native Render Pass
那么,Render Graph 是如何处理 Vulkan 的 RenderPass/Subpass 的呢?首先要掌握的是,通过AddRasterRenderPass添加的通道并不会直接成为子通道。通过RecordRenderGraph添加的通道,终究只是 Render Graph 的逻辑通道。Render Graph 在帧内所有通道记录完毕后,在编译阶段执行以下工作。
- 根据资源依赖关系构建 DAG,剔除不需要的通道(culling)
- 将相邻通道中满足条件的通道合并为一个 Native Render Pass(相当于 Vulkan 的 RenderPass),并将合并的各通道作为子通道
- 决定各附件的加载/存储操作(参见上一节的“Render Graph 决定操作的规则”)
- 将可行的资源无内存(memoryless)化(“无内存(memoryless)”一节)
也就是说,开发者的工作不是手动组织子通道,而是以可合并的形式设计通道,并正确声明资源的使用方式。合并是否成功,通过 Frame Debugger 的(RP n:m)标记和 Render Graph Viewer 来确认。
1.3.4. 通道合并的条件
整理一下 Render Graph 合并通道的条件。
- 两者都是 Raster Render Pass。
AddComputePass和AddUnsafePass不会被合并。若 Raster 通道序列之间插入了 Compute 通道,Native Render Pass 就会在那里中断。 - 通道是连续记录的。合并只在图上相邻的通道之间进行。
- 输出附件的分辨率一致。若改变中间缓冲的分辨率(降采样),在该边界处就无法合并。
- MSAA 采样数一致。
- 后一通道没有将前一通道的输出作为纹理使用。以
UseTexture使用会要求存储→采样,因此会妨碍合并。以SetInputAttachment(输入附件)使用则不妨碍合并。输入附件与纹理是不同的东西。 - 附件总数不超过上限(8 个)。合并后的 Native Render Pass 所使用的附件总数有上限。
- 没有设为全局纹理等脱离 Render Graph 跟踪的使用方式。
只要有一个条件不满足,该通道就会成为独立的 Native Render Pass。未被合并的理由会显示在 Render Graph Viewer 的 Pass Break Reasoning 中,因此未合并时请先确认那里。
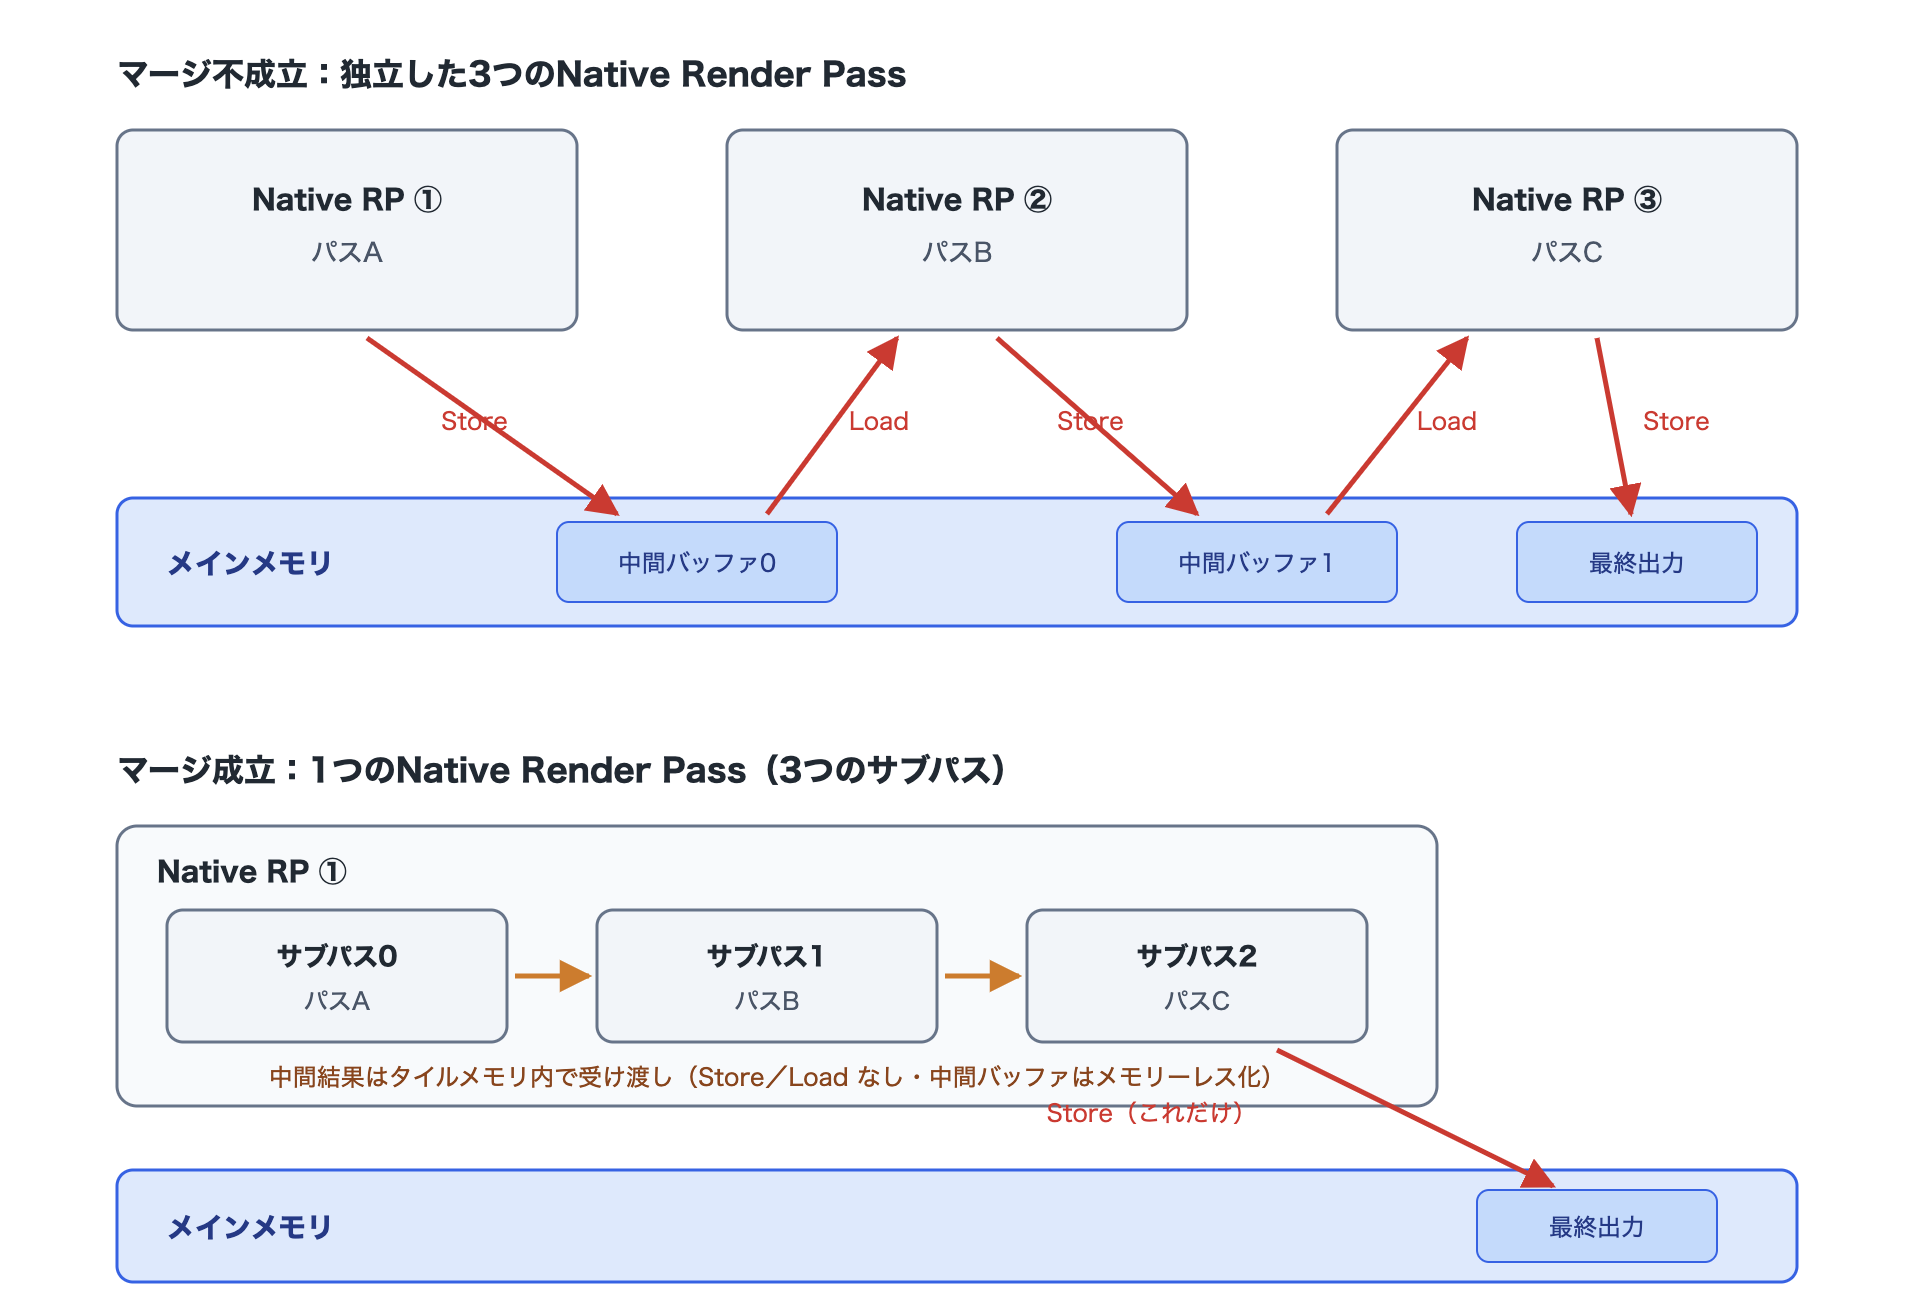
图 1.11: 合并前后 Native Render Pass 结构的比较
1.4. Frame Buffer Fetch
我们已经了解,满足条件即可将通道合并为一个 Native Render Pass。本节讲解在已合并的子通道之间直接从图块内存读取前一子通道结果的技术——Frame Buffer Fetch(以下简称 FBF)。
1.4.1. 什么是 Frame Buffer Fetch
以创建 G-Buffer 再进行光照的延迟渲染为例。若简单地实现,处理如下。
- 创建 G-Buffer(将反照率、法线、材质信息写入图块内存)
- 将反照率、法线、材质信息存储到主内存
- 将存储的 G-Buffer 作为纹理采样,进行延迟光照
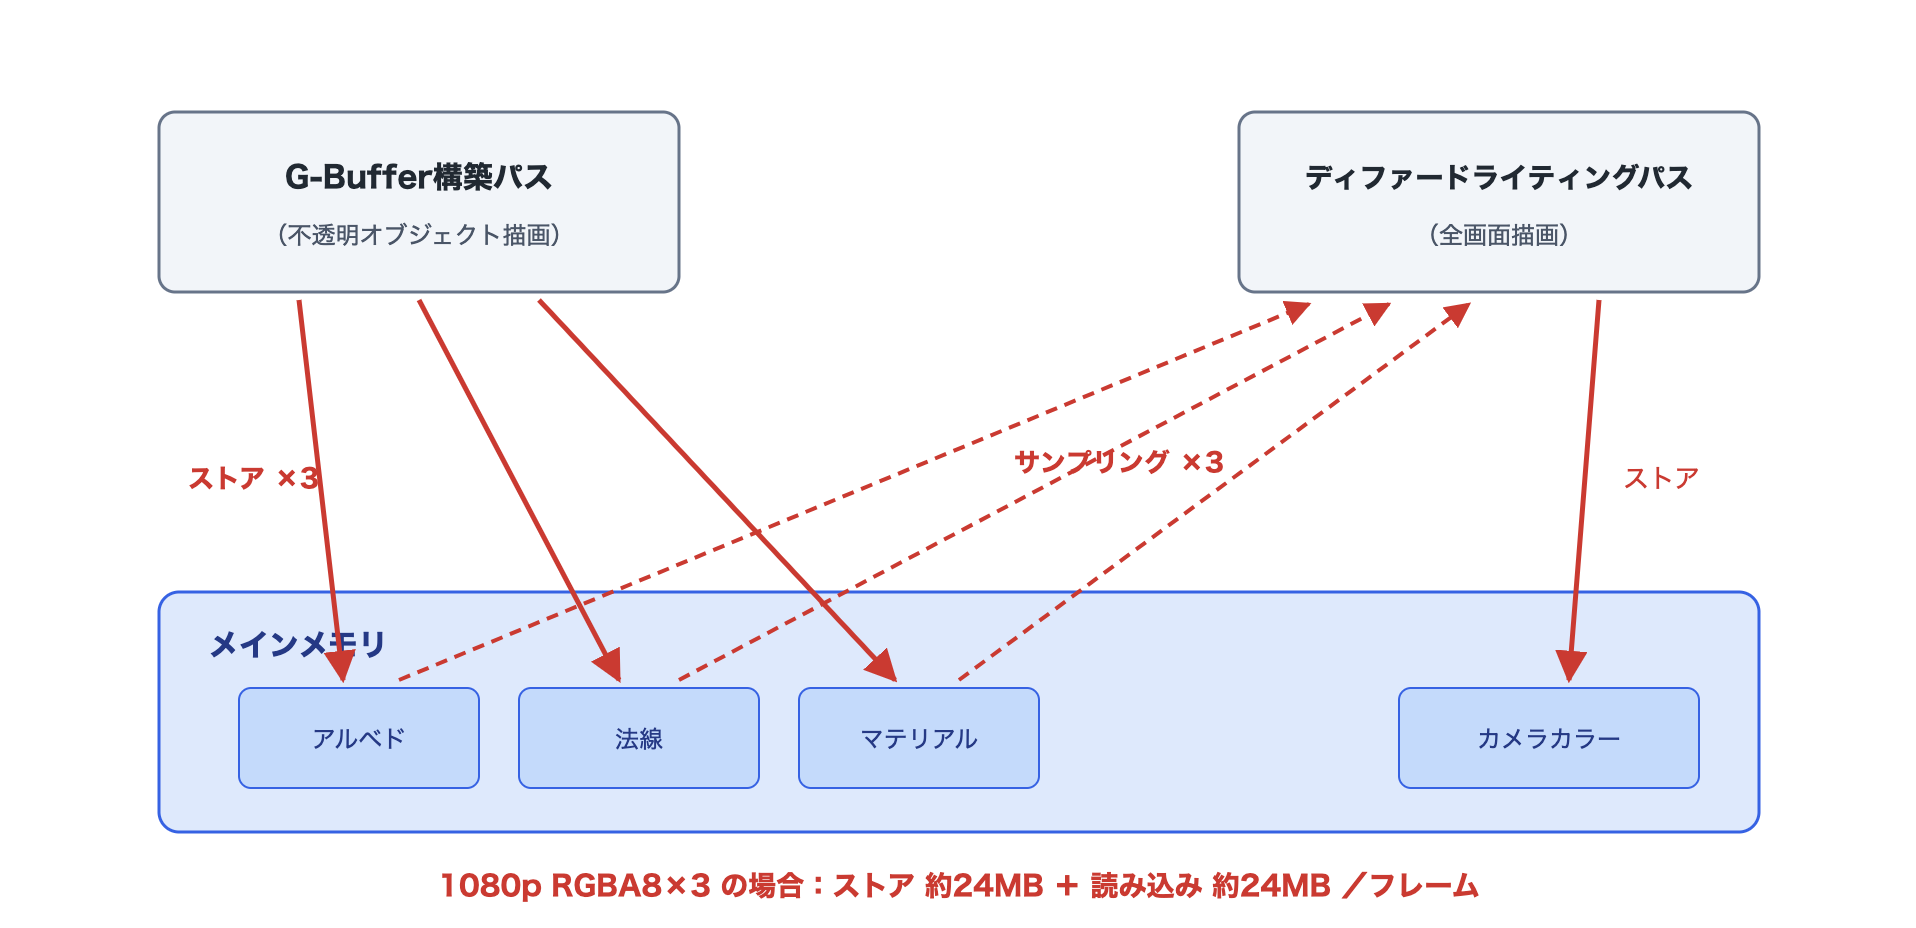
图 1.12: 简单延迟渲染的数据流
这里产生了一个疑问。光照通道想读取的是“当前正在处理的像素”的 G-Buffer 值。而这个值,前一个通道刚刚写入了同一图块的图块内存。能不能不经过主内存的往返,直接从图块内存读取呢?实现这一点的就是 FBF。使用 FBF 后,处理如下。
- 创建 G-Buffer(写入图块内存)
- 直接从图块内存读取 G-Buffer,进行延迟光照
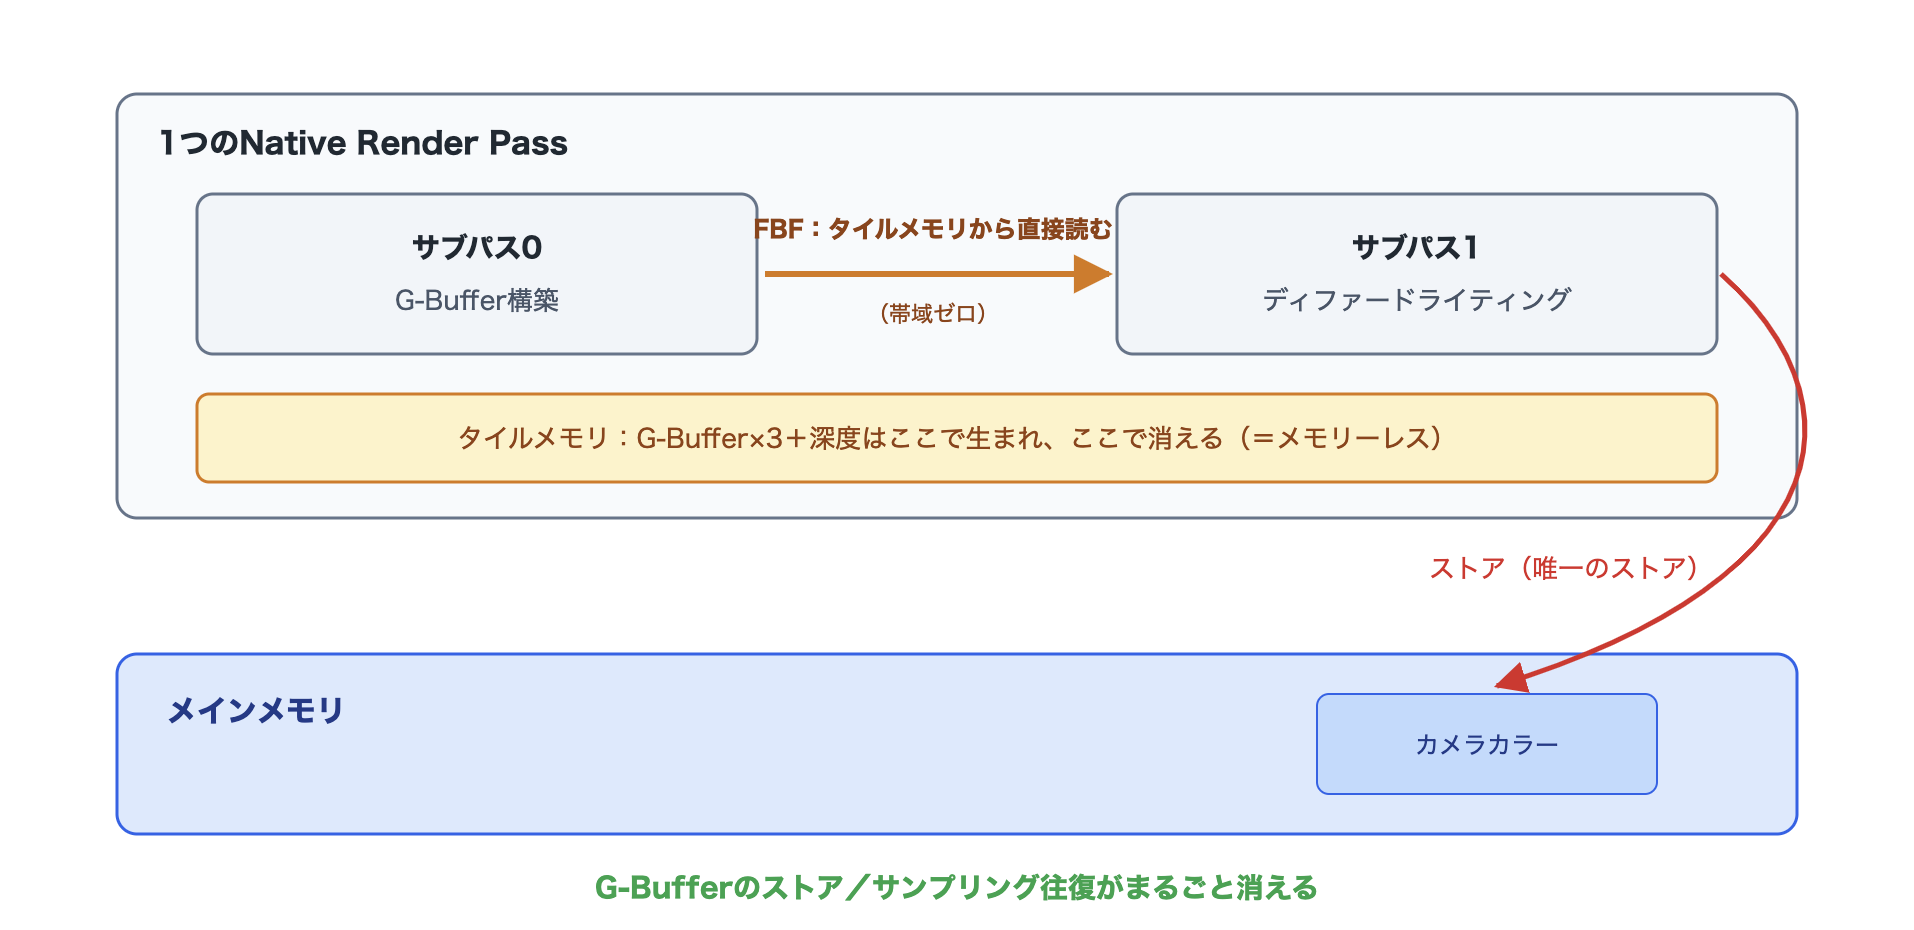
图 1.13: 使用 Frame Buffer Fetch 的延迟渲染数据流
3 张 G-Buffer 的存储以及为采样它们而进行的读取都消失了。以 1080p 的 RGBA8×3 张计算,仅存储就能削减约 24MB/帧,60FPS 下约 1.4GB/s 的带宽。在 API 层面,FBF 通过上一节“Vulkan 的 RenderPass/Subpass”中提到的 Vulkan 输入附件(在 Metal 中为颜色附件的直接读取)来实现。因此 FBF 只能在同一 Render Pass 内的子通道之间使用。通道已被合并是 FBF 的前提条件。
1.4.2. 理解限制
FBF 并不是纹理采样的替代品。它有以下限制。
- 只能读取与正在处理的片元相同的像素位置。图块内存中只有“当前正在处理的图块”的内容,因此偏移采样(读取周边像素)在原理上不可能。
- 不能使用过滤和 mipmap。只能加载单个值。
- 输入侧与输出侧的分辨率必须一致(这也是合并条件之一)。
来看一个限制 1 起作用的实际案例。考虑“在黑白/棕褐色合成的结果上,叠加使 UV 扭曲的噪声处理”这一处理。噪声处理的着色器会像下面这样偏移 UV 后采样。
清单 1.4: 噪声处理着色器
1 2 3 4 5 | // 使用噪声扭曲 UV float2 distortedUV = input.texcoord + noise * 0.02; // 用扭曲后的 UV 采样纹理。 // 由于加载的位置与片元位置不同,无法使用 Frame Buffer Fetch。 half4 color = SAMPLE_TEXTURE2D_X(_BlitTexture, sampler_LinearClamp, distortedUV); |
由于想读取的位置与正在处理的片元位置不同,该通道无法使用 FBF。合成结果必须以UseTexture声明,合成通道与噪声通道之间会产生存储→采样的往返。因此,在设计特效的阶段就确认“该通道是否只读取同一像素?”,可以尽早判断能否使用 FBF。仅需同一像素的处理(色调映射、颜色分级、合成、延迟光照)是 FBF 的候选,而需要读取周边的处理(模糊、扭曲、Bloom)则要使用纹理。
1.4.3. 着色器 API 的内部
要在 Unity 的着色器中使用 FBF,需要利用 SRP Core 提供的宏。
清单 1.5: Frame Buffer Fetch 的用法
1 2 3 4 5 6 7 8 9 | // 声明 0 号输入附件 FRAMEBUFFER_INPUT_X_HALF(0); half4 frag(Varyings input) : SV_Target { // 从 0 号输入附件加载正在处理的片元位置的值 half4 color = LOAD_FRAMEBUFFER_X_INPUT(0, input.positionCS.xy); ... } |
宏根据精度和用途有多种变体。
| 声明宏 | 加载宏 | 用途 |
|---|---|---|
| FRAMEBUFFER_INPUT_HALF(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | half 精度的颜色 |
| FRAMEBUFFER_INPUT_FLOAT(n) | LOAD_FRAMEBUFFER_INPUT(n, pos) | float 精度 |
| FRAMEBUFFER_INPUT_X_HALF(n) | LOAD_FRAMEBUFFER_X_INPUT(n, pos) | 支持 XR(单通道实例化)的版本 |
带_X的变体与TEXTURE2D_X系列宏一样,支持 XR 的渲染目标数组。在可能需要支持 XR 的项目中,统一使用带_X的版本会更稳妥。了解这些宏在各平台上展开为什么,有助于理解其行为和 fallback。
| 平台 | 展开为 | 实体 |
|---|---|---|
| Vulkan | subpassInput + subpassLoad | Render Pass 的输入附件 |
| Metal | 通过 [[color(n)]] 属性读取颜色附件 | 直接读取图块内存 |
| OpenGL ES | GL_EXT_shader_framebuffer_fetch 等扩展(仅限支持的 GPU) | 不支持扩展时使用下方的 fallback |
| 不支持的环境 | 普通纹理(_UnityFBInput0 等)+ 加载指令 | 不构成 FBF,变为普通的纹理读取 |
需要注意的是最后一行。在不支持的环境中,宏会 fallback 以保证能够运行,但此时没有削减带宽的效果。也就是说,能运行并不代表 FBF 生效了。是否产生了效果,请通过 Render Graph Viewer 的操作显示(输入侧缓冲的存储是否为 DontCare)和真机的带宽测量来确认。
1.4.4. SetInputAttachment 与 UseTexture 的区别
在 C# 侧,通过SetInputAttachment声明想用 FBF 读取的资源。
清单 1.6: 输入附件的声明
1 2 3 4 5 6 7 8 9 | using (var builder = renderGraph.AddRasterRenderPass<PassData>("Lighting", out var passData)) { builder.SetRenderAttachment(cameraColor, 0, AccessFlags.Write); // 对应着色器的 FRAMEBUFFER_INPUT_X_HALF(0) builder.SetInputAttachment(gBufferAlbedo, 0); // 对应 FRAMEBUFFER_INPUT_X_HALF(1) builder.SetInputAttachment(gBufferNormal, 1); ... } |
SetInputAttachment的第 2 个参数的索引,对应着色器侧FRAMEBUFFER_INPUT_X_HALF(n)的n。这里用表格整理一下它与从“图块内存的加载/存储”一节起反复出现的UseTexture的区别。
| 项目 | UseTexture | SetInputAttachment |
|---|---|---|
| 可读取的位置 | 任意 UV(可偏移、过滤、mip) | 仅限正在处理的片元位置 |
| 与前一通道的合并 | 妨碍 | 不妨碍 |
| 前一通道输出的存储 | 强制为 Store | 合并成立时可设为 DontCare |
| 带宽开销 | 存储+采样读取 | 零(在图块内存内完成) |
| 着色器侧的读取方式 | SAMPLE_TEXTURE2D 系列 | LOAD_FRAMEBUFFER 系列 |
1.4.5. 深度的 Fetch
不仅是颜色,深度也在图块内存上。如果能 Fetch 深度,就有可能从软粒子、贴花、雾效这类“引用场景深度的处理”中也消除_CameraDepthTexture的存储→采样往返。SRP Core 提供了一组用于处理深度输入附件的宏,但将深度附件作为输入是一个容易受到平台和 URP 版本限制的领域。在得出验证结果之前,本章推荐的是下面这个能够可靠运行的替代方案。作为替代方案,可以将深度写入颜色附件再进行 Fetch。在构建 G-Buffer 的子通道中,将线性化后的深度值写入颜色附件的一个 channel(R16_Float 等),在后续子通道中通过 FBF 读取。虽然附件会多出一个,但只要实现无内存(memoryless)化,实际内存开销就是零,并且可以可靠地消除深度纹理的存储往返。
1.4.6. 平台差异与陷阱
最后,总结一下使用 FBF 时需要确认的平台差异。
| 环境 | FBF 的可用性 | 备注 |
|---|---|---|
| Vulkan (Adreno) | ○ 输入附件 | 广泛支持。驱动质量因设备而异 |
| Vulkan (Mali) | ○ 输入附件 | 广泛支持 |
| Vulkan (IMG / Pixel 10) | ○ 输入附件 | TBDR 系。注意驱动特有的行为差异(最后一节的“GPU 厂商差异”) |
| Metal (Apple) | ○ 颜色附件读取 | 稳定可用 |
| OpenGL ES | △ 依赖扩展 | 仅限支持 GL_EXT_shader_framebuffer_fetch 的 GPU。不支持时 fallback |
| 编辑器 (D3D 等) | × fallback 行为 | 作为普通纹理运行。可以确认运行,但无法测量效果 |
需要特别注意的有以下 3 点。
- 在编辑器中看不到效果。由于 fallback 也能正确绘制,请以“只有在真机上测量才能看出差异”为前提来组织工作流程。
- 与 MSAA 并用时,容易在合并条件(采样数一致)上出问题。启用了 MSAA 的相机颜色与未使用 MSAA 创建的中间缓冲无法合并。请像
GetTextureDesc(cameraColor)那样从原始 Desc 复制中间缓冲的 TextureDesc,以继承采样数。 - 一个子通道可读取的输入附件数量有上限。附件总数 8 个的限制(上一节的“通道合并的条件”)也包括输入侧。设计 G-Buffer 时,请通过 channel 打包来节省附件数量。
1.5. 无内存(memoryless)
到此为止,中间缓冲的加载和存储都已经可以消除了。这里有一件事值得思考:既不加载也不存储的缓冲,还需要在主内存上拥有实体吗?
1.5.1. 什么是无内存(memoryless)
实际上并不需要。只在图块内存上使用、并在图块内存上丢弃的资源,根本不需要分配主内存。这一状态称为无内存(memoryless)。Vulkan/Metal 提供了一种创建模式,可将资源创建为“仅存在于图块内存(片上内存)、不持有主内存后备存储”的资源(Vulkan 中为LAZILY_ALLOCATED内存,Metal 中为MTLStorageMode.memoryless)。指定为无内存(memoryless)的资源具有以下性质。
- 不消耗主内存(应用的内存占用减少)
- 加载操作不能指定为 Load,存储操作不能指定为 Store(因为没有可读写的实体)
也就是说,无内存(memoryless)是前面各节消除加载/存储之后的结果。只要加载/存储已经消除,就能实现无内存(memoryless)化;若无法无内存(memoryless)化,就说明某处还残留着加载或存储。
1.5.2. 成立条件
用前面的术语来描述某个资源可以无内存(memoryless)化的条件,如下所示。
- 加载操作为 Clear 或 DontCare(不从主内存读取之前的内容。即“通过 AccessFlags 声明资源使用方式”小节中看到的 WriteAll/Discard 声明,或首次使用时的 Clear)
- 存储操作为 DontCare(不被后续通道作为纹理使用,也不保留到下一帧。参见“Render Graph 决定操作的规则”小节)
- 使用在一个 Native Render Pass 内完结(子通道之间的传递,即输入附件/FBF 可以使用。参见“Render Pass / Subpass”一节的合并、“Frame Buffer Fetch”一节的 FBF)
如您所见,这 3 个条件正是前面各节讲解的内容本身。
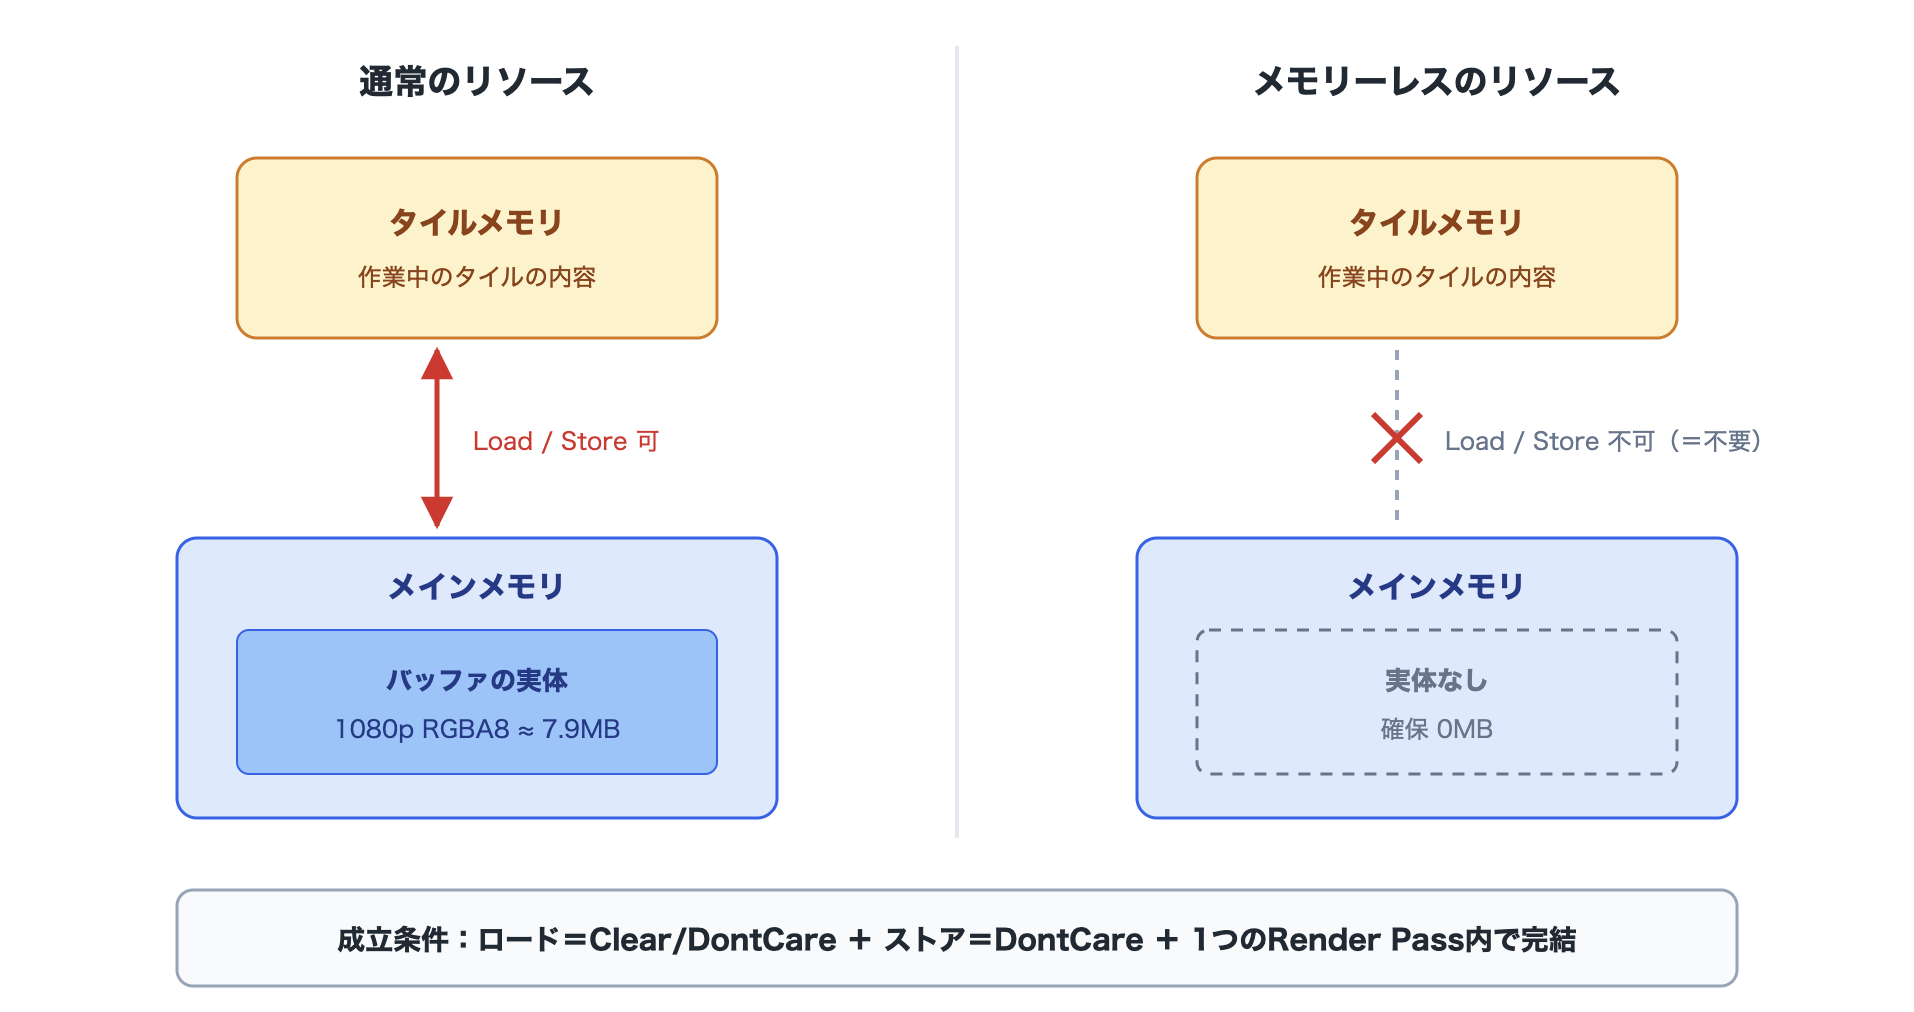
图 1.14: 无内存(memoryless)化前后的内存映射比较
自动无内存(memoryless)化与显式指定
在 Unity 的 Render Graph 中,无内存(memoryless)通过 2 种途径实现。
自动无内存(memoryless)化
当 Render Graph 管理的纹理(通过renderGraph.CreateTexture创建)满足“成立条件”小节中的 3 个条件时,Render Graph 会自动将其无内存(memoryless)化。开发者无需做任何指定。是否已无内存(memoryless)化,可以在 Render Graph Viewer 的 Resource List 中确认。
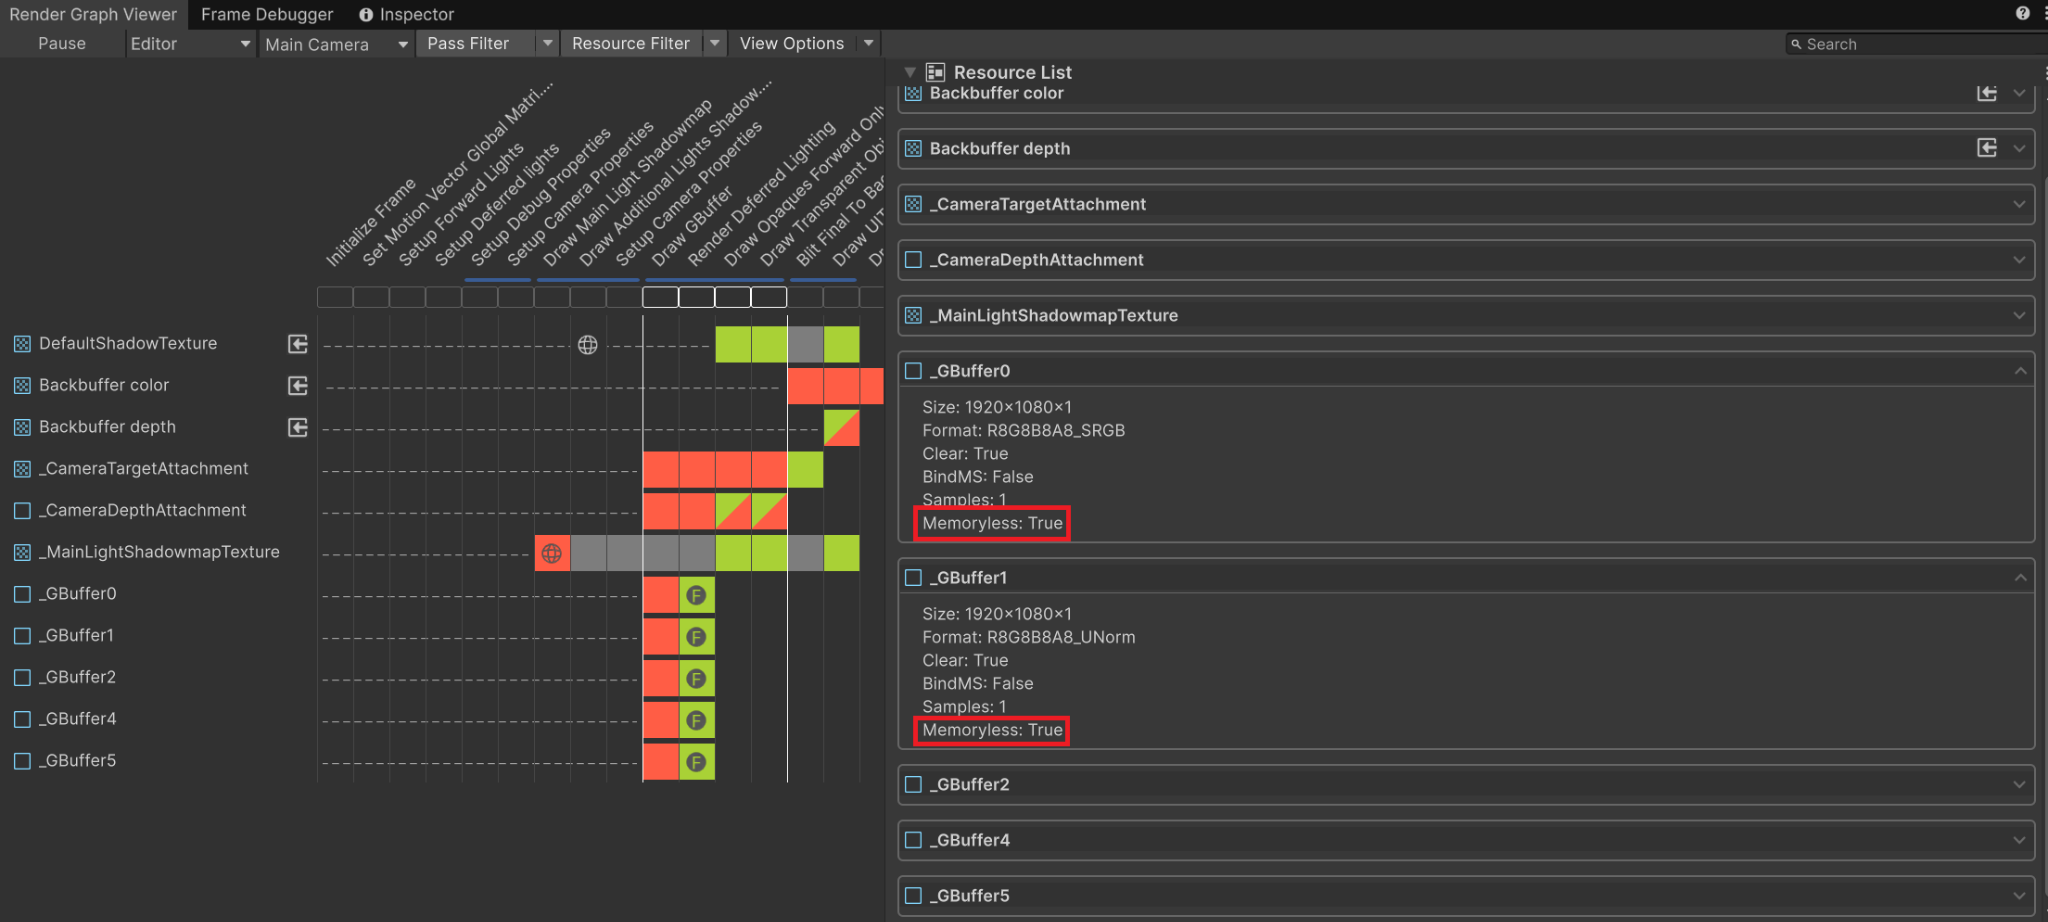
图 1.15: Render Graph Viewer 中的 Memoryless 显示
显式指定
也可以通过TextureDesc的memoryless字段显式指定。
清单 1.7: 无内存(memoryless)的显式指定
1 2 3 4 | var desc = renderGraph.GetTextureDesc(universalResourceData.cameraColor); desc.memoryless = RenderTextureMemoryless.Color; // 指定为无内存(memoryless) desc.name = "Intermediate Texture"; var handle = renderGraph.CreateTexture(desc); |
显式指定的优点是能将设计意图保留在代码中。如果不小心在后续通道中对指定了无内存(memoryless)的资源执行UseTexture,配置上的矛盾会在那一刻显现出来。而如果交给自动处理,当重构过程中某处混入了UseTexture时,就无法察觉无内存(memoryless)已失效(=内存占用与带宽增加)。如果有“该资源要在图块内存内完结”的设计意图,建议通过显式指定将其保留在代码中。
1.5.3. 削减量的量化
无内存(memoryless)化的削减量可以通过计算求得。下面给出 1080p 下的代表性示例。
| 资源配置 | 计算 | 削减量 |
|---|---|---|
| RGBA8 中间缓冲 1 张 | 1920×1080×4B | 约 7.9MB |
| RGBA16F 中间缓冲 1 张 | 1920×1080×8B | 约 15.9MB |
| G-Buffer 3 张(RGBA8)+深度 | 7.9MB×4 | 约 31.7MB |
| 4xMSAA RGBA8 颜色 | 1920×1080×4B×4 | 约 31.7MB |
| 4xMSAA 深度(D32) | 1920×1080×4B×4 | 约 31.7MB |
如表所示,削减量大的是 MSAA 和 G-Buffer。尤其是 4xMSAA,颜色与深度合计超过 60MB,它能否消除对应用整体的内存预算影响很大。另外,无内存(memoryless)削减的是“内存占用”,而带宽的削减来自前面各节进行的加载/存储削减。请注意两者是不同的指标(由于无内存(memoryless)是加载/存储削减的结果,实践中两者会同时达成)。
1.5.4. MSAA 渲染目标的无内存(memoryless)化
无内存(memoryless)效果最大的是 MSAA。我们从机制开始看起。在 4xMSAA 下,图块内存上每个像素保存 4 个采样的颜色和深度。但最终显示到屏幕上的,只是将 4 个采样平均(解析)后的 1 个采样。这时存储操作的选择就起作用了。
- 选择 Store,4 个采样的数据会原样写出到主内存(带宽 4 倍、内存 4 倍)。
- 选择 Resolve,则在图块内存上进行解析,只写出解析后的 1 个采样。
在 TBR GPU 上,解析可以在图块内存上几乎无开销地完成。而且选择 Resolve 时,4 个采样的 MSAA 缓冲本身不会被存储,因此满足无内存(memoryless)的条件。也就是说,正确配置的 MSAA 会形成
- MSAA 颜色缓冲(4 采样) → 无内存(memoryless)(不分配主内存、不存储)
- 解析目标缓冲(1 采样) → 普通存储
- MSAA 深度缓冲(4 采样) → 无内存(memoryless)+不存储(后续不使用深度时)
这样的配置。TBR GPU 上的 MSAA 被认为(相比 IMR)开销低,原因就在于此。在 URP 中,启用 Universal Render Pipeline 资源的 MSAA 设置后,Render Graph 会自动组织出这一配置。需要确认的是它是否被破坏。请在 Render Graph Viewer 中确认 MSAA 颜色缓冲的存储操作是否为 Resolve、Memoryless 是否为 yes。典型的破坏情形是后续通道将 MSAA 缓冲本身作为纹理请求(自定义通道中的错误声明、Opaque Texture 的配置错误等)。
1.5.5. GPU 厂商差异
本章讨论的技术都建立在标准的 Vulkan/Metal 功能之上,在主要厂商的 GPU 上均可运作。在此基础上,掌握各厂商的特性差异,有助于解读测量结果和处理问题。
| 厂商 | 架构特性 | 注意点 |
|---|---|---|
| Qualcomm Adreno | 基于 GMEM 的分箱。根据绘制内容可能切换到直接模式(类 IMR 行为) | 切换到直接模式后,以图块内存为前提的优化效果会发生变化。用 Profiler 确认处于哪种模式 |
| ARM Mali | 以 16×16 图块为基本的 TBR | 外部带宽计数器丰富,是本章带宽测量的基准厂商 |
| Imagination (IMG) | 具有硬件隐面消除(HSR)的 TBDR。Pixel 10 的 IMG DXT 属于此类 | 由于 HSR,不透明过度绘制本来就少,优化的着力点与其他厂商不同。驱动较新,建议验证行为差异 |
| Apple | PowerVR 系谱的 TBDR。可通过 Metal 显式操作图块内存 | FBF/无内存(memoryless)稳定可用。先在 iOS 上确认效果再进行 Android 验证也是有效的做法 |
1.5.6. 结语
最后再次总结本章讨论的 4 个主题。使用 Render Graph 时,开发者要做的只有 2 件事:正确声明资源的使用方式,以及用 Frame Debugger 和 Render Graph Viewer 确认结果。这是不起眼的工作,但日积月累就会体现为设备发热和电池消耗的差异。希望本章能对各位项目的优化有所帮助。
1.5.7. 参考文献
- ARM, "Arm GPU Best Practices Developer Guide", https://developer.arm.com/documentation/101897/latest/
- Qualcomm, "Adreno GPU Best Practices", https://docs.qualcomm.com/doc/80-78185-2/topic/mobile_best_practices.html
- Apple, "Metal Best Practices Guide", https://developer.apple.com/library/archive/documentation/3DDrawing/Conceptual/MTLBestPracticesGuide/
- Unity, "Render graph system" (URP Documentation), https://docs.unity3d.com/Manual/urp/render-graph.html
- 《学园偶像大师》:在移动端也完整呈现“光照与反射”!【CEDEC2024】(日文), https://gamemakers.jp/article/2025_01_29_90729/
- 在移动端实现极速 Deferred Rendering 的方法(日文), CEDiL, https://cedil.cesa.or.jp/cedil_sessions/view/2457
- 从 Unity 6 开始掌握 RenderGraph ― 基本功能篇(日文), https://blog.sge-coretech.com/entry/2024/06/04/171757
- 从 Unity 6 开始掌握 RenderGraph!应用实现篇 1“RenderPass 的构建”(日文), https://blog.sge-coretech.com/entry/2024/09/11/105032
- 着色器优化入门 第 2 回“什么是基于图块渲染的 GPU?”(日文), https://blog.sge-coretech.com/entry/2025/01/27/145242